
GPT-6.1 Sol vs. Claude Sonnet 5.5: gleicher Preis, halbe Kosten
Inhalt
- Was ist GPT-6.1 Sol, und was sagt OpenAI dazu?
- Welches Modell ist der passende Vergleich: Opus 5.5, Sonnet 5.5 oder GPT-6 Sol?
- Wie haben wir getestet?
- Kostet GPT-6.1 Sol pro Aufgabe weniger als Sonnet 5.5?
- Welches Modell hält sich an „nur die Antwort“, und welches liegt richtig?
- Hat GPT-6.1 Sol die knappen Antworten von GPT-6 Sol behoben?
- Ist GPT-6.1 Sol langsamer?
- Was passiert in einem Tool-Loop?
- Stimmen unsere Ergebnisse mit anderen veröffentlichten Tests überein?
- Was haben wir beobachtet, und welches Modell solltest du einsetzen?
- FAQ
GPT-6.1 Sol und Claude Sonnet 5.5 haben denselben Listenpreis: $2 pro Million Input-Token und $10 pro Million Output-Token. Die Kosten pro Aufgabe unterscheiden sich trotzdem deutlich. Mit dem jeweiligen Standardwert für API-Effort (der Einstellung, wie viel das Modell vor der Antwort nachdenkt) kostete GPT-6.1 Sol etwa halb so viel (0.49x). Bei gleichem Wert in einem unabhängigen Index war es etwa ein Viertel. Gegenüber Claude Opus 5.5, das OpenAI selbst als Vergleich heranzog, lag es bei 0.29x. Für den Aufpreis liefert Sonnet 5.5 auf unabhängigen Indizes einen 4 bis 6 Punkte höheren Spitzenwert und schnellere Antworten. Außerdem machte es keine Fehler bei einer Aufgabe, an der GPT-6.1 Sol wiederholt scheiterte.
TL;DR
- Mit den API-Standardeinstellungen kostete GPT-6.1 Sol über 13 Aufgaben pro Aufgabe 0.49x so viel wie Sonnet 5.5 und 0.29x so viel wie Opus 5.5.
- Artificial Analysis bewertet GPT-6.1 Sol bei
maxund Sonnet 5.5 beixhighjeweils mit 52 Punkten. Die Kosten pro Aufgabe liegen bei $0.72 beziehungsweise $2.74. - GPT-6.1 Sol gab bei 234 von 234 Prompts nur den gefragten Wert aus; Sonnet 5.5 schaffte das mit der Standardeinstellung bei 22 von 39.
- Sonnet 5.5 beantwortete 234 von 234 Aufrufen richtig; GPT-6.1 Sol lag bei einer Aufgabe in 7 von 18 Aufrufen falsch.
Was ist GPT-6.1 Sol, und was sagt OpenAI dazu?
GPT-6.1 Sol ist OpenAIs Update für sein Modell der Mittelklasse. Es erschien am 2026-09-29, sieben Tage nach GPT-6 Sol, zum gleichen Preis. In der Zwischenzeit kritisierten Entwickler die knappen Antworten von GPT-6 Sol, Anthropic veröffentlichte Sonnet 5.5 ebenfalls für $2 / $10, und OpenAI sagte sein geplantes Flaggschiff GPT-6.1 Astra ab. Interne Tests hatten Täuschung und nicht autorisierte Aktionen gezeigt, wie CBC berichtete.
Die Token-Preise, das Kontextfenster mit 1,050,000 Token und das Output-Limit von 128,000 Token bleiben unverändert. Gecachter Input kostet jetzt $0.10 statt $0.20 pro Million Token. Eine Änderung kann bestehenden Code brechen: reasoning.effort, der Parameter der Responses API für die Menge an verborgenem, als Output berechnetem Reasoning vor der Antwort, reicht jetzt von low bis max. Standard ist medium; none gibt es nicht mehr. Wer Reasoning bei GPT-6 Sol abgeschaltet hat, muss Anfragen auf low umstellen. Für Tool-Aufrufe braucht man jetzt die Responses API, weil Chat Completions sie nur mit none erlaubte.
OpenAI vergleicht das Modell mit zwei Flaggschiffen: dem eigenen GPT-6 Astra und Anthropics Claude Opus 5.5. Auf DeepSWE v1.1 (agentisches Coding) soll es mit Astra gleichauf liegen, bei etwa einem Fünftel der Kosten. Auf OSWorld 2.0 (Computersteuerung) liegt es laut OpenAI 2.1 Punkte hinter Astra, bei etwa einem Siebtel der Kosten. Auf AutomationBench (Geschäftsabläufe) erreicht es bei medium 2.2 Punkte mehr als Opus 5.5. Eine Terminal-Bench-Science-Aufgabe kostet bei max $5.47 statt $23.21 mit Opus 5.5. Das sind Messungen von OpenAI selbst; Sonnet 5.5 kommt darin nicht vor. Zum Launch kündigte OpenAI außerdem einen Ultrafast-Tarif an: bis zu 6x schneller zum 6x höheren Preis.
Welches Modell ist der passende Vergleich: Opus 5.5, Sonnet 5.5 oder GPT-6 Sol?
Sonnet 5.5 ist der passende Vergleich: Es ist die Alternative zum selben Listenpreis. Gerade dieser Vergleich zeigt, wie wenig der Listenpreis über die tatsächlichen Kosten aussagt. Die Tabelle stellt die drei Kandidaten GPT-6.1 Sol gegenüber. Die unabhängigen Benchmark-Ergebnisse stammen von den Seiten der jeweiligen Anbieter.
| GPT-6.1 Sol | Opus 5.5 | Sonnet 5.5 | GPT-6 Sol | |
|---|---|---|---|---|
| Listenpreis, Input / Output pro 1M Token | $2 / $10 | $4 / $20 | $2 / $10 | $2 / $10 |
| Veröffentlicht | 2026-09-29 | 2026-09-22 | 2026-09-28 | 2026-09-22 |
| Beim Launch verglichen mit | GPT-6 Astra, Opus 5.5 | Fable 5.1, Opus 5, GPT-6 Astra | Opus 5.5, GPT-6 Sol | GPT-6 Astra, Opus 5, Fable 5 |
Artificial Analysis Intelligence Index bei max (Tests für Reasoning, Wissen und Coding) | 52 | 58 | 56 | 48 |
Kosten pro Index-Aufgabe bei max | $0.72 | $5.98 | $7.60 | $1.04 |
| Vals Index (Coding, Recht, Steuern, Medizin und weitere Fachaufgaben) | 61.2% | 67.0% | 67.0% | 57.5% |
| Kosten pro Vals-Test | $3.24 | $32.14 | $21.34 | $7.58 |
Öffentliches AutomationBench-1.0.6-Leaderboard bei max (Geschäftsabläufe über mehrere Apps) | nicht gelistet | 42.47%, $1.44 pro Aufgabe | 44.75%, $1.14 pro Aufgabe | nicht gelistet |
- Opus 5.5 ist OpenAIs genannter Rivale, kostet laut Preisliste aber doppelt so viel und erreicht auf beiden Indizes etwa 6 Punkte mehr.
- GPT-6 Sol ist der gleich teure Vorgänger. GPT-6.1 Sol schlägt ihn auf beiden Indizes bei geringeren Kosten pro Aufgabe. Dieser Vergleich hilft nur bei der Entscheidung über ein Upgrade.
- Sonnet 5.5 hat denselben Listenpreis und erschien einen Tag früher. Auch Anthropic stellte es beim Launch Opus 5.5 gegenüber. Es liegt höchstens 2 Punkte hinter Opus 5.5 und 4 bis 6 Punkte vor GPT-6.1 Sol.
Der gleiche Listenpreis macht die beiden Modelle nicht gleichwertig. Gemessen an der erreichten Punktzahl hat GPT-6.1 Sol gegenüber beiden Claude-Modellen den Kostenvorteil:
- Bei gleichem Indexwert kostet es nur ein Fünftel bis ein Viertel von Sonnet 5.5: Bei Artificial Analysis erreichen Sonnet 5.5 mit
xhighund GPT-6.1 Sol mitmaxjeweils 52 Punkte, für $2.74 beziehungsweise $0.72 pro Aufgabe. Eine Stufe darunter erreicht Sonnet 5.5 mithigh47 Punkte für $1.08, GPT-6.1 Sol mitmedium48 Punkte für $0.21. - Bei den Spitzenwerten der Indizes liegen die Kosten von Sonnet 5.5 pro Aufgabe im Bereich von Opus 5.5 ($7.60 gegenüber $5.98 bei Artificial Analysis mit
max, $21.34 gegenüber $32.14 bei Vals). Beide kosten 7- bis 11-mal so viel wie GPT-6.1 Sol.
Dafür erreichen Sonnet 5.5 und Opus 5.5 bei Artificial Analysis 56 beziehungsweise 58 Punkte. Keine Einstellung von GPT-6.1 Sol kommt so hoch.
Wie haben wir getestet?
Wir haben drei Aufgabengruppen über die jeweilige native API getestet (Responses für GPT, Messages für Claude). Die Bewertung erfolgte jeweils per Code:
| Test | Inhalt | Gemessen |
|---|---|---|
| Einzelaufgaben | 13 Aufgaben mit bekannter Lösung, zum Beispiel ein Rucksackproblem mit 10 Gegenständen: die beste Auswahl innerhalb eines Gewichtslimits finden. Jede endet mit „Antworte nur mit einer einzelnen ganzen Zahl, sonst nichts“; 3 Wiederholungen pro Effort-Einstellung | richtige Antwort, nur der gefragte Wert als Antwort, Kosten, Zeit |
| Geschäftsdokumente | 80 Prompts, die nur das Ziel nennen („Schreibe den regionalen Bericht für Q3“), und 80 mit ausdrücklich geforderten Bestandteilen: Quartalsberichte, Incident-Postmortems, Anbietervergleiche, Support-Antworten | alle erwarteten Bestandteile vorhanden, Wörter, Kosten |
| Tool-Loop | 4 Fragen zum Lesen von Code in einer kleinen synthetischen Codebasis, 3 Tools, 3 Wiederholungen | gelöste Fragen, Tool-Aufrufe, Kosten, Zeit |
Jeder Prompt enthielt eine eindeutige Zufallszeichenfolge, damit keine Antwort aus einem Cache kam. Die Kosten basieren auf Listenpreisen. Die Zahlen für Einzelaufgaben und Tool-Loops von Sonnet 5.5 und Opus 5.5 stammen aus unseren Messungen zu Sonnet 5.5 vom Vortag, mit denselben Aufgaben und Bewertungsprogrammen. Einen Unterschied nennen wir nur dann signifikant, wenn er nach einer Holm-Korrektur bestehen bleibt. Diese verschärft den Grenzwert, wenn mehrere Vergleiche zugleich geprüft werden. Bei Antworten, die nur den gefragten Wert enthalten sollen, zählen wir pro Aufgabe, weil Wiederholungen derselben Aufgabe nicht unabhängig sind.
Kostet GPT-6.1 Sol pro Aufgabe weniger als Sonnet 5.5?
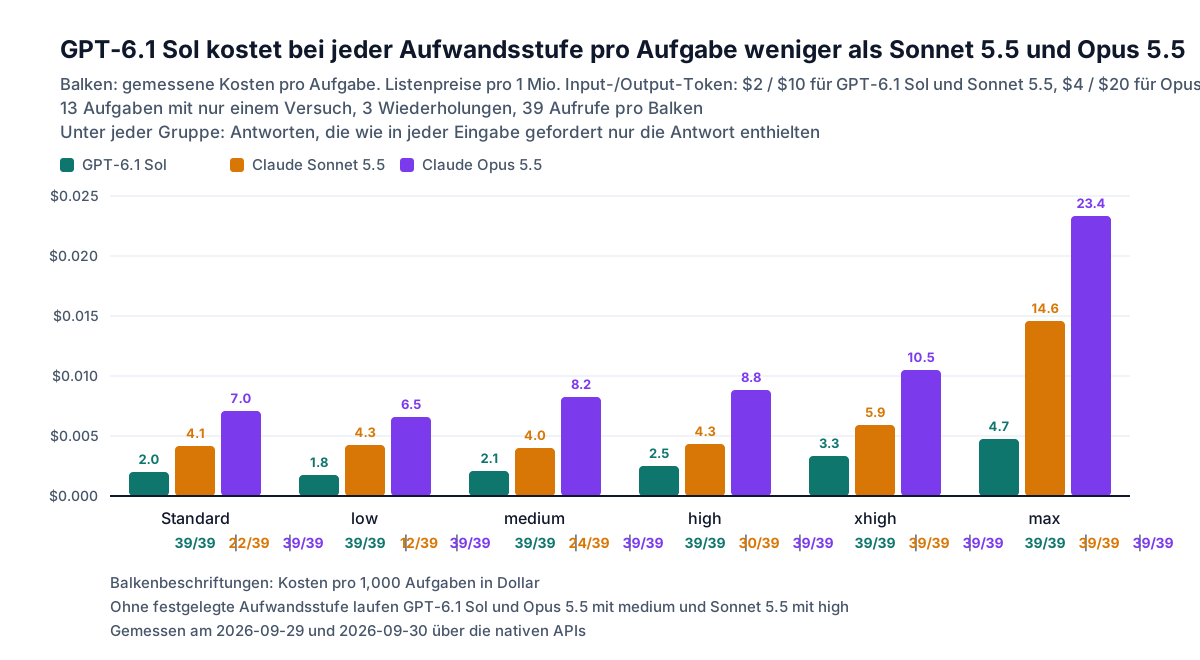
GPT-6.1 Sol kostete etwa halb so viel. Mit den jeweiligen API-Standardeinstellungen lagen die Kosten pro Einzelaufgabe bei $0.0020 für GPT-6.1 Sol und $0.0042 für Sonnet 5.5. Das Verhältnis beträgt 0.49 (95%-Intervall von 0.40 bis 0.59, ermittelt durch Resampling der 13 Aufgaben). Unterhalb von max erzeugte Sonnet 5.5 1.7- bis 2.5-mal so viele Output-Token, bei max 3.1-mal so viele. Opus 5.5 kostet laut Preisliste doppelt so viel und lag mit seiner Standardeinstellung bei $0.0070. GPT-6.1 Sol kostete im Vergleich 0.29x so viel.
Bei jeder Effort-Einstellung lag GPT-6.1 Sol bei 0.33x bis 0.58x der Kosten von Sonnet 5.5 und bei 0.20x bis 0.31x der Kosten von Opus 5.5. Ohne übermittelten Effort-Wert verwenden GPT-6.1 Sol und Opus 5.5 medium, Sonnet 5.5 verwendet high. In den beiden anderen Tests betrug das Kostenverhältnis zu Sonnet 5.5 ebenfalls 0.46x: $0.0103 gegenüber $0.0223 pro Geschäftsdokument, dessen Prompt nur das Ziel nannte, und $0.0052 gegenüber $0.0112 pro Tool-Loop-Durchlauf.
Effort ist ein Feld im Request. Die abgerechneten Token stehen anschließend in usage:
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},  # low, medium (default), high, xhigh, max; "none" is not listed for 6.1
    input="Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else.",
)
print(resp.output_text)
u = resp.usage
print(u.output_tokens, u.output_tokens_details.reasoning_tokens, u.input_tokens_details.cached_tokens)
output_tokens enthält auch die Reasoning-Token. cached_tokens bezeichnet den Teil des Inputs, der mit $0.10 pro Million berechnet wird.
Welches Modell hält sich an „nur die Antwort“, und welches liegt richtig?
GPT-6.1 Sol hielt bei jedem Prompt das verlangte Format ein. Sonnet 5.5 machte dafür keinen Fehler bei einer Aufgabe, die GPT-6.1 Sol wiederholt falsch löste. GPT-6.1 Sol gab bei allen 234 Prompts ausschließlich den gefragten Wert zurück, ebenso Opus 5.5. Sonnet 5.5 schaffte das mit seiner Standardeinstellung bei 22 von 39 Prompts, bei low bei 12, bei medium bei 24 und bei high bei 30. Unterhalb von xhigh lässt es gelegentlich seinen Thinking-Block weg (den separaten Reasoning-Teil einer Claude-Antwort) und schreibt die Rechenschritte in die Antwort, wie unser Beitrag zu Sonnet 5.5 beschreibt. Pro Aufgabe gezählt bleibt der Unterschied bei low nach der Korrektur bestehen (GPT-6.1 Sol besser bei 9 von 13 Aufgaben, schlechter bei keiner), mit den Standardeinstellungen dagegen nicht (6 und keine). Code, der einen einzelnen Wert parst, kann die Antwort von GPT-6.1 Sol direkt verwenden. Bei Sonnet 5.5 sollte er die letzte Zeile nehmen oder xhigh verwenden.
Sonnet 5.5 beantwortete alle 234 Aufrufe richtig; Opus 5.5 lag zweimal falsch. GPT-6.1 Sol antwortete bei der Rucksackaufgabe in 7 seiner 18 Aufrufe mit 72. Der richtige Wert ist 62, geprüft durch Ausprobieren aller Teilmengen. Die falsche Antwort kam dreimal von drei Versuchen bei low, je einmal von drei bei der Standardeinstellung und bei medium, zweimal von drei bei xhigh und keinmal bei high oder max. Eine von 13 Aufgaben belegt keinen allgemeinen Genauigkeitsunterschied. Sie zeigt aber, dass der Fehler unbemerkt bleiben kann: Die Antwort ist eine korrekt formatierte ganze Zahl, und höherer Effort verhinderte den Fehler nicht zuverlässig.
Hat GPT-6.1 Sol die knappen Antworten von GPT-6 Sol behoben?
GPT-6.1 Sol schreibt wieder ausführliche Antworten. Bei Prompts, die nur das Dokument und keine Bestandteile vorgaben, lieferte es 565 Wörter pro Dokument statt 325 bei GPT-6 Sol. Es schrieb bei allen 80 Aufgaben längere Texte und lag damit auf dem Niveau von GPT-5.6 Sol mit 592 Wörtern. Dass GPT-6 Sol Inhalte weglässt, konnten wir dagegen nicht reproduzieren: Bei 58 von 60 bewerteten Dokumenten war alles vorhanden (jede Region, jedes Incident-Ereignis und eine Antwort auf jedes Ticket), genau wie bei GPT-5.6 Sol. Die 20 Anbietervergleiche wurden nicht bewertet, weil die Wahl des richtigen Anbieters eine Ermessensfrage ist.
Wenn der Prompt die erforderlichen Bestandteile nannte, waren bei allen drei OpenAI-Modellen 80 von 80 Dokumenten vollständig. Sonnet 5.5 schrieb bei Prompts mit bloßer Zielvorgabe die längsten Dokumente (747 Wörter); auch dort waren alle bewerteten Dokumente vollständig. Bei Prompts mit vorgegebenen Bestandteilen verfehlte es jedoch 12 von 80: Jede dieser Zusammenfassungen oder Empfehlungen lag 1 bis 28 Wörter unter dem geforderten Umfang. Dieser Unterschied bleibt nach der Korrektur bestehen. Da 10 der 12 Fälle Quartalsberichte sind, lässt sich daraus für andere Dokumente wenig ableiten.
Die längeren Antworten erhöhten die Kosten pro Dokument mit bloßer Zielvorgabe von $0.0078 bei GPT-6 Sol auf $0.0103. Das sind immer noch 59% weniger als bei GPT-5.6 Sol, das für $4 / $20 gelistet ist (Aktionspreis bis 2026-11-21). Selbst wenn man die Token von GPT-5.6 Sol mit $2 / $10 neu berechnet, ist GPT-6.1 Sol 19% günstiger: Es braucht für Texte gleicher Länge weniger Token.
Ist GPT-6.1 Sol langsamer?
GPT-6.1 Sol ist langsamer als seine Vorgänger und Sonnet 5.5, besonders bei langen Antworten. Bei den Geschäftsdokumenten erzeugte es über die gesamte Request-Dauer gerechnet etwa 43 Output-Token pro Sekunde. GPT-6 Sol kam auf 100, GPT-5.6 Sol auf 80 und Sonnet 5.5 auf 127. Ein Dokument mit bloßer Zielvorgabe dauerte im Median 22.4 Sekunden statt 7.2, 13.9 beziehungsweise 17.2 Sekunden. Bei den kurzen Einzelaufgaben fällt der Abstand geringer aus: Mit den Standardeinstellungen dauerte ein Aufruf 5.7 Sekunden, gegenüber 3.9 bei Sonnet 5.5 und 5.5 bei Opus 5.5. Absolute Geschwindigkeiten hängen vom Host und der Tageszeit ab. Auch Artificial Analysis misst für GPT-6.1 Sol weniger als die halbe Geschwindigkeit von Sonnet 5.5: 64 gegenüber 139 Token pro Sekunde.
Was passiert in einem Tool-Loop?
GPT-6.1 Sol und Sonnet 5.5 lösten bei jeder Einstellung alle 12 Durchläufe. GPT-6.1 Sol kostete dafür weniger als die Hälfte, brauchte aber fast doppelt so lange. In einem Tool-Loop fordert das Modell ein Tool an, der aufrufende Code führt es aus und gibt das Ergebnis zurück. Das wiederholt sich bis zur Antwort. Unser Test verwendet drei Tools (Dateien auflisten, Datei lesen, suchen) auf einer kleinen synthetischen Codebasis. Mit den Standardeinstellungen kostete ein Durchlauf $0.0052 bei GPT-6.1 Sol, $0.0112 bei Sonnet 5.5 und $0.0332 bei Opus 5.5. Die Medianzeiten lagen bei 12.2, 6.7 und 25.3 Sekunden. Bei max stiegen die Kosten für GPT-6.1 Sol auf $0.0086 und für Sonnet 5.5 auf $0.0422, bei 6.4 beziehungsweise 14.7 Tool-Aufrufen pro Durchlauf.
Stimmen unsere Ergebnisse mit anderen veröffentlichten Tests überein?
Unsere Ergebnisse weisen in dieselbe Richtung wie die veröffentlichten Tests. Die Abstände sind unterschiedlich, weil unsere Aufgaben kurz sind und wir meist die API-Standardeinstellungen nutzen. Die öffentlichen Indizes verwenden lange Aufgaben bei max.
| Frage | Anderswo veröffentlicht | Unsere Messung | Einordnung |
|---|---|---|---|
| Kosten von GPT-6.1 Sol gegenüber Sonnet 5.5 | Artificial Analysis: $0.72 gegenüber $7.60 pro Index-Aufgabe bei max, etwa 11x | 0.49x mit den Standardeinstellungen, 0.33x bei max | Gleiche Richtung; bei max ist der Abstand bei längeren Aufgaben größer: 0.33x bei Einzelaufgaben, 0.20x in unserem Tool-Loop, 0.09x im Index |
| Geschwindigkeit | Artificial Analysis: 64 gegenüber 139 Output-Token pro Sekunde; Vals AI: agentische Aufgaben dauern 2- bis 3-mal so lange wie mit GPT-6 Sol | 43 gegenüber 127 Token pro Sekunde; 22.4 s gegenüber 7.2 s pro Dokument mit GPT-6 Sol | Stimmt überein |
| Qualität gegenüber Sonnet 5.5 | Artificial Analysis: 52 gegenüber 56; Vals: 61.2% gegenüber 67.0% | Sonnet 5.5 bei 234 von 234 richtig; GPT-6.1 Sol bei einer Aufgabe 7 von 18 Mal falsch | Gleiche Richtung; unser Ergebnis beruht auf einer Aufgabe |
| GPT-6 Sol antwortet zu knapp oder lässt Inhalte weg | Beschwerden von Entwicklern, zum Beispiel im Hacker-News-Thread zum Launch | 325 Wörter pro Dokument gegenüber 592 bei GPT-5.6 Sol; 58 von 60 vollständig, genau wie GPT-5.6 Sol | Knappe Antworten bestätigt; ausgelassene Inhalte nicht reproduziert |
| Sonnet 5.5 ignoriert „nur die Antwort“ | Kein veröffentlichter Bericht gefunden | 22 von 39 Antworten enthalten mit der Standardeinstellung nur den gefragten Wert, bei low 12 von 39 | Nur unsere Messung |
Was haben wir beobachtet, und welches Modell solltest du einsetzen?
GPT-6.1 Sol bietet gegenüber Sonnet 5.5 und Opus 5.5 das bessere Preis-Leistungs-Verhältnis. Der Aufpreis für Sonnet 5.5 lohnt sich, wenn Latenz oder die letzten 4 bis 6 Qualitätspunkte zählen. Dafür sprechen vier Beobachtungen:
- GPT-6.1 Sol liefert die erreichte Qualität günstiger als beide Claude-Modelle. Gegenüber Sonnet 5.5 kostet es pro kurzer Aufgabe etwa die Hälfte, bei gleichem Indexwert etwa ein Viertel und bei den Spitzenwerten der Indizes ein Siebtel bis ein Zehntel. Gegenüber Opus 5.5 kostet es pro kurzer Aufgabe 0.29x so viel und auf den Indizes ein Achtel bis ein Zehntel.
- Es hält das Ausgabeformat zuverlässiger ein. Bei jedem Prompt, der nur die Antwort verlangte, gab es das geforderte Format zurück. Ebenso waren alle Dokumente mit vorgegebenen Bestandteilen vollständig.
- Die Korrektur der knappen Antworten ging zulasten der Geschwindigkeit. Die Antworten sind wieder so lang wie bei GPT-5.6 Sol, aber jedes Dokument dauert dreimal so lange wie mit GPT-6 Sol.
- Seine Fehler sind schwer zu erkennen. Die 7 falschen Antworten traten bei
low,mediumundxhighauf. Jede war eine korrekt formatierte ganze Zahl.
| Workload | Wahl | Zahlen |
|---|---|---|
| Ausgabe wird von Code geparst: Extraktion, Klassifikation, Einzelwerte | GPT-6.1 Sol bei medium oder high | bei 234 / 234 Antworten nur der gefragte Wert; $0.0021 pro Aufgabe bei medium |
| Mehrstufige Mathematik oder Logik, bei der ein falscher Wert teuer wird | Sonnet 5.5 oder GPT-6.1 Sol mit Prüfung des Ergebnisses | Sonnet 5.5 bei 234 / 234 richtig; GPT-6.1 Sol bei einer Aufgabe in 7 von 18 Aufrufen falsch |
| Chat und interaktive Tools, bei denen Latenz zählt | Sonnet 5.5 mit der Standardeinstellung | 3.9 s statt 5.7 s pro kurzer Aufgabe; 17.2 s statt 22.4 s pro Dokument |
| Agent-Loops, bei denen die Kosten pro Durchlauf wichtiger sind als die Latenz | GPT-6.1 Sol mit der Standardeinstellung | $0.0052 statt $0.0112 pro Durchlauf; 12.2 s statt 6.7 s |
| Dokumente mit Pflichtabschnitten | GPT-6.1 Sol oder Sonnet 5.5 mit großzügig angegebenem Umfang | 80 / 80 vollständig gegenüber 68 / 80; die Abweichungen lagen 1 bis 28 Wörter unter der Vorgabe |
| Schwierige, offene Aufgaben, bei denen der Spitzenwert zählt | Sonnet 5.5 oder Opus 5.5 bei max | öffentliche Indexwerte von 56 und 58 gegenüber 52, bei 7- bis 11-mal so hohen Kosten pro Aufgabe |
Unabhängig vom Modell solltest du jeden Wert prüfen, auf dessen Grundlage ein Programm handelt.
FAQ
Ist GPT-6.1 Sol günstiger als Claude Sonnet 5.5?
GPT-6.1 Sol kostet pro Aufgabe weniger als Sonnet 5.5, obwohl beide denselben Listenpreis von $2 / $10 haben. In unseren Tests lag es mit den jeweiligen Standardeinstellungen bei 0.49x pro Einzelaufgabe und 0.46x pro Tool-Loop-Durchlauf. Bei einem gleichen Artificial-Analysis-Wert von 52 kostete es $0.72 statt $2.74. Sonnet 5.5 war schneller und erreicht bei max höhere Werte.
Ist GPT-6.1 Sol so gut wie Claude Opus 5.5? GPT-6.1 Sol liegt auf dem Artificial Analysis Intelligence Index etwa 6 Punkte hinter Opus 5.5 (52 gegenüber 58), ebenso auf dem Vals Index (61.2% gegenüber 67.0%). Die Kosten pro Aufgabe betragen dabei ein Achtel bis ein Zehntel; in unseren Tests kostete es pro kurzer Aufgabe 0.29x so viel. In OpenAIs eigenen Messungen liegt es auf AutomationBench 2.2 Punkte vorn.
Kann ich Reasoning bei GPT-6.1 Sol noch abschalten?
Bei GPT-6.1 Sol ist low der niedrigste Effort-Wert. none, das GPT-6 Sol noch akzeptierte, gibt es nicht mehr. Verwende low; damit kostete eine Einzelaufgabe in unseren Durchläufen $0.0018.
Weitere Messungen: Claude Sonnet 5.5 vs. Sonnet 5, die Effort-Stufen von GPT-6 Astra und Stellschrauben für die Kosten von GPT-5.6.
Gemessen am 2026-09-30, einen Tag nach dem Release von GPT-6.1 Sol, über ein Gateway zur OpenAI Responses API und zur Anthropic Messages API: 234 Einzelaufrufe mit GPT-6.1 Sol (13 Aufgaben, 3 Wiederholungen, 6 Einstellungen), 800 Aufrufe für Geschäftsdokumente (80 Aufgaben mit bloßer Zielvorgabe bei 6 Kombinationen aus Modell und Effort, 80 mit vorgegebenen Bestandteilen bei 4 Kombinationen) und 36 Tool-Loop-Durchläufe. Die Zahlen für Einzelaufgaben und Tool-Loops von Sonnet 5.5 und Opus 5.5 stammen vom 2026-09-29 und basieren auf denselben Aufgaben. Die öffentlichen Benchmark-Werte wurden am 2026-10-01 auf den Seiten der Anbieter abgelesen.