
Claude Sonnet 5.5 vs Sonnet 5: 80% weniger bei gleichem Preis
Inhalt
- Was hat sich bei Claude Sonnet 5.5 geändert?
- Was zeigen die veröffentlichten Benchmarks?
- Wie haben wir gemessen?
- Ist Sonnet 5.5 pro Aufgabe günstiger als Sonnet 5?
- Wie viel kostet jede Effort-Stufe?
- Warum schreibt Sonnet 5.5 den Rechenweg in die Antwort?
- Was passiert in einem Tool-Loop?
- Ist Sonnet 5.5 schneller?
- Gelten die Token-Budgets von Sonnet 5 weiter?
- Welches Modell solltest du verwenden?
- FAQ
Claude Sonnet 5.5 hat dieselben Token-Preise wie Claude Sonnet 5: $2 pro Million Input-Token und $10 pro Million Output-Token. Einsparungen entstehen daher ausschließlich durch einen geringeren Token-Verbrauch. Bei 13 Single-Shot-Aufgaben mit den API-Standardeinstellungen kostete Sonnet 5.5 pro Aufgabe $0.0041, Sonnet 5 dagegen $0.021. Das sind 80% weniger, obwohl beide Modelle alle Aufgaben richtig lösten. Probleme gab es beim Ausgabeformat: Unterhalb der Effort-Stufe xhigh überspringt Sonnet 5.5 manchmal sein internes Reasoning und schreibt den Rechenweg direkt in die Antwort, selbst wenn der Prompt ausschließlich das Ergebnis verlangt.
TL;DR
- Mit den API-Standardeinstellungen kostete Sonnet 5.5 pro Aufgabe $0.0041, Sonnet 5 dagegen $0.021. Beide Modelle beantworteten alle 39 Aufrufe korrekt.
- Sonnet 5.5 kostete mit
low,mediumundhighungefähr gleich viel.maxkostete 3.5x so viel wie die Standardeinstellung. - Unterhalb von
xhighschrieb Sonnet 5.5 bei 68 von 156 Prompts, die nur das Ergebnis verlangten, den Rechenweg in die Antwort. Ein System-Prompt behob das Problem nicht. - In einem Tool-Loop mit vier Fragen kostete Sonnet 5.5 bei
max$0.042 pro Durchlauf und damit mehr als Opus 5.5 mit dessen Standardeinstellung ($0.033).
Anthropic veröffentlichte Sonnet 5.5 am 2026-09-28 und gab an, es sei 30% schneller und koste “bis zu 30% weniger pro Aufgabe” als Sonnet 5. Wir haben das Modell am folgenden Tag vermessen.
Was hat sich bei Claude Sonnet 5.5 geändert?
Der Preis blieb gleich, aber die Thinking-Steuerung und mehrere Request-Parameter haben sich geändert. Sonnet 5.5 verwendet adaptives Thinking: Das Modell entscheidet selbst, wie viel internes Reasoning vor der Antwort nötig ist. Diese Reasoning-Token werden als Output abgerechnet. Gesteuert wird das Verhalten über effort (output_config.effort in der Messages API), einen Request-Parameter mit fünf Stufen von low bis max. Der API-Standard ist high.
| Sonnet 5.5 | Sonnet 5 | Opus 5.5 | |
|---|---|---|---|
| Veröffentlicht | 2026-09-28 | 2026-06-30 | 2026-09-22 |
| Input / Output, pro 1M Token | $2 / $10 | $2 / $10 | $4 / $20 |
| Cache-Lesezugriff, pro 1M Token | $0.20 | $0.20 | $0.20 |
| Kontextfenster / maximaler Output | 1M / 128K | 1M / 128K | 1M / 128K |
| Wissensstand (nur Monat veröffentlicht) | Juni 2026 | Januar 2026 | Juni 2026 |
| Standard-Effort der API | high | high | medium |
| Niedrigste Thinking-Einstellung | between_tools (bei high oder niedriger) | disabled | nicht abschaltbar; Thinking ist immer aktiv |
| Mindestlänge cachefähiger Prompts | 512 Token | 1,024 Token | 512 Token |
Sonnet 5 wurde mit $2 / $10 als Einführungspreis veröffentlicht. Auf Anthropics Preisseite wird dieser inzwischen als regulärer Preis geführt. Die geplante Erhöhung auf $3 / $15 fand nicht statt.
Laut Migrationsleitfaden funktionierten die folgenden Requests mit Sonnet 5, führen bei Sonnet 5.5 aber zu HTTP 400:
thinking: {"type": "disabled"}. Verwende stattdessenthinking: {"type": "between_tools"}. Dadurch wird das Reasoning vor der ersten Antwort deaktiviert. Die Einstellung wird nur beihighoder niedriger akzeptiert.- Erzwungene Tool-Nutzung (
tool_choiceaufanyoder ein bestimmtes Tool gesetzt). Verwendeautound beschreibe im Prompt, wann das Tool eingesetzt werden soll. - Ein manuelles Thinking-Budget (
budget_tokens), nicht standardmäßige Werte fürtemperature,top_podertop_ksowie ein vorbefüllter Assistant-Turn, der die Modellantwort bereits beginnt. - Das erneute Senden eines Thinking-Blocks von Sonnet 5.5, nachdem der System-Prompt, die Tools oder eine frühere Nachricht geändert wurden. Dies gilt für Accounts, die ab 2026-08-31 erstellt wurden.
- Das ältere Computer-Use-Tool
computer_20251124in der Claude API und bei Google Cloud.
Eine Änderung erzeugt keinen Fehler: Kurze Hinweise, die das Modell zwischen Tool-Aufrufen schreibt, werden jetzt als thinking-Blöcke geliefert. Mit der standardmäßigen Anzeigeeinstellung sind sie leer. Eine Oberfläche, die diese Hinweise streamt, bleibt deshalb an diesen Stellen still.
Was zeigen die veröffentlichten Benchmarks?
In Anthropics eigener Tabelle liegt Sonnet 5.5 bei halb so hohen Token-Preisen nur wenige Punkte hinter Opus 5.5 und deutlich vor Sonnet 5.
| Benchmark (was gemessen wird) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (agentisches Coding im Terminal) | 70.6% | 10.3% | 66.4% (xhigh) | nicht veröffentlicht |
| CursorBench 4.0 (Coding in einem Editor) | 55.5% | 34.1% | 57.8% | nicht veröffentlicht |
| GDPval-AA v2.1 (Dokumente aus der Wissensarbeit, Elo-Wertung, höher ist besser) | 1844 | 1449 | 1846 | 1487 |
| OSWorld 2.1 (Computer-Nutzung, Teilpunkte möglich) | 80.1% | 57.0% | 81.8% | nicht veröffentlicht |
| Humanity’s Last Exam, mit Tools | 64.5% | 54.9% | 67.7% | nicht veröffentlicht |
Artificial Analysis weist auf die Kosten hin: Mit max erreichte Sonnet 5.5 im Intelligence Index 56 Punkte und lag damit zwei Punkte hinter Opus 5.5 bei max. Es verbrauchte jedoch rund 193K Output-Token pro Aufgabe. Das ist der höchste dort bisher gemessene Wert und rund 60% mehr als bei Opus 5.5 oder Sonnet 5 mit max. Die Kosten lagen bei etwa $7.60 pro Index-Aufgabe.
Wie haben wir gemessen?
Wir haben allen drei Modellen 13 Single-Shot-Aufgaben mit bekannten Lösungen geschickt, also jeweils einen Prompt, eine Antwort und keine Tools. Darunter waren acht kurze Aufgaben, etwa die Summe aller Primzahlen unter 60 oder die Anzahl der Ziffer 7 von 1 bis 500, sowie fünf Aufgaben mit mehreren nötigen Rechenschritten, darunter ein Rucksackproblem mit 10 Elementen, Pfade durch ein blockiertes 8x8-Gitter und 13 hoch 1,001 modulo 10,007. Alle Sollantworten wurden lokal per Brute Force ermittelt. Jeder Prompt endete mit “Antworte nur mit einer einzigen Ganzzahl und sonst nichts.” Jede Aufgabe lief dreimal mit der API-Standardeinstellung und mit jeder der fünf Effort-Stufen. Insgesamt waren es 702 Aufrufe über die native Messages API. Jeder Prompt enthielt eine eindeutige zufällige Zeichenfolge, damit keine Antwort aus einem Cache stammen konnte. Die Kosten wurden anhand von Anthropics Listenpreisen berechnet. Bewertet wurde, ob das Endergebnis korrekt war und ob die Antwort ausschließlich dieses Ergebnis enthielt.
Bei der Genauigkeit gab es kaum Unterschiede. Sonnet 5.5 beantwortete alle 234 Aufrufe korrekt. Sonnet 5 löste alle 233 zurückgegebenen Aufrufe richtig, ein weiterer endete mit einem Serverfehler. Opus 5.5 machte bei low und mit der Standardeinstellung jeweils einen Fehler.
Ist Sonnet 5.5 pro Aufgabe günstiger als Sonnet 5?
Sonnet 5.5 kostete mit der Standardeinstellung 80% weniger als Sonnet 5, bei low, medium und high waren es 77% bis 78% weniger. Der Grund: Sonnet 5.5 erzeugte nur ungefähr ein Fünftel so viele Output-Token. Da die Listenpreise identisch sind, stammt die gesamte Ersparnis aus der höheren Token-Effizienz. Sonnet 5 erzeugte unabhängig von der Effort-Stufe etwa 1,800 bis 2,100 Token pro Aufgabe. Sonnet 5.5 blieb bis xhigh bei ungefähr 400.
| Alle 13 Aufgaben, je Aufgabe | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| API-Standard | $0.0041 (396 Token) | $0.0212 (2,105) | $0.0070 (334) |
low | $0.0043 (409) | $0.0184 (1,817) | $0.0065 (309) |
medium | $0.0040 (383) | $0.0180 (1,780) | $0.0082 (393) |
high | $0.0043 (416) | $0.0188 (1,858) | $0.0088 (421) |
xhigh | $0.0059 (574) | $0.0202 (2,001) | $0.0105 (507) |
max | $0.0146 (1,438) | $0.0193 (1,909) | $0.0234 (1,149) |
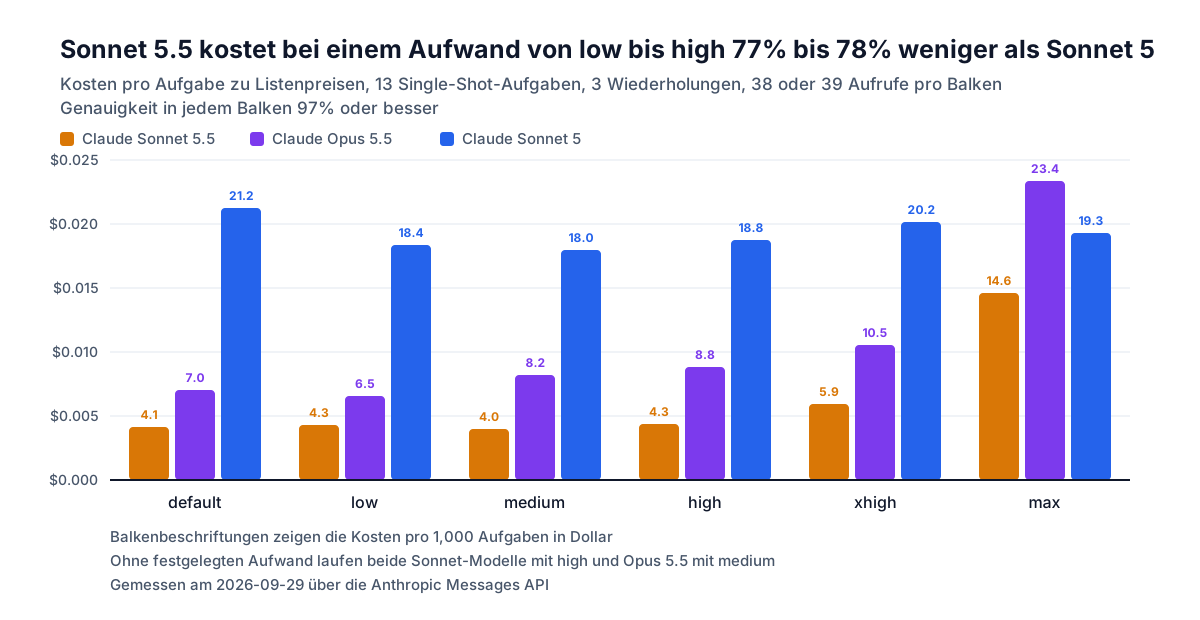
Die Token-Zahlen sind die durchschnittlichen Output-Token pro Aufruf einschließlich des Reasonings. Bei den fünf schwierigen Aufgaben beträgt die Ersparnis mit der Standardeinstellung 84% ($0.0057 gegenüber $0.0348). In unserem Tool-Loop, bei dem in jedem Turn das gesamte Transkript erneut gesendet wird und die Input-Token den Großteil der Kosten ausmachen, sind es 8%. Anthropics Angabe von “bis zu 30%” ist für einzelne Prompts wie diese konservativ, für einen kurzen Loop wie unseren dagegen großzügig.
Bei nur 13 Aufgaben hat die Ersparnis von 80% beim Standardwert eine große Spannweite: Ein Resampling der Aufgaben ergibt ein 95%-Intervall von 66% bis 85% weniger, und die untere Grenze liegt bei jeder Stufe von low bis xhigh über 50%.
Wie viel kostet jede Effort-Stufe?
Bei Sonnet 5.5 kosteten low, medium und high jeweils ungefähr $0.0042 pro Aufgabe. Die Standardeinstellung high verursachte in diesem Test also keine Mehrkosten. xhigh kostete etwa 40% mehr, max 3.5x so viel wie die Standardeinstellung. Mit max war Sonnet 5.5 pro Aufgabe doppelt so teuer wie Opus 5.5 mit dessen Standardeinstellung ($0.0146 gegenüber $0.0070), ohne bessere Genauigkeit.
Dieser flache Verlauf gilt nicht für jede Workload. Bei einer längeren DevOps-Aufgabe beobachtete ein anderer Tester, dass high ungefähr doppelt so viele Output-Token wie medium verbrauchte. Wenn Effort für eine Workload relevant ist, müssen die Stufen separat vermessen werden.
Warum schreibt Sonnet 5.5 den Rechenweg in die Antwort?
Unterhalb von xhigh verwendet Sonnet 5.5 nicht immer einen Thinking-Block. Wenn dieser Block fehlt, schreibt das Modell sein Reasoning direkt in die Antwort. Der Thinking-Block ist ein separater Teil der Response für das Reasoning des Modells. Sein Text ist standardmäßig leer, danach folgt die Antwort in einem text-Block.
Von den 234 Antworten von Sonnet 5.5 enthielten 166 einen Thinking-Block. Alle 166 bestanden ausschließlich aus dem Ergebnis. In den übrigen 68 Fällen stand zuerst der Rechenweg, etwa “09:47 + 3:46 = 13:33 … + 1:39 = 15:40”, gefolgt von “15:40”. Das Endergebnis war jedes Mal korrekt, das verlangte Ausgabeformat aber nicht.
| Antworten nur mit Ergebnis | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| API-Standard | 22 / 39 | 38 / 39 | 38 / 39 |
low | 12 / 39 | 37 / 39 | 38 / 39 |
medium | 24 / 39 | 37 / 39 | 39 / 39 |
high | 30 / 39 | 38 / 39 | 39 / 39 |
xhigh | 39 / 39 | 35 / 38 | 39 / 39 |
max | 39 / 39 | 37 / 39 | 39 / 39 |
Das Verhalten hängt von der Aufgabe ab: Wo es auftrat, zeigte Sonnet 5.5 den Rechenweg in allen drei Wiederholungen, außer bei einer Aufgabe mit dem Standardwert, wo es zweimal geschah. Das betraf 9 der 13 Aufgaben bei low, 6 beim Standardwert, 5 bei medium und 3 bei high (alles kurze Rechenaufgaben). Pro Aufgabe gezählt, bei nur 13 Aufgaben, übersteht keiner dieser Abstände eine Holm-Korrektur; die Zahlen sind daher Beobachtungen und keine Quote, mit der man planen kann. Die Abweichungen bei Sonnet 5 sehen anders aus: Dort erschien eine korrekte, fett formatierte Antwort mit einer kurzen Erklärung. Die Zeile für xhigh enthält nur 38 Aufrufe, weil einer mit einem Serverfehler endete.
Ein System-Prompt mit der Anweisung, “nur das Endergebnis” auszugeben und alle Zwischenschritte intern auszuführen, half nicht. Sonnet 5.5 lieferte bei 24 kurzen Aufgaben mit low achtmal und mit medium neunmal ausschließlich das Ergebnis. Ohne den System-Prompt waren es sechs beziehungsweise neun. xhigh behob das Problem: Jeder Aufruf enthielt einen Thinking-Block und ausschließlich das Ergebnis, kostete aber rund 40% mehr als low bis high. Für Code, der Modellantworten parst:
- Verwende
xhigh, wenn die Antwort zwingend aus genau einer Ergebniszeile bestehen muss. - Alternativ kann das Ergebnis aus der letzten nicht leeren Zeile gelesen werden. In allen 68 Fällen war diese Zeile korrekt.
- Anthropics Structured Outputs können die Antwort ebenfalls auf ein Schema beschränken. Diesen Weg haben wir nicht getestet.
import anthropic

client = anthropic.Anthropic()
prompt = "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else."
resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    output_config={"effort": "xhigh"},  # low, medium, high (API default), xhigh, max
    messages=[{"role": "user", "content": prompt}],
)
text = "".join(block.text for block in resp.content if block.type == "text")
lines = text.strip().splitlines()
answer = lines[-1] if lines else None  # below xhigh, working can precede the answer
print(answer, resp.usage.output_tokens)  # output_tokens includes the reasoning
Was passiert in einem Tool-Loop?
Mit der Standardeinstellung sowie bei low und medium löste Sonnet 5.5 jeden Durchlauf eines Code-Reading-Loops mit vier Fragen für rund $0.011. Das entspricht einem Drittel der Kosten von Opus 5.5. Bei max führte Sonnet 5.5 dreimal so viele Tool-Aufrufe aus und kostete mehr als Opus 5.5. Jedes Modell erhielt drei Tools zum Auflisten von Dateien, Lesen einer Datei und Suchen in einer kleinen synthetischen Codebasis. Für jede Antwort waren 3 bis 6 Abfragen über mehrere Dateien nötig.
| Tool-Loop, jeweils 12 Durchläufe | Gelöst | Mediane Turn-Zahl | Tool-Aufrufe pro Durchlauf | Kosten pro Durchlauf | Mediane Gesamtlaufzeit |
|---|---|---|---|---|---|
| Sonnet 5.5, Standard | 12 / 12 | 3 | 4.8 | $0.0112 | 6.7 s |
Sonnet 5.5, low | 12 / 12 | 3 | 4.9 | $0.0112 | 7.4 s |
Sonnet 5.5, medium | 12 / 12 | 3 | 5.1 | $0.0113 | 6.8 s |
Sonnet 5.5, max | 12 / 12 | 4 | 14.7 | $0.0422 | 20.1 s |
| Opus 5.5, Standard | 12 / 12 | 4 | 5.3 | $0.0332 | 25.3 s |
| Sonnet 5, Standard | 11 / 12 | 3.5 | 4.2 | $0.0122 | 15.8 s |
Von VentureBeat veröffentlichte Kundenaussagen berichten von weniger Tool-Aufrufen als bei Sonnet 5, bei Lovable etwa ein Drittel weniger. Unser Loop ist zu kurz, um diesen Effekt zu zeigen. Sonnet 5.5 führte 4.8 Aufrufe pro Durchlauf aus, Sonnet 5 nur 4.2. Trotzdem kostete Sonnet 5.5 8% weniger und war in weniger als der halben Zeit fertig.
Ist Sonnet 5.5 schneller?
Sonnet 5.5 war vor allem deshalb früher fertig, weil es weniger schrieb. Die mediane Gesamtlaufzeit vom Senden des Requests bis zum vollständigen Empfang der Response betrug bei einer Single-Shot-Aufgabe mit der Standardeinstellung 3.9 Sekunden für Sonnet 5.5, 8.1 Sekunden für Sonnet 5 und 5.5 Sekunden für Opus 5.5. Gemessen an den Output-Token pro Sekunde Gesamtlaufzeit waren beide Sonnet-Modelle ungefähr gleich schnell (88 gegenüber 91). Die Wartezeit halbierte sich, weil Sonnet 5.5 nur ein Fünftel der Token erzeugte, nicht weil die Token schneller generiert wurden. Bei den schwierigen Aufgaben lagen die Werte bei 5.8 Sekunden gegenüber 21.0.
Gelten die Token-Budgets von Sonnet 5 weiter?
Kontextbudgets und max_tokens-Grenzen, die für Sonnet 5 festgelegt wurden, sollten weiter passen. Laut Anthropics Migrationsleitfaden nutzt Sonnet 5.5 denselben Tokenizer, und die vier festen Texte, die wir getestet haben (englischer Fließtext, Python-Code, JSON-Tool-Argumente, chinesischer Fließtext), ergaben auf beiden Modellen und auf Opus 5.5 identische Token-Zahlen, zum Beispiel 1,270 Tokens für den englischen und 493 für den chinesischen Text; Sonnet 5.5 und Opus 5.5 rechnen pro Anfrage 2 feste Tokens mehr. Anfragen mit Tools werden beim Input etwas günstiger: Laut Anthropics Preisseite umfasst der versteckte System-Prompt für die Tool-Nutzung auf Sonnet 5.5 286 Tokens, auf Sonnet 5 dagegen 354.
Welches Modell solltest du verwenden?
Für die meisten Workloads mit Sonnet 5 lohnt sich der Wechsel. Danach muss nur noch die passende Effort-Stufe gewählt werden.
| Workload | Darauf achten | Empfehlung | Zahlen |
|---|---|---|---|
| Per Code geparster Output: Extraktion, Klassifikation, einzelne Werte | Unterhalb von xhigh kann der Rechenweg in der Antwort stehen | Sonnet 5.5 mit xhigh oder medium und die letzte Zeile parsen | nur Ergebnis: 39 / 39 bei xhigh, 24 / 39 bei medium; xhigh rund 40% teurer |
| Chat und Texte für Nutzer | Latenz und Kosten | Sonnet 5.5 mit medium | $0.0040 pro Aufgabe, Median 3.9 s |
| Agent-Loops mit Tools | max vervielfacht die Tool-Aufrufe | Sonnet 5.5 mit der Standardeinstellung oder medium; vor Sonnet 5.5 mit max besser zu Opus 5.5 wechseln | $0.011 pro Durchlauf mit der Standardeinstellung, $0.042 bei max, $0.033 mit Opus 5.5 |
| Sonnet-5-Code, der Thinking deaktiviert oder ein Tool erzwingt | HTTP 400 nach dem Modellwechsel | between_tools (bei high oder niedriger) und tool_choice: auto | Anthropics Migrationsleitfaden |
Unabhängig von der Effort-Stufe sollte der Code zwei Prüfungen enthalten: Die Antwort muss die vom Parser erwartete Struktur haben, und die Output-Token pro Request brauchen ein Limit. Bei einzelnen Prompts erhöhte max die Kosten pro Aufgabe um den Faktor 3.5x, im Loop verdreifachte sich die Anzahl der Tool-Aufrufe.
FAQ
Ist Sonnet 5.5 günstiger als Opus 5.5?
Mit den jeweiligen Standardeinstellungen kostete Sonnet 5.5 pro Single-Shot-Aufgabe 41% weniger als Opus 5.5 und pro Tool-Loop-Durchlauf nur ein Drittel so viel. Bei max kehrt sich die Reihenfolge um: Sonnet 5.5 kostete bei Single-Shot-Aufgaben doppelt so viel wie Opus 5.5 mit dessen Standardeinstellung und pro Tool-Loop-Durchlauf 27% mehr.
Welche Effort-Stufe sollte ich bei Sonnet 5.5 verwenden?
Sonnet 5.5 kostete bei unseren Aufgaben mit low, medium und high ungefähr gleich viel ($0.0040 bis $0.0043). Für Chats und Tool-Loops ist medium daher ein sinnvoller Ausgangspunkt. Verwende xhigh, wenn Code die Antwort als einzelnen Wert parst. max kostete 3.5x so viel wie die Standardeinstellung.
Kann ich Thinking bei Sonnet 5.5 weiterhin deaktivieren?
Sonnet 5.5 lehnt thinking: {"type": "disabled"} mit HTTP 400 ab. Verwende stattdessen thinking: {"type": "between_tools"}. Diese Einstellung wird bei low, medium und high akzeptiert.
Weitere Messungen: Claude Opus 5.5 im Vergleich zu Opus 5, der Tokenizer von Claude Sonnet 5 und Thinking-Steuerungen verschiedener Anbieter.
Gemessen am 2026-09-29, einen Tag nach der Veröffentlichung, über ein Gateway zur Anthropic Messages API. 702 bewertete Single-Shot-Aufrufe (13 Aufgaben mit per Brute Force ermittelten Sollantworten, 3 Wiederholungen, 6 Effort-Einstellungen, 3 Modelle), 48 Aufrufe zum Test einer System-Anweisung für das Ausgabeformat, 72 Tool-Loop-Durchläufe (4 Fragen mit mehreren nötigen Schritten, 3 Wiederholungen, 6 Einstellungen) sowie Token-Zählungen für vier feste Texte pro Modell. Prompts wurden mit zufälligen Zusätzen versehen, die Kosten anhand von Anthropics Listenpreisen berechnet.