
Prompt-Cache-Misses: Fünf Checks vor der Routing-Analyse
Inhalt
- Was solltest du zuerst prüfen, wenn Cache-Treffer ausbleiben?
- Welche Anwendungseinstellungen und Zeitabläufe solltest du prüfen?
- Was kann ein Gateway zwischen Client und Anbieter verändern?
- Wie untersuchst du eine Cache-Verschlechterung in Synthorai?
- Eine gemessene Sitzung: Verschlechterung finden, dann die Spans prüfen
- Wie helfen native Diagnosen, eine geänderte Anfrage zu erkennen?
- Wann solltest du den Inferenzdienst selbst untersuchen?
- Wie weist du nach, dass eine Korrektur wirkt?
- FAQ
- Garantiert cache_control einen Treffer?
- Kann das Routing einen Cache-Miss verursachen, obwohl der Modellname gleich bleibt?
- Warum melden Diagnosen eine geänderte Anfrage, obwohl einige Tokens aus dem Cache kamen?
Prüfe bei einem Miss im Prompt-Cache zuerst die Nutzungsdaten. Vergleiche danach das wiederverwendbare Präfix, die Cache-Voraussetzungen, das Timing und das tatsächliche Upstream-Ziel mit einer Referenzanfrage, deren Cache bereits gefüllt ist.
TL;DR
- Fehlende Cache-Nutzungsdaten bedeuten einen unbekannten Zustand. Gemeldete Lesezugriffe von null verraten noch nicht die Ursache.
- Die Request-Trefferrate zählt Anfragen mit beliebiger Wiederverwendung. Der Token-Wiederverwendungsanteil misst, wie viel der Eingabe wiederverwendet wurde.
- Native Diagnosezustände verlangen unterschiedliche Maßnahmen: eine Abweichung beheben, eine fehlende Referenz ersetzen oder einen nicht eindeutigen Vergleich untersuchen.
- DeepSeek benötigt passende persistierte Präfixeinheiten. Ein gemeinsames Textpräfix allein reicht möglicherweise nicht.
Was solltest du zuerst prüfen, wenn Cache-Treffer ausbleiben?
Prüfe zuerst, ob die unverarbeitete Antwort überhaupt Cache-Nutzungsdaten enthält. Meldet der Anbieter Lesezugriffe, der Client oder das Dashboard aber nicht, untersuche zuerst die Erfassung und Darstellung. Sichere andernfalls die letzte Anfrage mit bestätigtem Cache-Treffer und vergleiche die betroffene Anfrage damit.
| Erster Check | Benötigte Belege | Kleinster sinnvoller nächster Schritt |
|---|---|---|
| Ist der Miss tatsächlich belegt? | Unveränderte Nutzungsdaten des Anbieters, Client-Antwort und Dashboard-Eintrag | Fehlende Felder und Streaming-Aggregation prüfen, bevor du Prompts änderst |
| Hat sich das Präfix geändert? | Geordnete Tools, Systemtext und frühere Nachrichten | Komponenten vergleichen; wechselnde Zeitstempel oder Request-IDs hinter wiederverwendbare Inhalte verschieben |
| War das Präfix geeignet und wurde es geschrieben? | Modellminimum, Steuerungsparameter, Nutzungsdaten zu Lese- und Schreibzugriffen | Das konkrete Modell und die API prüfen; den vorgesehenen Breakpoint untersuchen |
| Kam die Anfrage zu früh oder zu spät? | Antwortbeginn, Abstand zwischen Anfragen, Cache-Lebensdauer | Vor dem Test mit parallelem Traffic eine Folgeanfrage sequenziell ausführen |
| Hat sich das Ziel geändert? | Tatsächlich verwendetes Modell, Dienst, Kontokontext und Fallback-Versuche | Den Gateway-Betreiber bitten, die tatsächlichen Upstream-Versuche zu vergleichen |
Verwende zwei klar benannte Kennzahlen für Anfragen mit vollständigen Eingabe- und Cache-Nutzungsdaten:
- Request-Trefferrate = Anfragen mit mehr als null aus dem Cache gelesenen Tokens / Anfragen mit vollständigen Nutzungsdaten.
- Token-Wiederverwendungsanteil = Summe der aus dem Cache gelesenen Tokens / Summe aller Eingabe-Tokens, einschließlich gecachter Eingaben und Cache-Schreibzugriffen.
Weise Anfragen mit fehlenden Nutzungsdaten separat aus und rechne fehlgeschlagene Versuche in die Incident-Kosten ein. Eine wachsende Eingabe kann den Token-Wiederverwendungsanteil senken, ohne die Request-Trefferrate zu verändern.
| Native API | Feld für Cache-Lesezugriffe | Gesamteingabe im Nenner des Token-Anteils |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens, enthält bereits gecachte Eingaben |
| Anthropic Messages | usage.cache_read_input_tokens | input_tokens + cache_read_input_tokens + cache_creation_input_tokens innerhalb von usage |
| DeepSeek | usage.prompt_cache_hit_tokens | prompt_cache_hit_tokens + prompt_cache_miss_tokens innerhalb von usage |
Wenn native Felder konvertiert wurden, verwende das normalisierte Schema des Gateways. Die Formel für Synthorai steht weiter unten.
Welche Anwendungseinstellungen und Zeitabläufe solltest du prüfen?
Prüfe, ob sich Inhalte vor dem erwarteten wiederverwendbaren Präfix geändert haben. Gute Ausgangspunkte sind Zeitstempel im Systemtext, die Tool-Reihenfolge und umgeschriebene Historien.
Präfixänderungen. Erfasse separate Fingerprints (Hashes zur Änderungserkennung) für die geordneten Tool-Definitionen, den stabilen Systemtext und frühere Nachrichtenblöcke. Platziere einen anfragespezifischen Marker am Ende. Ein Hash über die gesamte Anfrage ändert sich schon dann, wenn eine Unterhaltung regulär durch Anhängen wächst. Die erste Abweichung lässt sich damit nicht lokalisieren. Auch Leerraum in JSON außerhalb von Text ist etwas anderes als Leerraum innerhalb einer Zeichenkette, die das Modell sieht.
Prüfe die Platzierung abgerufener Inhalte, Moduswechsel, die Kontextkomprimierung und die endgültige Anfrage des Frameworks. Vergleiche bei multimodalen Eingaben auch die Vorverarbeitung und Dateireferenzen.
Voraussetzungen und Steuerungsparameter. Ein Breakpoint markiert das Ende des Präfixes, das gecacht werden soll. Die Time to Live (TTL) ist die konfigurierte Lebensdauer des Cache-Eintrags.
Eine insgesamt lange Anfrage garantiert nicht, dass das ausgewählte wiederverwendbare Präfix die Mindestlänge des Modells erreicht. Prüfe bei expliziten Breakpoints den Inhalt vor dem Breakpoint. cache_control macht ein ansonsten ungeeignetes Präfix nicht wiederverwendbar. Prüfe bei Anthropic automatische und blockbezogene Steuerung, TTL-Konflikte und Breakpoint-Limits. Eine ungültige Kombination kann HTTP 400 auslösen: Die Anfrage wird dann abgewiesen, statt erfolgreich mit null Cache-Lesezugriffen beantwortet zu werden. Prompt-Caching bei Anthropic.
Verfügbarkeit und Ablauf. Wenn du einen Schwall identischer Anfragen sendest, bevor der erste Schreibvorgang verfügbar ist, können mehrere Anfragen auf einen kalten Cache treffen. Laut Anthropic ist der Cache nach Beginn der ersten Antwort verfügbar. Sende nach diesem Antwortbeginn eine Folgeanfrage, um eine Referenz mit gefülltem Cache zu erhalten. Vergleiche anschließend parallele Anfragen anhand ihrer jeweiligen Antwortbeginn-Zeitstempel. Vergleiche bei einer inaktiven Unterhaltung die Pause mit der konfigurierten Cache-Lebensdauer und dem dokumentierten Verhalten zur Verlängerung. Cache-Verfügbarkeit bei Anthropic.
Persistierte Einheiten bei DeepSeek. DeepSeek gleicht vollständige persistierte Präfixeinheiten ab, also gespeicherte Abschnitte früheren Kontexts. Das dokumentierte Beispiel beginnt mit A+B, gefolgt von A+C: Die zweite Anfrage kann die vollständige Einheit A+B nicht wiederverwenden. Nachdem der Dienst das gemeinsame Präfix A erkannt und persistiert hat, kann eine dritte Anfrage A+D diese Einheit nutzen. Dabei ist A der stabile Kontext; B, C und D sind unterschiedliche Suffixe. Diesen Mechanismus beschreibt der Anbieter. Er stammt nicht aus unseren Messungen.
Behalte für dieses Muster A exakt bei, schließe die ersten beiden Anfragen sequenziell ab und berücksichtige, dass die Persistierung Sekunden dauern kann. Prüfe dann die Hit-/Miss-Token-Felder der dritten Anfrage. Bloßes Warten garantiert nicht, dass die gewünschte gemeinsame Präfixeinheit angelegt wurde. Das Caching erfolgt weiterhin nach dem Best-Effort-Prinzip. Persistierungsregeln von DeepSeek.
Was kann ein Gateway zwischen Client und Anbieter verändern?
Ein Gateway kann sowohl die tatsächlich gesendete Anfrage als auch die an den Client zurückgegebenen Belege verändern. Prüfe beides getrennt, bevor du eine Verschlechterung dem Routing zuschreibst.
Prüfe Modell-Aliasse, den Geltungsbereich der Zugangsdaten, Policy-Overrides und Fallback-Versuche. Untersuche bei einer Protokollkonvertierung die ausgehenden Steuerungsparameter und die zurückgegebenen nativen Felder. Vergleiche beim Streaming die Upstream-Nutzungsereignisse mit den endgültigen Nutzungsdaten des Clients.
Routing-Drift zwischen Anbietern. Lastverteilung oder Failover können dasselbe öffentlich angebotene Modell auf unterschiedliche Inferenzanbieter mit getrennten Caches verteilen. Ein bei Anbieter A gefülltes Präfix ist bei Anbieter B dann nicht verfügbar. Unsere Studie zur Anbieterdrift erfasste neun Upstreams und 4/20 Request-Treffer, gegenüber 19/20 im Vergleich mit einem einzelnen Backend. Diese Werte beschreiben die damalige Konfiguration.
Gruppiere die Versuche nach Anbieter, Modell und Kontokontext. Vergleiche innerhalb jeder Gruppe die Cache-Lesezugriffe bei stabilen Präfixen und Anfrageabständen. Beziehe Fehler und Fallback-Ziele ein. Bitte den Betreiber, die Affinität (konsistentes Routing zusammengehöriger Anfragen) und das Failover zu prüfen. Wiederhole den Vergleich nach einer freigegebenen Anpassung. Anbieterwechsel belegen eine Drift. Einzelne Misses erfordern trotzdem eine Prüfung von Timing und Cache-Voraussetzungen.
Bei Synthorai-Anfragen lässt sich kein Anbieter oder Kanal auswählen.
Wie untersuchst du eine Cache-Verschlechterung in Synthorai?
Nutze Analytics für Workload-Trends und Logs für einzelne Anfragen. Die Bezeichnungen wurden am 6. November 2026 im laufenden System überprüft.
- Workload eingrenzen. Wähle in Analytics
Time rangeundAll keys · all models. Nutze in LogsAdd filtermitmodeloderkey. Verwende für den normalen und den betroffenen Zeitraum dieselbe Auswahl.CACHE HITist ein Token-Wiederverwendungsanteil, keine Request-Trefferrate. - Anfrage prüfen. Vergleiche in
OverviewunterCost at your ratedie Werte für Input, Cache read, Output und gegebenenfalls Schreibzugriffe. Stabile Lesezugriffe bei wachsender Eingabe sprechen für zunehmenden Kontext. Sinkende Lesezugriffe bei steigenden Schreibzugriffen sind ein Anlass, Präfix und Timing zu prüfen.Rawenthält gespeicherte Felder, nicht die ursprüngliche Antwort des Anbieters. - Trace und Sitzung verfolgen. Wähle bei der betroffenen Anfrage in Logs
Open traceund danachOpen session. Vergleiche unterTraces in this sessiondie Aufgaben und öffne den Trace ohne Wiederverwendung. Klicke auf jeden Span (einzelne Operation), um Cache-Lese- und -Schreibzugriffe sowie Kosten zu prüfen. Das Wasserfalldiagramm allein zeigt keine Cache-Wiederverwendung. Nutze die Logs-Filtersessionodertracefür die zugrunde liegenden Datensätze. Sichere Links, Zeitstempel und native Response-IDs für die Eskalation.
Sende X-Session-Id pro Unterhaltung, X-Trace-Id pro Aufgabe und X-Span-Id pro Operation. Gruppiere nach Modell und dem vorgesehenen gemeinsamen Präfix, bevor du Cache-Trends interpretierst.
Korrelation und Routing sind getrennte Funktionen: Für die Gateway-Affinität hat X-Session-Id außerdem Vorrang vor dem Cache-Key im Body. X-Trace-Id gruppiert nur Beobachtungen. Halte die Sitzungsidentität während der Vergleiche stabil. Keiner der beiden Header garantiert einen gemeinsamen Cache oder ein festes Ziel. Fasse keine unabhängigen Unterhaltungen zusammen, nur um Treffer zu erzielen.
Berechne die Token-Wiederverwendung für vollständige gespeicherte Synthorai-Datensätze so:
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)
cached_tokens ist hier bereits in prompt_tokens enthalten. Erneutes Addieren würde Eingaben doppelt zählen. Cache-Schreibzugriffe gehören in den Nenner, nicht in den Zähler. Schließe Datensätze ohne Nutzungsdaten aus und weise ihre Anzahl separat aus. Eine gespeicherte Null allein beweist nicht, dass der Upstream tatsächlich einen gemessenen Nullwert geliefert hat.
Eine gemessene Sitzung: Verschlechterung finden, dann die Spans prüfen
Im Anschluss an unsere Untersuchung der Agentenkosten haben wir am 6. November 2026 sechs sequenzielle Responses-Anfragen über Synthorai mit GPT-6.1 Sol gesendet. Eine Sitzung enthielt drei Traces mit jeweils zwei Aufrufen, bezeichnet als lookup-1 und lookup-2. Die Bezeichnungen stehen für synthetische Modellaufrufe; ein Lookup-Tool wurde nicht ausgeführt. Modell, Tools und Sitzungs-ID blieben unverändert. Für die gezielte Störung wurde jeder Anfrage ein neuer zeitstempelähnlicher Wert vorangestellt. Die Korrektur stellte das ursprüngliche Präfix wieder her. Die Request-Marker blieben am Ende.
| Trace | Eingabe-Tokens | Cache-Lesezugriffe | Wiederverwendung | Gemeldete Kosten |
|---|---|---|---|---|
| Referenz | 4,729 | 2,273 | 48.1% | $0.0063923 |
| Störung | 4,764 | 0 | 0% | $0.0119350 |
| Korrektur | 4,732 | 4,546 | 96.1% | $0.0009446 |
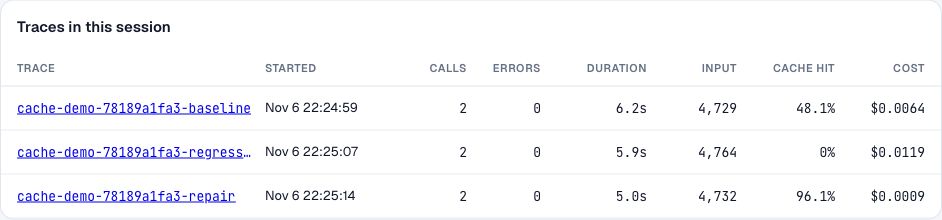
Öffne unter Traces in this session die Störungszeile ohne Wiederverwendung. Die Referenz enthält einen ersten Aufruf mit kaltem Cache; die Korrektur nutzt ein bereits gecachtes Präfix. Diese Demonstration mit sechs Aufrufen zeigt den eingebauten Fehler und seine Behebung, keine erwartbare Einsparquote im Produktivbetrieb. Über die gesamte Sitzung beträgt die Wiederverwendung 6,819 / 14,225 = 47.9%. Dieser Durchschnitt verdeckt die Störung.
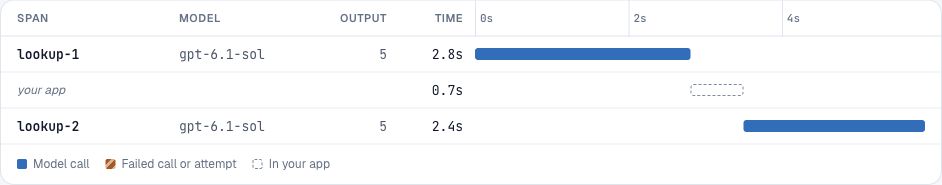
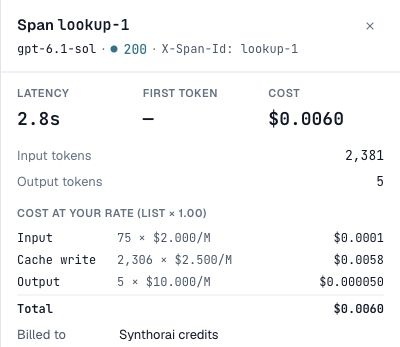
Wähle im Wasserfalldiagramm lookup-1. Die Detailansicht zeigt 2,306 in den Cache geschriebene Tokens bei 2,381 Eingabe-Tokens. Das passt zum Neuaufbau des geänderten Präfixes. Die gespeicherten synthetischen Anfragen belegen die eingebaute Abweichung; aus dem Zeitverlauf allein lässt sie sich nicht erkennen. Öffne den Request-Datensatz über Open in Logs und vergleiche die anwendungsseitigen Präfix-Fingerprints.
In dieser Demonstration wurden keine nativen Diagnosevergleiche angefordert. Die eingebaute Präfixänderung und die gemeldeten Nutzungsdaten belegen die beobachtete Verschlechterung und Erholung. Ob der tatsächliche Anbieter durchgehend derselbe blieb, wurde nicht unabhängig überprüft. Die Sitzungsidentität blieb konstant. Das Experiment misst daher keinen Vorteil durch Affinität.
Unterscheide bei BYOK vor dem Rechnungsabgleich zwischen vom Anbieter gemeldeten und geschätzten Kosten. Hole für nicht verfügbare Ziel- und Fallback-Details Belege vom Betreiber ein.
Wie helfen native Diagnosen, eine geänderte Anfrage zu erkennen?
Native Diagnosen erkennen Unterschiede zwischen Anfragen; Nutzungsdaten messen die gemeldete Wiederverwendung. Werte beides zusammen aus. Der gewählte Gateway-Pfad muss die nativen Felder unterstützen und erhalten. Unser früherer Vergleichstest über Synthorai lieferte keine Diagnosen. Die Dokumentation des Anbieters allein belegt deshalb nicht, dass sie über das Gateway verfügbar sind.
OpenAI Responses akzeptiert bei unterstützten Modellen prompt_cache_options.comparison_response_id. Bewahre die Response-ID der abgeschlossenen Referenzanfrage auf und sende den tatsächlichen Inhalt der Folgeanfrage mit. Die Vergleichsreferenz lädt keine Unterhaltungshistorie. Die Ergebnisse stehen in prompt_cache_diagnostics, beim Streaming auch im Ereignis response.completed. Wähle anhand der folgenden Zustände den nächsten Schritt. Die Token-Schätzungen der Diagnostik sind von den abgerechneten Nutzungsdaten getrennt. Cache-Diagnostik von OpenAI.
Anthropic Messages verwendet diagnostics: {"previous_message_id": null} zur erstmaligen Aktivierung. Bei späteren Anfragen mit aktivierter Diagnostik wird die vorherige native Message-ID angegeben. Beim Streaming erscheint das Ergebnis in message_start. Interpretiere ein Null-Ergebnis erst, nachdem du geprüft hast, dass die Diagnostik für beide Anfragen aktiviert war und die Folgeanfrage eine echte Referenz enthielt. Anthropic dokumentiert die Diagnostik für die Claude API, nicht für Amazon Bedrock oder von Google verwaltetes Claude. Cache-Diagnostik von Anthropic.
| API und zurückgegebener Zustand | Bedeutung | Nächster Schritt |
|---|---|---|
OpenAI cache_hit | Der Vergleich hat keinen Miss erkannt | Wiederverwendung anhand der Nutzungsdaten quantifizieren; neue Suffix-Tokens müssen möglicherweise trotzdem verarbeitet werden |
OpenAI cache_miss | Eine klassifizierte Abweichung hat die erwartete Wiederverwendung beeinträchtigt | reason prüfen, die betreffende Komponente korrigieren und erneut vergleichen |
OpenAI comparison_response_not_found | Referenzdatensatz fehlt oder ist abgelaufen | Eine kürzlich abgeschlossene Antwort aus derselben Organisation wählen |
OpenAI unavailable | Vergleich nicht unterstützt oder nicht eindeutig | Modellunterstützung prüfen; eine aktuelle Referenz versuchen, bei anhaltendem Problem manuell prüfen |
Anthropic diagnostics: null | Nur nach einem gültigen Vergleich mit aktivierter Diagnostik bedeutet dies keine Abweichung; wird auch ohne Aktivierung oder im ersten Turn zurückgegeben | Zuerst Aktivierung und Referenz prüfen; bei gültiger Übereinstimmung und wenigen Lesezugriffen die Cache-Verfügbarkeit prüfen |
Anthropic cache_miss_reason: null innerhalb eines Diagnoseobjekts | Vergleich steht noch aus | Den nächsten Turn mit aktivierter Diagnostik prüfen; ein ausstehendes Ergebnis nicht als Miss einstufen |
Anthropic Grundtyp *_changed | Erste erkannte abweichende Komponente | Diese Komponente korrigieren und erneut vergleichen; spätere Abweichungen können weiterhin bestehen |
Anthropic previous_message_not_found | Kein gespeicherter Referenz-Fingerprint | Aktivierung bei der vorherigen Anfrage, Organisation/Workspace und verstrichene Zeit prüfen; eine neue Referenz anlegen |
Anthropic unavailable | Kein eindeutiger Vergleich, unter anderem bei bestimmten weiteren Parameteränderungen oder Vergleichslimits | Tatsächliche Werte für tool_choice, Thinking-/Ausgabeeinstellungen und Beta-Header vergleichen; bei anhaltendem Problem manuell prüfen |
| Diagnosefeld fehlt bei einer der APIs | Belege fehlen | API-/Modellunterstützung, Request-Optionen, Konvertierung und Erfassung von Streaming-Ereignissen prüfen |
Bei OpenAIs prompt_cache_key_changed ist besondere Vorsicht nötig: Die Nutzungsdaten können einen Miss melden, ohne dass ein physischer Cache-Miss vorliegt. Prüfe, ob der Key bewusst für eine getrennte Abrechnung geändert wurde, bevor du das Ergebnis der Cache-Verfügbarkeit zuschreibst. Halte den Key innerhalb der vorgesehenen Abrechnungsgruppe stabil und prüfe zugleich seine Rolle für die Gateway-Affinität. Diagnosegründe von OpenAI.
Wann solltest du den Inferenzdienst selbst untersuchen?
Untersuche die Cache-Verfügbarkeit, nachdem du geeignete Inhalte, gültiges Timing, einen vergleichbaren Zielkontext und verlässliche Nutzungsdaten bestätigt hast. Auch dann garantieren unveränderte Eingaben nicht, dass ein wiederverwendbarer Eintrag vorhanden ist.
Mögliche Erklärungen sind abgelaufene Einträge, unvollständige Persistierung, Kapazitätsengpässe und dienstseitiges Scheduling. OpenAI dokumentiert Einschränkungen bei Cache-Routing und Verfügbarkeit. Ein Sitzungslabel garantiert keinen Zugriff auf einen bestimmten Worker. Ein partieller Treffer kann auch bedeuten, dass ein früheres Präfix weiter nutzbar ist, während spätere Inhalte verarbeitet werden müssen. Prompt-Caching bei OpenAI.
Ein langsames erstes Token oder null Lesezugriffe beweisen keinen Clusterwechsel. Gib bei einer Eskalation native Response-IDs, Zeitstempel, Anfrageabstände und Zielbezeichnungen weiter. Ohne Belege des Anbieters bleibt der Mechanismus ungeklärt.
Explizite Cache-Ressourcen erfordern einen zusätzlichen Check: Prüfe Existenz, Ablauf und Geltungsbereich des referenzierten Objekts. Verwende bei einer veralteten expliziten Ressourcen-ID nicht dieselben Diagnoseannahmen wie beim automatischen Präfix-Caching.
Wie weist du nach, dass eine Korrektur wirkt?
Vergleiche normalen, betroffenen und korrigierten Traffic anhand von Nutzungsdaten, Diagnosen und Zielen.
Rechne Wiederholungsversuche in die Kosten ein. Eine Korrektur der Datenerfassung sollte native und clientseitige Nutzungsdaten in Einklang bringen. Eine Präfixkorrektur sollte die Abweichung beseitigen und eine vergleichbare Wiederverwendung herstellen. Eine Routing-Korrektur sollte das vorgesehene Ziel und die Erholung innerhalb dieses Zielkontexts bestätigen. Ist die jeweilige Bedingung nicht erfüllt, bleibt der Fall ungeklärt. Setze die Untersuchung mit den übrigen Belegen fort.
FAQ
Garantiert cache_control einen Treffer?
Auch Cache-Steuerungsparameter unterliegen den Anforderungen an Präfixlänge, Platzierung, Verfügbarkeit und Lebensdauer. Prüfe die Modellanforderungen und die unveränderten Nutzungsdaten.
Kann das Routing einen Cache-Miss verursachen, obwohl der Modellname gleich bleibt?
Ein unveränderter Modellname im Client kann zu unterschiedlichen Anbietern, Modellen oder Kontokontexten aufgelöst werden. Vergleiche die tatsächlichen Versuche zusammen mit dem Gateway-Betreiber anhand des Runbooks zur Anbieterdrift.
Warum melden Diagnosen eine geänderte Anfrage, obwohl einige Tokens aus dem Cache kamen?
Eine Änderung weit hinten in der Anfrage kann ein früheres Präfix wiederverwendbar lassen. Betrachte die geänderte Komponente zusammen mit der absoluten Zahl der aus dem Cache gelesenen Tokens. Diagnosevergleich und Cache-Abrechnung beschreiben unterschiedliche Aspekte der Anfrage.
Weitere Untersuchungsansätze findest du im Gateway-Cache-Audit, bei den Kosten von Cache-Schreibzugriffen und beim Timing der Kontextkomprimierung.