
Kontextkomprimierung: Nach wie vielen Anfragen lohnt sie sich?
Inhalt
- Welches Problem soll die Kontextkomprimierung lösen?
- Szenario 1: Was tun, wenn dem Modell der Kontext ausgeht?
- Szenario 2: Vor einer höheren Preisstufe komprimieren?
- Szenario 3: Nach wie vielen weiteren Anfragen lohnt sich eine Komprimierung?
- Geht durch die Komprimierung der Aufpreis fürs Cache-Schreiben verloren?
- Wie gut passt eine Amortisationsformel zu den Messwerten?
- Was ändert sich mit DeepSeeks implizitem Cache?
- Wie beeinflusst das Wachstum den Zeitpunkt der Komprimierung?
- Welches Intervall legt das Modell für fortlaufende Arbeit nahe?
- Wie sollten Sie die Gesamtkosten messen?
- Welche Strategie sollten Sie einsetzen?
- FAQ
- Senkt Kontextkomprimierung immer die API-Kosten?
- Sollte ich genau an einer Preisgrenze komprimieren?
- Kann ich warten, bis das Kontextfenster voll ist?
- Amortisiert sich eine Zusammenfassung bei schnellerem Kontextwachstum immer früher?
- Sollte ich wegen implizitem Caching bis zur Kontextgrenze warten?
Die Kontextkomprimierung bei Claude Sonnet 5.5 hatte ihre Kosten in sechs Testläufen mit warmem Cache nach 4-6 weiteren Anfragen eingespielt. Die Läufe starteten bei knapp 14k Tokens. Dieser Messbereich gilt für die getestete Arbeitslast. Eine geeignete Strategie muss die Erstellung der Zusammenfassung, das tatsächliche Abrechnungsmodell des Caches und genügend verbleibende Arbeit berücksichtigen, damit sich der Eingriff lohnt.
TL;DR
- Wenn das Kontextfenster knapp wird, muss der aktive Kontext aus Kapazitätsgründen schrumpfen. Die maximale Fenstergröße eines Modells haben wir nicht gemessen.
- Nach einer Zusammenfassung im höheren Tarif lag eine weitere Anfrage ungefähr an der Gewinnschwelle ($0.0560882 gegenüber $0.0560655 bei unverändertem Verlauf). Bei zwei Anfragen lohnte sich die Zusammenfassung in diesem Beispiel eindeutig.
- Eine nachträgliche Formelprüfung ergab 4-5 Anfragen bis zur Amortisation, gemessen wurden 4-6. Das war kein Test einer vorab erstellten Prognose.
- Eine Archivaufgabe mit sechs Fragen kostete mit Komprimierung $0.0156941 und ohne $0.0059911, jeweils bei 6/6 korrekten Antworten.
Welches Problem soll die Kontextkomprimierung lösen?
Bevor Sie einen Token-Schwellenwert festlegen, klären Sie den Grund für die Kontextreduktion. Eine harte Kontextgrenze, eine höhere Preisstufe und ein gewöhnlicher langer Dialog erfordern unterschiedliche Entscheidungen.
Bei der Kontextkomprimierung werden frühere Gesprächsinhalte durch eine kürzere Darstellung ersetzt, die spätere Anfragen verwenden. Unsere Experimente nutzten clientseitige Textzusammenfassungen: Ein gewöhnlicher Modellaufruf erzeugte eine Zusammenfassung, mit der die Anwendung den bisherigen Verlauf ersetzte. Native Komprimierungsfunktionen mit signierten oder verschlüsselten Inhalten haben andere Vorgaben für Anfragen und Verbrauchserfassung.
| Situation | Hauptziel | Was sollte den Eingriff auslösen? | Belege in diesem Artikel |
|---|---|---|---|
| Das Kontextfenster des Modells wird knapp | Die Aufgabe weiter ausführen können | Genügend Reserve für die nächste Eingabe, das nächste Tool-Ergebnis und die Ausgabe | Dokumentierte Modellgrenzen und eine technische Strategie; kein Experiment zur maximalen Fenstergröße |
| Die nächste Preisstufe rückt näher | Kosten der gesamten Arbeitslast senken | Erwartete Tarifersparnis übersteigt die Kosten für Zusammenfassung und Fortsetzung | Ein kleines Experiment zu Preisstufen ohne Cache |
| Genügend Platz im Fenster und innerhalb der Preisstufe | Eine bestimmte Arbeitslast verbessern | Genügend sinnvolle Arbeit verbleibt, um die Zusammenfassung zu amortisieren, ohne benötigten Zustand zu verlieren | Vergleichsläufe zur Zustandserhaltung mit Cache und eine kurze Archivaufgabe |
Szenario 1: Was tun, wenn dem Modell der Kontext ausgeht?
Reduzieren oder reorganisieren Sie den aktiven Kontext, bevor die nächste Anfrage das unterstützte Fenster überschreiten kann. Ab diesem Punkt ist die Fortsetzung mit dem vollständigen Gesprächsverlauf möglicherweise keine tragfähige Strategie mehr.
Für Claude Haiku 5.5 nennen die Modellspezifikationen ein Fenster von 1M Tokens und eine maximale Ausgabe von 128K. Das sind veröffentlichte Spezifikationen. Den maximal akzeptierten Kontext auf unserer Gateway-Route haben wir nicht getestet. Auch das folgende Preisstufenexperiment belegt diese Grenze nicht.
Reservieren Sie Platz für die nächste Eingabe, das nächste Tool-Ergebnis und die vom Dienst benötigte Ausgabe. Lösen Sie die Komprimierung aus, solange die Zusammenfassungsanfrage noch ins Fenster passt. Erhalten Sie den wesentlichen Zustand in einer Zusammenfassung oder einem abrufbaren Quelldatensatz und bewerten Sie, ob die Aufgabe erfolgreich fortgesetzt wird. Eine Ablehnung wegen eines überfüllten Fensters ist keine günstigere, erfolgreiche Vergleichsvariante.
Szenario 2: Vor einer höheren Preisstufe komprimieren?
Komprimieren Sie, wenn die erwartete verbleibende Arbeit die Zusammenfassung zu den tatsächlich geltenden Preisen amortisiert. Eine Preisgrenze kann die Komprimierung attraktiv machen. Die Zusammenfassung selbst kann aber bereits im teureren Tarif abgerechnet werden.
Bei Claude Haiku 5.5 ändern sich die Preise oberhalb von 100,000 Eingabe-Tokens. Die am 4. November 2026 geprüften Standardpreise für Ein- und Ausgabe betragen bis zu dieser Grenze $0.10/$0.50 pro Million Tokens und darüber $0.50/$2.50.
Wir schickten unterschiedliche fiktive Bibliotheksdatensätze durch das Synthorai-Gateway. Eine Anfrage mit 94,350 Eingabe-Tokens kostete $0.009437, eine mit 111,999 kostete $0.0560095. Beide erzeugten vier Ausgabe-Tokens. Der Kostenunterschied ergibt sich sowohl aus der Eingabelänge als auch aus der Preisstufe.
Anschließend fassten wir den größeren Verlauf zusammen. Dieser Aufruf verarbeitete 112,028 Eingabe-Tokens, meldete keine Cache-Treffer und kostete im höheren Tarif $0.0560715. Beide Varianten beantworteten die Fragen zu Mengen und Quellen korrekt.
| Verbleibende Anfragen | Verlauf beibehalten | Zusammenfassung plus Anfragen mit reduziertem Kontext | Beibehalten, zum niedrigen Tarif neu berechnet | Komprimieren, zum niedrigen Tarif neu berechnet |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
Bei einer Anfrage lagen beide Varianten ungefähr gleichauf: Der Unterschied betrug $0.0000227. Bei zwei Anfragen lohnte sich die Zusammenfassung in diesem Beispiel eindeutig. Die Neuberechnung aller Tokens zum niedrigen Tarif trennt den Mengeneffekt vom Tarifeffekt.
Diese Anfragen ohne Cache bilden eine einzelne synthetische Aufgabe ab. Bei einem bereits gecachten Verlauf sieht die Rechnung anders aus. Prüfen Sie, wie weit die Zusammenfassung den Kontext unter die Grenze bringt und wann neue Eingaben sie erneut überschreiten; siehe Preisstufen für lange Kontexte.
Szenario 3: Nach wie vielen weiteren Anfragen lohnt sich eine Komprimierung?
Bei Claude Sonnet 5.5 maßen wir in sechs Läufen mit Cache 4-6 weitere Anfragen bis zur Amortisation. Die Läufe starteten mit etwa 13.5k-14.2k Eingabe-Tokens. Ein Schritt bezeichnet hier eine nachfolgende Modellanfrage. Das Experiment berücksichtigte die Erstellung der Zusammenfassung und spätere Cache-Schreibvorgänge. Innerhalb von zwölf Folgeanfragen nach der gemeinsamen Aufwärmphase bestimmten wir den ersten Punkt, an dem die Komprimierung nicht mehr teurer war. In allen sechs Läufen blieb das bis Anfrage 12 so. Diese Beobachtung deckt weder einen späteren Cache-Ablauf noch eine weitere Zusammenfassung oder eine geänderte Aufgabe ab.
Geht durch die Komprimierung der Aufpreis fürs Cache-Schreiben verloren?
Bereits bezahlte Schreibvorgänge sind zum Entscheidungszeitpunkt versunkene Kosten. Für die Mehrkostenrechnung zählt, ob günstigere künftige Lesezugriffe die Zusammenfassungsanfrage und die neuen Schreibvorgänge decken. Diese Experimente nutzten explizites Caching mit fünf Minuten Gültigkeit. Implizite Caches haben anbieterspezifische Preise und verlangen möglicherweise nicht denselben Schreibaufschlag.
Ein Lauf mit mittlerem Wachstum zeigt den Unterschied zwischen dem ersten Eingriff und einer weiteren Zusammenfassung später in der Sitzung:
| Eingriff | Vermiedene künftige Lesekosten | Zusätzliche Schreibkosten bei der Fortsetzung | Kosten der Zusammenfassung | Nettoergebnis bis Schritt 12 |
|---|---|---|---|---|
| Erste Zusammenfassung gegenüber unverändertem Verlauf | $0.0159875 | $0.0010175 | $0.0049761 | $0.0099939 günstiger |
| Zweite Zusammenfassung gegenüber nur einer Zusammenfassung | $0.0037283 | $0.0013925 | $0.0065302 | $0.0041844 teurer |
Die zweite Zeile berücksichtigt außerdem um $0.0000100 niedrigere Kosten für andere Tokens. Die Kosten der Zusammenfassung enthalten deren eigene Cache-Kategorien; zählen Sie diese nicht doppelt. Aus den Token-Kategorien geht nicht hervor, welche einzelnen Einträge nie wiederverwendet wurden.
Wie gut passt eine Amortisationsformel zu den Messwerten?
Ein einfaches Modell für einen warmen Cache schätzt die nötigen verbleibenden Anfragen. Dabei ist H die Zahl der ersetzten Verlaufstokens, S die Zahl der Eingabe-Tokens der ersetzenden Zusammenfassung, A der vollständige Preis der Zusammenfassungsanfrage, r der Preis pro aus dem Cache gelesenem Token und w der Preis pro in den Cache geschriebenem Token. Unveränderte Anweisungen vor dem ersetzten Verlauf bleiben erhalten.
Über n künftige Anfragen kostet der beibehaltene Verlauf n*r*H. Der Ersatz kostet A + w*S + (n-1)*r*S. Die Kostendifferenz beträgt:
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
Die Formel setzt H > S, sofortige Cache-Fähigkeit, unveränderte Preise sowie gleiche spätere Ergänzungen, Ausgaben und Tool-Aufrufe voraus. Cache-Ablauf, zusätzliche Schreibvorgänge für beibehaltene Präfixe oder Kosten zur Wiederherstellung der Qualität sind nicht abgedeckt. Wenn sich diese Größen ändern, berechnen Sie die Kosten abschnittsweise.
Wir wandten die Formel nachträglich auf die Experimente an. Als Eingaben dienen die Verbrauchsdaten der Aufwärmphase und der Zusammenfassung, nicht die späteren Kosten. Die Ergebnisse waren aber bereits bekannt. Es handelt sich um eine nachträgliche Plausibilitätsprüfung, nicht um eine Validierung mit zurückgehaltenen Daten oder eine Vorabprognose. Die Analyse nähert H durch die gesamte Eingabe der Aufwärmphase und S durch die Ausgabe-Tokens der Zusammenfassung an. Wegen unveränderter Anweisungen, der Einbettung in die Anfrage und der Cache-Fähigkeit entsprechen diese Werte nicht exakt dem ersetzbaren Verlauf und der ersetzenden Eingabe.
| Zuwachs pro Anfrage | Lauf | Nachträgliche Schätzung | Gemessene Amortisation |
|---|---|---|---|
| Etwa 96 Tokens/Schritt | 1 | 5 Schritte | 6 Schritte |
| Etwa 96 Tokens/Schritt | 2 | 5 Schritte | 6 Schritte |
| Etwa 1.4k Tokens/Schritt | 1 | 5 Schritte | 5 Schritte |
| Etwa 1.4k Tokens/Schritt | 2 | 4 Schritte | 4 Schritte |
| Etwa 5.2k-5.5k Tokens/Schritt | 1 | 5 Schritte | 5 Schritte |
| Etwa 5.2k-5.5k Tokens/Schritt | 2 | 4 Schritte | 5 Schritte |
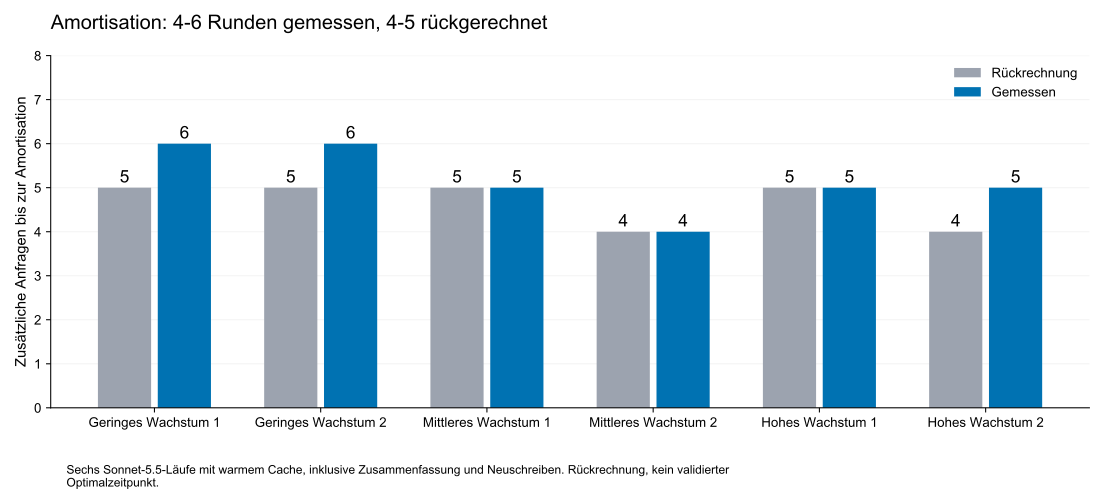
In diesen sechs Läufen wich die nachträgliche Schätzung höchstens um einen Schritt ab. Für künftige Entscheidungen müssen A und S anhand früherer Zusammenfassungen geschätzt und an neuen Aufgaben validiert werden. Dieser Vergleich liefert keine allgemeine Fehlergarantie.
Was ändert sich mit DeepSeeks implizitem Cache?
Keine separate Cache-Schreibgebühr bedeutet nicht, dass die Eingabe nach der Komprimierung kostenlos ist. DeepSeek V4.1 Flash 1017 nutzt automatisches Caching und unterschiedliche Eingabepreise für Treffer und Fehlschläge. Die Preisseite führt keine separate Schreibgebühr auf. Für ein neues Zusammenfassungspräfix fällt trotzdem der Eingabepreis für Cache-Fehlschläge an, solange es nicht gecacht ist.
Laut Cache-Dokumentation müssen die gespeicherten Präfixeinheiten übereinstimmen. Der Aufbau dauert Sekunden, Treffer werden nur nach dem Best-Effort-Prinzip bedient. Deshalb kann das Ersatzpräfix bei mehr als einer Anfrage einen Fehlschlag verursachen. Erfassen Sie prompt_cache_hit_tokens und prompt_cache_miss_tokens. Gehen Sie weder von genau einem kalten Aufruf aus noch davon, dass ein unverändertes Systempräfix immer einen Treffer liefert.
Sei p der Eingabepreis pro Token bei einem Cache-Fehlschlag und m die Zahl der Anfragen mit kaltem Ersatzpräfix innerhalb von n künftigen Anfragen. Wenn der beibehaltene Referenzverlauf im Cache bleibt und sich spätere gemeinsame Kosten aufheben, gilt:
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
Bei einer kalten Anfrage ersetzen Sie w durch p, nicht durch null. Wenn m unbekannt ist, rechnen Sie mehrere Szenarien durch oder bepreisen Sie die tatsächlich gemeldeten Treffer- und Fehlschlagskategorien. Berücksichtigen Sie dabei auch Fehlschläge beim unveränderten Präfix und beim Zusammenfassungsaufruf.
Das Folgende ist eine Formelrechnung, kein DeepSeek-Experiment. Verwendet werden die offiziellen Flash-Preise außerhalb der Spitzenzeiten: $0.003/M für Eingaben mit Cache-Treffer, $0.15/M bei Fehlschlägen und $0.60/M für die Ausgabe. Angenommen werden eine Zusammenfassung mit 1k Tokens, ein warmer ursprünglicher Verlauf, eine kalte Anfrage mit dem Ersatzpräfix und Zusammenfassungskosten von A = r*H + output_price*S. Einbettung, Reasoning und Tools bleiben unberücksichtigt.
| Ursprünglicher Verlauf | Angenommene Kosten des Zusammenfassungsaufrufs | Berechnete Amortisation |
|---|---|---|
| 10k Tokens | $0.000630 | 29 Anfragen |
| 100k Tokens | $0.000900 | 4 Anfragen |
Günstige Lesezugriffe können dafür sprechen, einen kurzen gecachten Verlauf beizubehalten. Bei längeren Aufgaben kann sich die Komprimierung dagegen amortisieren. Qualität und Amortisation bei DeepSeek wurden nicht gemessen. Rechnen Sie für Spitzenpreise oder Sitzungen mit gemischten Tarifen neu.
Wie beeinflusst das Wachstum den Zeitpunkt der Komprimierung?
Das Wachstum verändert den Verlauf am Entscheidungszeitpunkt. Vergehen vor dem Eingriff j Schritte und kommen pro Schritt g Tokens hinzu, setzen Sie H_j = H_0 + g*j zusammen mit der aktuellen Größe und den aktuellen Kosten der Zusammenfassung in die Amortisationsformel ein.
Gleicher späterer Zuwachs verursacht in beiden Varianten gemeinsame Kosten. Bei unveränderten Preisen und gleichem Cache-Verhalten heben sich diese Terme auf. Schnelleres Wachstum erreicht Kapazitäts- oder Preisgrenzen früher, bestimmt aber für sich genommen nicht die Zahl der Anfragen bis zur Amortisation.
In unseren Wachstumstests blieb der wesentliche Zustand klein, während die Archivdaten zunahmen. Bei mittlerem Wachstum kostete wiederholtes Zusammenfassen mehr als eine einzelne Zusammenfassung, bei hohem Wachstum weniger, jeweils in beiden zwölf Schritte langen Läufen. Alle Strategien beantworteten einschließlich der Erweiterung 96/96 Zustandsabfragen korrekt. Damit wurde kein unbegrenztes Wachstum des wesentlichen Zustands getestet.
Welches Intervall legt das Modell für fortlaufende Arbeit nahe?
Für eine lang laufende Aufgabe mit annähernd konstantem Wachstum, gleicher Zusammenfassungsgröße, gleichen Preisen und gleichem Cache-Verhalten sei F der fixe Betrag pro Komprimierungszyklus. Dazu gehören die Ausgabe der Zusammenfassung und das erneute Schreiben des Ersatzes. Kosten, die linear mit dem Intervall wachsen, werden ausgeklammert: Ihr amortisierter Beitrag pro Schritt ist konstant. Wenn das zusammenfassende Modell den Verlauf aus dem Cache liest, lässt sich F als A - r*H + w*S schätzen. Andere Preismodelle erfordern eine eigene Zerlegung. Bei einem Wachstum g pro Schritt und einem Intervall k zwischen Zusammenfassungen betragen die intervallabhängigen Durchschnittskosten:
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
Vorausgesetzt sind positive Werte für F, r und g, kleine beibehaltene Zusammenfassungen und vergleichbare Ergebnisqualität. Ohne Wachstum gibt es keinen wachstumsbedingten periodischen Auslöser. Bei kostenlosen Lesezugriffen liefert dieses Modell keine Amortisation durch eingesparte Lesekosten. Mit unseren Preisen für explizites Caching und unseren Zusammenfassungsgrößen ergeben sich mögliche Intervalle von etwa 30, 7-8 und 4 Schritten bei niedrigem, mittlerem und hohem Wachstum. Testen Sie benachbarte ganzzahlige Intervalle von mindestens einer Anfrage und halten Sie genügend Kapazitätsreserve vor. Wir haben keine Intervallreihe getestet, die diese Werte als optimal belegt. Ein Cache mit gesondertem Preis für Fehlschläge benötigt eine eigene Fixkostenzerlegung.
Eine Beispielrechnung verdeutlicht die Einheiten. Ein aufgezeichneter Lauf mit mittlerem Wachstum hatte A = $0.0049761, H = 13,712, S ≈ 341 und g ≈ 1,396 tokens/turn. Mit r = $0.10/M und w = $2.50/M ergibt sich:
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
Das berechnet einen Kandidaten aus aufgezeichneten Werten. Es belegt nicht, dass eine Strategie mit acht Anfragen optimal ist. Die Prüfung des verbleibenden Zeithorizonts ist davon getrennt: Wenn sich ein Eingriff voraussichtlich nach fünf Anfragen amortisiert, aber nur noch drei verbleiben, lassen Sie diesen optionalen Eingriff aus, selbst wenn er laut periodischem Timer fällig wäre.
Kurz vor Abschluss einer Aufgabe sollten Sie auf eine weitere optionale Zusammenfassung verzichten, wenn sie sich über die verbleibenden Anfragen nicht mehr amortisieren kann. Kapazität, Preisstufen und die Erhaltung benötigter Informationen haben Vorrang vor diesem vereinfachten Kostenmodell.
Eine kurze Archivaufgabe zeigt dieses Entscheidungskriterium. Beide Strategien beantworteten sechs Mengenfragen korrekt. Das Beibehalten des Verlaufs kostete jedoch $0.0059911, die Variante einschließlich Zusammenfassung $0.0156941. Sechs Anfragen reichten nicht zur Amortisation. Die Zusammenfassung enthielt genügend Details; zusätzliches Nachschlagen war nicht nötig. Der Amortisationshorizont hängt von der konkreten Zusammenfassung und Arbeitslast ab, nicht von einer allgemeingültigen Regel mit vier bis sechs Schritten.
Wie sollten Sie die Gesamtkosten messen?
Berücksichtigen Sie die Zusammenfassung, die erste Anfrage mit ersetztem Verlauf und jede Fortsetzung. Weniger Prompt-Tokens und eine hohe Cache-Trefferquote allein belegen keine Ersparnis.
Für Claude Sonnet 5.5 rechneten wir mit $2/M für frische Eingaben, $2.50/M für Cache-Schreibvorgänge mit fünf Minuten Gültigkeit, $0.10/M für Cache-Lesezugriffe und $10/M für die Ausgabe. Cache-Lesezugriffe sind günstig, aber nicht kostenlos. Das Ersetzen eines warmen Verlaufs kann einen neuen Schreibvorgang auslösen. Eine sehr kurze Zusammenfassung ist möglicherweise gar nicht cachefähig. Unsere expliziten Haltepunkte an Inhaltsblöcken führten zu messbaren Cache-Schreib- und Lesezugriffen. Einige kurze komprimierte Präfixe meldeten anfangs weder das eine noch das andere.
Diese Funktion setzt eine vorgegebene Zahl von Anfragen mit kaltem Präfix voraus. Übergeben Sie als cold_input_per_million den expliziten Schreibpreis oder den Eingabepreis für implizite Cache-Fehlschläge:
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
Schätzen Sie die Zusammenfassungskosten anhand früherer Aufrufe, um vor der Komprimierung entscheiden zu können. Prüfen Sie die Schätzung anhand vollständiger Verbrauchsnachweise, einschließlich fehlgeschlagener Anfragen und Wiederherstellungsarbeiten. Ein fehlender Nachweis macht eine Anfrage nicht kostenlos.
Die Messungen liefen am 4. November 2026 über die Messages-Schnittstelle des Gateways, mit deaktiviertem Thinking und ohne gehostete Tools. Gewöhnliche Antworten waren auf 128 Ausgabe-Tokens begrenzt, Zusammenfassungen auf 2,048. Die Kosten wurden anhand der zurückgegebenen Verbrauchsdaten zu Standardpreisen rekonstruiert und mit den gemeldeten Gateway-Kosten abgeglichen. Es handelt sich nicht um einen Abgleich mit Lieferantenrechnungen. Die gewöhnlichen Arbeitslasten nutzten clientseitige Zusammenfassungen, keine native Komprimierungsimplementierung.
Welche Strategie sollten Sie einsetzen?
Wenden Sie zuerst die Kapazitäts- und Tarifgrenzen an und planen Sie Reserve für Eingaben, Tools und Ausgaben ein. Berücksichtigen Sie bei Arbeitslasten mit Claude Sonnet 5.5 und explizitem Cache die Schreibaufschläge und Zusammenfassungskosten. Lassen Sie optionale Eingriffe aus, die sich vor Aufgabenende voraussichtlich nicht amortisieren. Validieren Sie ganzzahlige Intervalle nahe dem analytisch berechneten Kandidaten mit identischen eingehenden Aufgaben und demselben Endzeitpunkt.
Beim impliziten Caching von DeepSeek V4.1 Flash 1017 sollten Sie ein nützliches Präfix beibehalten, wenn die Treffer stabil sind und nur wenig Arbeit verbleibt. Ein späterer Auslöser unterhalb der Kapazitätsgrenze kann sinnvoll sein. Keine separate Schreibgebühr bedeutet nicht, dass Sie bis zur harten Grenze warten sollten. Schätzen Sie bei längeren Aufgaben die tatsächlichen Treffer- und Fehlschlagskosten und beobachten Sie nach dem Ersetzen des Verlaufs die Anfragen, bis Cache-Treffer auftreten.
Rechnen Sie neu, wenn sich Preise, Cache-Zustand, Modell oder Größe des wesentlichen Zustands ändern. Halten Sie Quellen abrufbar und prüfen Sie geänderte Werte bei Aufgaben, in denen Details zählen. Erfassen Sie die Zusammenfassung und den anschließenden Verbrauch in derselben Agent-Sitzung und verwenden Sie die richtigen Token-Kategorien.
FAQ
Senkt Kontextkomprimierung immer die API-Kosten?
Die Einsparungen müssen die Kosten für Zusammenfassung, Cache-Neuaufbau und Wiederherstellung übersteigen. Unsere Archivaufgabe mit sechs Fragen kostete mit Zusammenfassung $0.0156941 und mit beibehaltenem Verlauf $0.0059911, jeweils bei 6/6 korrekten Antworten.
Sollte ich genau an einer Preisgrenze komprimieren?
Eine Preisgrenze ist ein Anlass, die gesamte verbleibende Arbeitslast zu bewerten, kein automatischer Auftrag zur Zusammenfassung. In unserem Beispiel mit Claude Haiku 5.5 wurde die Zusammenfassung selbst oberhalb von 100,000 Tokens abgerechnet. Bei einer späteren Anfrage lagen beide Varianten ungefähr gleichauf, bei zwei lohnte sie sich eindeutig.
Kann ich warten, bis das Kontextfenster voll ist?
Lassen Sie Platz für die Zusammenfassungsanfrage, die nächste Eingabe beziehungsweise das nächste Tool-Ergebnis und die Ausgabe. Ein bereits zu großer Verlauf passt möglicherweise auch nicht mehr in eine Zusammenfassungsanfrage. Die Fehlergrenze bei maximalem Fenster haben wir nicht gemessen.
Amortisiert sich eine Zusammenfassung bei schnellerem Kontextwachstum immer früher?
Schnelleres gemeinsames Wachstum erhöht die Kosten beider Strategien und vergrößert nicht automatisch die Ersparnis durch eine einzelne Zusammenfassung. Wiederholte Komprimierung kann die weitere Anhäufung begrenzen, verursacht aber zusätzliche Kosten für Zusammenfassungen und erneute Schreibvorgänge. In unseren Läufen mit mittlerem Wachstum kostete wiederholte Komprimierung über zwölf Schritte mehr als eine einzelne Zusammenfassung. Bei hohem Wachstum war die Wiederholung günstiger. Wählen Sie die Strategie anhand von Wachstum, verbleibendem Horizont und dem Zustand, der erhalten bleiben muss.
Sollte ich wegen implizitem Caching bis zur Kontextgrenze warten?
Implizites Caching kann dafür sprechen, einen günstigen warmen Verlauf bei einer kurzen Aufgabe beizubehalten. DeepSeek V4.1 Flash 1017 berechnet für ein ungecachtes Zusammenfassungspräfix trotzdem den Eingabepreis für Cache-Fehlschläge. Die Speicherung erfolgt nur nach dem Best-Effort-Prinzip. Schätzen Sie den verbleibenden Nutzen und halten Sie vor Erreichen des unterstützten Fensters Reserve für Tools, Eingaben und Ausgaben frei. Die obigen DeepSeek-Werte sind Berechnungen, keine gemessenen Schwellenwerte.