
gemini-3.1-flash-lite-image vs wan2.7-image-pro
Qual usar e quando
Estes dois cobram em unidades diferentes - gemini-3.1-flash-lite-image cobra por token ($0.25 por milhão na entrada, $30 por milhão na saída) enquanto wan2.7-image-pro cobra $0.075 por chamada - então nenhuma conversão única é honesta e você deve comparar com base no formato médio das suas próprias requisições. Escolha gemini-3.1-flash-lite-image quando você quiser receber texto junto com imagens a partir de entrada de texto ou imagem, com um teto de saída de 4096 tokens e um limite de conhecimento em 2025-01. Escolha wan2.7-image-pro para geração com saída puramente em imagem, onde o preço fixo por chamada torna os custos previsíveis independentemente do tamanho do prompt.
Preços
| gemini-3.1-flash-lite-image | wan2.7-image-pro | Δ | |
|---|---|---|---|
| Por imagem gerada | - | $0.075 | - |
| Entrada / 1M tokens | $0.25 | - | - |
| Saída / 1M tokens | $30 | - | - |
Estes dois modelos cobram em unidades diferentes, então nenhum Δ é mostrado: converter uma na outra exigiria uma suposição que não medimos. Acima, os preços de cada um aparecem na sua própria unidade.
Especificações
| gemini-3.1-flash-lite-image | wan2.7-image-pro | |
|---|---|---|
| Modalidades de entrada | texto imagem | texto imagem |
| Modalidades de saída | texto imagem | imagem |
| Lançamento | 2026-06-30 | 2026-04-01 |
| Corte de conhecimento | 2025-01 | - |
| Tamanhos de saída | 1K only (1:1 = 1024x1024) |
|
| Modos de entrada | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, image editing (incl. bounding-box interactive edit), 0-9 reference images, text/image-to-image-set |
| Imagens por requisição | - | 12 |
| Formatos | - | png |
| Notas | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | 4K text-to-image (max 4096x4096; editing max 2K), aspect ratios 1:8-8:1 instruction + click-to-edit editing character-consistent sets up to 12 images print-quality text rendering incl. formulas/tables |
As especificações são transcritas da documentação de cada provedor; quando um provedor não publica um dado, a linha é omitida, e não inferida. Fontes completas: gemini-3.1-flash-lite-image · wan2.7-image-pro
Um prompt, os dois modelos, medidos pelo gateway
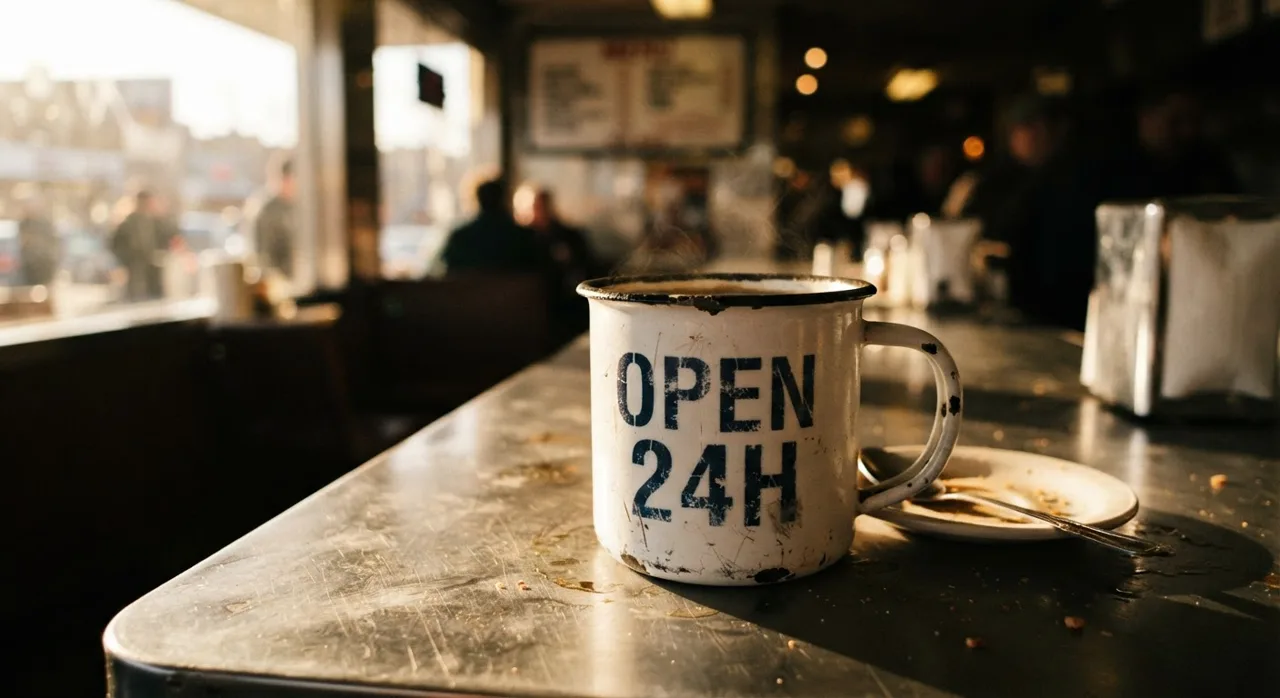
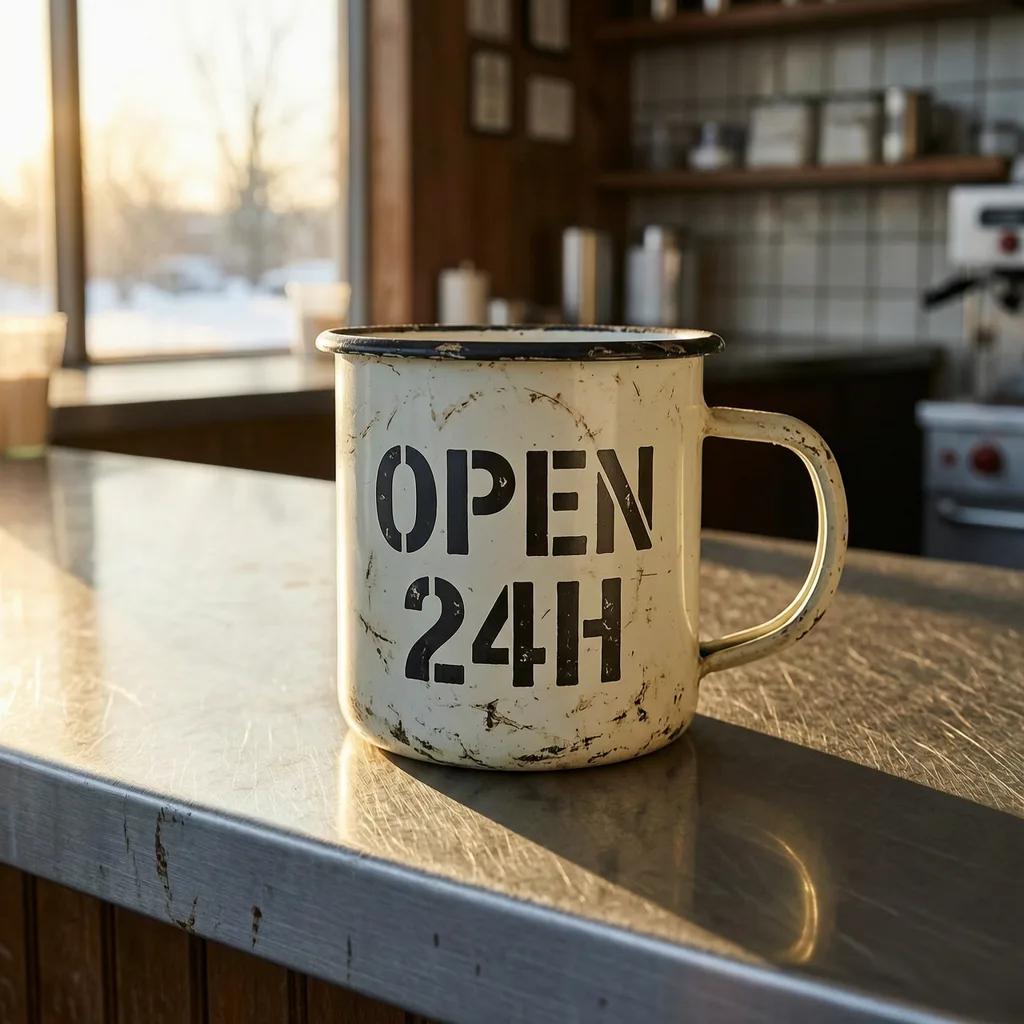
Um prompt, uma requisição por modelo, sem novas tentativas e sem escolher o melhor resultado: é o primeiro que cada modelo retornou. Nem o tamanho nem a duração foram fixados; cada modelo usou seu próprio padrão, porque uma requisição ajustada para servir a todos não mostraria o melhor de nenhum. Os arquivos foram recodificados para a web, então avalie a composição e a aderência ao prompt, e não a compressão.
Troque de um para o outro mudando uma linha
Os dois ids estão em todas as abas abaixo; o par de linhas destacado é a única alteração. O endpoint, a chave e o formato da requisição são os mesmos.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="wan2.7-image-pro",  # descomente esta linha, comente a linha acima
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "wan2.7-image-pro", // descomente esta linha, comente a linha acima
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "wan2.7-image-pro", # descomente esta linha, comente a linha acima
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "wan2.7-image-pro", // descomente esta linha, comente a linha acima
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("wan2.7-image-pro") // descomente esta linha, comente a linha acima
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));Perguntas frequentes
Qual é mais barato, gemini-3.1-flash-lite-image ou wan2.7-image-pro?
Eles cobram em unidades diferentes, então não existe um número único que seja honesto: na tabela acima, gemini-3.1-flash-lite-image e wan2.7-image-pro aparecem cada um na sua unidade. Compare os dois na sua própria carga de trabalho; o trade-off na prática está descrito no veredito, no topo desta página.
Posso fazer um teste A/B de gemini-3.1-flash-lite-image contra wan2.7-image-pro sem duas integrações?
Sim. Os dois são servidos pelo mesmo endpoint compatível com OpenAI, com uma única chave de API. Para trocar, basta mudar uma linha, a string do modelo; assim você pode direcionar uma parte do tráfego para cada um e comparar as contas diretamente.
O preço muda com o tamanho da imagem?
Depende de como o modelo cobra. Os modelos com preço por imagem cobram o mesmo valor, seja qual for o prompt ou o tamanho da saída; nos modelos cobrados por token, o custo cresce com a resolução gerada, então uma imagem 4K custa várias vezes o preço de uma pequena. A tabela acima mostra qual é o caso de cada um.