
gemini-3.1-flash-lite-image vs Seedream 5.0 Lite
Qual usar e quando
Esses dois cobram em unidades diferentes - o gemini-3.1-flash-lite-image cobra por token ($0.25 por milhão de entrada, $30 por milhão de saída), enquanto o seedream-5-0-260128 cobra uma taxa fixa de $0.035 por chamada - portanto, nenhuma conversão única entre eles é honesta; faça o orçamento com base nos tamanhos dos seus próprios prompts e no volume de chamadas. Escolha o modelo do Google quando precisar de texto como retorno junto com imagens, pois ele emite tanto texto quanto imagem (até 4096 tokens de saída) a partir de entrada de texto ou imagem. Escolha o modelo da ByteDance para trabalho puramente de texto-ou-imagem para imagem com um custo previsível por chamada.
Preços
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | Δ | |
|---|---|---|---|
| Por imagem gerada | - | $0.035 | - |
| Entrada / 1M tokens | $0.25 | - | - |
| Saída / 1M tokens | $30 | - | - |
Estes dois modelos cobram em unidades diferentes, então nenhum Δ é mostrado: converter uma na outra exigiria uma suposição que não medimos. Acima, os preços de cada um aparecem na sua própria unidade.
Especificações
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | |
|---|---|---|
| Modalidades de entrada | texto imagem | texto imagem |
| Modalidades de saída | texto imagem | imagem |
| Lançamento | 2026-06-30 | 2026-01 |
| Corte de conhecimento | 2025-01 | - |
| Tamanhos de saída | 1K only (1:1 = 1024x1024) |
|
| Modos de entrada | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, single-image image-to-image, multi-reference image-to-image (2-14 refs), batch/sequential image sets |
| Imagens por requisição | - | 15 |
| Formatos | - | png, jpeg |
| Notas | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | 2K/3K/4K output, png/jpeg text-to-image + single/multi-reference image editing batch generation with reference + generated images <=15 500 max IPM |
As especificações são transcritas da documentação de cada provedor; quando um provedor não publica um dado, a linha é omitida, e não inferida. Fontes completas: gemini-3.1-flash-lite-image · Seedream 5.0 Lite
Um prompt, os dois modelos, medidos pelo gateway
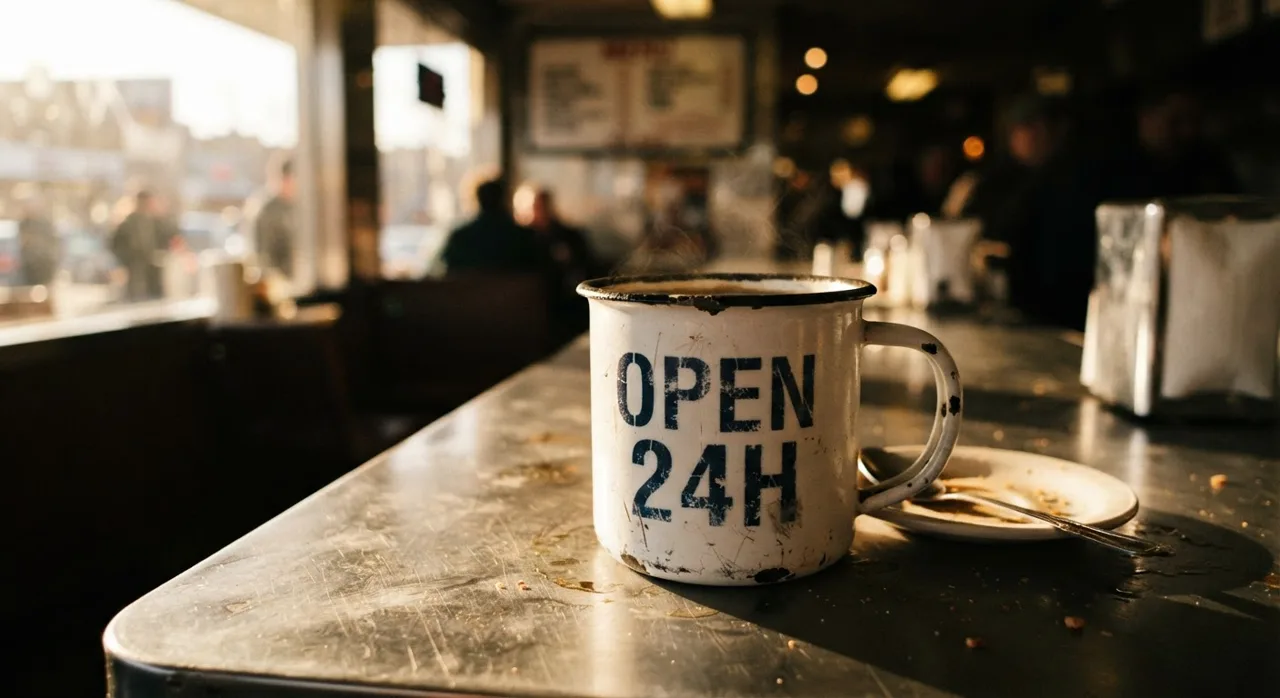
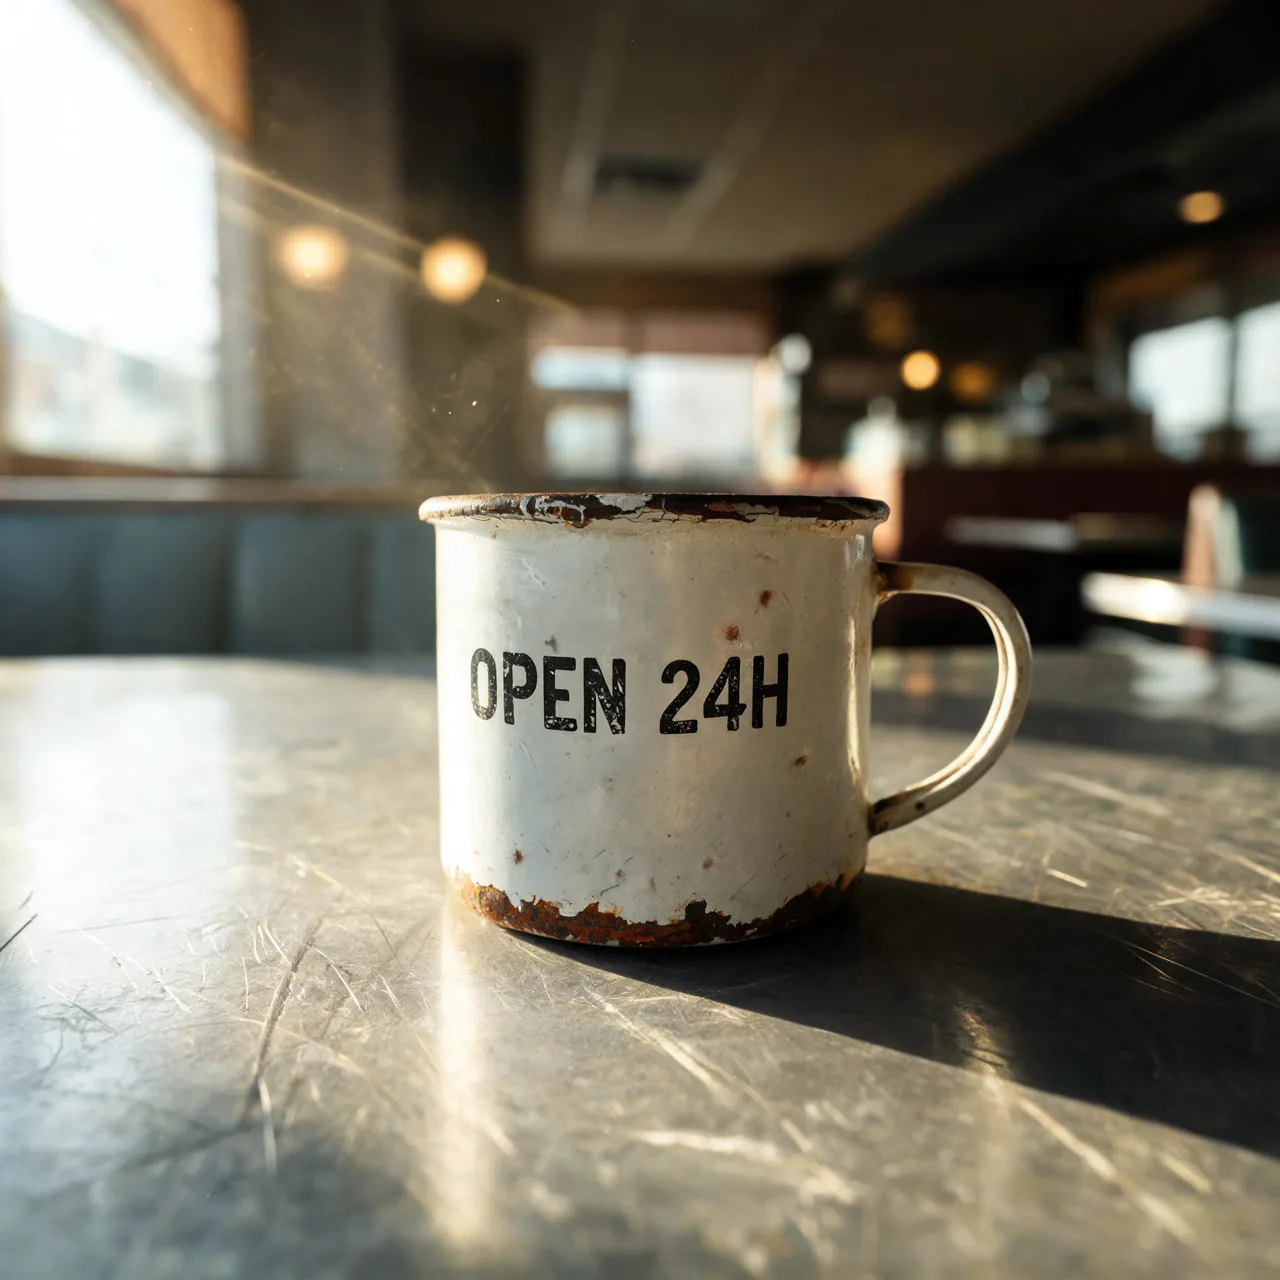
Um prompt, uma requisição por modelo, sem novas tentativas e sem escolher o melhor resultado: é o primeiro que cada modelo retornou. Nem o tamanho nem a duração foram fixados; cada modelo usou seu próprio padrão, porque uma requisição ajustada para servir a todos não mostraria o melhor de nenhum. Os arquivos foram recodificados para a web, então avalie a composição e a aderência ao prompt, e não a compressão.
Troque de um para o outro mudando uma linha
Os dois ids estão em todas as abas abaixo; o par de linhas destacado é a única alteração. O endpoint, a chave e o formato da requisição são os mesmos.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="seedream-5-0-260128",  # descomente esta linha, comente a linha acima
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "seedream-5-0-260128", // descomente esta linha, comente a linha acima
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "seedream-5-0-260128", # descomente esta linha, comente a linha acima
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "seedream-5-0-260128", // descomente esta linha, comente a linha acima
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("seedream-5-0-260128") // descomente esta linha, comente a linha acima
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));Perguntas frequentes
Qual é mais barato, gemini-3.1-flash-lite-image ou Seedream 5.0 Lite?
Eles cobram em unidades diferentes, então não existe um número único que seja honesto: na tabela acima, gemini-3.1-flash-lite-image e Seedream 5.0 Lite aparecem cada um na sua unidade. Compare os dois na sua própria carga de trabalho; o trade-off na prática está descrito no veredito, no topo desta página.
Posso fazer um teste A/B de gemini-3.1-flash-lite-image contra Seedream 5.0 Lite sem duas integrações?
Sim. Os dois são servidos pelo mesmo endpoint compatível com OpenAI, com uma única chave de API. Para trocar, basta mudar uma linha, a string do modelo; assim você pode direcionar uma parte do tráfego para cada um e comparar as contas diretamente.
O preço muda com o tamanho da imagem?
Depende de como o modelo cobra. Os modelos com preço por imagem cobram o mesmo valor, seja qual for o prompt ou o tamanho da saída; nos modelos cobrados por token, o custo cresce com a resolução gerada, então uma imagem 4K custa várias vezes o preço de uma pequena. A tabela acima mostra qual é o caso de cada um.