
gemini-3.1-flash-lite-image vs GPT Image 2
Qual usar e quando
Ambos são modelos de imagem que cobram os mesmos $30 por milhão de tokens de saída, então a verdadeira diferença está na entrada: o gemini-3.1-flash-lite-image aceita texto e imagens a $0.25 por milhão versus $5 do gpt-image-2, tornando 20x mais barato fornecer prompts e imagens de referência. Escolha o gemini-3.1-flash-lite-image para pipelines intensivos em prompts ou de imagem para imagem, onde o volume de entrada domina a fatura, e note que ele também pode retornar texto junto com as imagens, com um limite de saída de 4096 tokens e raciocínio que não pode ser desativado. Escolha o gpt-image-2 quando desejar um endpoint puramente de saída de imagem da OpenAI e o custo de entrada for um item de despesa menor.
Preços
| gemini-3.1-flash-lite-image | GPT Image 2 | Δ | |
|---|---|---|---|
| Entrada / 1M tokens | $0.25 | $5 | 0.05× |
| Saída / 1M tokens | $30 | $30 | = |
| Tokens de imagem de referência / milhão | - | $8 | - |
Tarifas do catálogo em tempo real, lidas no momento do build; a página de cada modelo traz a tabela de preços atual.
Onde cada um fica: preço de saída por 1M tokens entre os 15 modelos de geração de imagens com esta unidade de cobrança (escala logarítmica)
Especificações
| gemini-3.1-flash-lite-image | GPT Image 2 | |
|---|---|---|
| Modalidades de entrada | texto imagem | texto imagem |
| Modalidades de saída | texto imagem | imagem |
| Lançamento | 2026-06-30 | 2026-04-21 |
| Corte de conhecimento | 2025-01 | - |
| Tamanhos de saída | somente 1K (1:1 = 1024x1024) |
|
| Modos de entrada | texto-para-imagem, geração + edição intercaladas, até 14 imagens de referência | texto-para-imagem, edição de imagem com inpainting por máscara |
| Imagens por requisição | - | 10 |
| Formatos | - | png, jpeg, webp |
| Notas | Saída apenas em 1K (1024px) 10 proporções (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) e até 14 imagens de referência geração e edição intercaladas, com edições locais rápidas em múltiplos turnos latência ponta a ponta abaixo de 2s marca de água SynthID + C2PA sempre ativa | Resoluções flexíveis: bordas de até 3840px em múltiplos de 16, proporção <=3:1, cerca de 0,65-8,3MP no total (incluindo 4K 3840x2160) edição com inpainting por máscara todas as imagens de entrada processadas em alta fidelidade renderização de texto significativamente melhorada (a colocação precisa ainda pode falhar) |
As especificações são transcritas da documentação de cada provedor; quando um provedor não publica um dado, a linha é omitida, e não inferida. Fontes completas: gemini-3.1-flash-lite-image · GPT Image 2
Um prompt, os dois modelos, medidos pelo gateway
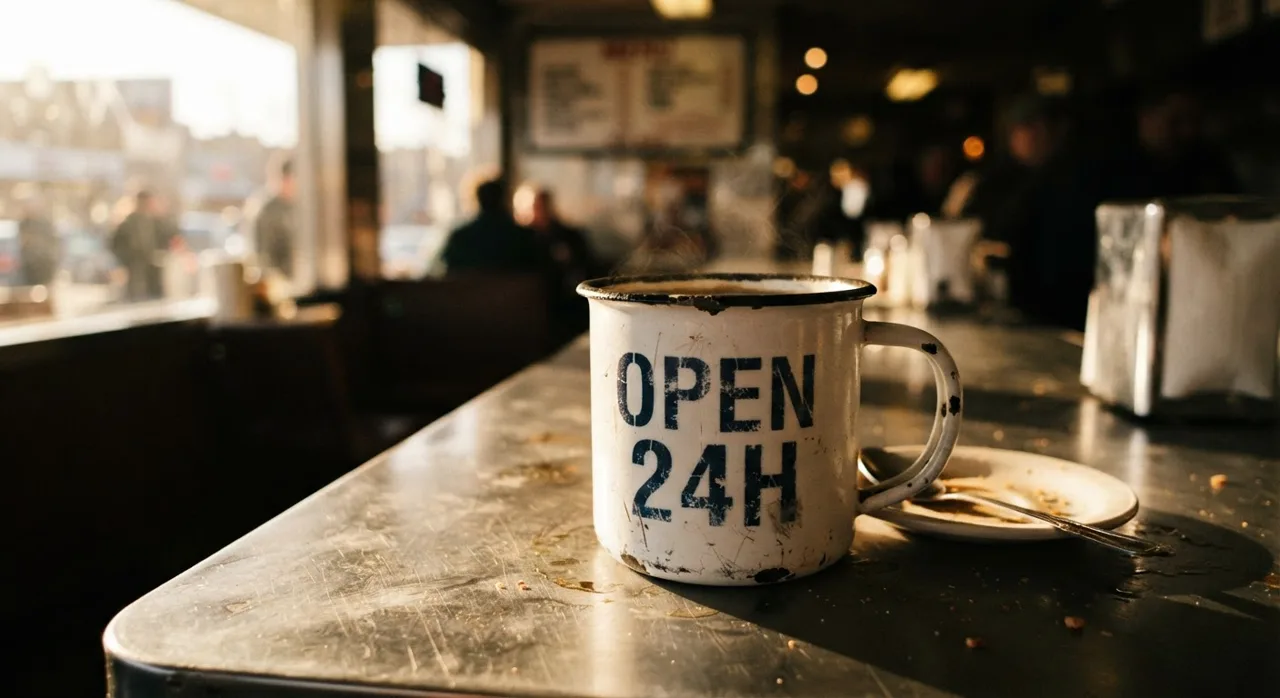
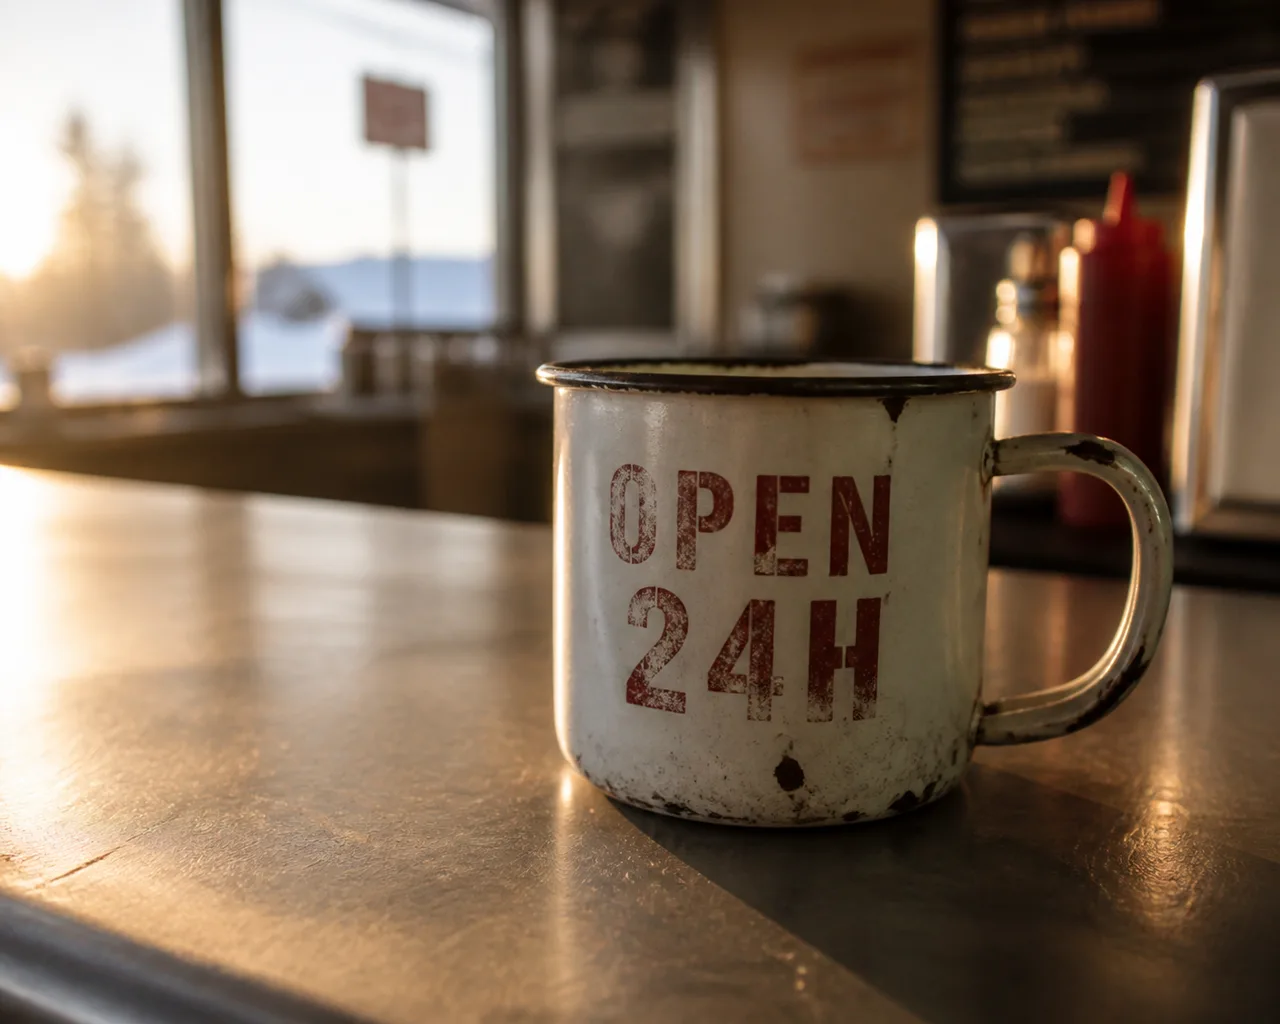
Um prompt, uma requisição por modelo, sem novas tentativas e sem escolher o melhor resultado: é o primeiro que cada modelo retornou. Nem o tamanho nem a duração foram fixados; cada modelo usou seu próprio padrão, porque uma requisição ajustada para servir a todos não mostraria o melhor de nenhum. Os arquivos foram recodificados para a web, então avalie a composição e a aderência ao prompt, e não a compressão.
Troque de um para o outro mudando uma linha
Os dois ids estão em todas as abas abaixo; o par de linhas destacado é a única alteração. O endpoint, a chave e o formato da requisição são os mesmos.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="gpt-image-2",  # descomente esta linha, comente a linha acima
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "gpt-image-2", // descomente esta linha, comente a linha acima
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "gpt-image-2", # descomente esta linha, comente a linha acima
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "gpt-image-2", // descomente esta linha, comente a linha acima
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("gpt-image-2") // descomente esta linha, comente a linha acima
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));Perguntas frequentes
Qual é mais barato, gemini-3.1-flash-lite-image ou GPT Image 2?
gemini-3.1-flash-lite-image sai mais barato na linha “Entrada / 1M tokens” ($0.25 contra $5, 20× de diferença). Outras linhas podem pender para o outro lado: a tabela acima mostra todos os preços, e o custo real depende do seu mix de uso.
Posso fazer um teste A/B de gemini-3.1-flash-lite-image contra GPT Image 2 sem duas integrações?
Sim. Os dois são servidos pelo mesmo endpoint compatível com OpenAI, com uma única chave de API. Para trocar, basta mudar uma linha, a string do modelo; assim você pode direcionar uma parte do tráfego para cada um e comparar as contas diretamente.
O preço muda com o tamanho da imagem?
Depende de como o modelo cobra. Os modelos com preço por imagem cobram o mesmo valor, seja qual for o prompt ou o tamanho da saída; nos modelos cobrados por token, o custo cresce com a resolução gerada, então uma imagem 4K custa várias vezes o preço de uma pequena. A tabela acima mostra qual é o caso de cada um.