
Jev vs LLMs flash: 7x mais barato em workflows
Conteúdo
- O que é o Jev e como ele difere de um LLM?
- Como fizemos os testes?
- Quando o Jev é mais barato que um LLM flash?
- Quanto o Jev é mais rápido?
- Como esses resultados se comparam às afirmações da TypeSafe?
- O Jev é tão preciso quanto um LLM flash?
- Dá para confiar na confiança do Jev?
- Você deve usar o Jev ou um LLM flash?
- Perguntas frequentes
O custo do Jev da TypeSafe em relação a um LLM flash depende do formato da tarefa. Ao fazer 12 perguntas sobre cada transcrição de suporte, o Jev custou 7 vezes menos que o GPT-5.6 Luna sem thinking e levou 0.12 segundos, descontado o tempo de rede, contra 1.66. Para atribuir um único rótulo entre 77 opções, custou o mesmo que o Qwen3.8 Flash e o GLM 5.3 Flash. O Jev é um modelo de decisão: em vez de gerar texto, retorna uma escolha, uma pontuação ou uma probabilidade para cada pergunta definida. Comparamos o modelo com cinco modelos de chat da categoria flash, tanto na configuração mais barata quanto na configuração padrão de thinking, em quatro testes baseados em datasets públicos. O Jev foi o modelo mais rápido em todos os testes, mas não foi o mais preciso em nenhum deles.
TL;DR
- Com 12 perguntas por caso, os LLMs flash custaram de 4.8 a 37 vezes mais que o Jev e levaram de 11 a 27 vezes mais tempo, com precisão semelhante.
- Para um rótulo por mensagem, o Jev custou o mesmo que o Qwen3.8 Flash e o GLM 5.3 Flash sem thinking.
- Com o thinking padrão, um único rótulo custou de 1.5 a 26 vezes mais nos modelos flash que no Jev.
- O GPT-5.6 Luna foi mais preciso que o Jev em todos os testes, exceto no de prompt injection.
- As respostas do Jev com probabilidade igual ou superior a 0.99 estavam corretas em 98% dos casos.
O que é o Jev e como ele difere de um LLM?
O Jev é o modelo “System One” da TypeSafe. Ele lê um trecho de texto ou JSON (o estado) e responde a perguntas tipadas sobre esse conteúdo, sem gerar texto que precise ser interpretado. Há três tipos de pergunta:
| Tipo de pergunta | O que você pergunta | O que retorna |
|---|---|---|
| Noul (nome usado pela TypeSafe para sim/não) | uma pergunta de sim ou não | uma probabilidade de 0 a 1 |
| Choice | escolha uma entre até 255 opções definidas por você | a opção, a probabilidade de cada opção e uma confiança |
| Score | avalie em uma escala ordenada de 2 a 10 níveis definidos por você | uma pontuação ponderada por probabilidade e uma confiança |
A requisição identifica cada pergunta por nome e recebe uma resposta para cada nome. No formato documentado pela TypeSafe (referência da API), o exemplo abaixo faz três perguntas de sim ou não sobre uma conversa curta de suporte:
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {"transcript": "Customer: My card was declined twice today.\nAgent: One moment.\nCustomer: Also, how do I change my PIN?"},
    "questions": {
      "declined_card": {"type": "noul", "instructions": "In `transcript`, does the customer report a declined card payment?"},
      "change_pin":    {"type": "noul", "instructions": "In `transcript`, does the customer want to change a PIN?"},
      "lost_card":     {"type": "noul", "instructions": "In `transcript`, does the customer report a lost or stolen card?"}
    }
  }'
Esta foi a resposta que recebemos:
{
  "model": "jev-1.13.0",
  "answers": {
    "declined_card": {"type": "noul", "noul": 0.99},
    "change_pin":    {"type": "noul", "noul": 0.98},
    "lost_card":     {"type": "noul", "noul": 0.02}
  },
  "usage": {"input_tokens": 359, "output_tokens": 56}
}
O código lê answers.<question>.noul e compara o valor com um threshold, como faria com qualquer número. O campo model identifica a versão que respondeu. O alias jev-latest muda quando a TypeSafe lança uma nova versão. Se os thresholds foram ajustados para uma versão específica, fixe jev-1.13.0.
A TypeSafe processa as perguntas em paralelo. O Jev 1.13 custa $0.042 por milhão de tokens de entrada, e a saída é gratuita (modelos). Por token de entrada, isso é 3.6 vezes menos que o Qwen3.8 Flash, 4.8 vezes menos que o GPT-5.6 Luna e 18 vezes menos que o Gemini 3.8 Flash. A entrada inclui o template da própria TypeSafe, cerca de 300 tokens por chamada, além de todas as perguntas e opções definidas. A chamada acima contabilizou 359 tokens de entrada, $0.000015, e os 56 tokens de saída não tiveram custo. A TypeSafe documenta os pontos fracos do Jev em suas notas sobre irregularidades do modelo: contagem, aritmética, comparação de datas, perguntas com várias etapas e estados longos cheios de texto irrelevante.
Como fizemos os testes?
Executamos quatro testes, uma vez em 2026-09-21 e outra em 2026-09-22, usando o Jev e cinco modelos de chat flash: GPT-5.6 Luna, Qwen3.8 Flash, GLM 5.3 Flash, DeepSeek V4.1 Flash e Gemini 3.8 Flash. Cada modelo de chat foi executado na configuração funcional de thinking mais barata (desativado ou low quando não era possível desativá-lo). Nos três testes de classificação, também usamos a configuração padrão do fornecedor.
- 12 perguntas por caso: 150 transcrições de suporte ao cliente, cada uma montada com uma a seis mensagens do dataset Banking77 (PolyAI, CC BY 4.0), o que permite saber as respostas corretas. Todos os modelos respondem a 12 perguntas de sim ou não por transcrição (“o cliente informa que perdeu o cartão ou que ele foi roubado?”), cada uma com uma probabilidade. O Jev recebe 12 perguntas Noul em uma única chamada; os modelos de chat retornam um único objeto JSON. Repetimos 60 casos adicionando, antes da transcrição, um documento de referência com 3,000 tokens e outro com 12,000 tokens, usando artigos da Wikipedia sobre serviços bancários.
- Um rótulo: 308 mensagens do Banking77, 4 para cada uma das 77 intenções. O Jev recebe uma pergunta Choice com 77 opções; os modelos de chat recebem a mesma lista e respondem com a intenção.
- 28 rótulos: 200 comentários do GoEmotions (Google, Apache 2.0), cada um com 28 emoções possíveis.
- Prompt injection: o dataset de teste de prompt injection da deepset (Apache 2.0), com 116 linhas e uma pergunta de sim ou não para cada uma.
O custo corresponde ao preço de tabela de cada fornecedor multiplicado pelos tokens cobrados. A latência vem de uma execução separada com 40 chamadas por modelo em uma conexão mantida aberta, descontando o tempo de ida e volta da rede. A seção de desempenho explica o método. Também executamos o GPT-5.6 Terra e o Seed 2.0 Mini nos três testes de classificação. Eles aparecem nas tabelas, mas não no gráfico.
Quando o Jev é mais barato que um LLM flash?
Quando o mesmo texto recebe muitas perguntas, quando o texto é longo ou quando o modelo de chat usaria thinking. Para atribuir um único rótulo a um texto curto com um modelo barato e thinking desativado, o custo do Jev é o mesmo.
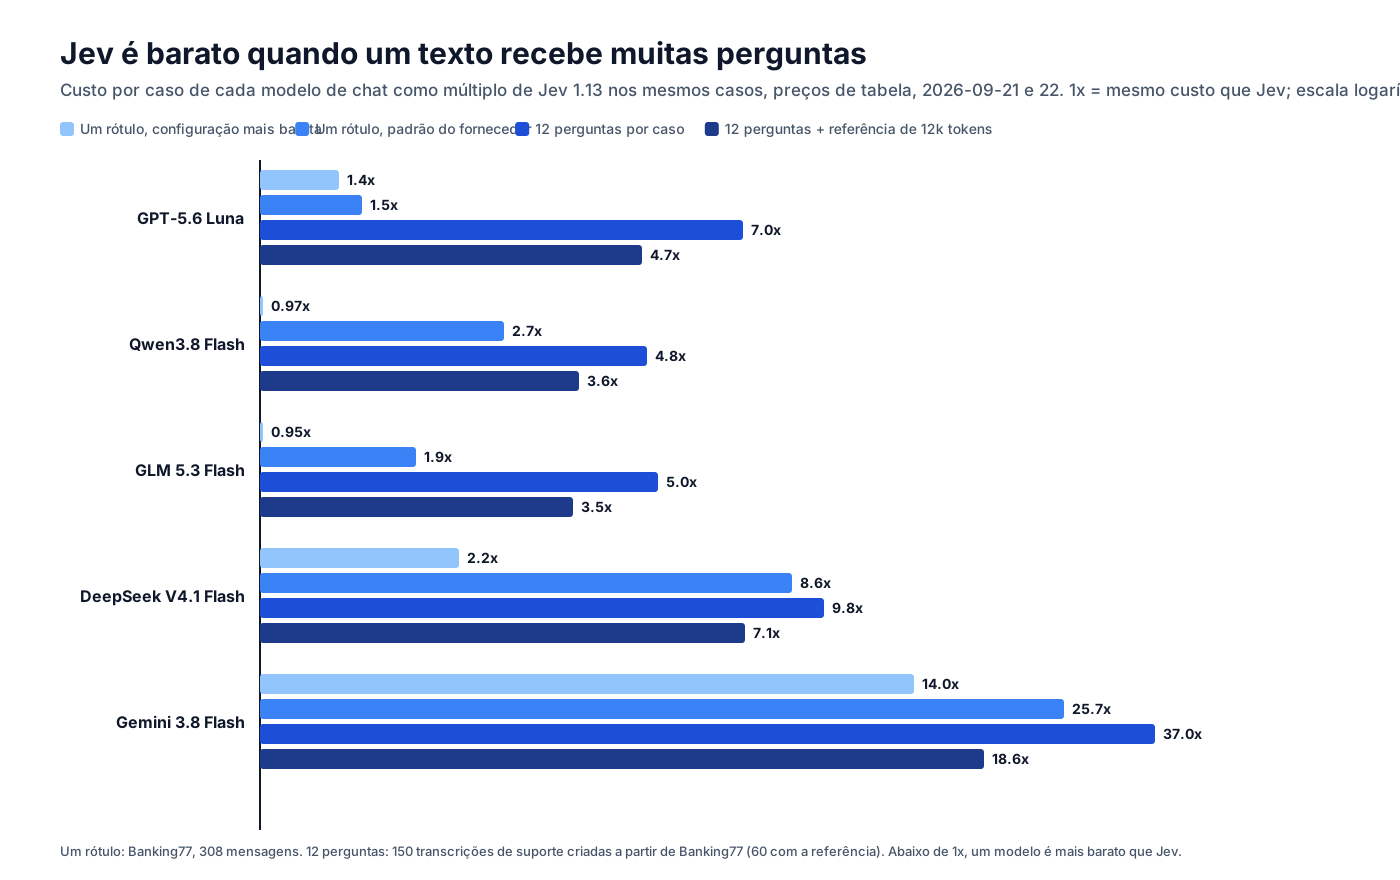
Três fatores alteram esse múltiplo. O primeiro é o número de perguntas. Um modelo de chat precisa gerar uma resposta para cada pergunta, e a saída é a parte cara (GPT-5.6 Luna cobra $1.20 por milhão de tokens de saída e $0.20 pelos de entrada). No Jev, as respostas são gratuitas e cada pergunta adicional acrescenta cerca de 17 tokens de entrada. O segundo é o thinking. Com as configurações padrão dos fornecedores, os modelos de chat geraram uma mediana de até 161 tokens de saída por rótulo, enquanto sem thinking geraram de 3 a 8. Isso aumentou o múltiplo em relação ao Jev. O terceiro é o tamanho da entrada. Com uma referência de 12,000 tokens, o template fixo e as respostas deixam de ter peso relevante, e o múltiplo se aproxima da proporção entre os preços de entrada: 3.5 vezes para o GLM 5.3 Flash e até 18.6 vezes para o Gemini 3.8 Flash. O DeepSeek V4.1 Flash fica em 7.1 vezes.
No teste de um único rótulo, o Jev não gera economia em relação aos modelos mais baratos. As 77 opções adicionam cerca de 1,400 tokens a cada chamada. Assim, uma mensagem de uma linha contabiliza cerca de 1,690 tokens de entrada no Jev, contra 440 no Qwen3.8 Flash.
| Teste, custo por 1,000 casos | Jev | Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| 12 perguntas por caso | $0.027 | $0.19 | $0.13 | $0.14 | $0.27 | $1.02 |
| 12 perguntas, referência de 12,000 tokens | $0.43 | $2.02 | $1.57 | $1.53 | $3.06 | $8.06 |
| Um rótulo, configuração mais barata | $0.071 | $0.098 | $0.069 | $0.068 | $0.16 | $0.99 |
| Um rótulo, configuração padrão do fornecedor | $0.071 | $0.11 | $0.19 | $0.13 | $0.61 | $1.83 |
Quanto o Jev é mais rápido?
Cerca de 7 a 28 vezes, descontado o tempo de rede. A mediana do Jev ficou entre 0.11 e 0.12 segundos, enquanto os modelos de chat levaram de 0.79 a 3.25 segundos.
Cronometramos 40 chamadas por modelo e tarefa, uma de cada vez em uma conexão mantida aberta, e subtraímos o tempo de ida e volta medido nessa mesma conexão com uma requisição que não faz nenhum cálculo de modelo. Resta o tempo do próprio modelo mais o trajeto do nosso proxy até o provedor, igual para todos os modelos.
| Segundos após descontar a rede, mediana (percentil 95) | Jev | GPT-5.6 Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Um rótulo, configuração mais barata | 0.11 (0.21) | 1.33 (1.80) | 0.96 (1.68) | 1.22 (3.06) | 0.79 (1.35) | 1.95 (3.76) |
| Um rótulo, configuração padrão do fornecedor | 0.11 (0.21) | 1.45 (5.29) | 3.25 (21.5) | 2.97 (7.32) | 1.19 (10.4) | 2.18 (8.22) |
| 12 perguntas por caso | 0.12 (0.20) | 1.66 (2.56) | 3.21 (5.21) | 3.13 (6.20) | 1.33 (1.70) | 2.14 (2.89) |
O impacto do thinking aparece no percentil 95. Com as configurações padrão dos fornecedores, uma em cada vinte chamadas do Qwen3.8 Flash levou mais de 21 segundos para retornar um único rótulo. As chamadas mais lentas do Jev continuaram próximas de 0.2 segundos.
Adicionar perguntas não deixou o Jev mais lento: para um mesmo ticket de suporte, passar de 1 para 60 perguntas de sim ou não moveu a mediana em menos de 0.1 segundo, e a chamada com 60 perguntas faturou 1,371 tokens de entrada, $0.000058. Nas chamadas com 20 perguntas, todas as respostas estavam certas nas cinco execuções.
Como esses resultados se comparam às afirmações da TypeSafe?
A direção é a mesma, mas os ganhos medidos aqui são menores porque as comparações são diferentes. No post de lançamento, a TypeSafe cita um custo até 444.6 vezes menor e uma execução 193.6 vezes mais rápida. A medição compara o Jev com modelos frontier usando reasoning em workflows com várias etapas, e o próprio texto descreve esses números como “o limite superior dos ganhos no mundo real” (post de lançamento).
Os testes de workflow publicados pela empresa incluem o GPT-5.6 Luna: o Jev alcançou 67.8% de precisão, $0.0004 e 0.4 segundos por caso, contra 66.8%, $0.0033 e 12.9 segundos do Luna. Isso equivale a cerca de 8 vezes menos custo e 32 vezes mais velocidade. Em nosso teste com 12 perguntas, o Luna sem thinking custou 7 vezes mais que o Jev e levou 14 vezes mais tempo após descontar a rede, valores da mesma ordem de grandeza. Para um único rótulo, a diferença de custo desaparece em relação aos modelos flash mais baratos.
O Jev é tão preciso quanto um LLM flash?
Ficou próximo no teste de workflow, atrás nos testes de classificação e nunca em primeiro lugar. Com 12 perguntas por caso, o micro F1 do Jev, calculado sobre todos os “sim” e “não” de todas as perguntas, em uma escala na qual 1.0 é perfeito, ficou dentro da faixa dos modelos de chat. Suas probabilidades também ordenaram respostas certas e erradas quase tão bem quanto os melhores modelos.
| 12 perguntas por caso (150 transcrições) | Micro F1 com threshold 0.5 | Todas as 12 respostas corretas | AUC |
|---|---|---|---|
| Jev 1.13 | 0.909 | 61.3% | 0.990 |
| GPT-5.6 Luna, sem thinking | 0.933 | 71.3% | 0.973 |
| GPT-5.6 Luna, padrão | 0.931 | 71.3% | 0.992 |
| Gemini 3.8 Flash, low | 0.919 | 66.7% | 0.974 |
| Qwen3.8 Flash, sem thinking | 0.913 | 62.7% | 0.975 |
| GLM 5.3 Flash, low | 0.906 | 64.7% | 0.975 |
| DeepSeek V4.1 Flash, sem thinking | 0.896 | 60.0% | 0.958 |
A AUC mede a qualidade da ordenação pelas probabilidades. Uma AUC de 1.0 significa que todo “sim” verdadeiro recebeu uma probabilidade maior que qualquer “não”. Com a referência de 12,000 tokens antes da transcrição, o Jev manteve a precisão: F1 de 0.914, contra 0.922 nas mesmas 60 transcrições sem a referência.
Nos testes de classificação, os modelos de chat ficaram à frente, principalmente com as configurações padrão de thinking:
| Modelo e configuração | Um rótulo (Banking77) | 28 rótulos (micro F1 no GoEmotions) | Prompt injection |
|---|---|---|---|
| Jev 1.13 | 80.2% | 0.228 | 74.1% |
| GPT-5.6 Luna, sem thinking / padrão | 85.1% / 87.3% | 0.301 / 0.342 | 69.6% / 72.2% |
| GPT-5.6 Terra, sem thinking / padrão | 83.4% / 85.4% | 0.273 / 0.324 | 80.9% / 79.1% |
| Gemini 3.8 Flash, low / padrão | 84.4% / 83.8% | 0.373 / 0.372 | 81.9% / 82.8% |
| Qwen3.8 Flash, desativado / padrão | 77.6% / 81.5% | 0.286 / 0.338 | 81.9% / 80.2% |
| GLM 5.3 Flash, low / padrão | 77.9% / 79.9% | 0.255 / 0.310 | 81.9% / 81.9% |
| DeepSeek V4.1 Flash, desativado / padrão | 77.3% / 81.8% | 0.289 / 0.365 | 82.8% / 86.2% |
| Seed 2.0 Mini, sem thinking | 70.8% | 0.245 | 66.4% |
O GPT-5.6 Luna e o Terra responderam a 115 dos 116 textos de injection e a 199 dos 200 comentários. Uma requisição de cada teste retornou erro, e a precisão foi calculada sobre as respostas recebidas. Uma resposta diferente de “sim” ou “não” conta como errada. No teste de emoções, o Jev respondeu “sim” com frequência excessiva: uma emoção à qual atribuiu probabilidade de 0.80 a 0.95 aparecia no rótulo humano em apenas 15% dos casos. Os rótulos de emoção são esparsos, pois os anotadores escolheram uma ou duas emoções por comentário. Isso reduz a pontuação de todos os modelos, mas todos receberam a mesma instrução. No teste de prompt injection, o threshold padrão de 0.5 do Jev não era o ponto de corte adequado, como mostra a próxima seção.
Dá para confiar na confiança do Jev?
As probabilidades distinguem bem as respostas certas das erradas, mas não são calibradas no sentido estrito. Cada tarefa precisa de seu próprio threshold. Uma probabilidade calibrada de 0.8 estaria correta em 80% dos casos. No Banking77, o Jev acertou 98% das respostas com probabilidade igual ou superior a 0.99, mas acertou cerca de metade das respostas abaixo de 0.8.
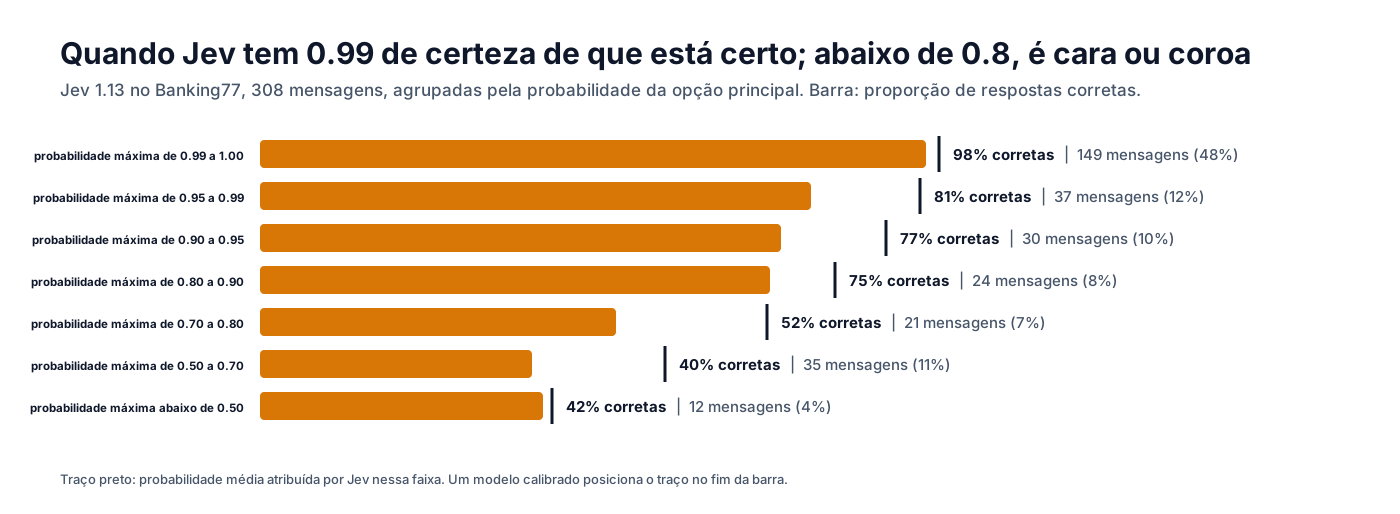
Quase metade das mensagens do Banking77 (48%) recebeu uma probabilidade máxima de 0.99 ou mais. Um pipeline que aceite esses casos e encaminhe os demais a um modelo maior mantém 98% de precisão nessa parcela do tráfego. O teste de prompt injection mostra o outro lado. Com o ponto de corte padrão de 0.5, o Jev identificou apenas metade dos ataques. A outra metade recebeu probabilidades entre 0.03 e 0.5, baixas em termos absolutos, mas em geral maiores que as dos textos benignos, cuja mediana foi 0.02. Ao ordenar os textos por probabilidade, o modelo separou ataques de textos benignos com AUC de 0.984.
| Threshold no conjunto de injection | Precisão do Jev | Ataques detectados | Falsos alarmes (entre 56 benignos) |
|---|---|---|---|
| 0.5 (padrão) | 74.1% | 50.0% | 0 |
| 0.1 | 88.8% | 80.0% | 1 |
| 0.05 | 93.1% | 91.7% | 3 |
Esses thresholds foram escolhidos nos mesmos 116 textos, portanto devem ser tratados como um limite superior. Um modelo de chat também pode fornecer probabilidades quando sua API retorna log-probabilities, a probabilidade que o próprio modelo atribui a cada token gerado. Entre os modelos de chat testados, o Qwen3.8 Flash e o Seed 2.0 Mini retornaram esses valores. A probabilidade do token “yes” no Qwen3.8 Flash ordenou os textos de injection com AUC de 0.977.
Você deve usar o Jev ou um LLM flash?
| Se a sua tarefa é | Use | Motivo, com base nestes testes |
|---|---|---|
| fazer muitas perguntas de sim/não ou escolha única sobre o mesmo texto | Jev | de 4.8 a 37 vezes mais barato, de 11 a 27 vezes mais rápido após descontar a rede, com precisão semelhante |
| tomar uma decisão dentro de um loop que precisa responder em menos de um segundo | Jev | de 0.11 a 0.12 s após descontar a rede |
| avaliar documentos longos com poucos critérios por documento | Jev | o custo se aproxima da proporção entre os preços de entrada, de 3.5 a 18.6 vezes menor |
| atribuir um rótulo por mensagem curta pelo menor custo | Jev, Qwen3.8 Flash ou GLM 5.3 Flash sem thinking | o custo é o mesmo; os LLMs não retornam probabilidade, a menos que você leia as log-probabilities |
| obter o rótulo com maior precisão | GPT-5.6 Luna na configuração padrão | 87.3% no Banking77 por $0.11 a cada 1,000 casos |
| trabalhar com números, datas, contagem ou geração de texto | um modelo de chat | a TypeSafe lista esses casos entre os pontos fracos do Jev |
O padrão que melhor aproveitou o Jev em nossos testes foi decompor a decisão em várias perguntas específicas sobre o mesmo texto, agir sobre respostas acima de um threshold ajustado com seus próprios dados rotulados e enviar o restante a um modelo de chat.
Perguntas frequentes
O que é o TypeSafe Jev?
O Jev é um modelo de decisão da TypeSafe que responde a perguntas tipadas, como sim/não, escolha única ou avaliação em uma escala, sobre um trecho de texto. Em vez de gerar texto, ele retorna probabilidades. O Jev 1.13 é a versão atual, disponibilizada pelo alias jev-latest, por $0.042 por milhão de tokens de entrada, com saída gratuita.
O Jev é mais barato que um LLM? Depende da tarefa. Ao fazer 12 perguntas sobre cada transcrição de suporte, o GPT-5.6 Luna sem thinking custou 7 vezes mais que o Jev, e o Gemini 3.8 Flash custou 37 vezes mais. Para atribuir um único rótulo entre 77 opções, o Qwen3.8 Flash e o GLM 5.3 Flash sem thinking tiveram o mesmo custo do Jev.
O Jev é mais preciso que o GPT-5.6 Luna? Não em nossos testes. O GPT-5.6 Luna sem thinking obteve micro F1 de 0.933, contra 0.909 do Jev, no teste com 12 perguntas por caso. No Banking77, os resultados foram 85.1% e 80.2%, respectivamente. Com o threshold padrão, o Jev detectou mais prompt injections que o Luna sem thinking.
Por que a TypeSafe afirma que o Jev é 444 vezes mais barato? Esse número compara o Jev com modelos frontier usando reasoning em workflows com várias etapas, e a própria TypeSafe o descreve como o limite superior dos ganhos. Em nossa comparação com modelos flash, o Jev foi de 4.8 a 37 vezes mais barato em um workflow de 12 perguntas e teve custo praticamente igual para um único rótulo.
As probabilidades do Jev são calibradas? Não no sentido estrito. No Banking77, as respostas com probabilidade igual ou superior a 0.99 estavam corretas em 98% dos casos, mas abaixo de 0.8 a taxa de acerto ficou em cerca de metade. No teste de prompt injection, o modelo atribuiu probabilidade inferior a 0.5 a metade dos ataques. Ajuste um threshold por tarefa usando seus próprios dados rotulados.
Relacionado: melhor API de LLM flash em 2026, comparação de saídas estruturadas de LLMs, controles de thinking em LLMs, melhor LLM por caso de uso.