
A/B test del prompt: rollout al 10%, costo 1.9x
Invia il 10% del traffico a un nuovo prompt, per sessione. Su 200 sessioni, l'8.0% lo ha usato, nessuna ha cambiato versione e il costo per chiamata è stato 1.94x.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| GPT-6 Luna v1 di support-answer è costata $0.000110 per chiamata sulle 1,272 chiamate del rollout, con una latenza mediana di 4.9 s. Con reasoning_effort none è costata $0.000034. | Versione di produzione nella demo | da $0.1/M |
| DeepSeek V4.1 Flash v3, con lo stesso prompt su questo modello, ha risposto più velocemente (mediana di 3.1 s), ma è costata $0.000213 per chiamata, 1.94 volte v1, perché ha generato 1.6 volte i token di output a un prezzo per token più alto. | Versione candidata nella demo | da $0.3/M |
Indice
- Come inviare il 10% del traffico in produzione a una nuova versione?
- Quali chiamate vanno alla candidata?
- Come confrontare le due versioni?
- Disattivare il ragionamento cambia il risultato?
- Le esecuzioni di test falsano il confronto?
- Cosa resta escluso?
- Domande frequenti
- Come fare un A/B test di un prompt in produzione?
- Il rollout mantiene ogni conversazione sulla stessa versione?
- Una modifica al prompt può aumentare il costo senza cambiare il testo?
- Letture correlate
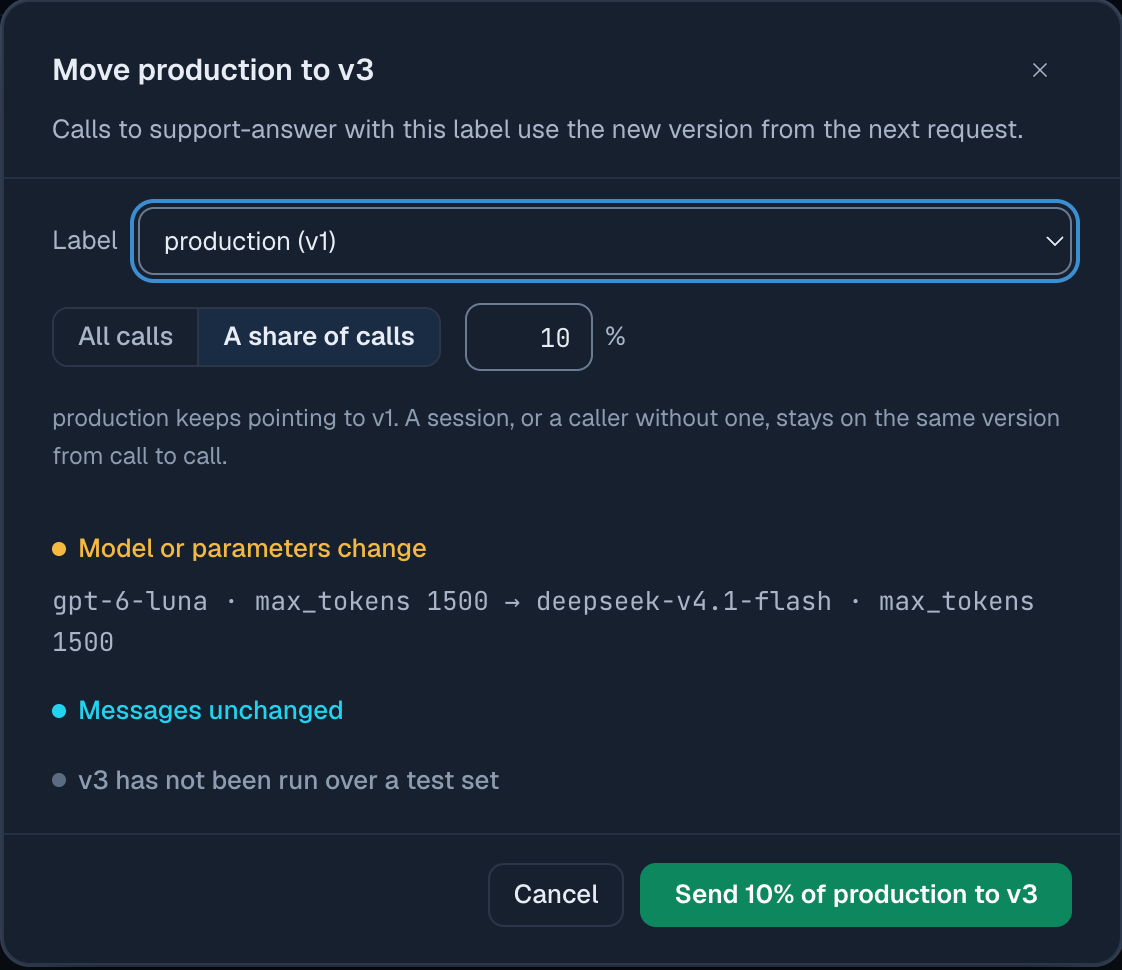
Il rilascio graduale di un prompt indirizza una quota delle chiamate a un dato ID verso una versione candidata. Le altre continuano a usare la versione in produzione, così puoi confrontarle sul traffico reale prima di passare tutti alla nuova versione. Nella libreria di prompt di Synthorai configuri il rollout sull’etichetta production (“v1, con v3 al 10%”). Il gateway sceglie la versione in base all’ID di sessione, quindi una conversazione non cambia versione a metà. Nella nostra prova, con una quota impostata al 10%, 16 sessioni su 200 (8.0%) sono finite sulla candidata e ogni sessione ha mantenuto la stessa versione. La candidata usava un altro modello, ma nessuno aveva misurato il costo di questa modifica. Già con la sola quota del 10%, i totali per versione mostravano un costo per chiamata pari a 1.92 volte quello della versione in produzione.
TL;DR
- Con il rollout al 10%, 16 sessioni su 200 (8.0%, intervallo al 95% da 5.0 a 12.6%) hanno usato la candidata; al 50%, sono state 111 su 200 (55.5%).
- Tutte le 400 sessioni di tre turni hanno mantenuto una sola versione del prompt. Lo stesso vale per tutti gli utenti finali identificati tramite
_user, il campouserdel body osafety_identifier. - La candidata, lo stesso prompt su DeepSeek V4.1 Flash anziché GPT-6 Luna, è costata $0.000213 per chiamata contro $0.000110, con una latenza mediana di 3.1 s contro 4.9 s.
- Le chiamate vincolate a
prompt_version=1non sono mai finite sulla candidata: 0 su 40.
Questa guida riprende Versionamento dei prompt, dove vengono configurati i due prompt e le rispettive versioni. Dalla stessa directory di github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
Il rollout è stato eseguito il 19 ottobre 2026, con 1,840 chiamate; i controlli sulla ripartizione degli utenti finali risalgono al 20 ottobre. La versione in produzione è la v1 di support-answer su GPT-6 Luna. La candidata è la v3: stesso testo di sistema e stessi messaggi, ma su DeepSeek V4.1 Flash. Cambia solo il modello.
Come inviare il 10% del traffico in produzione a una nuova versione?
All’etichetta production assegni una seconda versione e una quota di traffico. Con una chiave admin basta una chiamata per avviare il rollout e un’altra per interromperlo:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
Per i client non cambia nulla: continuano a chiamare support-answer senza specificare una versione. L’header di risposta X-Synthorai-Prompt-Version indica quale versione ha risposto a ogni chiamata. Per mettere in produzione la candidata, sposti production su quella versione e il rollout termina. Nella console la stessa impostazione si chiama “Rilascia gradualmente” e si trova nella pagina della candidata. Nell’elenco dei prompt, l’etichetta appare poi come “production v1 · v3 10%”.
Quali chiamate vanno alla candidata?
Il gateway sceglie la versione usando una chiave stabile per ogni chiamata. Finché la quota non cambia, alla stessa chiave corrisponde sempre la stessa versione. Viene usato il primo di questi elementi presente nella chiamata:
- l’ID di sessione (
X-Session-Id, l’header descritto in Tracciare un agente LLM); - l’utente finale: l’etichetta
_userinX-Synthorai-Metadata, altrimentiusernel body,safety_identifierometadata.user_iddi Anthropic; - in assenza di questi dati, la richiesta stessa: ogni chiamata viene quindi assegnata in modo indipendente.
rollout.py ha verificato ogni caso con quote del 10% e del 50%. Ogni sessione comprendeva 3 turni, ogni utente finale 2 chiamate:
| Chiamate | Al 10%: su v3 | Al 50%: su v3 | Versione mantenuta |
|---|---|---|---|
200 sessioni, X-Session-Id | 16 = 8.0% (da 5.0 a 12.6%) | 111 = 55.5% (da 48.6 a 62.2%) | 400 sessioni su 400 |
50 utenti finali, etichetta _user | 6 | 27 | 100 utenti su 100 |
| 100 chiamate senza nessuno dei due | 11 = 11.0% (da 6.3 a 18.6%) | 49 = 49.0% (da 39.4 a 58.7%) | non applicabile |
20 chiamate vincolate a prompt_version=1 | 0 | 0 |
Gli intervalli tra parentesi sono intervalli di confidenza al 95%: indicano dove è plausibile che si trovi la quota reale, dato il numero di prove. Tutti contengono la quota impostata. Un’esecuzione separata al 50% ha verificato i due campi del body: 50 utenti identificati solo dal campo user e 20 solo da safety_identifier, con 2 chiamate ciascuno. Tutti i 70 utenti hanno mantenuto una sola versione; 25 dei 50 e 8 dei 20 hanno usato la v3.
Per il tuo rollout ne derivano due indicazioni. L’ID di sessione mantiene coerente una conversazione su più turni: invialo a ogni chiamata della conversazione. Senza una chiave, lo stesso utente può ricevere la v1 a una chiamata e la v3 alla successiva. Una chiamata che specifica la versione tramite prompt_version, invece, resta fuori dal rollout: un test o un job batch vincolato a una versione continua a ricevere esattamente quella.
Come confrontare le due versioni?
La pagina Prompts aggrega chiamate, errori, spesa, token e latenza per versione. L’API Requests restituisce gli stessi dati con i filtri prompt_id e prompt_version. La demo li ha letti dopo il rollout:
| Versione | Richieste | Spesa | Spesa per chiamata | Latenza mediana | Token di output per chiamata, media | Token di ragionamento per chiamata, media |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3, DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
I token di ragionamento sono quelli che il modello genera per ragionare prima di rispondere. Vengono fatturati come output, ma non compaiono nella risposta.
La scheda Chiamate del prompt mostra lo stesso tipo di totali. Su 7 giorni conta tutte le chiamate della demo per ogni versione, non solo quelle del rollout, quindi i valori sono più alti rispetto alla tabella.
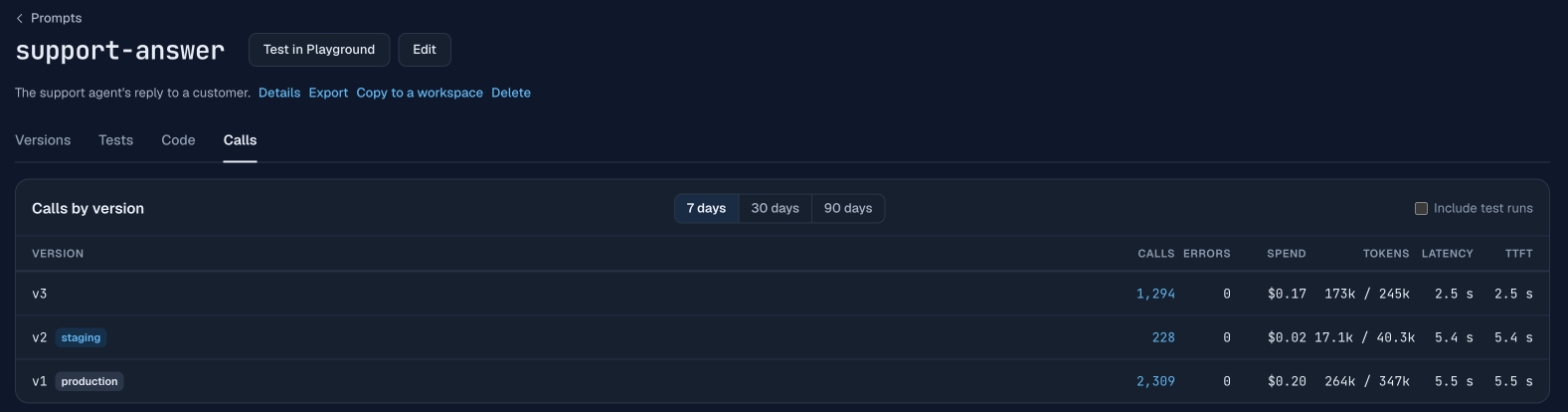
La v3 è più veloce e, sull’intera esecuzione, costa 1.94 volte di più per chiamata. Il divario ha due cause. Su questo gateway, DeepSeek V4.1 Flash costa più di GPT-6 Luna per token: nella fascia fuori picco, $0.15 per l’input e $0.60 per l’output ogni milione di token, contro $0.10 e $0.50. Inoltre, la v3 ha generato 1.6 volte i token di output. La differenza è quasi tutta nel ragionamento: 256 token per chiamata contro 149, mentre le risposte vere e proprie avevano rispettivamente 65 e 48 token (mediane). Nessuno di questi due fattori è visibile nel testo del prompt. Il divario era già presente con la sola quota del 10%: le 71 chiamate gestite dalla v3 sono costate $0.000212 ciascuna, contro $0.000111 per le 749 gestite dalla v1, cioè 1.92 volte tanto.
Il prezzo dipende anche dall’orario. Tutte le chiamate DeepSeek del rollout sono state eseguite nella fascia fuori picco prevista dal gateway per questo modello (dalle 22:00 alle 08:00, ora di Pechino). Il costo era la metà delle tariffe di picco di $0.30 e $1.20. L’esecuzione da 140 chiamate del 20 ottobre è avvenuta nella fascia di picco: in quel caso la v3 è costata $0.000394 per chiamata contro $0.000107 per la v1, ossia 3.7 volte tanto, rispettivamente su 66 e 74 chiamate.
Delle 1,840 chiamate, 1,839 hanno restituito 200. Una è andata in timeout lato client dopo 300 s ed è conteggiata come errore; gli altri turni della sua sessione sono stati comunque serviti.
Disattivare il ragionamento cambia il risultato?
Riduce il costo di entrambe le versioni di almeno due terzi, ma non rende la v3 più economica. effort.py ha chiamato ogni versione 50 volte senza reasoning_effort e 50 volte con reasoning_effort: "none" inviato dal client. Ha usato i messaggi dei clienti del set di test di Testare un prompt prima del rilascio, che contengono tutti un numero d’ordine (40 messaggi, di cui 10 ripetuti due volte):
| Versione | reasoning_effort | Costo per chiamata | Token di output, media | Latenza mediana | Risposta con numero d’ordine | Risposta giudicata pertinente alla domanda |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | predefinito | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1, GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3, DeepSeek V4.1 Flash | predefinito | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3, DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
“none” ha eliminato completamente il ragionamento su entrambi i modelli, riducendo il costo per chiamata del 68% sulla v1 e del 75% sulla v3. Per quanto si possa concludere da 50 chiamate, le risposte hanno retto: tutte contenevano ancora il numero d’ordine. Il controllo con valutatore, una chiamata a Claude Sonnet 5.5 che verifica se la risposta affronta la domanda del cliente, ha registrato variazioni di 2 e 4 risposte su 50. Il test esatto di Fisher ha dato p = 0.82 e 0.44. Questo test indica la probabilità di osservare una differenza almeno così grande se “none” non avesse alcun effetto; valori così alti indicano che la variazione è compatibile con il caso. Con “none” su entrambi, la v3 costava ancora 1.44 volte la v1 per chiamata ($0.000049 contro $0.000034). Anche queste chiamate sono state eseguite nella fascia fuori picco del gateway per DeepSeek.
Durante un rollout, il client non sa quale versione risponderà: se invia reasoning_effort, il valore si applica a entrambe. Puoi invece salvare l’impostazione nella versione. Una versione può memorizzare reasoning_effort, che il gateway inserisce nelle richieste Chat Completions e Responses quando la chiamata non imposta già il ragionamento. Una candidata salvata così porta la propria impostazione nel rollout. I totali per versione confrontano quindi le configurazioni così come verrebbero rilasciate.
Le esecuzioni di test falsano il confronto?
Per impostazione predefinita no, perché i totali per versione nella pagina Prompts escludono il traffico di test: le chiamate Playground, comprese le esecuzioni di test della console, e quelle con etichetta source: prompt-test o source: eval in X-Synthorai-Metadata. L’opzione “Includi esecuzioni di test” permette di conteggiarle. Su support-answer, attivarla ha aggiunto 150 chiamate sia alla v1 sia alla v2: 110 ciascuna da una valutazione etichettata e 40 ciascuna da un test nella console. La v3 è rimasta invariata. I log e l’API Requests elencano comunque tutte le chiamate: se durante il rollout hai eseguito una valutazione, filtra per etichetta:
X-Synthorai-Metadata: {"source":"eval"}Cosa resta escluso?
- Test statistici su costo e latenza. La tabella per versione confronta totali e medie; non abbiamo verificato le differenze con test statistici. Prima di prendere decisioni in base a una differenza, verificala, soprattutto se è piccola.
- Qualità delle risposte sul traffico reale. Un rollout mostra quanto costa una versione e quanto è veloce. Per verificare se le risposte sono corrette, è più semplice usare un insieme fisso di input prima del rollout; Testare un prompt prima del rilascio lo fa per la v2.
- Arresto automatico. La demo non interrompe il rollout se il tasso di errore o il costo della candidata supera una soglia. È un admin a modificare la quota, spostare l’etichetta sulla candidata o interrompere il rollout.
Domande frequenti
Come fare un A/B test di un prompt in produzione?
Assegna all’etichetta di produzione una versione candidata e una quota di traffico, continua a chiamare l’ID del prompt come prima e confronta i totali delle due versioni. Nella demo, una quota del 10% ha indirizzato 16 sessioni su 200 alla candidata. Dopo poche centinaia di chiamate, i totali ne mostravano già il costo.
Il rollout mantiene ogni conversazione sulla stessa versione?
Sì, se le chiamate della conversazione includono un ID di sessione. Tutte le 400 sessioni della demo hanno mantenuto una sola versione nei tre turni. Senza ID di sessione viene usato l’identificativo dell’utente finale; in assenza di entrambi, ogni chiamata viene assegnata in modo indipendente.
Una modifica al prompt può aumentare il costo senza cambiare il testo?
Sì, basta cambiare modello mantenendo lo stesso testo, come nella demo. La candidata su DeepSeek V4.1 Flash è costata 1.94 volte la versione su GPT-6 Luna per chiamata: su questo gateway il prezzo per token era più alto e il modello ha usato più token per ragionare. Confronta il costo per chiamata dell’intera versione, non il prezzo del modello.
Letture correlate
- Versionamento dei prompt: chiamare un prompt tramite ID e spostare un’etichetta.
- Testare un prompt prima del rilascio: set di test e controlli, con un confronto tra v2 e v1.
- Perché il mio agente LLM costa tanto?: altre quattro cause di costi elevati, individuate nelle tracce.
- Guida alla libreria di prompt: rollout, statistiche per versione e tutti i campi.