
Versionamento dei prompt: modifiche in meno di 10 s, senza redeploy
Conserva i prompt LLM in una libreria, richiamali con prompt_id e pubblica spostando un'etichetta. Misurazioni: 8-9 s sulle chiamate reali, gli stessi 114.5 token di prompt della richiesta inline.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| GPT-6 Luna Eseguite v1 e v2 di support-answer. Una chiamata tramite id del prompt ha inviato gli stessi 114.5 token di prompt (mediana di 20 coppie) della richiesta renderizzata inviata inline. | Modello per il prompt di risposta della demo | da $0.1/M |
| DeepSeek V4.1 Flash Eseguito policy-check v1 con uno schema di output memorizzato nella versione: una risposta JSON in 18 token di output per $0.000033, con reasoning_effort impostato su none. | Modello per il controllo JSON della demo | da $0.3/M |
Indice
- Come si richiama un prompt tramite id?
- Una chiamata tramite id costa più del prompt scritto nel codice?
- Quanto tempo serve perché lo spostamento di un’etichetta abbia effetto sulle chiamate?
- Cosa succede quando una chiamata non può essere eseguita?
- Cosa può contenere una versione oltre al testo?
- Dove si vede quale versione ha risposto a una chiamata?
- Cosa resta fuori?
- FAQ
- Cos’è il versionamento dei prompt?
- Richiamare un prompt tramite id aggiunge latenza o token?
- Quanto rapidamente arriva in produzione una modifica al prompt?
- Posso continuare a usare l’SDK OpenAI o Anthropic?
- Altre letture
Il versionamento dei prompt consiste nel conservare ogni prompt fuori dal codice, in versioni numerate e immutabili, richiamarlo tramite un id e scegliere la versione da usare in produzione facendo puntare un’etichetta a quella versione. Un’etichetta è un riferimento con un nome, come production o staging, che punta a una sola versione alla volta. Nella libreria di prompt di Synthorai, la richiesta identifica il prompt con prompt_id; il gateway inserisce messaggi, modello e parametri della versione. Spostando l’etichetta production si cambia ciò che riceveranno le chiamate successive. Nei nostri test, lo spostamento è diventato effettivo sulle chiamate reali in 8-9 secondi con traffico costante e alla prima chiamata dopo un periodo di inattività. Una chiamata tramite id ha inviato esattamente lo stesso numero di token di prompt della stessa richiesta scritta nel codice.
TL;DR
- Una chiamata al gateway Synthorai tramite
prompt_idha inviato una mediana di 114.5 token di prompt su 20 coppie, come la richiesta inline. - Lo spostamento dell’etichetta
productionè diventato effettivo sulle chiamate dopo 8.0-8.5 s (mediana) con traffico costante, e subito dopo 15 s senza chiamate. - In 20 spostamenti dell’etichetta, nessuna chiamata ha ricevuto la vecchia versione dopo che la prima aveva ricevuto quella nuova.
- Le chiamate non eseguibili hanno restituito 400 o 404 prima di invocare qualsiasi modello, senza addebiti.
Questa guida sposta nella libreria i prompt dell’agente di assistenza di Tracciare un agente LLM e li richiama in tutti i modi accettati dal gateway. Il codice si trova su github.com/synthorai-io/use-cases, nella directory prompt-library/. Servono Python 3.10 o successivo, una chiave di inferenza e una chiave amministrativa con il permesso prompts.write, disponibili nella console.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put both keys in it
cd prompt-library
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python setup.py         # saves the prompts and their versions; safe to run again
python call.py          # every way to call a prompt
python ship.py          # moves production and times it
python errors.py        # what a call that cannot be served answers
I test di questa pagina risalgono al 19 ottobre 2026. setup.py salva due prompt. support-answer gestisce la risposta dell’agente e ha quattro versioni, ciascuna con una modifica realistica; policy-check è un controllo eseguito da un sottoagente che risponde in JSON:
| Prompt | Versione | Cosa cambia | Modello |
|---|---|---|---|
support-answer | v1 | versione di base: indicare il numero d’ordine, non promettere mai una data di rimborso | GPT-6 Luna |
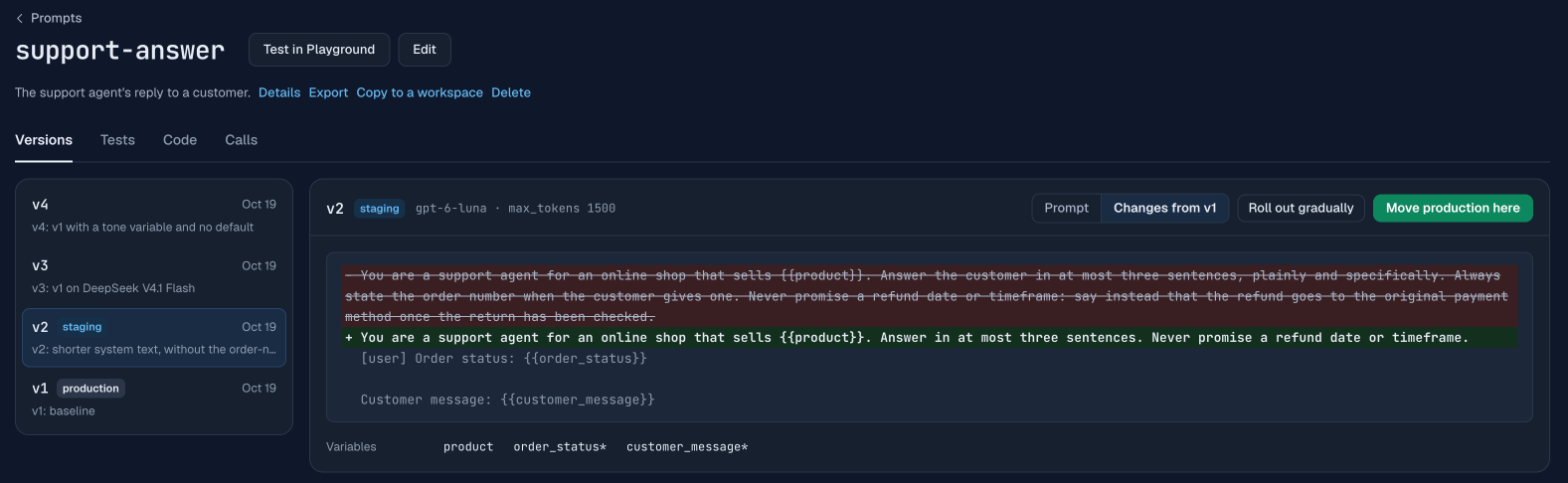
support-answer | v2 | testo di sistema più breve, senza la regola sul numero d’ordine | GPT-6 Luna |
support-answer | v3 | testo di v1 su un altro modello | DeepSeek V4.1 Flash |
support-answer | v4 | v1 con una variabile {{tone}} senza valore predefinito | GPT-6 Luna |
policy-check | v1 | argomenti e livello di rischio in JSON conforme a uno schema | DeepSeek V4.1 Flash |
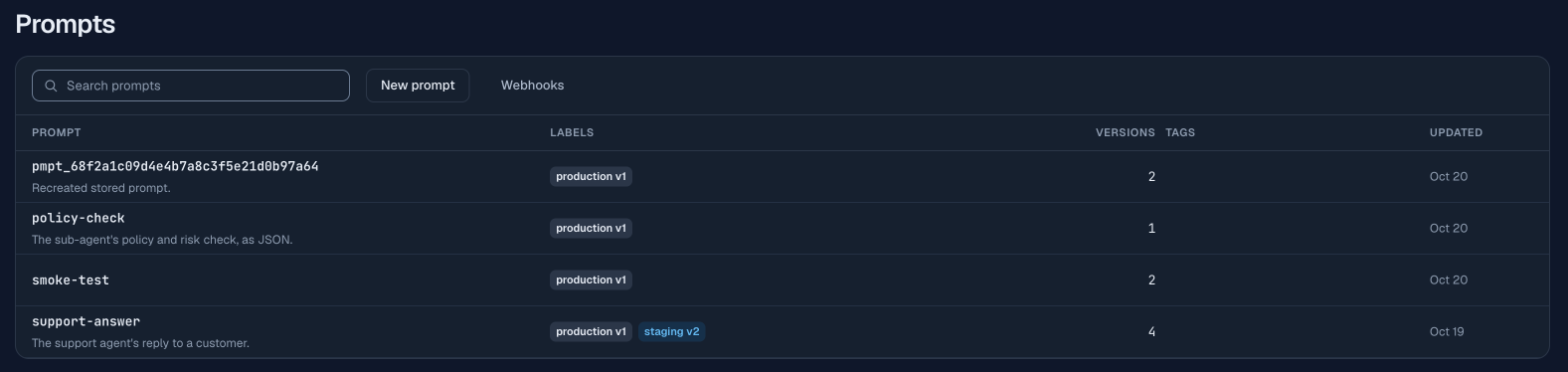
production punta a v1 e staging a v2. v2 e v3 sono al centro delle due guide successive: testare una versione prima di pubblicarla e distribuirla a una parte del traffico di produzione. La console mostra le differenze tra ogni versione e quella precedente:
Come si richiama un prompt tramite id?
Si invia una normale richiesta a /v1/chat/completions, /v1/responses o /v1/messages, aggiungendo prompt_id e prompt_variables al corpo. Una variabile è un segnaposto {{name}} nel testo della versione; prompt_variables assegna a ciascuna variabile il valore per quella chiamata. Gli SDK richiedono un modello e un messaggio, quindi si inviano un nome di modello qualsiasi e un messaggio utente vuoto: il gateway usa il modello della versione e scarta il messaggio vuoto. Con l’SDK Python di OpenAI, i campi aggiuntivi vanno in extra_body:
import os
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key=os.environ["SYNTHORAI_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="any",                                   # the version's model is used
    messages=[{"role": "user", "content": ""}],    # required by the SDK; dropped
    extra_body={
        "prompt_id": "support-answer",
        "prompt_variables": {
            "customer_message": "Where is order A-50977? It has been a week.",
            "order_status": "in transit, shipped on 2026-10-01",
        },
    },
)
print(raw.headers["x-synthorai-prompt-version"])   # which version answered
print(raw.parse().choices[0].message.content)
La chiamata non include product perché la versione ne definisce un valore predefinito (“home electronics”). L’header di risposta X-Synthorai-Prompt-Version indica quale versione ha risposto. Quando si usa un’etichetta, è l’unico modo per saperlo.
Se non si specifica una versione, la chiamata usa quella a cui punta production. Due campi permettono di sceglierne un’altra; la chiamata può inviare l’uno o l’altro, non entrambi:
| Campo | Esempio | Versione usata nella demo |
|---|---|---|
| nessuno | v1 (production) | |
prompt_label | "staging" | v2 |
prompt_version | 1 | v1 |
La stessa chiamata tramite id ha funzionato su tutti e tre gli endpoint: Chat Completions e Responses con l’SDK OpenAI, Messages con l’SDK Anthropic e lo stesso extra_body. Tutte e tre hanno usato v1 su GPT-6 Luna. Su Responses, i messaggi della versione finiscono in input; la guida alla libreria di prompt descrive la corrispondenza dei campi per ogni endpoint.
Una chiamata tramite id costa più del prompt scritto nel codice?
Il costo è lo stesso della richiesta scritta nel codice, perché il gateway invia al provider una normale richiesta. Lo abbiamo verificato con 20 coppie di chiamate. Per ogni coppia abbiamo renderizzato il prompt, inviato la richiesta risultante inline e inviato gli stessi valori tramite id. L’ordine era alternato e il salt era lo stesso all’interno della coppia: una breve stringa casuale aggiunta al messaggio per evitare che due coppie contenessero la stessa richiesta.
| Token di prompt, mediana | Latenza lato client, mediana | |
|---|---|---|
Tramite prompt_id | 114.5 | 4.1 s |
| Inline | 114.5 | 4.6 s |
Il numero di token è identico. La chiamata tramite id è stata la più veloce delle due, un risultato che non può dipendere da un overhead aggiuntivo. Interpretiamo quindi la differenza come variabilità tra chiamate di GPT-6 Luna e concludiamo che l’uso dell’id non ha aggiunto tempi misurabili. Non abbiamo sottoposto la differenza di latenza a un test statistico.
Per vedere cosa invierebbe una chiamata senza invocare un modello, basta renderizzarla. POST /v1/prompts/{id}/render accetta le stesse variabili e restituisce la richiesta e la versione risolta:
curl https://synthorai.io/v1/prompts/support-answer/render \
  -H "Authorization: Bearer $SYNTHORAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "chat", "prompt_variables": {"customer_message": "Where is order A-50977?", "order_status": "in transit"}}'
Il rendering non viene fatturato e non compare in Logs: dopo quello della demo, in Logs non c’era alcuna richiesta con il relativo id di sessione. Concorre però al rate limit della chiave.
Quanto tempo serve perché lo spostamento di un’etichetta abbia effetto sulle chiamate?
Meno di 10 secondi: nei nostri test, 8-9 s con chiamate continue e nessuna attesa dopo un periodo di inattività. Per pubblicare una versione basta una chiamata con una chiave amministrativa, che fa puntare un’etichetta a un numero di versione:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})
admin.put("/prompts/support-answer/labels/production", json={"version": 3}).raise_for_status()
Per il rollback si esegue la stessa chiamata con il vecchio numero di versione. Il codice continua a richiamare lo stesso id, senza alcun redeploy. Solo un amministratore o il proprietario del workspace può spostare un’etichetta, e ogni spostamento viene registrato nell’audit log del workspace.
ship.py ha misurato i tempi. Ha inviato una chiamata ogni 0.5 s, spostato production tramite API e continuato a chiamare finché l’header non ha indicato la nuova versione, proseguendo poi per altri 10 s. Ha ripetuto l’operazione 5 volte da v1 a v3 e 5 volte in senso inverso, quindi ha ripetuto i 10 spostamenti dopo 15 s senza chiamate:
| Caso | Invio dell’ultima chiamata che ha usato la vecchia versione | Invio della prima chiamata che ha usato la nuova versione |
|---|---|---|
| Chiamate ogni 0.5 s, da v1 a v3 | mediana di 8.02 s dopo lo spostamento (da 7.53 a 8.53) | mediana di 8.52 s (da 8.03 a 9.03) |
| Chiamate ogni 0.5 s, da v3 a v1 | mediana di 7.52 s (da 7.52 a 8.52) | mediana di 8.02 s (da 8.02 a 9.02) |
| Dopo 15 s senza chiamate, in entrambe le direzioni | nessuna | 0.0 s, in tutti i 10 spostamenti |
I tempi partono dal momento in cui la chiamata API di spostamento restituisce la risposta. La documentazione indica che lo spostamento ha effetto sulle chiamate in “circa 10 secondi”. I due casi sono compatibili con un gateway che conserva il valore letto di un’etichetta per alcuni secondi dall’ultima lettura: con traffico costante, la modifica diventa visibile quando quella copia scade; dopo una pausa, la prima chiamata rilegge l’etichetta. In nessuno dei 20 spostamenti una chiamata ha ricevuto la vecchia versione dopo la prima che aveva ricevuto quella nuova. Durante la propagazione, quindi, non abbiamo osservato alternanza tra versioni.
Cosa succede quando una chiamata non può essere eseguita?
Fallisce prima di invocare qualsiasi modello, con un 400 o un 404 nel formato di errore dell’endpoint chiamato, senza addebiti. errors.py ha inviato cinque chiamate di questo tipo:
| Chiamata | Stato | Codice | Messaggio |
|---|---|---|---|
v4 senza tone | 400 | prompt_variable_missing | ”prompt_variables: manca tone (nessun valore fornito né predefinito)“ |
| una versione e un’etichetta | 400 | prompt_invalid | ”inviare prompt_version oppure prompt_label, non entrambi” |
| un id inesistente | 404 | prompt_not_found | ”prompt_id: nessun prompt “support-answer-missing” in questo workspace” |
| versione 99 | 404 | prompt_not_found | ”il prompt “support-answer” non ha una versione 99” |
| un’etichetta che non punta ad alcuna versione | 404 | prompt_not_found | ”l’etichetta “development” del prompt “support-answer” non punta ancora ad alcuna versione” |
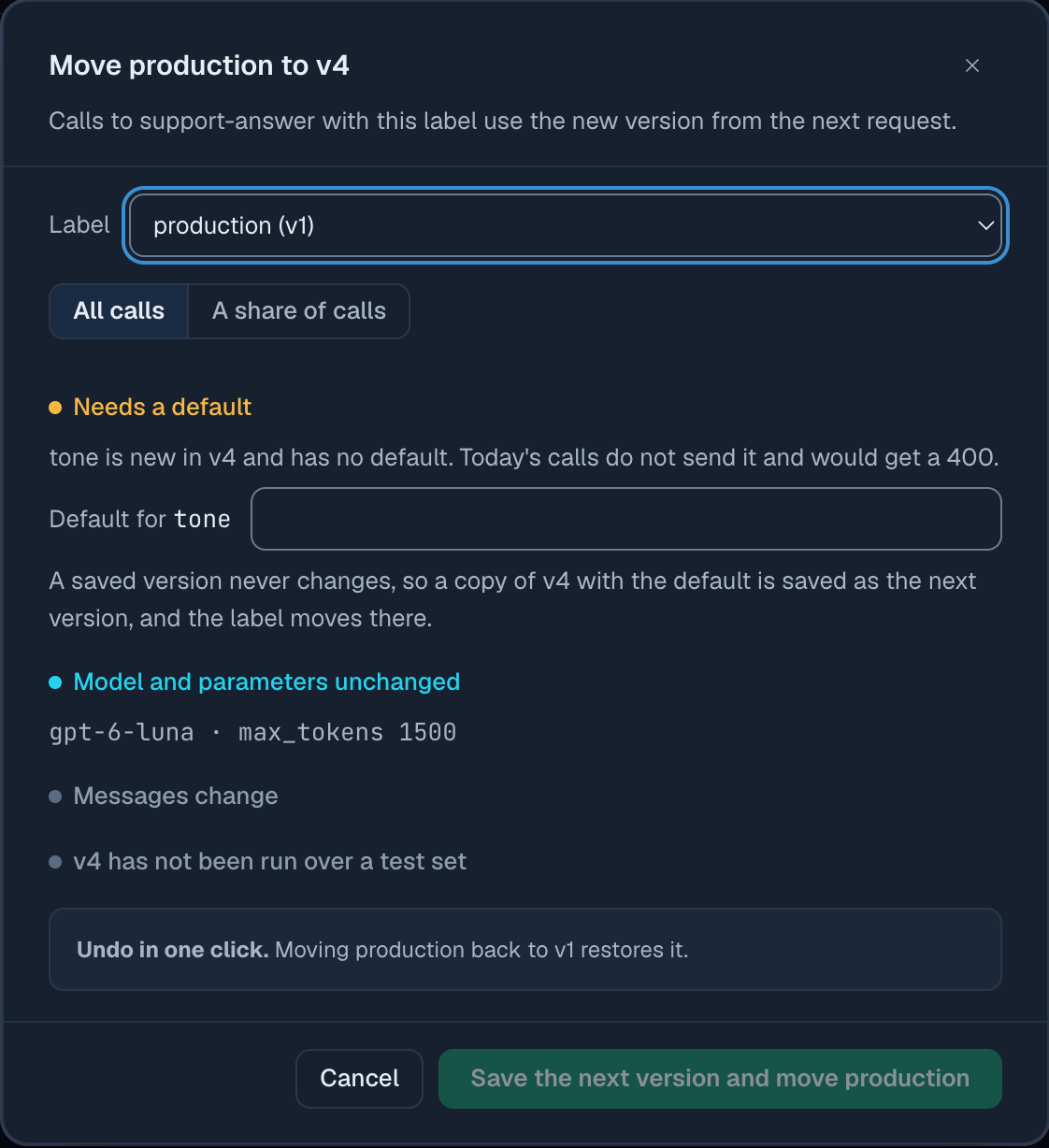
Nessuna delle cinque ha una registrazione di fatturazione. La prima riga mostra una modifica che interromperebbe le chiamate esistenti: v4 aggiunge una variabile senza valore predefinito, quindi ogni chiamata che non invia tone fallisce. La console rileva il problema prima della pubblicazione. Quando si sposta production su v4, si apre una finestra che verifica cosa cambia per chi chiama oggi e chiede un valore predefinito, salvandolo nella versione successiva.
Se la libreria è temporaneamente illeggibile, il gateway usa l’ultima copia letta, fino a 24 ore, e aggiunge X-Synthorai-Prompt-Stale: 1 alla risposta. Se non ha una copia recente del prompt, restituisce 503 prompt_unavailable; in quel caso va ritentata la chiamata. Nella demo non abbiamo osservato nessuno dei due casi.
Cosa può contenere una versione oltre al testo?
Una versione contiene il testo di sistema, i messaggi, il modello, cinque parametri, uno schema di output e i tool di tipo funzione. Per i parametri prevale la richiesta: i valori della versione per temperature, max_tokens, top_p, response_format e reasoning_effort si applicano solo se la richiesta non imposta lo stesso campo.
policy-check conserva lo schema JSON nella versione, quindi chi lo chiama riceve JSON conforme senza dover specificare un formato. Quando viene salvata tramite API, la versione indica il formato in params e contiene lo schema in schema:
version = {
    "model": "deepseek-v4.1-flash",
    "system": "You review messages to an online electronics shop's support desk. ...",
    "messages": [{"role": "user", "content": "{{customer_message}}"}],
    "params": {"max_tokens": 300, "response_format": "json_schema"},
    "schema": {"name": "policy_check", "strict": True, "schema": {
        "type": "object",
        "properties": {"topics": {"type": "array", "items": {"type": "string"}},
                       "risk": {"type": "string", "enum": ["low", "medium", "high"]}},
        "required": ["topics", "risk"], "additionalProperties": False}},
}
admin.post("/prompts/policy-check/versions", json={"body": version, "note": "v1: JSON check"}).raise_for_status()
Uno schema salvato senza response_format: "json_schema" viene rifiutato con un 400 che ne spiega il motivo. Una chiamata a policy-check su DeepSeek V4.1 Flash ha restituito {"topics": ["shipping", "refunds"], "risk": "medium"} con 151 token di input e 18 di output, al costo di $0.000033. La chiamata ha inviato reasoning_effort: "none" dal client, perché le versioni della demo erano state salvate prima che fosse possibile conservarlo nella versione. Ora una versione può memorizzarlo in params: abbiamo salvato e renderizzato una versione di prova con reasoning_effort: "none", e la richiesta conteneva reasoning_effort su Chat Completions e reasoning.effort su Responses. Su Messages, il valore della versione viene omesso perché i modelli Claude usano un formato diverso per le impostazioni di thinking; su quell’endpoint vanno inviate dal client.
Le chiamate ai tool e le conversazioni a più turni funzionano come senza un prompt di libreria. I messaggi della versione vengono prima, seguiti dalla conversazione inviata dal client. Al primo turno del ciclo di tool della demo, il modello ha richiesto lookup_order({"order_id": "A-50977"}); al secondo turno, la chiamata al tool generata dal modello e il risultato del tool sono stati inviati come normali messaggi, usando lo stesso id, e v1 ha risposto in base al risultato.
Dove si vede quale versione ha risposto a una chiamata?
Ogni chiamata viene registrata con il prompt e la versione, consultabili in tre modi:
- Nella risposta: l’header
X-Synthorai-Prompt-Version, che la demo riporta nei risultati accanto a ogni chiamata. - In Logs: il filtro
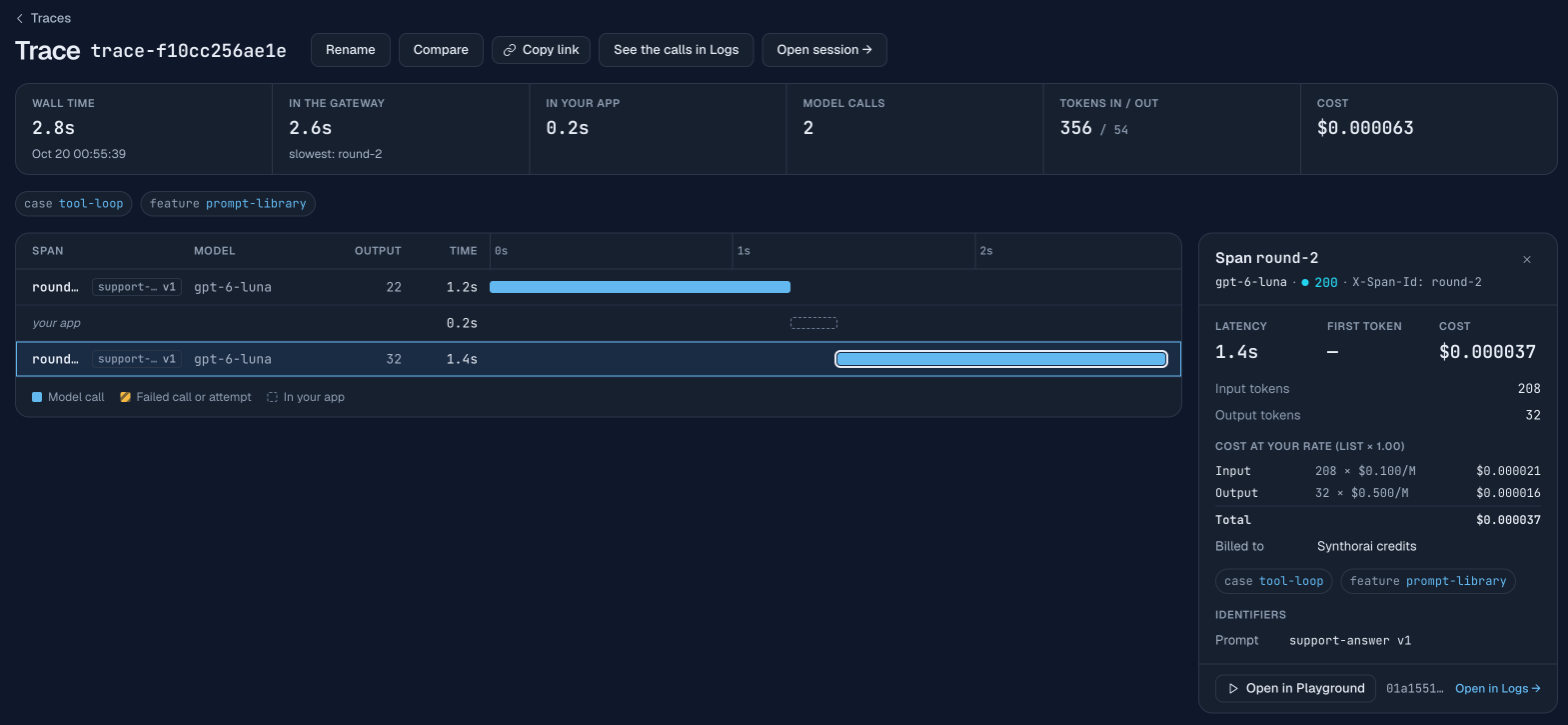
prompt = support-answerconprompt_version = 3elenca le chiamate di quella versione; il dettaglio di una richiesta indica prompt e versione.GET /api/v1/requestsaccetta gli stessi filtriprompt_ideprompt_version. - In una traccia: ogni riga di chiamata al modello nel waterfall ha un badge “prompt vN”, e il pannello della chiamata riporta prompt e versione. Gli header di tracing di Tracciare un agente LLM funzionano senza modifiche anche con le chiamate tramite id.
La pagina Prompts aggrega chiamate, errori, spesa, token e latenza per versione su 7, 30 o 90 giorni. È la vista usata dalla guida al rollout per confrontare due versioni sul traffico reale.
Cosa resta fuori?
- Rollout e test. L’invio di una quota del traffico di produzione a una versione candidata è descritto in Test A/B di una modifica al prompt; i test su un insieme fisso di input sono descritti in Testare un prompt prima di pubblicarlo.
- Partial. Un blocco di testo memorizzato una sola volta e incluso in più prompt con
{{>id}}; ogni versione salvata fissa la versione del partial che include. - Webhook di modifica. Un POST firmato quando viene aggiunta una versione a un prompt o spostata un’etichetta, per sincronizzare i prompt con git o un canale di chat. Il file
webhook.pydella demo verifica una firma, ma non abbiamo ricevuto alcuna consegna reale. - Idempotenza nella creazione. L’header
Idempotency-Keyrende sicuro ritentare una richiesta: per 24 ore, l’API risponde a una chiave ripetuta con la prima risposta, anziché creare due volte il prompt. Vale anche dopo l’eliminazione del prompt, quindi per ricreare un prompt eliminato occorre inviare una nuova chiave.
FAQ
Cos’è il versionamento dei prompt?
Consiste nel conservare ogni prompt in versioni numerate che non cambiano dopo il salvataggio e nello scegliere la versione da usare in produzione tramite un’etichetta, anziché modificando il codice. Per il rollback basta far puntare l’etichetta alla versione precedente.
Richiamare un prompt tramite id aggiunge latenza o token?
Nelle nostre 20 coppie non ha aggiunto né l’una né gli altri: la mediana era di 114.5 token di prompt in entrambi i casi, e la chiamata tramite id non era più lenta. Il gateway risolve la versione e invia al provider una normale richiesta.
Quanto rapidamente arriva in produzione una modifica al prompt?
Entro circa 10 secondi. Nei nostri test, con chiamate continue, la prima chiamata che ha usato la nuova versione è stata inviata 8.0-8.5 s (mediana) dopo lo spostamento dell’etichetta. Dopo 15 s senza traffico, la modifica è stata immediata.
Posso continuare a usare l’SDK OpenAI o Anthropic?
Entrambi funzionano senza modifiche: inviano i campi del prompt tramite extra_body, con un nome di modello qualsiasi e un messaggio utente vuoto per soddisfare gli argomenti obbligatori.
Altre letture
- Guida alla libreria di prompt: tutti i campi, gli errori e gli header di risposta di questa pagina.
- I prompt nella console: l’editor, il confronto tra versioni e la finestra di spostamento.
- Test A/B di una modifica al prompt: un rollout al 10% e il confronto per versione.
- Testare un prompt prima di pubblicarlo: set di test, controlli e cosa si può o non si può dedurre da una singola esecuzione.
- Tracciare un agente LLM: gli header di sessione e tracing che la demo continua a inviare.