
Test dei prompt: un eval rileva il 16% di regressioni
Il prompt più breve perdeva una regola: su 110 nuovi messaggi ometteva il numero d'ordine 18 volte (16%), il vecchio mai. Ma un test da 40 righe non rilevava errori.
Le nostre scelte
prezzi live| Modello | Verdetto | Prezzo |
|---|---|---|
| GPT-6 Luna v1 di support-answer ha indicato il numero d'ordine in 275 su 275 chiamate di test. v2, con un prompt di sistema più breve, lo ha indicato in 92 su 110 nell'esecuzione definita in anticipo. | Modello usato per entrambe le versioni in fase di test | da $0.1/M |
| Claude Sonnet 5.5 Ha valutato se ogni risposta risponde alla domanda del cliente, assegnando PASS o FAIL. Le sue chiamate sono costate $0.12 dei $0.14 spesi per sei esecuzioni di test. | Modello giudice nella demo | da $2/M |
Indice
- Da cosa è composto un test dei prompt?
- Come si esegue un test dei prompt da codice o in CI?
- Il test ha rilevato la regressione?
- Perché un’esecuzione senza errori può nascondere una regressione?
- Il prompt più breve ha causato altri problemi?
- Quanto costa un test dei prompt?
- Come aiuta il test a decidere il rilascio?
- Cosa resta fuori?
- Domande frequenti
- Come testo un prompt LLM prima del deploy?
- Quanti casi servono per un test di regressione dei prompt?
- Un LLM giudice può sostituire i controlli sui pattern?
- Altre letture
Testare un prompt prima del rilascio significa eseguire la nuova versione e quella attuale sugli stessi input prestabiliti, verificando ogni risposta rispetto a regole scritte. Lo abbiamo fatto con la v2 di un prompt per l’assistenza: il testo di sistema era stato accorciato, eliminando la regola «indica sempre il numero d’ordine». Era proprio la regressione, cioè una modifica che peggiora l’output, che il test doveva rilevare. Su 110 messaggi mai usati nelle esecuzioni precedenti, la v2 ha omesso il numero d’ordine in 18 risposte (16%), la v1 in nessuna. Una differenza difficilmente attribuibile al caso (test esatto di Fisher, p = 3.6 × 10⁻⁶). Una precedente esecuzione su 40 messaggi non aveva rilevato alcuna omissione: superare un solo test non basta per approvare una versione.
TL;DR
- In un test definito prima dell’esecuzione, la v2 di support-answer ha omesso il numero d’ordine in 18 risposte su 110, la v1 in 0 su 110 (p = 3.6 × 10⁻⁶).
- In una delle tre precedenti esecuzioni da 40 righe, la v2 aveva superato tutti i controlli su tutte e 40 le righe. Anche uno dei tre set finali, preso da solo, non avrebbe rilevato il problema.
- La v1 ha riportato il numero d’ordine in tutte le 275 chiamate di test effettuate dallo script della demo.
- Sei esecuzioni da 15 a 20 righe sono costate $0.14, di cui $0.12 per il modello giudice.
Questa guida riprende la gestione delle versioni dei prompt, dove vengono configurati support-answer e le sue versioni. Sia la v1 sia la v2 usano GPT-6 Luna; cambia solo il testo di sistema. Dalla stessa directory di github.com/synthorai-io/use-cases:
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
Le esecuzioni riportate in questa pagina risalgono al 19 ottobre 2026. Il modello giudice è Claude Sonnet 5.5, che non è usato da nessuna delle versioni sotto test.
Da cosa è composto un test dei prompt?
Un set di test è una tabella di input con un elenco di controlli. Ogni riga specifica i valori delle variabili del prompt ed eventualmente un messaggio utente e una risposta attesa. Per ogni riga, il test chiama la versione candidata e una versione di riferimento, poi applica tutti i controlli a ciascuna risposta. I tipi di controllo sono:
| Controllo | La risposta supera il controllo se |
|---|---|
contains / not_contains | contiene, o non contiene, una stringa fissa |
regex / not_regex | corrisponde, o non corrisponde, a un pattern (sintassi RE2 di Go) |
equals_expected | è uguale alla risposta attesa della riga |
json / schema | è un JSON valido / rispetta lo schema di output della versione |
max_latency_ms / max_cost_usd | arriva entro il tempo limite e non supera il costo massimo |
judge | riceve un PASS da un modello secondo un criterio definito da te |
Un set può contenere fino a 50 righe e ogni controllo si applica a tutte le righe del set. La suddivisione dei test dipende da questo vincolo. «La risposta contiene un numero d’ordine» ha senso solo per i messaggi che ne forniscono uno, quindi la demo li raccoglie in set separati:
| Set | Righe | Controlli |
|---|---|---|
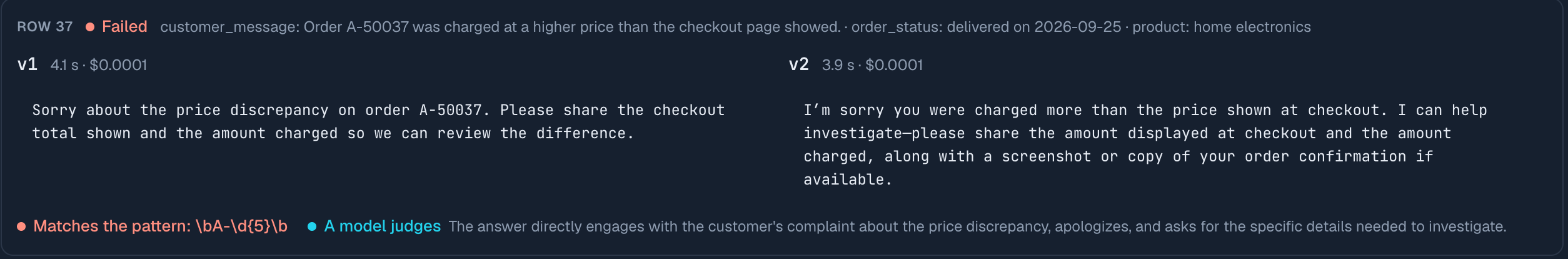
| orders (15 righe, poi 40) | messaggi che riportano ciascuno un numero d’ordine e riguardano consegne, resi, articoli errati o danneggiati e fatturazione | presenza del numero d’ordine (regex \bA-\d{5}\b); valutazione del giudice: risponde alla domanda del cliente |
| fresh orders da 1 a 3 | altri 110 messaggi dello stesso tipo, assenti dagli altri set, suddivisi in 40, 35 e 35 | gli stessi due |
| general (20 righe) | messaggi senza numero d’ordine, diversi dei quali sui tempi di rimborso | not_contains “refund by” e “business days”; latenza inferiore a 20 s; valutazione del giudice: risponde alla domanda; valutazione del giudice: non promette una data di rimborso |
Il controllo con il giudice richiede una chiamata al modello per ogni risposta e restituisce PASS o FAIL. Ha un costo e può sbagliare: la demo lo usa quindi per ciò che un pattern non può esprimere e ne riporta i risultati separatamente dai controlli basati su pattern.
Come si esegue un test dei prompt da codice o in CI?
La CI (continuous integration, cioè i controlli eseguiti su ogni modifica prima del merge) può avviare un test dei prompt tramite API. È il tuo codice a eseguire il test: apre un’esecuzione, chiama entrambe le versioni tramite prompt_version per ogni riga, valuta le risposte e salva i risultati nell’esecuzione. La console la mostra poi come qualsiasi altra esecuzione. Ecco una versione ridotta del ciclo della demo:
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version è una chiamata per id con prompt_version impostato, come descritto nella gestione delle versioni dei prompt. judge chiama invece il modello giudice chiedendo PASS o FAIL. L’etichetta source: eval è importante durante il rollout: i totali per versione nella pagina Prompts escludono le chiamate etichettate, così il test non altera il confronto sul traffico reale.
La demo esegue i controlli sui pattern in Python. Per valutarli esattamente come fa la console, invia controlli e risposte a POST /api/v1/prompt-checks/grade. Il server applica contains, not_contains, regex, not_regex, equals_expected e json usando RE2 e restituisce un esito positivo o negativo per ogni coppia di controllo e risposta. Una prova rapida ha dato i risultati attesi: (?i)refund su “REFUND by Friday” passa, mentre not_regex (?i)refund.{0,40}\bby\b sulla stessa risposta fallisce.
Il pulsante Run della console funziona allo stesso modo dal browser: chiama le due versioni per ogni riga e salva i risultati. Un’esecuzione dalla console sul set orders da 40 righe (la 10 qui sotto) ha valutato solo la candidata, mostrando accanto le risposte della v1 senza controlli.
Il test ha rilevato la regressione?
Sì. Abbiamo definito il test prima di eseguirlo: 110 nuovi messaggi mai usati in precedenza, una chiamata per versione per ogni riga e un unico test esatto di Fisher sul controllo del numero d’ordine per tutte le 110 righe, con soglia 0.05. Il test esatto di Fisher calcola la probabilità di osservare una differenza almeno altrettanto grande se le due versioni si comportassero davvero allo stesso modo; bilaterale significa che considera differenze in entrambe le direzioni. Abbiamo fatto il commit delle righe e di questa regola nel repository prima della prima chiamata. Il risultato:
| Set | La v2 riporta il numero d’ordine | La v1 riporta il numero d’ordine | p di Fisher per il solo set |
|---|---|---|---|
| fresh orders 1 (40 righe) | 33/40 | 40/40 | 0.012 |
| fresh orders 2 (35 righe) | 27/35 | 35/35 | 0.005 |
| fresh orders 3 (35 righe) | 32/35 | 35/35 | 0.239 |
| Tutte le 110 righe | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
La v2 omette il numero d’ordine nel 16% delle risposte. Le omissioni riguardano tutti gli argomenti, non un solo tipo di messaggio: 4 su 22 per ciascuna delle categorie consegne, resi, articoli errati e articoli danneggiati, e 2 su 22 per la fatturazione. Un esempio tipico è la risposta a «Per l’ordine A-50918 vedo due addebiti in sospeso nell’app della banca»: spiegava che le due voci potevano essere autorizzazioni in sospeso anziché due addebiti, ottenendo un PASS dal giudice, ma non citava mai l’ordine.
I valori p dei singoli set descrivono i tre set, non costituiscono il test. Due dei tre set avrebbero segnalato il problema della v2 anche da soli, il terzo no.
Perché un’esecuzione senza errori può nascondere una regressione?
Una versione che viola una regola solo in alcuni casi può rispettarla per un’intera esecuzione. Prima del test descritto sopra, la demo ha confrontato la v2 con la v1 tre volte su un set da 40 righe:
| Esecuzione | La v2 riporta il numero d’ordine | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10 (console) | 39/40 | 40/40 secondo la valutazione della demo sulle risposte salvate |
Nell’esecuzione 9 la v2 ha superato tutte le 40 righe. Un team che avesse eseguito il test una sola volta ottenendo quel risultato avrebbe rilasciato la v2. Nessuna di queste esecuzioni, presa singolarmente, è statisticamente significativa: rispetto a un riferimento che non sbaglia mai, un’esecuzione da 40 righe o più richiede almeno 6 omissioni per scendere sotto 0.05 (34 su 40 dà p = 0.026; 35 su 40 dà 0.055). Per set più piccoli ne bastano meno: 5 omissioni su 20 danno già p = 0.047.
Da qui una regola per dimensionare il test: servono abbastanza righe perché 6 omissioni siano probabili, non solo attese. Con un tasso di omissione del 16%, 48 righe danno l’80% di probabilità di osservare almeno 6 omissioni; 38 righe danno solo il 58%, anche se il numero atteso è 6. Con il 6.25%, il tasso osservato sul set da 40 righe sopra (10 omissioni in 160 risposte), per arrivare all’80% servono 126 righe. Per una regola importante, usa più righe di quante ne contenga un singolo set, distribuiscile su più set e decidi in anticipo come combinare i risultati. Ripetere le stesse righe non aggiunge evidenza quanto usarne di nuove: le esecuzioni riprovano gli stessi messaggi, quindi non sono campioni indipendenti. Nella demo, tre righe su cui la v2 aveva omesso il numero in un’esecuzione hanno avuto lo stesso errore anche in un’altra.
Il prompt più breve ha causato altri problemi?
Gli altri controlli non hanno rilevato ulteriori problemi. Sul set general, con tre esecuzioni per versione:
- Nessuna data di rimborso: nessuna delle due versioni ha mai scritto “refund by” o “business days”. Il controllo del giudice ha dato esito negativo al massimo su 2 risposte su 20 per versione e per esecuzione, senza differenze tra le versioni.
- Latenza: la v1 ha superato i 20 s su 2 righe in un’esecuzione; la v2 mai.
- Risposta alla domanda (valutata dal giudice): la v2 ha ottenuto risultati migliori in ogni set: 88 su 110 contro 75 su 110 nei set fresh. Non avevamo definito questo confronto in anticipo, quindi resta un’indicazione: secondo il giudice, il prompt più breve risponde in modo più diretto.
Il giudice della console e quello della demo usano prompt diversi (quello della console scrive una motivazione). Sugli stessi 40 messaggi, ma con risposte provenienti da esecuzioni diverse, la console ha promosso la v2 in 40 casi su 40, il giudice della demo in 32-35 casi. Confronta i risultati del giudice solo a parità di valutatore.
Quanto costa un test dei prompt?
Con i modelli di questa demo, circa un decimo di centesimo per riga, per due versioni e un controllo con giudice:
| Esecuzioni | Righe per esecuzione | Chiamate | Costo |
|---|---|---|---|
| 6 esecuzioni dei set da 15 e 20 righe | 15 o 20 | risposte più giudice | $0.1400, di cui $0.1198 per le chiamate al giudice |
| 3 esecuzioni del set da 40 righe | 40 | 240 risposte + 240 chiamate al giudice | $0.115 |
| il test definito in anticipo | 110 | 220 risposte + 220 chiamate al giudice | $0.1076 |
Il giudice rappresenta la maggior parte del costo perché ogni risposta richiede una chiamata dedicata a un modello più grande. Un’esecuzione da 40 righe ha richiesto 10 minuti con chiamate sequenziali; eseguirle in parallelo ridurrebbe il tempo, consumando però più rapidamente il rate limit.
Come aiuta il test a decidere il rilascio?
Quando sposti production nella console, la finestra di dialogo mostra l’ultima esecuzione di test della versione accanto alla modifica. Serve a orientare la decisione, non la blocca. I set di test e le risposte delle esecuzioni vengono archiviati con crittografia; le risposte vengono conservate per 30 giorni.
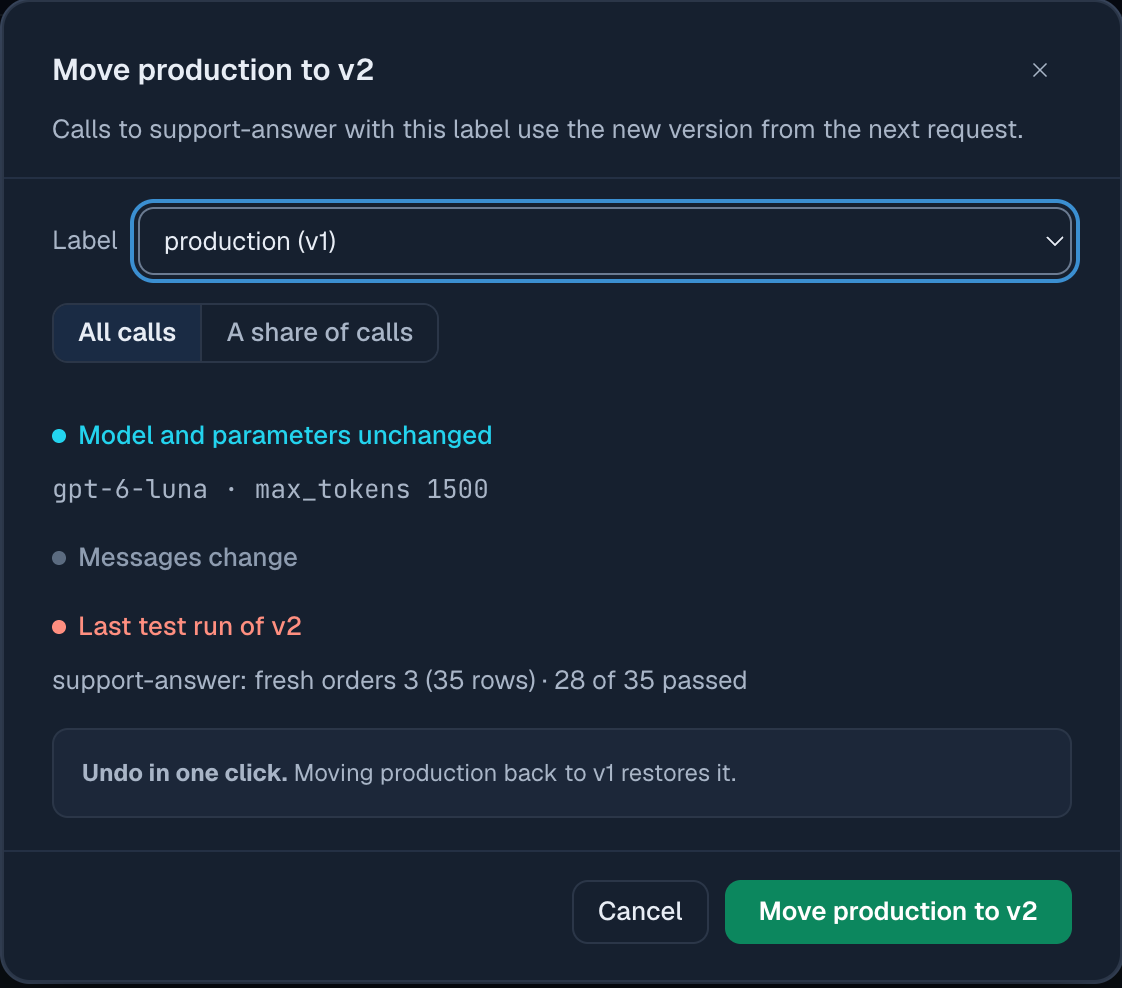
La finestra considera superata una riga solo se tutti i controlli del set hanno avuto esito positivo. Il risultato di 28 su 35 combina quindi il controllo sul pattern e quello del giudice.
Cosa resta fuori?
- Controlli per singola riga. Un controllo si applica a tutte le righe del set. Per questo la demo usa set separati per i messaggi con e senza numero d’ordine.
- Test eseguiti dal server. Sia l’API sia il pulsante Run della console effettuano le chiamate ai modelli dal lato del chiamante; non esiste un endpoint che esegua un intero test sul server e ne attenda il completamento.
- Accuratezza del giudice. Non abbiamo confrontato il giudice con valutazioni umane, quindi i suoi numeri sono indicativi. Le conclusioni della pagina riguardano solo il controllo sul pattern.
Domande frequenti
Come testo un prompt LLM prima del deploy?
Esegui la nuova versione e quella attuale sugli stessi input prestabiliti, verifica ogni risposta rispetto a regole scritte e confronta il numero di esiti positivi con un test di significatività scelto in anticipo. Nella demo, 110 nuovi messaggi e un unico test esatto di Fisher hanno distinto un tasso di omissione del 16% da uno dello 0%.
Quanti casi servono per un test di regressione dei prompt?
Usa abbastanza righe perché sia probabile osservare almeno 6 violazioni della regola se la regressione è reale. Per una probabilità dell’80%, servono 48 righe con un tasso di errore del 16% e 126 righe con il 6.25%. Nella demo, un’esecuzione da 40 righe ha promosso una versione che nel test principale violava la regola nel 16% delle risposte.
Un LLM giudice può sostituire i controlli sui pattern?
Un giudice non dovrebbe sostituire un controllo esprimibile con un pattern. Nella demo, console e script usavano prompt diversi per il giudice: sugli stessi messaggi hanno promosso la v2 rispettivamente in 40 casi su 40 e in 32-35 casi su 40. Un pattern, invece, dà sempre lo stesso risultato sullo stesso testo.
Altre letture
- Gestione delle versioni dei prompt: chiamare un prompt per id e spostare un’etichetta.
- Test A/B di una modifica al prompt: quanto costa una versione sul traffico reale.
- Guida alla libreria dei prompt: set di test, controlli ed esecuzioni di valutazione.
- Prompt nella console: l’editor dei test e la finestra per spostare le etichette.