
Cache dei prompt: cinque controlli prima di accusare il routing
Indice
- Cosa controllare per prima cosa quando spariscono gli hit della cache?
- Quali impostazioni applicative e quali tempi vanno controllati?
- Cosa può cambiare un gateway tra client e provider?
- Come si analizza una regressione della cache in Synthorai?
- Una sessione misurata: individuare la regressione e poi esaminarne gli span
- Come aiuta la diagnostica nativa a individuare una richiesta modificata?
- Quando conviene indagare sul servizio di inferenza?
- Come si dimostra che una correzione ha funzionato?
- FAQ
- Aggiungere cache_control garantisce un hit?
- Il routing può causare un miss della cache anche se il nome del modello non cambia?
- Perché la diagnostica segnala una richiesta modificata se alcuni token erano in cache?
Per diagnosticare i mancati hit della cache dei prompt, parti dai dati di utilizzo. Poi confronta prefisso riutilizzabile, requisiti di ammissibilità, tempi e destinazione upstream effettiva con una richiesta di riferimento per cui la cache era sicuramente già disponibile.
TL;DR
- Se mancano i dati di utilizzo della cache, il risultato è sconosciuto. Un conteggio di letture pari a zero non ne identifica la causa.
- Il tasso di hit per richiesta conta le richieste che riutilizzano almeno una parte della cache; il rapporto di riutilizzo dei token misura quanta parte dell’input è stata riutilizzata.
- Gli stati della diagnostica nativa richiedono azioni diverse: correggere una divergenza, sostituire un riferimento mancante o approfondire un confronto inconcludente.
- DeepSeek richiede la corrispondenza con unità di prefisso persistite. Un prefisso testuale comune, da solo, potrebbe non bastare.
Cosa controllare per prima cosa quando spariscono gli hit della cache?
Verifica innanzitutto che la risposta grezza contenga davvero i dati di utilizzo della cache. Se il provider segnala letture ma il client o la dashboard non le mostrano, parti dalla rendicontazione. Altrimenti, conserva l’ultima richiesta con cache sicuramente disponibile e confrontala con quella che non ottiene hit.
| Primo controllo | Dati da raccogliere | Minima azione utile |
|---|---|---|
| Il miss è reale? | Utilizzo grezzo del provider, risposta al client e record nella dashboard | Controllare campi mancanti e aggregazione dello streaming prima di modificare i prompt |
| Il prefisso è cambiato? | Tool nell’ordine effettivo, testo di sistema e messaggi precedenti | Confrontare i componenti; spostare timestamp variabili o ID di richiesta dopo il contenuto riutilizzabile |
| Il prefisso era ammissibile ed è stato scritto in cache? | Soglia minima del modello, controlli e utilizzo in lettura/scrittura | Verificare modello e API esatti; esaminare il breakpoint previsto |
| La richiesta è arrivata troppo presto o troppo tardi? | Ora di inizio della risposta, intervallo tra richieste e durata della cache | Eseguire una richiesta successiva in sequenza prima di provare il traffico parallelo |
| La destinazione è cambiata? | Modello effettivo, servizio, ambito dell’account e tentativi di fallback | Chiedere al gestore del gateway di confrontare i tentativi upstream effettivi |
Usa due metriche, chiamandole esplicitamente per nome, sulle richieste con dati completi di utilizzo dell’input e della cache:
- Tasso di hit per richiesta = richieste con più di zero token letti dalla cache / richieste con dati di utilizzo completi.
- Rapporto di riutilizzo dei token = somma dei token letti dalla cache / somma di tutti i token di input, inclusi input in cache e scritture in cache.
Riporta separatamente le richieste prive di dati di utilizzo e includi i tentativi falliti nel costo dell’incidente. La crescita dell’input può ridurre il riutilizzo dei token senza modificare il tasso di hit per richiesta.
| API nativa | Campo delle letture dalla cache | Input totale usato al denominatore del rapporto tra token |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens, che include già l’input in cache |
| Anthropic Messages | usage.cache_read_input_tokens | input_tokens + cache_read_input_tokens + cache_creation_input_tokens all’interno di usage |
| DeepSeek | usage.prompt_cache_hit_tokens | prompt_cache_hit_tokens + prompt_cache_miss_tokens all’interno di usage |
Se i campi nativi sono stati convertiti, usa lo schema normalizzato del gateway. La formula per Synthorai è riportata più avanti.
Quali impostazioni applicative e quali tempi vanno controllati?
Verifica se è cambiato del contenuto prima del prefisso che dovrebbe essere riutilizzabile. Timestamp di sistema, ordine dei tool e cronologia riscritta sono buoni punti di partenza.
Modifiche al prefisso. Acquisisci impronte separate (hash usati per rilevare modifiche) per le definizioni dei tool nel loro ordine, il testo di sistema stabile e i blocchi dei messaggi precedenti. Lascia in fondo il marcatore specifico della richiesta. L’hash dell’intera richiesta cambia anche quando la conversazione cresce normalmente con la sola aggiunta di messaggi e non permette di localizzare la prima differenza. Anche gli spazi nel JSON esterni al testo sono diversi dagli spazi all’interno di una stringa visibile al modello.
Esamina la posizione dei contenuti recuperati, i cambi di modalità, la compattazione e la richiesta finale prodotta dal framework. Per gli input multimodali, confronta pre-elaborazione e riferimenti ai file.
Requisiti e controlli. Un breakpoint indica la fine del prefisso per cui si richiede la memorizzazione in cache. Il time to live (TTL) è la durata configurata della voce in cache.
Una richiesta lunga nel complesso non garantisce che il prefisso riutilizzabile selezionato raggiunga la soglia minima del modello. Con i breakpoint espliciti, controlla il contenuto che precede il breakpoint. Aggiungere cache_control non rende riutilizzabile un prefisso che non soddisfa gli altri requisiti. Su Anthropic, verifica i controlli automatici rispetto a quelli a livello di blocco, i conflitti di TTL e i limiti sui breakpoint. Una combinazione non valida può produrre un HTTP 400, cioè una richiesta rifiutata, anziché una risposta riuscita con zero letture dalla cache. Caching dei prompt su Anthropic.
Disponibilità e scadenza. Inviare una raffica di richieste identiche prima che la prima scrittura sia disponibile può generare più richieste a cache fredda. La documentazione Anthropic indica che la cache diventa disponibile dopo l’inizio della prima risposta. Invia una richiesta successiva dopo l’inizio della prima risposta per ottenere un riferimento con cache disponibile. Confronta poi le richieste parallele usando i rispettivi timestamp di inizio risposta. Per una conversazione rimasta inattiva, confronta l’intervallo con la durata configurata della cache e con l’eventuale comportamento di rinnovo documentato. Disponibilità della cache Anthropic.
Unità persistite di DeepSeek. DeepSeek cerca corrispondenze con intere unità di prefisso persistite, cioè porzioni salvate del contesto precedente. L’esempio documentato parte da A+B, seguito da A+C: la seconda richiesta non può riutilizzare l’intera unità A+B. Dopo che il servizio ha rilevato e persistito il prefisso comune A, una terza richiesta A+D può riutilizzare quell’unità. Qui A è il contesto stabile, mentre B, C e D sono suffissi diversi. È un meccanismo documentato dal fornitore, non una nostra misurazione.
Per questo schema, mantieni A identico, completa le prime due richieste in sequenza, considera che la persistenza può richiedere secondi e poi esamina i campi dei token hit/miss della terza richiesta. Aspettare, da solo, non garantisce che l’unità con il prefisso comune desiderato sia stata creata; la memorizzazione in cache resta best-effort. Regole di persistenza di DeepSeek.
Cosa può cambiare un gateway tra client e provider?
Un gateway può modificare sia la richiesta effettiva sia i dati restituiti al client. Controlla i due aspetti separatamente prima di attribuire una regressione al routing.
Verifica alias dei modelli, ambito delle credenziali, override delle policy e tentativi di fallback. Per la conversione di protocollo, esamina i controlli inviati a monte e i campi nativi restituiti; per lo streaming, confronta gli eventi di utilizzo upstream con i dati di utilizzo finali del client.
Variazioni di routing tra fornitori. Il bilanciamento o il failover possono spostare lo stesso modello pubblico tra fornitori di inferenza con cache separate. Un prefisso già in cache presso il fornitore A non è quindi disponibile presso il fornitore B. Il nostro studio sulle variazioni di provider ha rilevato nine upstream e 4/20 richieste con hit, contro 19/20 nel confronto con un solo backend. Questi risultati descrivono quella configurazione storica.
Raggruppa i tentativi per fornitore, modello e ambito dell’account. All’interno di ciascun gruppo, confronta le letture dalla cache mantenendo stabili prefissi e intervalli e includendo errori e destinazioni di fallback. Chiedi al gestore di verificare l’affinità, cioè l’instradamento coerente delle richieste correlate, e il failover. Ripeti il confronto dopo una modifica approvata. I cambi di fornitore dimostrano una variazione di routing; i singoli miss richiedono comunque controlli sui tempi e sui requisiti di ammissibilità.
Le richieste Synthorai non hanno un selettore di provider/canale.
Come si analizza una regressione della cache in Synthorai?
Usa Analytics per l’andamento del carico e Logs per le singole richieste. Le etichette sono state verificate dal vivo il 6 novembre 2026.
- Restringi il carico da analizzare. In Analytics, seleziona
Time rangeeAll keys · all models. In Logs, usaAdd filterconmodelokey. Mantieni le stesse selezioni negli intervalli normali e in quelli interessati dal problema.CACHE HITè un rapporto di riutilizzo dei token, non un tasso di hit per richiesta. - Esamina la richiesta. In
Overview, confronta Input, Cache read, Output e le eventuali scritture inCost at your rate. Letture stabili con input in crescita suggeriscono un aumento del contesto; letture in calo e scritture in aumento suggeriscono di controllare prefisso e tempi.Rawcontiene i campi memorizzati, non la risposta originale del provider. - Segui la traccia e la sessione. Dalla richiesta interessata in Logs, seleziona
Open trace, poiOpen session. InTraces in this session, confronta i task e apri la traccia senza riutilizzo. Fai clic su ogni span (singola operazione) per esaminare letture e scritture in cache e relativi addebiti; il solo waterfall non mostra il riutilizzo della cache. Usa i filtrisessionotracedi Logs per accedere ai record sottostanti. Conserva link, timestamp e ID nativi delle risposte per l’escalation.
Invia X-Session-Id per ogni conversazione, X-Trace-Id per ogni task e X-Span-Id per ogni operazione. Prima di interpretare gli andamenti della cache, raggruppa per modello e per prefisso che dovrebbe essere condiviso.
Correlazione e routing sono aspetti distinti: X-Session-Id ha anche la precedenza sulla chiave di cache nel body per l’affinità del gateway; X-Trace-Id serve solo a raggruppare le osservazioni. Mantieni stabile l’identità della sessione durante i confronti. Nessuno dei due garantisce una cache condivisa o una destinazione fissa; non raggruppare conversazioni scollegate per cercare di ottenere hit.
Per i record Synthorai memorizzati con dati completi, calcola il riutilizzo dei token così:
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)
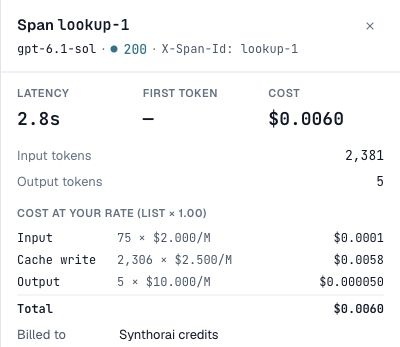
Qui cached_tokens è già incluso in prompt_tokens: aggiungerlo di nuovo conterebbe l’input due volte. Le scritture in cache vanno al denominatore, non al numeratore. Escludi i record privi di dati di utilizzo e riportane il numero separatamente; uno zero memorizzato, da solo, non dimostra che l’upstream abbia fornito uno zero misurato.
Una sessione misurata: individuare la regressione e poi esaminarne gli span
Dopo la nostra analisi dei costi degli agenti, il 6 novembre 2026 abbiamo inviato sei richieste Responses in sequenza tramite Synthorai usando GPT-6.1 Sol. Una sessione conteneva tre tracce, ciascuna con due chiamate etichettate lookup-1 e lookup-2. Queste etichette identificano chiamate sintetiche al modello: non è stato eseguito alcun tool di ricerca. Modello, tool e ID di sessione sono rimasti invariati. Per introdurre la regressione abbiamo anteposto a ogni richiesta un nuovo valore simile a un timestamp; la correzione ha ripristinato il prefisso originale. I marcatori delle richieste sono rimasti in fondo.
| Traccia | Token di input | Letture dalla cache | Riutilizzo | Costo riportato |
|---|---|---|---|---|
| riferimento | 4,729 | 2,273 | 48.1% | $0.0063923 |
| regressione | 4,764 | 0 | 0% | $0.0119350 |
| correzione | 4,732 | 4,546 | 96.1% | $0.0009446 |
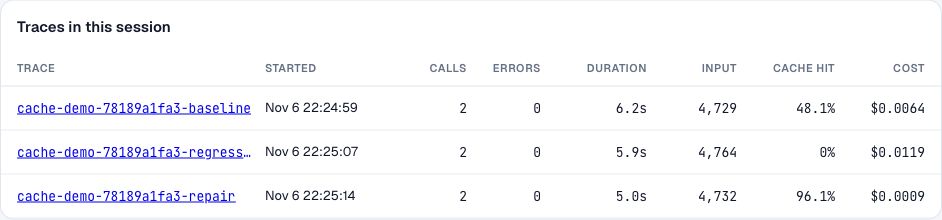
In Traces in this session, apri la riga della regressione senza riutilizzo. Il riferimento include una prima chiamata a cache fredda; la correzione riutilizza un prefisso già disponibile in cache. Questa dimostrazione di sei chiamate mostra il guasto introdotto e il ripristino, non un tasso di risparmio atteso in produzione. Il riutilizzo sull’intera sessione è 6,819 / 14,225 = 47.9%; questa media nasconde la regressione.
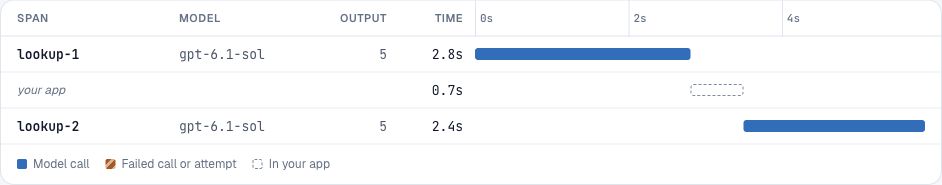
Seleziona lookup-1 nel waterfall. Il dettaglio mostra 2,306 token scritti in cache su 2,381 token di input, un dato coerente con la ricostruzione del prefisso modificato. Le richieste sintetiche memorizzate documentano la differenza introdotta; la sola timeline non permette di identificarla. Usa Open in Logs per accedere al record della richiesta e confronta le impronte dei prefissi rilevate dall’applicazione.
Questa dimostrazione non ha richiesto confronti diagnostici nativi. La modifica introdotta nel prefisso e i dati di utilizzo riportati documentano la regressione e il ripristino osservati; la continuità del fornitore effettivo non è stata verificata in modo indipendente. L’identità della sessione è rimasta fissa, quindi l’esperimento non misura un beneficio dell’affinità.
Per BYOK, distingui il costo riportato dal provider da quello stimato prima della riconciliazione con la fattura. Per i dettagli non disponibili su destinazioni e fallback, richiedi riscontri al gestore.
Come aiuta la diagnostica nativa a individuare una richiesta modificata?
La diagnostica nativa individua le differenze tra richieste; i dati di utilizzo misurano il riutilizzo riportato. Leggili insieme. Il percorso scelto nel gateway deve supportare e preservare i campi nativi. Un nostro precedente test di confronto su Synthorai non ha restituito dati diagnostici: la sola documentazione del fornitore non ne dimostra quindi la disponibilità attraverso il gateway.
OpenAI Responses accetta prompt_cache_options.comparison_response_id sui modelli supportati. Conserva l’ID della risposta di riferimento completata e invia il contenuto effettivo della richiesta successiva; il riferimento di confronto non carica la cronologia della conversazione. I risultati compaiono in prompt_cache_diagnostics, anche nell’evento response.completed durante lo streaming. Usa gli stati qui sotto per scegliere l’azione successiva. Le stime dei token nella diagnostica sono separate dall’utilizzo fatturato. Diagnostica della cache OpenAI.
Anthropic Messages usa diagnostics: {"previous_message_id": null} per l’attivazione iniziale, seguito dall’ID nativo del messaggio precedente nelle richieste successive con diagnostica attiva. Nello streaming, il risultato è esposto in message_start. Interpreta un risultato null solo dopo aver verificato che entrambe le richieste abbiano attivato la diagnostica e che la successiva abbia fornito un riferimento reale. Anthropic documenta la diagnostica per la Claude API, escludendo Amazon Bedrock e Claude gestito da Google. Diagnostica della cache Anthropic.
| API e stato restituito | Significato | Azione successiva |
|---|---|---|
OpenAI cache_hit | Il confronto non ha rilevato miss | Leggere i dati di utilizzo per quantificare il riutilizzo; i nuovi token del suffisso possono comunque richiedere elaborazione |
OpenAI cache_miss | Una differenza classificata ha influito sul riutilizzo atteso | Esaminare reason, correggere il componente interessato e ripetere il confronto |
OpenAI comparison_response_not_found | Record di riferimento mancante o scaduto | Scegliere una risposta recente e completata nella stessa organizzazione |
OpenAI unavailable | Confronto non supportato o inconcludente | Verificare il supporto del modello; provare un riferimento recente, poi passare ai controlli manuali se il problema persiste |
Anthropic diagnostics: null | Nessuna divergenza solo se è stato eseguito un confronto valido con diagnostica attiva; viene restituito anche senza attivazione o al primo turno | Verificare prima attivazione e riferimento; con una corrispondenza valida e poche letture, controllare la disponibilità della cache |
Anthropic cache_miss_reason: null all’interno di un oggetto diagnostico | Confronto in attesa | Controllare il turno successivo con diagnostica attiva; non classificare il risultato in attesa come miss |
Anthropic, motivo di tipo *_changed | Primo componente divergente identificato | Correggere quel componente e ripetere il confronto; potrebbero restare differenze successive |
Anthropic previous_message_not_found | Nessuna impronta di riferimento conservata | Verificare l’attivazione nella richiesta precedente, organizzazione/workspace e tempo trascorso; creare un nuovo riferimento |
Anthropic unavailable | Nessun confronto conclusivo, anche per alcune modifiche ad altri parametri o per limiti del confronto | Confrontare tool_choice effettivo, impostazioni di thinking/output e header beta; passare ai controlli manuali se il problema persiste |
| Campo diagnostico assente in una delle due API | Dati mancanti | Verificare supporto di API/modello, opzioni della richiesta, conversione e acquisizione degli eventi di streaming |
Il motivo prompt_cache_key_changed di OpenAI richiede attenzione: i dati di utilizzo possono segnalare un miss senza che si sia verificato un miss fisico della cache. Prima di attribuire il risultato alla disponibilità della cache, verifica se la chiave è stata modificata intenzionalmente per separare la contabilizzazione. Mantieni la chiave stabile all’interno del gruppo di contabilizzazione previsto, controllando anche il suo ruolo nell’affinità del gateway. Motivi diagnostici di OpenAI.
Quando conviene indagare sul servizio di inferenza?
Indaga sulla disponibilità della cache dopo aver confermato che il contenuto soddisfa i requisiti, i tempi sono validi, gli ambiti di destinazione sono confrontabili e i dati di utilizzo sono affidabili. Anche allora, un input invariato non garantisce la presenza di una voce riutilizzabile.
Le possibili spiegazioni includono scadenza, persistenza incompleta, pressione sulla capacità e scheduling lato servizio. OpenAI documenta vincoli di routing e disponibilità della cache; un’etichetta di sessione non garantisce l’accesso a uno specifico worker. Anche un hit parziale può indicare che un prefisso iniziale è ancora riutilizzabile, mentre il contenuto successivo deve essere elaborato. Caching dei prompt su OpenAI.
Un primo token lento o zero letture non dimostrano un cambio di cluster. In fase di escalation, fornisci ID nativi delle risposte, timestamp, intervalli ed etichette delle destinazioni; senza riscontri del provider, lascia irrisolto il meccanismo sottostante.
Le risorse di cache esplicite richiedono un controllo diverso: verifica esistenza, scadenza e ambito dell’oggetto referenziato. Non diagnosticare un ID obsoleto di una risorsa esplicita usando le stesse ipotesi della memorizzazione automatica dei prefissi.
Come si dimostra che una correzione ha funzionato?
Confronta il traffico normale, quello interessato dal problema e quello dopo la correzione usando dati di utilizzo, diagnostica e destinazioni.
Includi i retry nel costo. Una correzione della rendicontazione deve riconciliare l’utilizzo nativo con quello del client. Una correzione del prefisso deve eliminare la differenza e ripristinare un riutilizzo confrontabile. Una correzione del routing deve confermare la destinazione prevista e il ripristino all’interno di quell’ambito. Se la condizione pertinente non è soddisfatta, mantieni la classificazione come irrisolta e prosegui con i riscontri rimanenti.
FAQ
Aggiungere cache_control garantisce un hit?
I controlli della cache restano soggetti a lunghezza del prefisso, posizionamento, disponibilità e durata. Verifica i requisiti del modello e i dati grezzi di utilizzo.
Il routing può causare un miss della cache anche se il nome del modello non cambia?
Un nome di modello stabile lato client può risolversi in fornitori, modelli o ambiti di account diversi. Confronta i tentativi effettivi con il gestore del gateway, usando il runbook sulle variazioni di provider.
Perché la diagnostica segnala una richiesta modificata se alcuni token erano in cache?
Una modifica verso la fine della richiesta può lasciare riutilizzabile un prefisso precedente. Leggi il componente modificato insieme al numero assoluto di token letti dalla cache. Il confronto diagnostico e la contabilizzazione della cache descrivono aspetti diversi della richiesta.
Per analisi correlate, consulta l’audit della cache del gateway, i costi delle scritture in cache e i tempi della compattazione.