
Compressione del contesto: dopo quanti turni conviene
Indice
- Quale problema vuoi risolvere comprimendo il contesto?
- Scenario 1: cosa fare quando il contesto sta per esaurirsi?
- Scenario 2: conviene comprimere prima di una fascia di prezzo più alta?
- Scenario 3: quanti turni successivi ripagano una compressione?
- Comprimere spreca il sovrapprezzo pagato per scrivere in cache?
- Quanto si avvicina la formula ai risultati misurati?
- Cosa cambia con la cache implicita di DeepSeek?
- In che modo la crescita influisce sul momento in cui comprimere?
- Quale intervallo suggerisce il modello per un’attività continuativa?
- Come misurare il costo complessivo?
- Quale policy adottare in produzione?
- FAQ
- La compressione del contesto riduce sempre il costo delle API?
- Conviene comprimere esattamente alla soglia di prezzo?
- Posso aspettare che la finestra di contesto sia piena?
- Una crescita più rapida del contesto fa sempre ripagare prima un riepilogo?
- Con la cache implicita conviene aspettare il limite del contesto?
La compressione del contesto su Claude Sonnet 5.5 ha recuperato il proprio costo dopo 4-6 richieste successive, in sei prove a cache calda partite da circa 14k token. Questo intervallo misurato vale per il carico di lavoro usato. Una policy deve considerare la generazione del riepilogo, il modello di fatturazione effettivo della cache e il lavoro ancora da svolgere, che deve bastare a ripagare l’intervento.
TL;DR
- Quando ci si avvicina al limite della finestra di contesto, ridurre il contesto attivo diventa un requisito di capacità. I nostri test non hanno misurato la finestra massima del modello.
- Dopo un riepilogo fatturato nella fascia più costosa, una query era quasi in pareggio ($0.0560882 contro $0.0560655 mantenendo la cronologia). In quell’esempio, due query ripagavano nettamente il riepilogo.
- Una verifica retrospettiva della formula ha stimato 4-5 turni per recuperare il costo, contro i 4-6 misurati. Non era un test di previsione su risultati futuri.
- Un’attività su un archivio, con sei domande, è costata $0.0156941 con la compressione e $0.0059911 senza, con un’accuratezza di 6/6.
Quale problema vuoi risolvere comprimendo il contesto?
Prima di scegliere una soglia di token, stabilisci perché vuoi ridurre il contesto. Un limite rigido di capacità, una fascia di prezzo più alta e una normale conversazione lunga richiedono decisioni diverse.
La compressione del contesto sostituisce il contenuto precedente della conversazione con una rappresentazione più breve, usata dalle richieste successive. Nei nostri esperimenti abbiamo usato riepiloghi testuali gestiti lato client: una normale chiamata al modello generava un riepilogo e l’applicazione sostituiva la cronologia precedente con quel testo. Le funzionalità native di compressione con firma o crittografia hanno contratti diversi per richieste e conteggio dell’utilizzo.
| Situazione | Obiettivo principale | Quando intervenire? | Evidenze in questo articolo |
|---|---|---|---|
| Ci si avvicina alla finestra di contesto del modello | Poter continuare l’attività | Quando serve margine per il prossimo input, il risultato dei tool e l’output | Limiti documentati del modello e una policy ingegneristica; nessun esperimento sulla finestra massima |
| Ci si avvicina a una fascia di prezzo superiore | Ridurre il costo dell’intero carico di lavoro | Quando il risparmio atteso sulle tariffe supera i costi del riepilogo e della prosecuzione | Un piccolo esperimento sulle fasce di prezzo, senza cache |
| Finestra e fascia di prezzo lasciano ampio margine | Migliorare uno specifico carico di lavoro | Quando resta abbastanza lavoro utile da ripagare il riepilogo senza perdere lo stato necessario | Confronti a coppie sulla conservazione dello stato con cache e un breve carico di lavoro su un archivio |
Scenario 1: cosa fare quando il contesto sta per esaurirsi?
Riduci o riorganizza il contesto attivo prima che la richiesta successiva possa superare la finestra supportata. A quel punto, continuare a inviare l’intera conversazione potrebbe non essere più possibile.
Nelle specifiche del modello, Claude Haiku 5.5 dichiara una finestra di 1M token e un output massimo di 128K. Sono specifiche pubblicate. Non abbiamo verificato il massimo contesto accettato sulla nostra route del gateway, e l’esperimento sulle fasce di prezzo descritto sotto non determina quel limite.
Riserva spazio per il prossimo input, il risultato dei tool e l’output richiesto dal servizio. Intervieni finché la richiesta di riepilogo rientra ancora nella finestra. Conserva lo stato essenziale nel riepilogo o in un record sorgente recuperabile, e valuta se l’attività prosegue correttamente. Una richiesta rifiutata perché supera la finestra non è un’alternativa riuscita a costo inferiore.
Scenario 2: conviene comprimere prima di una fascia di prezzo più alta?
Comprimi quando il lavoro rimanente previsto ripaga il riepilogo ai prezzi effettivi. Il passaggio a una fascia superiore può rendere conveniente la compressione, ma anche il riepilogo potrebbe essere fatturato nella fascia più costosa.
Claude Haiku 5.5 cambia tariffa oltre 100,000 token di input. Le tariffe standard di input e output, verificate il 4 novembre 2026, sono $0.10/$0.50 per milione di token fino a quella soglia e $0.50/$2.50 oltre la soglia.
Abbiamo inviato record fittizi e diversificati di una biblioteca attraverso il gateway Synthorai. Una richiesta con 94,350 token di input è costata $0.009437; una con 111,999 è costata $0.0560095. Entrambe hanno generato quattro token di output. La differenza in dollari dipende sia dalla lunghezza dell’input sia dalla fascia di prezzo.
Abbiamo poi riassunto la cronologia più lunga. La chiamata ha elaborato 112,028 token di input, senza hit della cache segnalati, ed è costata $0.0560715 nella fascia superiore. Entrambe le strategie hanno risposto correttamente alle query su quantità e fonti.
| Query rimanenti | Cronologia mantenuta | Riepilogo più query con contesto ridotto | Cronologia mantenuta, ricalcolata alla tariffa bassa | Compressione, ricalcolata alla tariffa bassa |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
Con una query si era quasi in pareggio: la differenza tra le strategie era di $0.0000227. In questo esempio, due query ripagavano nettamente il riepilogo. Ricalcolare tutti i token alla tariffa bassa separa l’effetto del volume da quello della tariffa.
Queste richieste senza cache descrivono un solo compito sintetico. Una cronologia già in cache si comporta diversamente. Verifica quanto il riepilogo porta il contesto sotto la soglia e quando i nuovi input la supereranno di nuovo; vedi le fasce di prezzo per contesti lunghi.
Scenario 3: quanti turni successivi ripagano una compressione?
Per Claude Sonnet 5.5 abbiamo misurato 4-6 turni successivi in sei prove con cache, partendo da circa 13.5k-14.2k token di input. Qui un turno corrisponde a una richiesta successiva al modello. L’esperimento includeva la generazione del riepilogo e le successive scritture in cache. Abbiamo cercato il primo punto di pareggio entro dodici richieste di prosecuzione dopo il riscaldamento condiviso della cache. In tutte e sei le prove, dopo quel punto la compressione è rimasta non più costosa fino alla richiesta 12. L’osservazione non copre una successiva scadenza della cache, un altro riepilogo o un cambio di attività.
Comprimere spreca il sovrapprezzo pagato per scrivere in cache?
Al momento della decisione, le scritture già pagate sono costi irrecuperabili. Bisogna valutare se il risparmio sulle letture future copre la richiesta di riepilogo e le nuove scritture. Questi esperimenti usavano una cache esplicita di cinque minuti. Le cache implicite hanno prezzi specifici per provider e potrebbero non applicare lo stesso sovrapprezzo di scrittura.
Una prova con crescita media mostra la differenza tra il primo intervento e un ulteriore riepilogo più avanti nella sessione:
| Intervento | Costi di lettura futuri evitati | Scritture aggiuntive nella prosecuzione | Costo di generazione del riepilogo | Risultato netto al turno 12 |
|---|---|---|---|---|
| Primo riepilogo rispetto al mantenimento della cronologia | $0.0159875 | $0.0010175 | $0.0049761 | $0.0099939 in meno |
| Secondo riepilogo rispetto a fermarsi al primo | $0.0037283 | $0.0013925 | $0.0065302 | $0.0041844 in più |
La seconda riga include $0.0000100 in meno per altri token. Gli addebiti dei riepiloghi comprendono le rispettive categorie di utilizzo della cache: non contarle due volte. Le categorie di token non permettono di individuare le singole voci mai riutilizzate.
Quanto si avvicina la formula ai risultati misurati?
Un semplice modello a cache calda stima i turni rimanenti necessari. Indichiamo con H i token di cronologia sostituiti, con S i token di input del riepilogo sostitutivo, con A il costo completo della richiesta di riepilogo, con r il prezzo per token letto dalla cache e con w il prezzo per token scritto in cache. Mantieni le istruzioni invariate prima della cronologia da sostituire.
Su n richieste future, mantenere la cronologia costa n*r*H. La sostituzione costa A + w*S + (n-1)*r*S. La differenza incrementale è:
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
La formula presuppone H > S, idoneità immediata alla cache, prezzi invariati e aggiunte successive, output e uso dei tool uguali. Non copre la scadenza della cache, ulteriori riscritture del prefisso mantenuto o costi per recuperare la qualità persa. Se questi fattori cambiano, calcola i costi per intervalli distinti.
Abbiamo applicato la formula a posteriori, dopo gli esperimenti. Il calcolo usa i dati di utilizzo del riscaldamento e del riepilogo, non i costi successivi, ma i risultati erano già noti. È una verifica retrospettiva, non una validazione su dati separati o su risultati futuri. L’analisi approssima H con l’input totale del riscaldamento e S con i token di output del riepilogo. Questi valori non coincidono con la cronologia effettivamente sostituibile e con l’input sostitutivo, per via delle istruzioni stabili, del testo di contorno e dell’idoneità alla cache.
| Crescita in ingresso | Prova | Stima retrospettiva | Recupero del costo misurato |
|---|---|---|---|
| Circa 96 token/turno | 1 | 5 turni | 6 turni |
| Circa 96 token/turno | 2 | 5 turni | 6 turni |
| Circa 1.4k token/turno | 1 | 5 turni | 5 turni |
| Circa 1.4k token/turno | 2 | 4 turni | 4 turni |
| Circa 5.2k-5.5k token/turno | 1 | 5 turni | 5 turni |
| Circa 5.2k-5.5k token/turno | 2 | 4 turni | 5 turni |
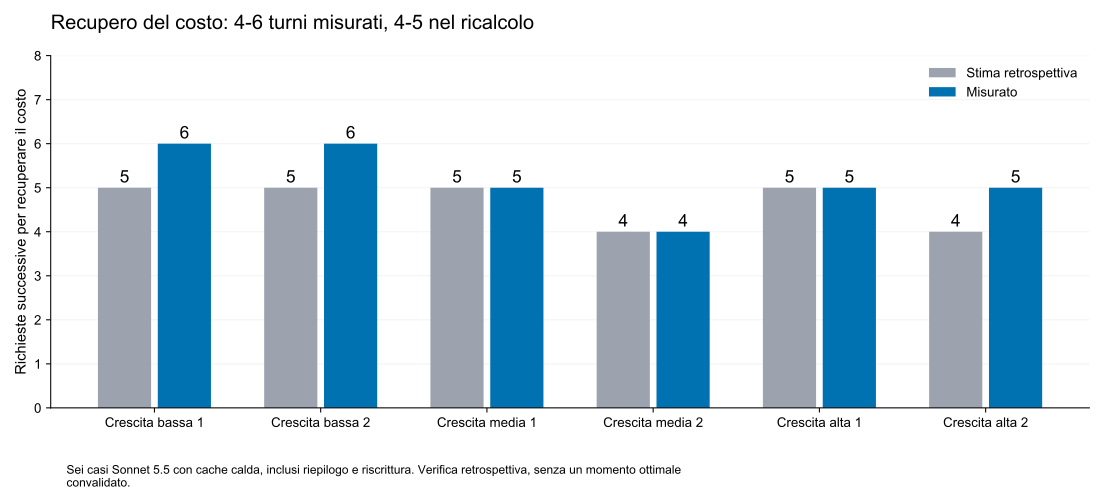
In queste sei prove, l’errore della verifica retrospettiva è stato al massimo di un turno. Per decidere su un caso futuro servono stime di A e S ricavate da riepiloghi precedenti e una validazione su nuove attività. Questo confronto non garantisce un limite generale all’errore.
Cosa cambia con la cache implicita di DeepSeek?
L’assenza di un costo separato di scrittura in cache non rende gratuito l’input dopo la compressione. DeepSeek V4.1 Flash 1017 usa la cache automatica e prezzi di input distinti per hit e miss. La sua pagina dei prezzi non riporta un addebito separato per la scrittura. Un nuovo prefisso contenente il riepilogo paga comunque la tariffa di input per miss quando non è in cache.
La documentazione della cache richiede che le unità di prefisso persistite corrispondano. La costruzione richiede secondi e gli hit non sono garantiti, quindi il testo sostitutivo può produrre miss su più di una richiesta. Monitora prompt_cache_hit_tokens e prompt_cache_miss_tokens; non dare per scontata una sola chiamata a cache fredda, né che un prefisso di sistema invariato produca sempre un hit.
Indichiamo con p il prezzo di input per token in caso di miss e con m il numero di richieste con prefisso sostitutivo a cache fredda nelle n richieste future. Se la strategia di riferimento mantiene la cronologia in cache e i costi comuni successivi si annullano:
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
Per una richiesta a cache fredda, sostituisci w con p, non con zero. Se m è ignoto, calcola più scenari oppure usa i costi delle categorie hit/miss effettive, includendo i miss sul prefisso stabile e sulla chiamata di riepilogo.
Quello che segue è un calcolo basato sulla formula, non un esperimento DeepSeek. Usiamo le tariffe ufficiali Flash fuori picco: $0.003/M per l’input con hit, $0.15/M per l’input con miss e $0.60/M per l’output. Assumiamo un riepilogo di 1k token, la cronologia originale già in cache, una richiesta sostitutiva a cache fredda e un costo del riepilogo A = r*H + output_price*S. Ignoriamo testo di contorno, reasoning e tool.
| Cronologia originale | Costo ipotizzato della chiamata di riepilogo | Recupero del costo calcolato |
|---|---|---|
| 10k token | $0.000630 | 29 richieste |
| 100k token | $0.000900 | 4 richieste |
Letture economiche possono favorire il mantenimento di una cronologia breve in cache, mentre un lavoro più lungo può ripagare la compressione. Non abbiamo misurato qualità e recupero dei costi su DeepSeek. Ricalcola con le tariffe di picco o per sessioni con tariffe miste.
In che modo la crescita influisce sul momento in cui comprimere?
La crescita cambia la cronologia presente al momento della decisione. Se prima dell’intervento passano j turni e ciascuno aggiunge g token, inserisci nella formula H_j = H_0 + g*j, insieme alle dimensioni e al costo attuali del riepilogo.
Una crescita successiva uguale aggiunge costi comuni alle due strategie. Se prezzi e comportamento della cache restano invariati, quei termini si annullano. Una crescita più rapida porta prima ai limiti di capacità o di prezzo, ma da sola non determina i turni necessari a recuperare il costo.
Nei nostri test di crescita, lo stato essenziale restava piccolo mentre aumentavano i dati d’archivio. In entrambe le prove da dodici turni, ripetere la compressione costava più di un solo riepilogo con crescita media e meno con crescita alta. Tutte le policy hanno risposto correttamente a 96/96 query sullo stato, inclusa l’estensione; questo non verifica una crescita illimitata dello stato essenziale.
Quale intervallo suggerisce il modello per un’attività continuativa?
Per un’attività di lunga durata con crescita, dimensioni del riepilogo, prezzi e comportamento della cache approssimativamente costanti, indichiamo con F il costo fisso di ogni ciclo di compressione, inclusi l’output del riepilogo e la riscrittura del testo sostitutivo. Escludiamo i costi lineari rispetto all’intervallo: il loro contributo medio per turno è costante. Quando il modello che riassume legge la cronologia dalla cache, stimiamo F come A - r*H + w*S; altri modelli tariffari richiedono una scomposizione specifica. Se g è la crescita per turno e k l’intervallo tra riepiloghi, il costo medio dipendente dall’intervallo è:
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
Servono F, r e g positivi, riepiloghi mantenuti di piccole dimensioni e qualità comparabile nell’esecuzione dell’attività. Con crescita zero non c’è un motivo legato alla crescita per intervenire periodicamente; con letture gratuite questo modello non prevede un recupero dei costi tramite il risparmio sulle letture. Con i nostri prezzi di cache esplicita e le nostre dimensioni dei riepiloghi, gli intervalli candidati sono circa 30, 7-8 e 4 turni per crescita bassa, media e alta. Prova gli interi vicini, con un minimo di una richiesta, rispettando il margine di capacità. Non abbiamo eseguito una scansione degli intervalli che li dimostri ottimali. Una cache con tariffazione dei miss richiede una propria scomposizione dei costi fissi.
Un esempio numerico chiarisce le unità. In una prova registrata con crescita media avevamo A = $0.0049761, H = 13,712, S ≈ 341 e g ≈ 1,396 tokens/turn. Con r = $0.10/M e w = $2.50/M otteniamo:
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
Questo calcolo ricava un candidato dai valori registrati; non dimostra che una policy ogni otto richieste sia ottimale. La verifica sull’orizzonte residuo è distinta: se si stima che un intervento si ripaghi dopo cinque richieste e ne restano solo tre, salta quell’intervento facoltativo anche se il timer periodico lo richiede.
Quando l’attività sta per finire, evita un ulteriore riepilogo facoltativo se non può ripagarsi nelle richieste rimanenti. Capacità, fasce di prezzo e conservazione delle informazioni necessarie hanno priorità su questo modello economico semplificato.
Un breve carico di lavoro su un archivio mostra questo criterio. Entrambe le strategie hanno risposto correttamente a sei domande sulle quantità, ma mantenere la cronologia è costato $0.0059911, contro $0.0156941 includendo un riepilogo. Sei query non hanno ripagato quell’intervento. Il riepilogo conservava dettagli sufficienti e non è servita alcuna ricerca aggiuntiva. L’orizzonte di recupero dipende dal riepilogo e dal carico di lavoro effettivi, non da una regola universale di quattro-sei turni.
Come misurare il costo complessivo?
Includi il riepilogo, la prima richiesta riscritta e tutte le richieste di prosecuzione. La riduzione dei token del prompt e la percentuale di hit della cache, da sole, non dimostrano un risparmio.
Per Claude Sonnet 5.5, abbiamo usato nel conteggio $2/M per l’input nuovo, $2.50/M per le scritture nella cache di cinque minuti, $0.10/M per le letture dalla cache e $10/M per l’output. Le letture dalla cache sono economiche, ma hanno comunque un costo. Sostituire una cronologia già in cache può generare una nuova scrittura, mentre un riepilogo molto breve potrebbe non essere affatto idoneo alla cache. I nostri punti di separazione espliciti nei blocchi di contenuto hanno prodotto scritture e letture misurabili; alcuni prefissi brevi compressi inizialmente non segnalavano né le une né le altre.
Questa funzione presuppone un numero specificato di richieste con prefisso a cache fredda. Passa il prezzo della scrittura esplicita o quello dell’input con miss implicito come cold_input_per_million:
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
Per decidere prima della compressione, stima il costo del riepilogo dalle chiamate precedenti. Verifica la stima sui dati completi di utilizzo, includendo errori e attività di recupero; l’assenza di un rendiconto non rende gratuita una richiesta.
Le misurazioni sono state eseguite il 4 novembre 2026 tramite l’interfaccia Messages del gateway, con thinking disabilitato e senza tool ospitati. Le risposte ordinarie erano limitate a 128 token di output e i riepiloghi a 2,048. Abbiamo ricostruito i costi dall’utilizzo restituito, applicando i prezzi standard, e li abbiamo confrontati con i costi riportati dal gateway. Non si tratta di una riconciliazione con le fatture del fornitore. I carichi di lavoro ordinari usavano riepiloghi lato client, non un’implementazione nativa della compressione.
Quale policy adottare in produzione?
Applica prima i vincoli di capacità e tariffa, lasciando margine per input, tool e output. Per i carichi di lavoro su Claude Sonnet 5.5 con cache esplicita, includi sovrapprezzi di scrittura e addebiti dei riepiloghi, ed evita gli interventi facoltativi che difficilmente si ripagheranno prima del completamento. Valida gli intervalli interi vicini al candidato analitico usando gli stessi arrivi delle attività e gli stessi turni finali.
Con la cache implicita di DeepSeek V4.1 Flash 1017, conserva un prefisso utile quando gli hit sono stabili e resta poco lavoro. Può essere ragionevole intervenire più tardi, a una soglia prudenziale di capacità; l’assenza di costi separati di scrittura non implica che si debba aspettare il limite rigido. Per attività più lunghe, stima i costi effettivi di hit e miss e controlla le richieste dopo la riscrittura finché non compaiono hit.
Ricalcola quando cambiano prezzi, stato della cache, modello o dimensioni dello stato essenziale. Mantieni fonti recuperabili e verifica i valori modificati nelle attività sensibili ai dettagli. Registra il riepilogo e l’utilizzo successivo in un’unica sessione dell’agente, usando le corrette categorie di token.
FAQ
La compressione del contesto riduce sempre il costo delle API?
Il risparmio deve superare i costi del riepilogo, della ricostruzione della cache e del recupero. Il nostro archivio con sei query è costato $0.0156941 con un riepilogo e $0.0059911 mantenendo la cronologia, con un’accuratezza di 6/6 in entrambi i casi.
Conviene comprimere esattamente alla soglia di prezzo?
La soglia di prezzo è il momento in cui valutare tutto il lavoro rimanente, non un comando automatico a riassumere. Nel nostro esempio con Claude Haiku 5.5, il riepilogo stesso è stato fatturato oltre 100,000 token; una query successiva portava quasi al pareggio, mentre due lo ripagavano nettamente.
Posso aspettare che la finestra di contesto sia piena?
Lascia spazio per la richiesta di riepilogo, il prossimo input o risultato dei tool e l’output. Una cronologia già troppo grande potrebbe non rientrare in una richiesta di riepilogo. Non abbiamo misurato il punto di errore al limite della finestra massima.
Una crescita più rapida del contesto fa sempre ripagare prima un riepilogo?
Una crescita condivisa più rapida aumenta i costi di entrambe le strategie e non incrementa automaticamente il risparmio di un singolo riepilogo. Ripetere la compressione può limitare l’accumulo successivo, ma aggiunge costi di riepilogo e riscrittura. Nelle nostre prove con crescita media, ripetere la compressione costava più di un solo riepilogo su dodici turni; con crescita alta era favorita la ripetizione. Scegli la policy in base a crescita, orizzonte residuo e stato da conservare.
Con la cache implicita conviene aspettare il limite del contesto?
La cache implicita può favorire il mantenimento di una cronologia già in cache ed economica per un’attività breve. DeepSeek V4.1 Flash 1017 addebita comunque l’input con miss per un prefisso di riepilogo non in cache, e la persistenza non è garantita. Stima il beneficio rimanente, poi lascia margine per tool, input e output entro la finestra supportata. I valori DeepSeek riportati sopra sono calcoli, non soglie misurate.