
Claude Sonnet 5.5 vs Sonnet 5: stesso prezzo, -80% per task
Indice
- Cosa cambia in Claude Sonnet 5.5?
- Cosa mostrano i benchmark del rilascio?
- Come abbiamo effettuato le misurazioni?
- Sonnet 5.5 costa meno di Sonnet 5 per task?
- Quanto costa ciascun livello di effort?
- Perché Sonnet 5.5 inserisce i passaggi nella risposta?
- Cosa succede in un tool loop?
- Sonnet 5.5 è più veloce?
- I token budget di Sonnet 5 restano validi?
- Quale modello conviene usare?
- FAQ
Claude Sonnet 5.5 ha gli stessi prezzi per token di Claude Sonnet 5: $2 per milione di token in input e $10 per milione in output. Ogni risparmio dipende quindi dal minor numero di token utilizzati. Su 13 task single-shot eseguiti con le impostazioni predefinite dell’API, il costo è stato di $0.0041 per task contro $0.021 di Sonnet 5, l’80% in meno, ed entrambi i modelli hanno risposto correttamente a tutti i task. Il problema riguarda il formato dell’output: sotto il livello di effort xhigh, Sonnet 5.5 a volte non usa il reasoning nascosto e inserisce i passaggi nella risposta, anche quando il prompt chiede esclusivamente il risultato.
TL;DR
- Con le impostazioni predefinite dell’API, Sonnet 5.5 è costato $0.0041 per task contro $0.021 di Sonnet 5; entrambi hanno risposto correttamente a tutte le 39 chiamate.
- Sonnet 5.5 ha avuto costi simili con effort
low,mediumehigh;maxè costato 3.5x rispetto al valore predefinito. - Sotto
xhigh, Sonnet 5.5 ha inserito i passaggi nella risposta in 68 dei 156 prompt che chiedevano solo il risultato; un system prompt non ha risolto il problema. - In un tool loop con quattro domande, Sonnet 5.5 a
maxè costato $0.042 per esecuzione, più di Opus 5.5 con le impostazioni predefinite ($0.033).
Anthropic ha rilasciato Sonnet 5.5 il 2026-09-28, dichiarando che è più veloce del 30% e costa “fino al 30% in meno per task” rispetto a Sonnet 5. Abbiamo effettuato le misurazioni il giorno successivo.
Cosa cambia in Claude Sonnet 5.5?
Il prezzo è rimasto invariato, mentre sono cambiati i controlli del thinking e diversi parametri delle richieste. Sonnet 5.5 usa l’adaptive thinking: il modello decide quanto reasoning nascosto eseguire prima di rispondere, e i relativi token vengono fatturati come output. Il comportamento si controlla tramite effort (output_config.effort nella Messages API), un parametro della richiesta con cinque livelli da low a max. Il valore predefinito dell’API è high.
| Sonnet 5.5 | Sonnet 5 | Opus 5.5 | |
|---|---|---|---|
| Data di rilascio | 2026-09-28 | 2026-06-30 | 2026-09-22 |
| Input / output, per 1M token | $2 / $10 | $2 / $10 | $4 / $20 |
| Lettura dalla cache, per 1M token | $0.20 | $0.20 | $0.20 |
| Finestra di contesto / output massimo | 1M / 128K | 1M / 128K | 1M / 128K |
| Knowledge cutoff (è pubblicato solo il mese) | Giugno 2026 | Gennaio 2026 | Giugno 2026 |
| Effort predefinito nell’API | high | high | medium |
| Impostazione minima del thinking | between_tools (con high o inferiore) | disabled | non può essere disattivato; il thinking è sempre attivo |
| Prompt minimo memorizzabile in cache | 512 token | 1,024 token | 512 token |
Il prezzo di lancio di Sonnet 5, $2 / $10, era stato presentato come promozionale, ma la pagina dei prezzi di Anthropic ora lo indica come standard; il previsto aumento a $3 / $15 non è avvenuto.
Secondo la guida alla migrazione, le seguenti richieste funzionavano con Sonnet 5 ma restituiscono HTTP 400 con Sonnet 5.5:
thinking: {"type": "disabled"}. Va sostituito conthinking: {"type": "between_tools"}, che disattiva il reasoning prima della prima risposta ed è accettato solo con efforthigho inferiore.- Uso forzato dei tool (
tool_choiceimpostato suanyo su un tool specifico). Va mantenutoauto, indicando nel prompt quando usare il tool. - Un budget di thinking manuale (
budget_tokens), valori non predefiniti pertemperature,top_potop_k, e un turno assistant precompilato, cioè l’inizio della risposta fornito al modello. - Il replay di un blocco di thinking di Sonnet 5.5 dopo aver modificato il system prompt, i tool o un messaggio precedente, per gli account creati dal 2026-08-31.
- Il precedente tool per computer use
computer_20251124nella Claude API e su Google Cloud.
Una modifica non genera errori: le brevi note scritte dal modello tra le chiamate ai tool ora arrivano come blocchi thinking, vuoti con l’impostazione di visualizzazione predefinita. Di conseguenza, un’interfaccia che le mostra in streaming non visualizza più nulla.
Cosa mostrano i benchmark del rilascio?
Nella tabella di Anthropic, Sonnet 5.5 è a pochi punti da Opus 5.5, pur avendo prezzi per token dimezzati, ed è molto avanti rispetto a Sonnet 5.
| Benchmark (cosa misura) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (coding agentico in un terminale) | 70.6% | 10.3% | 66.4% (xhigh) | non dichiarato |
| CursorBench 4.0 (coding in un editor) | 55.5% | 34.1% | 57.8% | non dichiarato |
| GDPval-AA v2.1 (documenti per knowledge work, punteggio Elo, più alto è meglio) | 1844 | 1449 | 1846 | 1487 |
| OSWorld 2.1 (computer use, punteggio parziale) | 80.1% | 57.0% | 81.8% | non dichiarato |
| Humanity’s Last Exam, con tool | 64.5% | 54.9% | 67.7% | non dichiarato |
Artificial Analysis segnala un problema di costo: con effort max, Sonnet 5.5 ha ottenuto 56 nel suo Intelligence Index, due punti meno di Opus 5.5 a max, ma ha usato circa 193K token di output per task. È il valore più alto mai misurato dal sito, circa il 60% in più rispetto a Opus 5.5 o Sonnet 5 a max, per un costo di circa $7.60 per task dell’indice.
Come abbiamo effettuato le misurazioni?
Abbiamo inviato a tutti e tre i modelli 13 task single-shot, ciascuno composto da un prompt e una risposta, senza tool e con risultati noti: otto task brevi, come sommare i numeri primi inferiori a 60 o contare la cifra 7 da 1 a 500, e cinque che richiedono più passaggi, come un problema knapsack con 10 elementi, i percorsi in una griglia 8x8 con ostacoli e 13 elevato alla potenza 1,001 modulo 10,007. Abbiamo calcolato ogni soluzione localmente con brute force e concluso ogni prompt con “Rispondi con un solo numero intero, nient’altro”. Ogni task è stato eseguito 3 volte con le impostazioni predefinite dell’API e con ciascuno dei cinque livelli di effort, per un totale di 702 chiamate sulla Messages API nativa. Ogni prompt conteneva una stringa casuale univoca, così da evitare risposte provenienti dalla cache, e i costi sono stati calcolati in base ai prezzi di listino di Anthropic. Abbiamo verificato sia la correttezza del risultato finale sia la presenza del solo risultato nella risposta.
L’accuratezza non ha evidenziato differenze tra i modelli. Sonnet 5.5 ha risposto correttamente a tutte le 234 chiamate e Sonnet 5 a tutte le 233 completate, mentre una ha restituito un errore del server; Opus 5.5 ha sbagliato un task con low e uno con le impostazioni predefinite.
Sonnet 5.5 costa meno di Sonnet 5 per task?
Sonnet 5.5 è costato l’80% in meno rispetto a Sonnet 5 con le impostazioni predefinite e dal 77% al 78% in meno con low, medium e high, perché ha generato circa un quinto dei token di output. I prezzi di listino sono identici, quindi il risparmio dipende interamente dall’efficienza nell’uso dei token. Sonnet 5 ha generato circa 1,800-2,100 token per task a ogni livello di effort; Sonnet 5.5 ne ha generati circa 400 fino a xhigh.
| Tutti i 13 task, per task | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Impostazioni API predefinite | $0.0041 (396 token) | $0.0212 (2,105) | $0.0070 (334) |
low | $0.0043 (409) | $0.0184 (1,817) | $0.0065 (309) |
medium | $0.0040 (383) | $0.0180 (1,780) | $0.0082 (393) |
high | $0.0043 (416) | $0.0188 (1,858) | $0.0088 (421) |
xhigh | $0.0059 (574) | $0.0202 (2,001) | $0.0105 (507) |
max | $0.0146 (1,438) | $0.0193 (1,909) | $0.0234 (1,149) |
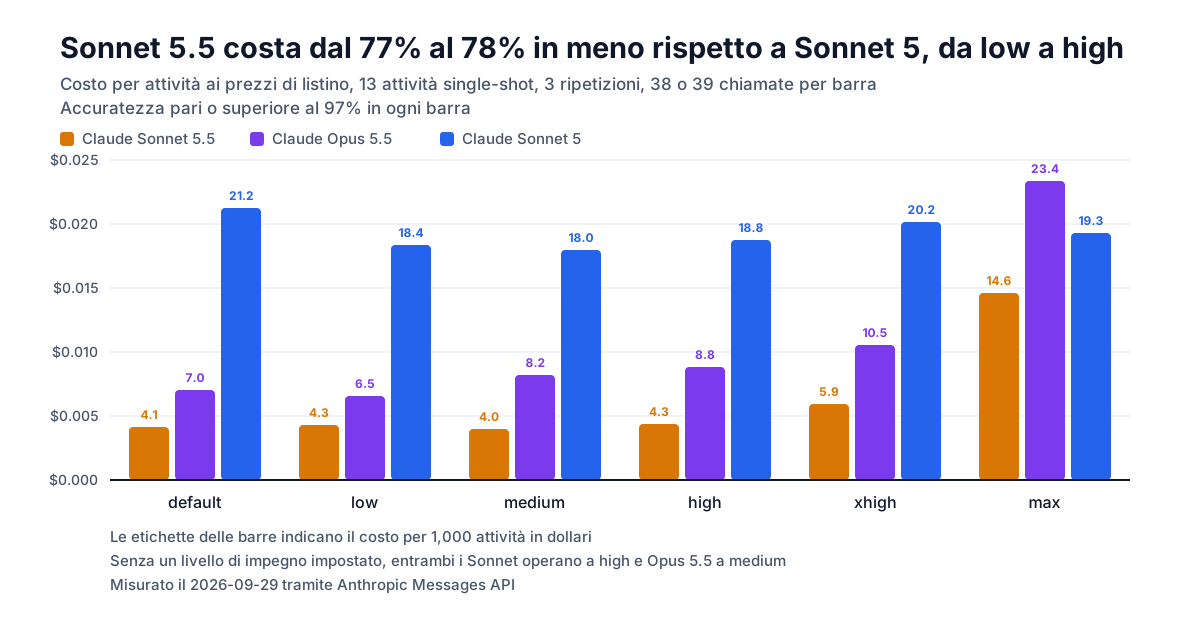
I conteggi indicano la media dei token di output per chiamata, reasoning incluso. Sui cinque task difficili, il risparmio con le impostazioni predefinite è dell’84% ($0.0057 contro $0.0348). Nel nostro tool loop, dove l’intera conversazione viene reinviata a ogni turno e dominano i token di input, il risparmio è dell’8%. Il “fino al 30%” dichiarato da Anthropic è quindi prudente per prompt singoli come questi, ma generoso per un loop breve come il nostro.
Con solo 13 task, il risparmio dell’80% con l’impostazione predefinita ha un margine ampio: ricampionando i task si ottiene un intervallo al 95% tra il 66% e l’85% in meno, e il limite inferiore resta sopra il 50% in ogni livello da low a xhigh.
Quanto costa ciascun livello di effort?
Con Sonnet 5.5, low, medium e high costano tutti circa $0.0042 per task, quindi in questo test il valore predefinito high non comporta costi aggiuntivi; xhigh è costato circa il 40% in più e max 3.5x rispetto al valore predefinito. A max, Sonnet 5.5 è costato il doppio per task rispetto a Opus 5.5 con le impostazioni predefinite ($0.0146 contro $0.0070), senza miglioramenti nell’accuratezza.
Questo andamento piatto non vale per tutti i workload: in un task DevOps più lungo, un altro tester ha rilevato che high usava circa il doppio dei token di output rispetto a medium. Se l’effort incide sul workload, serve un test completo su tutti i livelli.
Perché Sonnet 5.5 inserisce i passaggi nella risposta?
Sotto xhigh, Sonnet 5.5 non usa sempre un blocco di thinking. Quando lo omette, esegue il reasoning direttamente nella risposta. Il blocco di thinking è la parte separata della risposta che contiene il reasoning del modello; il testo è vuoto per impostazione predefinita e la risposta segue in un blocco text.
Delle 234 risposte di Sonnet 5.5, tutte le 166 con un blocco di thinking contenevano esclusivamente il risultato. Tutte le 68 senza blocco mostravano prima i passaggi, per esempio “09:47 + 3:46 = 13:33 … + 1:39 = 15:40”, seguiti da “15:40”. Il risultato finale era sempre corretto, ma il formato non rispettava la richiesta del prompt.
| Risposte contenenti solo il risultato | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Impostazioni API predefinite | 22 / 39 | 38 / 39 | 38 / 39 |
low | 12 / 39 | 37 / 39 | 38 / 39 |
medium | 24 / 39 | 37 / 39 | 39 / 39 |
high | 30 / 39 | 38 / 39 | 39 / 39 |
xhigh | 39 / 39 | 35 / 38 | 39 / 39 |
max | 39 / 39 | 37 / 39 | 39 / 39 |
Il comportamento dipende dal task: dove è successo, Sonnet 5.5 ha mostrato i calcoli in tutte e tre le ripetizioni, tranne che in un task con l’impostazione predefinita, dove è accaduto due volte. È successo su 9 dei 13 task con low, 6 con l’impostazione predefinita, 5 con medium e 3 con high (tutti brevi calcoli aritmetici). Contati per task, con soli 13 task, nessuno di questi scarti supera una correzione di Holm, quindi i conteggi vanno letti come osservazioni e non come un tasso su cui pianificare. Gli errori di formato di Sonnet 5 sono diversi: una risposta corretta in grassetto seguita da una breve spiegazione. La riga xhigh contiene 38 chiamate perché una ha restituito un errore del server.
Un system prompt che chiedeva “solo il risultato finale”, con tutti i passaggi svolti senza mostrarli, non ha aiutato: Sonnet 5.5 ha fornito esclusivamente il risultato in 8 dei 24 task brevi a low e in 9 dei 24 a medium, contro 6 e 9 senza system prompt. xhigh ha risolto il problema: ogni risposta conteneva un blocco di thinking e il solo risultato, con un costo superiore di circa il 40% rispetto a low, medium e high. Per il codice che esegue il parsing dell’output del modello:
- Usare
xhighquando la risposta deve stare su una sola riga. - Oppure leggere il risultato dall’ultima riga non vuota, che è stata corretta in tutti i 68 casi osservati.
- Anche gli structured output di Anthropic possono vincolare la risposta a uno schema; non abbiamo testato questa soluzione.
import anthropic

client = anthropic.Anthropic()
prompt = "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer, nothing else."
resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    output_config={"effort": "xhigh"},  # low, medium, high (API default), xhigh, max
    messages=[{"role": "user", "content": prompt}],
)
text = "".join(block.text for block in resp.content if block.type == "text")
lines = text.strip().splitlines()
answer = lines[-1] if lines else None  # below xhigh, working can precede the answer
print(answer, resp.usage.output_tokens)  # output_tokens includes the reasoning
Cosa succede in un tool loop?
Con le impostazioni predefinite, low e medium, Sonnet 5.5 ha completato correttamente ogni esecuzione di un loop con quattro domande di code reading, per circa $0.011, un terzo del costo di Opus 5.5. A max ha effettuato tre volte più chiamate ai tool ed è costato più di Opus 5.5. Ogni modello dispone di tre tool, per elencare i file, leggere un file ed eseguire ricerche, su una piccola codebase sintetica. Ogni risposta richiede da 3 a 6 consultazioni distribuite tra più file.
| Tool loop, 12 esecuzioni ciascuno | Risolti | Mediana dei turni | Chiamate ai tool per esecuzione | Costo per esecuzione | Mediana del tempo totale |
|---|---|---|---|---|---|
| Sonnet 5.5, predefinito | 12 / 12 | 3 | 4.8 | $0.0112 | 6.7 s |
Sonnet 5.5, low | 12 / 12 | 3 | 4.9 | $0.0112 | 7.4 s |
Sonnet 5.5, medium | 12 / 12 | 3 | 5.1 | $0.0113 | 6.8 s |
Sonnet 5.5, max | 12 / 12 | 4 | 14.7 | $0.0422 | 20.1 s |
| Opus 5.5, predefinito | 12 / 12 | 4 | 5.3 | $0.0332 | 25.3 s |
| Sonnet 5, predefinito | 11 / 12 | 3.5 | 4.2 | $0.0122 | 15.8 s |
Le testimonianze dei clienti riportate da VentureBeat indicano meno chiamate ai tool rispetto a Sonnet 5, un terzo in meno nel caso di Lovable. Il nostro loop è troppo breve per mostrare questo vantaggio: Sonnet 5.5 ha effettuato 4.8 chiamate per esecuzione contro 4.2 di Sonnet 5, pur costando l’8% in meno e terminando in meno della metà del tempo.
Sonnet 5.5 è più veloce?
Ha terminato prima soprattutto perché ha generato meno testo. La mediana del tempo totale, dall’invio della richiesta alla ricezione della risposta completa, per ogni task single-shot con le impostazioni predefinite è stata di 3.9 secondi per Sonnet 5.5, 8.1 secondi per Sonnet 5 e 5.5 secondi per Opus 5.5. I token di output al secondo sul tempo totale erano quasi identici per i due Sonnet, 88 contro 91. L’attesa si è dimezzata perché Sonnet 5.5 ha generato un quinto dei token, non perché li abbia prodotti più velocemente. Sui task difficili, i tempi sono 5.8 secondi contro 21.0.
I token budget di Sonnet 5 restano validi?
I budget di contesto e i limiti max_tokens pensati per Sonnet 5 dovrebbero continuare ad andare bene. Secondo la guida alla migrazione di Anthropic, Sonnet 5.5 usa lo stesso tokenizer, e i quattro testi fissi che abbiamo provato (prosa inglese, codice Python, argomenti JSON per gli strumenti, prosa cinese) hanno dato lo stesso numero di token su entrambi i modelli e su Opus 5.5, per esempio 1,270 token per l’inglese e 493 per il cinese; Sonnet 5.5 e Opus 5.5 aggiungono 2 token fissi per richiesta. Le richieste con strumenti costano un po’ meno in input: la pagina dei prezzi di Anthropic indica 286 token per il prompt di sistema nascosto sull’uso degli strumenti su Sonnet 5.5, contro 354 su Sonnet 5.
Quale modello conviene usare?
Per la maggior parte dei workload basati su Sonnet 5, conviene migrare; resta da scegliere il livello di effort.
| Workload | Problema da monitorare | Raccomandazione | Numeri |
|---|---|---|---|
| Output elaborato dal codice: estrazione, classificazione, singoli valori | Sotto xhigh, i passaggi possono finire nella risposta | Sonnet 5.5 a xhigh, oppure medium con parsing dell’ultima riga | solo risultato in 39 / 39 casi a xhigh, 24 / 39 a medium; xhigh costa circa il 40% in più |
| Chat e testo destinato agli utenti | Latenza e costo | Sonnet 5.5 a medium | $0.0040 per task, mediana di 3.9 s |
| Loop agentici con tool | max moltiplica le chiamate ai tool | Sonnet 5.5 con le impostazioni predefinite o a medium; passare a Opus 5.5 prima di usare Sonnet 5.5 a max | $0.011 per esecuzione con le impostazioni predefinite, $0.042 a max, $0.033 con Opus 5.5 |
| Codice per Sonnet 5 che disattiva il thinking o forza un tool | HTTP 400 dopo il cambio di modello | between_tools (con high o inferiore) e tool_choice: auto | Guida alla migrazione di Anthropic |
Indipendentemente dal livello di effort, il codice dovrebbe includere due controlli: verificare che la risposta abbia il formato atteso dal parser e imporre un limite ai token di output per ogni richiesta, perché max ha aumentato il costo per task di 3.5x sui prompt singoli e le chiamate ai tool di 3x nel loop.
FAQ
Sonnet 5.5 costa meno di Opus 5.5?
Con le rispettive impostazioni predefinite, Sonnet 5.5 è costato il 41% in meno di Opus 5.5 per ogni task single-shot e un terzo per ogni esecuzione del tool loop. A max l’ordine si inverte: Sonnet 5.5 è costato il doppio rispetto a Opus 5.5 con le impostazioni predefinite sui task single-shot e il 27% in più per ogni esecuzione del tool loop.
Quale livello di effort conviene usare con Sonnet 5.5?
Sonnet 5.5 ha avuto costi simili con low, medium e high nei nostri task, da $0.0040 a $0.0043, quindi medium è un buon punto di partenza per chat e tool loop. Va usato xhigh quando il codice si aspetta un singolo valore nella risposta; max è costato 3.5x rispetto al valore predefinito.
Posso ancora disattivare il thinking su Sonnet 5.5?
Sonnet 5.5 rifiuta thinking: {"type": "disabled"} con HTTP 400. Va inviato invece thinking: {"type": "between_tools"}, accettato con effort low, medium o high.
Misurazioni correlate: Claude Opus 5.5 vs Opus 5, il tokenizer di Claude Sonnet 5 e i controlli del thinking dei vari provider.
Misurazioni eseguite il 2026-09-29, un giorno dopo il rilascio, tramite un gateway verso la Anthropic Messages API. In totale: 702 chiamate single-shot valutate, con 13 task e soluzioni calcolate tramite brute force, 3 ripetizioni, 6 livelli di effort e 3 modelli; 48 chiamate per testare una system instruction sul formato dell’output; 72 esecuzioni del tool loop, con 4 domande multi-hop, 3 ripetizioni e 6 impostazioni; conteggio dei token per quattro testi fissi su ciascun modello. I prompt contenevano stringhe casuali; i costi sono stati calcolati in base ai prezzi di listino di Anthropic.