
Gemini 2.5 Flash Image, connu sous le nom de Nano Banana, est le modèle de génération et d'édition d'images de Google que la page officielle présente comme son meilleur moteur pour la création visuelle à grande vélocité, avec une vitesse et une efficacité à l'état de l'art.
- Entrée
- texte image $0.3/M
- Sortie
- image texte $30/M
- Coupure des connaissances
- 2025-06
Benchmarks
gemini-2.5-flash-image : 22 résultats publiés, mais aucun benchmark en commun avec assez d'autres modèles pour comparer.
Le prix en perspective
Position du prix parmi 9 modèles comparables
La barre situe le prix de ce modèle parmi tous les modèles du même type sur Synthorai. Le moins cher et le plus cher sont nommés à chaque extrémité. Ce sont des tarifs de base ; les remises liées au batch, à la région et aux écritures de cache figurent sur la page des tarifs.
Spécifications et limites
Tokens
| Sortie max (spéc. fournisseur) | 32 768 |
|---|---|
| Coupure des connaissances | 2025-06 |
Image
| Tailles |
|
|---|---|
| Modes d'entrée | text-to-image, édition d'image conversationnelle (image + texte en entrée) |
| Capacités image |
|
Modèle
| Modalités | texte + image → image + texte |
|---|
- Fait rare pour un modèle d'image, il publie une date limite des connaissances (juin 2025)
- l'appel de fonctions et la réflexion ne sont pas pris en charge
Un prompt, mesuré via la passerelle
gemini-2.5-flash-image
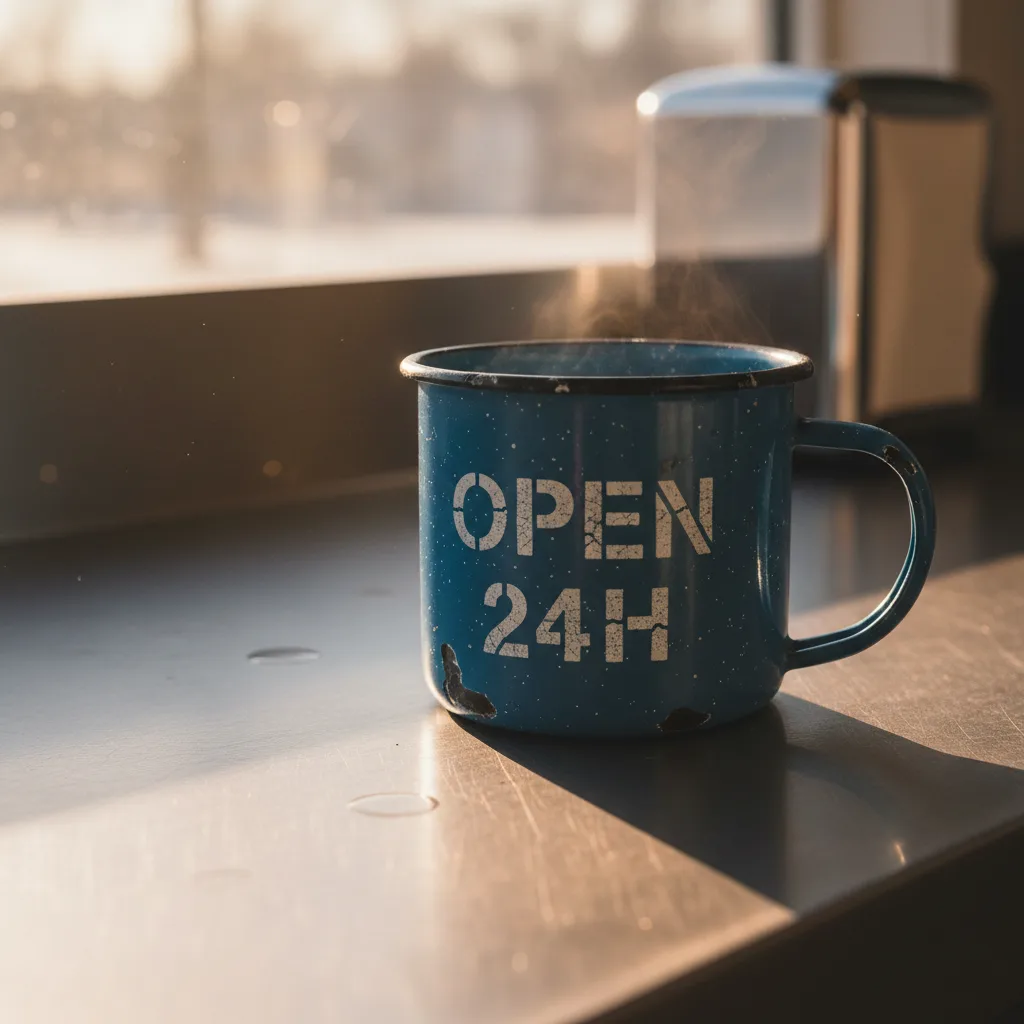
Renvoyé par le modèle 1024×1024 latence 7 s
Un prompt, une requête par modèle, sans nouvel essai ni tri des résultats : c'est le premier résultat renvoyé par chaque modèle. Ni la taille ni la durée n'ont été imposées. Chaque modèle a utilisé sa valeur par défaut, car une requête calibrée pour convenir à tous n'en mettrait aucun en valeur. Les fichiers sont réencodés pour le web : jugez la composition et le respect du prompt, pas la compression.
Utilisez gemini-2.5-flash-image en 30 secondes
Compatible OpenAI : changez la base_url, gardez votre SDK. POST /v1/images/generations
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-2.5-flash-image",
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-2.5-flash-image",
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-2.5-flash-image",
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-2.5-flash-image",
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-2.5-flash-image")
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));À propos de gemini-2.5-flash-image
- Il est conçu pour les scénarios à fort volume, l'édition d'images conversationnelle et les workflows à faible latence, combinant une compréhension multimodale native des entrées image et texte avec une sortie image et texte en 1K, 2K et 4K, le contrôle du format d'image ayant été ajouté au passage du modèle en disponibilité générale.
- L'édition suit le schéma de la famille : affinage conversationnel multi-tours qui reprend l'interaction précédente, ajout, suppression ou modification d'éléments, masquage sémantique pour l'inpainting, transfert de style et composition à partir de plusieurs images de référence.
- Les limites de tokens sont de 65 536 en entrée et 32 768 en sortie, et les sorties structurées, la mise en cache, le traitement par lots et l'inférence Flex et Priority sont pris en charge, tandis que l'appel de fonctions, l'ancrage Search et la réflexion ne le sont pas, ce qui constitue la limite pratique du raisonnement qu'il consacrera à une mise en page avant de dessiner.
- Chaque génération porte un filigrane SynthID.
- Google le décrit désormais comme le pionnier hérité de la série Nano Banana et recommande d'orienter les nouveaux travaux vers Nano Banana 2 Lite pour une meilleure qualité, une plus grande rapidité et un coût moindre : traitez-le donc comme l'option de compatibilité plutôt que comme le choix par défaut.
- Sa date limite des connaissances est juin 2025.
- Synthorai le sert derrière le même endpoint compatible OpenAI que ses modèles de chat.
FAQ
Peut-on essayer l'API gemini-2.5-flash-image gratuitement ?
Oui : les nouveaux comptes reçoivent 10 appels d'essai et jusqu'à $1 de crédit gratuit, sans carte bancaire. De quoi essayer gemini-2.5-flash-image sur votre charge de travail réelle avant d'ajouter un moyen de paiement.
Quels sont les points forts de gemini-2.5-flash-image ?
Meilleur moteur pour la création visuelle à grande vélocité ; édition d'images conversationnelle à faible latence ; vitesse et efficacité à l'état de l'art. La section À propos en donne un aperçu complet, tiré des notes de version du fournisseur.
Combien coûte gemini-2.5-flash-image ?
Sur Synthorai, gemini-2.5-flash-image coûte $0.3 par million de tokens en entrée et $30 par million de tokens en sortie, soit le tarif public du fournisseur, sans majoration de plateforme.
Comment générer des images avec l'API gemini-2.5-flash-image ?
Envoyez une requête POST à /v1/images/generations sur Synthorai avec model="gemini-2.5-flash-image". Le format est celui de l'API Images d'OpenAI : pas besoin du SDK du fournisseur. Tailles prises en charge : 1024x1024 (1:1), 832x1248 (2:3), 1248x832 (3:2), 864x1184 (3:4), 1184x864 (4:3), 896x1152 (4:5), 1152x896 (5:4), 768x1344 (9:16), 1344x768 (16:9), 1536x672 (21:9).
Comment obtenir l'accès à gemini-2.5-flash-image ?
Dans votre SDK OpenAI actuel, indiquez base_url="https://synthorai.io/v1" et model="gemini-2.5-flash-image", et c'est tout. Une seule clé API donne accès à tous les modèles de la passerelle.
Modèles associés
Comparer
Chaque valeur de cette page est reprise de la documentation du fournisseur (lien ci-dessus) et porte la date de sa vérification. Les prix sont comparés à l'échelle du catalogue. Quand les fournisseurs ne définissent pas une spécification de la même façon, la différence est signalée et la valeur n'est pas mise en graphique. Nous ne mesurons rien ici et nous n'attribuons aucune note.