
qwen-image-2.0-pro vs wan2.7-image-pro
Lequel choisir, et quand
Les deux sont des modèles d'image Alibaba au même $0.075 par appel, donc le choix porte sur ce que chacun peut produire : wan2.7-image-pro atteint le 4K en texte-vers-image et prend 0-9 images de référence avec des séries jusqu'à 12, tandis que qwen-image-2.0-pro est nativement 2K avec 1-3 images en entrée pour l'édition et jusqu'à 6 images par requête. wan2.7-image-pro est aussi le plus récent, 2026-04 contre 2026-02. Prenez qwen-image-2.0-pro pour ses préréglages 2K, wan2.7-image-pro pour le 4K, plus de références ou de plus grandes séries.
Tarifs
| qwen-image-2.0-pro | wan2.7-image-pro | Δ | |
|---|---|---|---|
| Par image générée | $0.075 | $0.075 | = |
Tarifs relevés dans le catalogue en direct à la génération du site ; la page de chaque modèle affiche la grille tarifaire à jour.
Leur position : prix par image générée, parmi les 8 modèles de génération d'images facturés dans cette unité (échelle logarithmique)
Spécifications
| qwen-image-2.0-pro | wan2.7-image-pro | |
|---|---|---|
| Modalités d'entrée | texte image | texte image |
| Modalités de sortie | image | image |
| Date de sortie | 2026-02-11 | 2026-04-01 |
| Tailles de sortie |
|
|
| Modes d'entrée | text-to-image, image editing (1-3 input images) | text-to-image, image editing (incl. bounding-box interactive edit), 0-9 reference images, text/image-to-image-set |
| Images par requête | 6 | 12 |
| Formats | png | png |
| Notes | Native 2K, custom WxH and standard aspect presets flagship fused generation+editing with enhanced text rendering, realistic textures and semantic adherence 1-6 images per request negative prompts | 4K text-to-image (max 4096x4096; editing max 2K), aspect ratios 1:8-8:1 instruction + click-to-edit editing character-consistent sets up to 12 images print-quality text rendering incl. formulas/tables |
Les spécifications sont reprises de la documentation de chaque fournisseur ; quand un fournisseur ne publie pas une valeur, la ligne est omise et non déduite. Sources complètes : qwen-image-2.0-pro · wan2.7-image-pro
Un prompt, deux modèles, mesurés via la passerelle
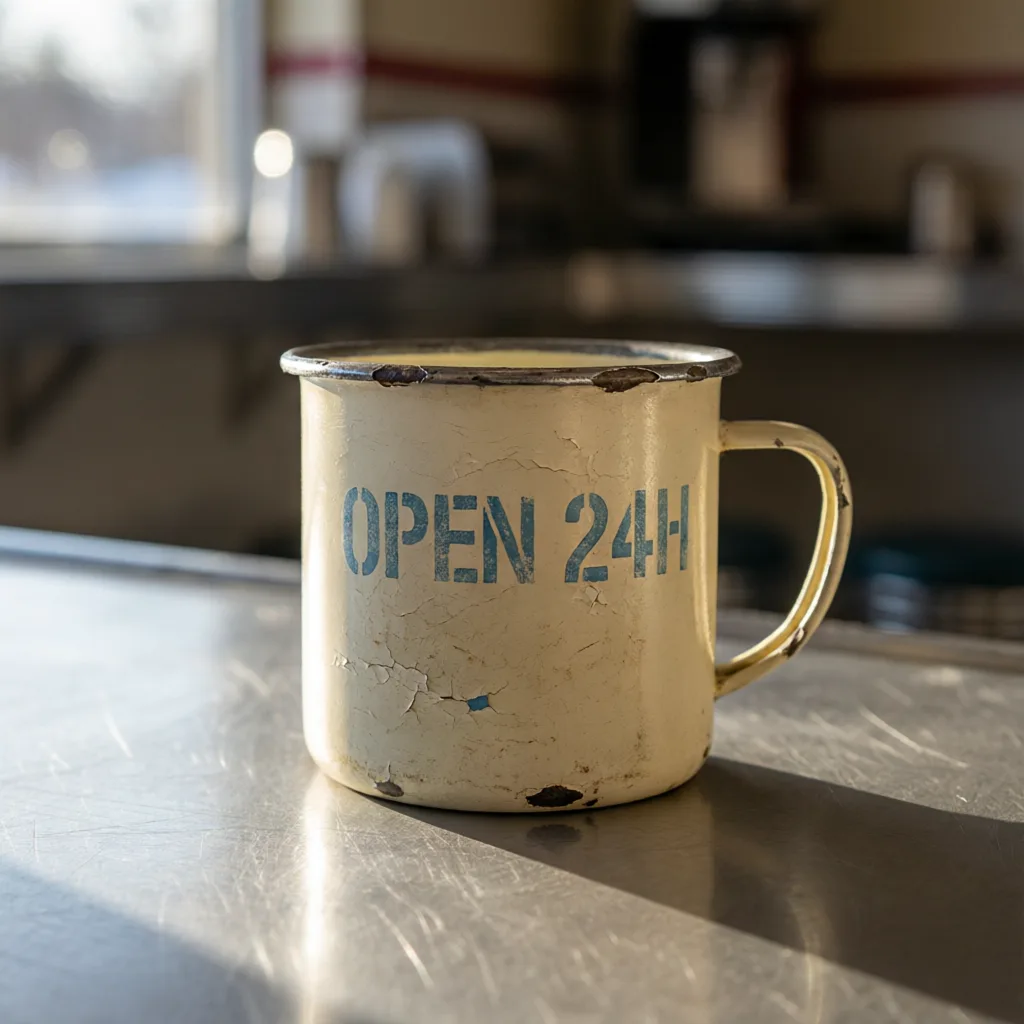
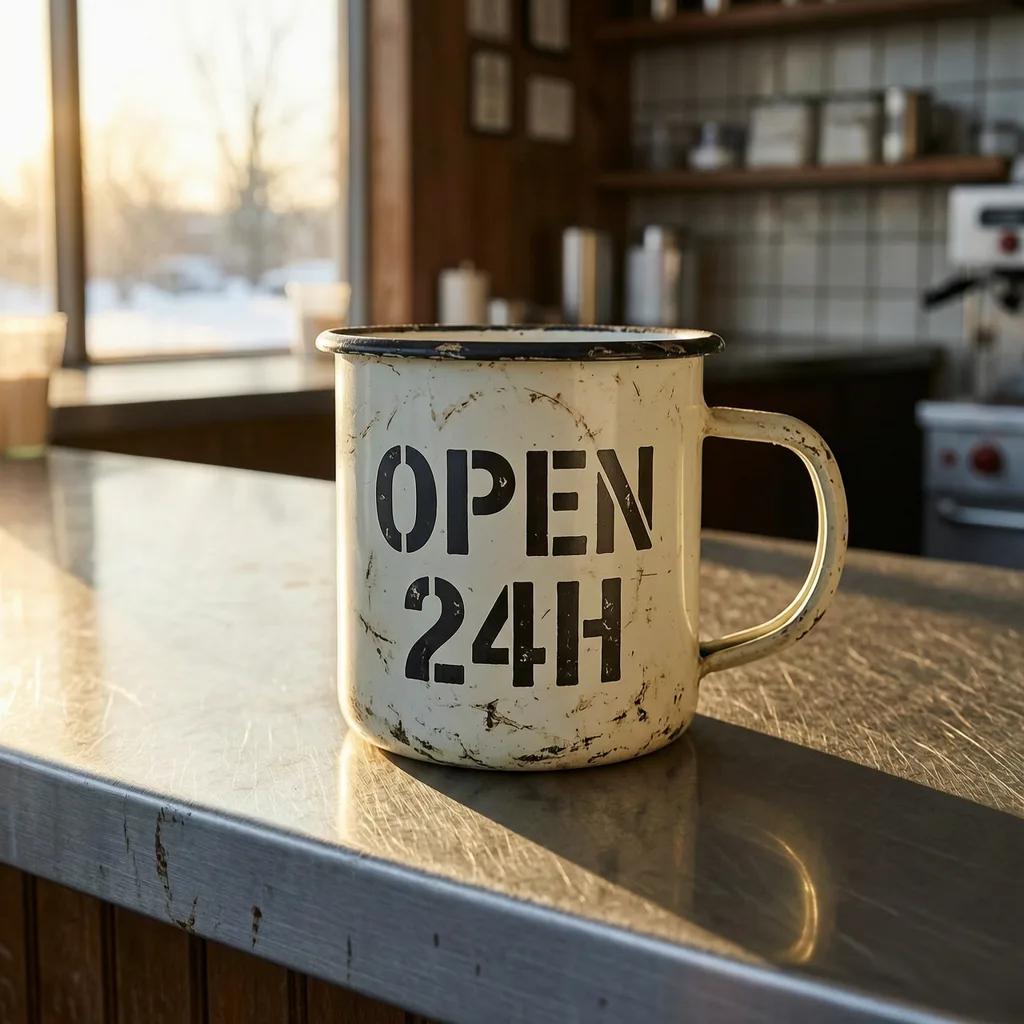
Un prompt, une requête par modèle, sans nouvel essai ni tri des résultats : c'est le premier résultat renvoyé par chaque modèle. Ni la taille ni la durée n'ont été imposées. Chaque modèle a utilisé sa valeur par défaut, car une requête calibrée pour convenir à tous n'en mettrait aucun en valeur. Les fichiers sont réencodés pour le web : jugez la composition et le respect du prompt, pas la compression.
Passez de l'un à l'autre en changeant une seule ligne
Les deux identifiants figurent dans chaque onglet ci-dessous : les deux lignes surlignées sont le seul changement. Même endpoint, même clé, même format de requête.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="qwen-image-2.0-pro",
    # model="wan2.7-image-pro",  # décommentez cette ligne, commentez celle du dessus
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "qwen-image-2.0-pro",
// model: "wan2.7-image-pro", // décommentez cette ligne, commentez celle du dessus
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "qwen-image-2.0-pro",
# "model": "wan2.7-image-pro", # décommentez cette ligne, commentez celle du dessus
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "qwen-image-2.0-pro",
// Model: "wan2.7-image-pro", // décommentez cette ligne, commentez celle du dessus
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("qwen-image-2.0-pro")
// .model("wan2.7-image-pro") // décommentez cette ligne, commentez celle du dessus
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Lequel est le moins cher, qwen-image-2.0-pro ou wan2.7-image-pro ?
Les deux affichent le même prix sur la ligne « Par image générée » ($0.075) : ce n'est donc pas le prix qui les départage ici. Voyez les spécifications et les capacités ci-dessous.
Puis-je faire un test A/B entre qwen-image-2.0-pro et wan2.7-image-pro sans deux intégrations ?
Oui. Les deux passent par le même endpoint compatible OpenAI, avec une seule clé API. Pour passer de l'un à l'autre, il suffit de changer l'identifiant du modèle, soit une ligne : vous pouvez donc envoyer une part du trafic à chacun et comparer directement les factures.
Le prix change-t-il avec la taille de l'image ?
Cela dépend du mode de facturation du modèle. Un modèle facturé à l'image coûte le même prix quelle que soit la taille du prompt ou de la sortie. Un modèle facturé au token coûte plus cher à mesure que la résolution générée augmente : une image 4K revient à plusieurs fois le prix d'une petite. Le tableau ci-dessus indique le cas de chacun.