
GPT Image 2 vs wan2.7-image-pro
Lequel choisir, et quand
gpt-image-2 et wan2.7-image-pro acceptent tous deux du texte plus une image en entrée et renvoient des images, la vraie différence réside donc dans leur mode de facturation : gpt-image-2 compte les tokens à $5 par million en entrée et $30 par million en sortie, tandis que wan2.7-image-pro est à un tarif fixe de $0.075 par appel. Ceux-ci facturent dans des unités différentes, aucune conversion unique n'est donc honnête - choisissez gpt-image-2 si vos prompts et sorties sont suffisamment petits pour que la facturation par token reste bon marché, et wan2.7-image-pro si vous voulez un prix prévisible par génération indépendamment de la taille du prompt. Aucun des deux ne publie de fenêtre de contexte, budgétez donc selon le modèle de facturation plutôt que selon la marge de tokens.
Tarifs
| GPT Image 2 | wan2.7-image-pro | Δ | |
|---|---|---|---|
| Par image générée | - | $0.075 | - |
| Entrée / 1M de tokens | $5 | - | - |
| Sortie / 1M de tokens | $30 | - | - |
Ces deux modèles ne sont pas facturés dans la même unité : aucun Δ n'est donc affiché, car les convertir supposerait une hypothèse que nous n'avons pas mesurée. Chaque grille tarifaire figure ci-dessus dans sa propre unité.
Spécifications
| GPT Image 2 | wan2.7-image-pro | |
|---|---|---|
| Modalités d'entrée | texte image | texte image |
| Modalités de sortie | image | image |
| Date de sortie | 2026-04-21 | 2026-04-01 |
| Tailles de sortie |
|
|
| Modes d'entrée | text-to-image, image edit with mask inpainting | text-to-image, image editing (incl. bounding-box interactive edit), 0-9 reference images, text/image-to-image-set |
| Images par requête | 10 | 12 |
| Formats | png, jpeg, webp | png |
| Notes | Flexible resolutions: edges up to 3840px in multiples of 16, ratio <=3:1, ~0.65-8.3MP total (incl. 4K 3840x2160) editing with mask inpainting all image inputs processed at high fidelity significantly improved text rendering (precise placement can still struggle) | 4K text-to-image (max 4096x4096; editing max 2K), aspect ratios 1:8-8:1 instruction + click-to-edit editing character-consistent sets up to 12 images print-quality text rendering incl. formulas/tables |
Les spécifications sont reprises de la documentation de chaque fournisseur ; quand un fournisseur ne publie pas une valeur, la ligne est omise et non déduite. Sources complètes : GPT Image 2 · wan2.7-image-pro
Un prompt, deux modèles, mesurés via la passerelle
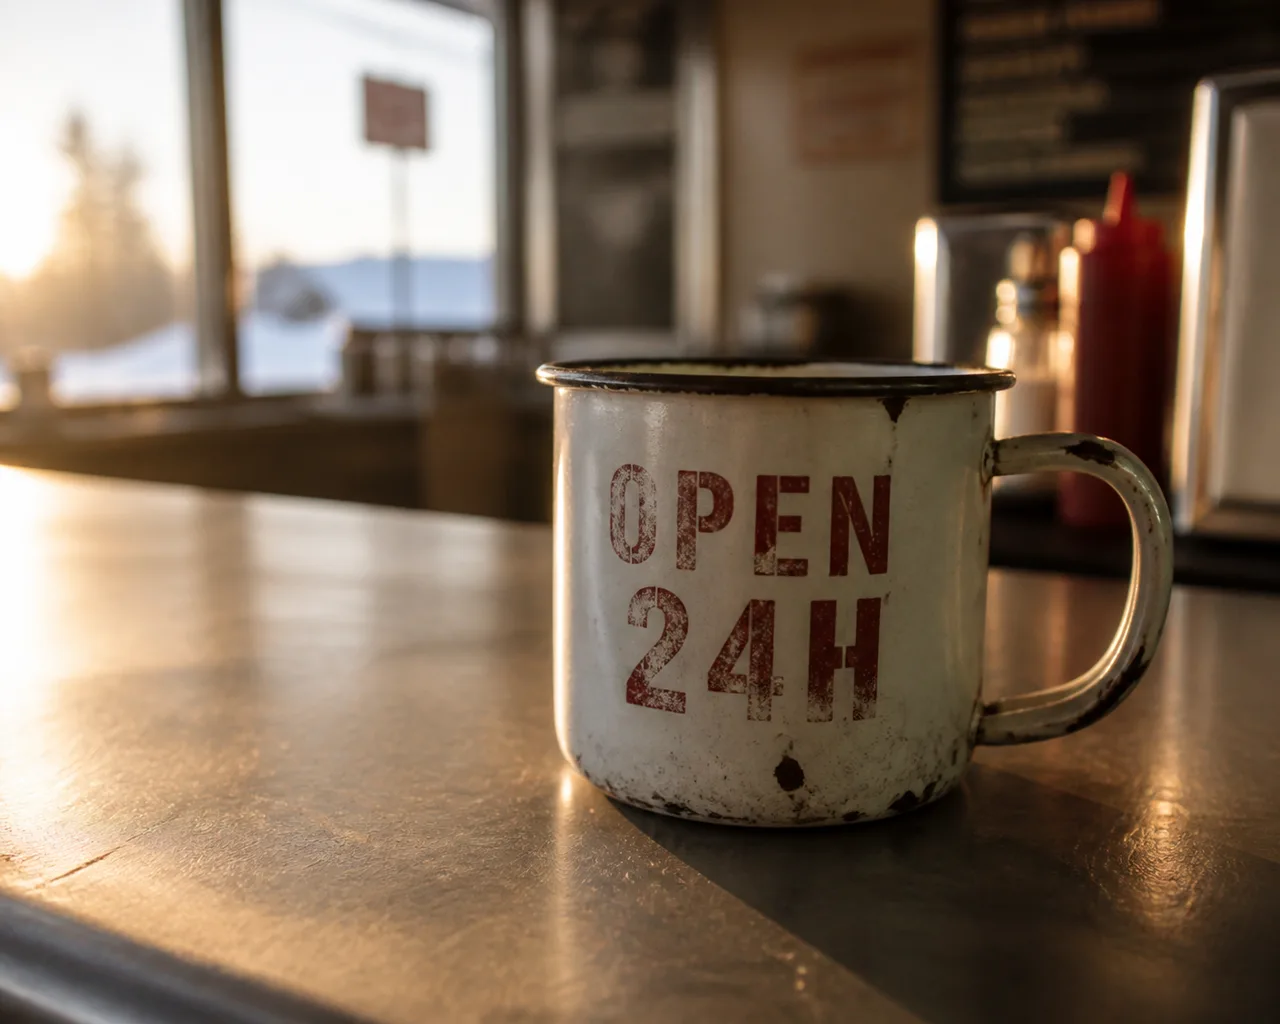
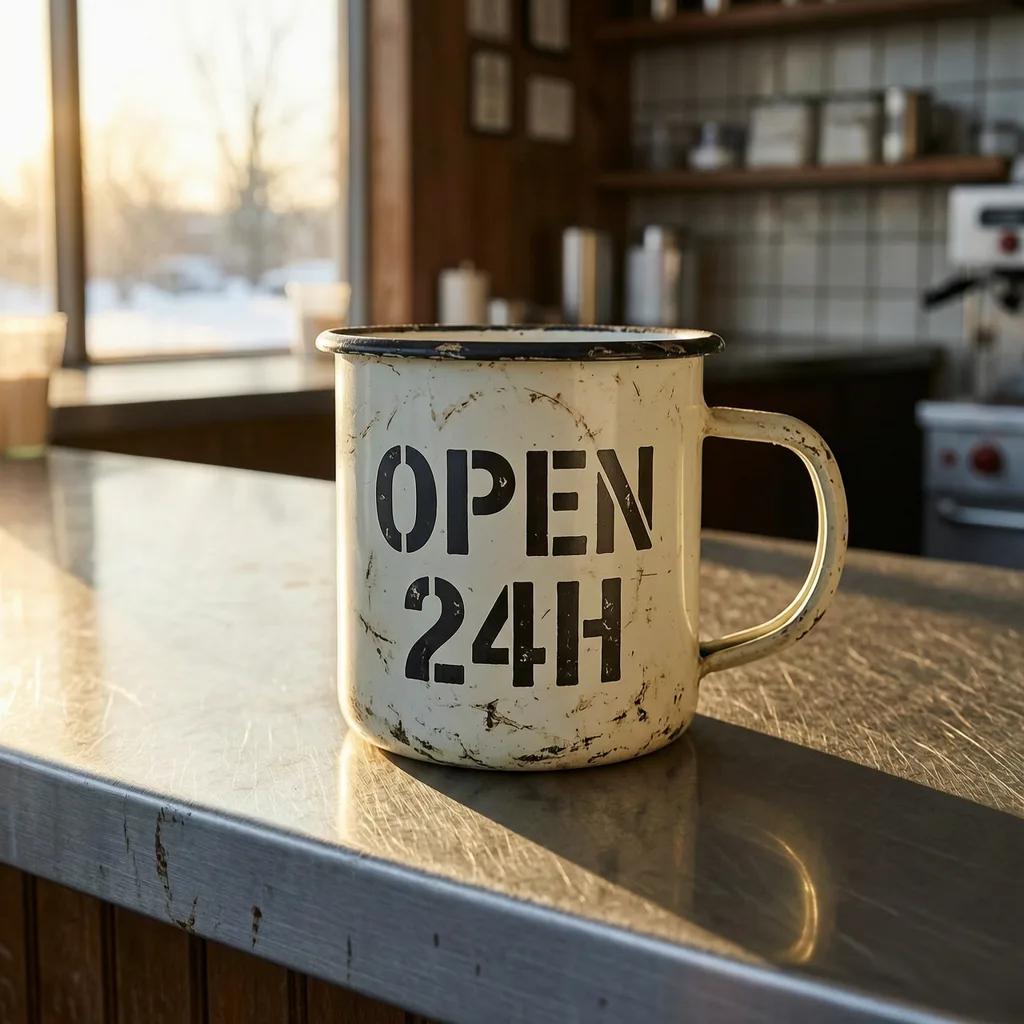
Un prompt, une requête par modèle, sans nouvel essai ni tri des résultats : c'est le premier résultat renvoyé par chaque modèle. Ni la taille ni la durée n'ont été imposées. Chaque modèle a utilisé sa valeur par défaut, car une requête calibrée pour convenir à tous n'en mettrait aucun en valeur. Les fichiers sont réencodés pour le web : jugez la composition et le respect du prompt, pas la compression.
Passez de l'un à l'autre en changeant une seule ligne
Les deux identifiants figurent dans chaque onglet ci-dessous : les deux lignes surlignées sont le seul changement. Même endpoint, même clé, même format de requête.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gpt-image-2",
    # model="wan2.7-image-pro",  # décommentez cette ligne, commentez celle du dessus
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gpt-image-2",
// model: "wan2.7-image-pro", // décommentez cette ligne, commentez celle du dessus
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2",
# "model": "wan2.7-image-pro", # décommentez cette ligne, commentez celle du dessus
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gpt-image-2",
// Model: "wan2.7-image-pro", // décommentez cette ligne, commentez celle du dessus
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gpt-image-2")
// .model("wan2.7-image-pro") // décommentez cette ligne, commentez celle du dessus
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Lequel est le moins cher, GPT Image 2 ou wan2.7-image-pro ?
Ils ne sont pas facturés dans la même unité, il n'existe donc pas de chiffre unique qui soit honnête : dans le tableau ci-dessus, GPT Image 2 et wan2.7-image-pro apparaissent chacun dans sa propre unité. Comparez-les sur votre charge de travail réelle. Le verdict en haut de cette page décrit le compromis en pratique.
Puis-je faire un test A/B entre GPT Image 2 et wan2.7-image-pro sans deux intégrations ?
Oui. Les deux passent par le même endpoint compatible OpenAI, avec une seule clé API. Pour passer de l'un à l'autre, il suffit de changer l'identifiant du modèle, soit une ligne : vous pouvez donc envoyer une part du trafic à chacun et comparer directement les factures.
Le prix change-t-il avec la taille de l'image ?
Cela dépend du mode de facturation du modèle. Un modèle facturé à l'image coûte le même prix quelle que soit la taille du prompt ou de la sortie. Un modèle facturé au token coûte plus cher à mesure que la résolution générée augmente : une image 4K revient à plusieurs fois le prix d'une petite. Le tableau ci-dessus indique le cas de chacun.