
Gemini BYOK ne désactive pas le stockage des requêtes Google
Sommaire
- Quel est le lien entre BYOK, Vertex et la Developer API ?
- Où configurer BYOK et le stockage des requêtes ?
- Qu’est-ce qui a changé dans le stockage des requêtes Gemini ?
- Un endpoint Custom peut-il appeler la Gemini Developer API ?
- store=false fonctionne-t-il sur la Developer API native ?
- Qu’ont vérifié les tests locaux ?
- Le repli peut-il modifier le traitement des données du projet ?
- Que vérifier avant la mise en production ?
- FAQ
- Gemini BYOK désactive-t-il la journalisation des requêtes ?
- Faut-il configurer BYOK dans les paramètres des requêtes d’inférence ?
- store=false signifie-t-il une conservation nulle des données ?
- Désactiver le repli garantit-il que toutes les requêtes restent dans mon projet ?
Gemini BYOK (bring your own key) permet de choisir les identifiants du client ; il ne désactive pas le stockage des requêtes. Pour le circuit testé ici, configurez BYOK dans la console Synthorai et la politique de stockage dans le projet Google associé. Nous avons constaté que l’API compatible Chat de Google rejetait store=false à la racine de la requête. Lors de la conversion d’une requête Gemini native au format Chat, ce champ était omis.
TL;DR
- Gemini est une famille de modèles. Gemini Developer API et Vertex AI sont deux services Google distincts qui permettent d’appeler ces modèles.
- L’entrée Google BYOK standard de Synthorai cible Vertex ; un endpoint Custom configuré séparément peut cibler l’interface compatible Chat de la Developer API.
- Configurez les identifiants et le repli de la passerelle dans la console Synthorai ; configurez la journalisation du projet Developer API dans Google AI Studio.
- Sur six tests synchrones via la passerelle, les booléens de stockage explicites au format Chat ont entraîné des réponses 400. La conversion du format natif vers Chat a omis ces booléens, et les requêtes ayant abouti sont apparues dans les journaux AI Studio.
Quel est le lien entre BYOK, Vertex et la Developer API ?
BYOK indique à qui appartiennent les identifiants utilisés par la passerelle. Vertex AI et Gemini Developer API désignent le service Google qui reçoit la requête. La présence de Gemini dans le nom d’un modèle ne permet d’identifier ni le service ni sa politique de stockage.
| Service Google | Hôte de l’API Google | Configuration Synthorai | Paramètres de stockage à vérifier |
|---|---|---|---|
| Gemini sur Vertex AI | aiplatform.googleapis.com, y compris les hôtes régionaux | Entrée Google BYOK standard, libellée Vertex, avec un identifiant autorisé pour Vertex | Paramètres de journalisation et de conservation propres au service dans le projet Google Cloud sélectionné |
| Gemini Developer API | generativelanguage.googleapis.com | Endpoint Custom distinct utilisant l’interface compatible OpenAI de Google et une clé Developer API | Journalisation du projet dans AI Studio ; options par requête prises en charge par l’interface API réellement utilisée |
Un endpoint Custom est une configuration de la passerelle, pas un troisième service Google. Il définit l’URL de destination, le format d’API, la clé du client et la liste des modèles. L’interface compatible Chat de Google est l’une des interfaces de la Developer API ; son interface native GenerateContent utilise un autre format de requête.
L’entrée BYOK Vertex standard ne propose pas de champ dédié à une clé Gemini Developer API. Un compte de service Google Cloud, couramment utilisé pour Vertex, est une identité applicative dotée d’autorisations sur le projet. Une clé Developer API correspond à une autre configuration de service. Utilisez des identifiants autorisés pour la destination choisie.
Les expériences ci-dessous ciblent la Developer API. Pour Vertex, consultez les paramètres de conservation propres au service de Google ; le changement de journalisation de la Developer API ne permet pas de déduire le comportement de Vertex.
Où configurer BYOK et le stockage des requêtes ?
Configurez les identifiants du client dans la console Synthorai, puis vérifiez le stockage dans la console du service Google sélectionné. Ces paramètres agissent sur des parties différentes du parcours de la requête.
| Où | Éléments à configurer |
|---|---|
| Console Synthorai, BYOK | Identifiant du client ou endpoint Custom, modèles concernés, état d’activation et politique de repli |
| Google AI Studio, projet Developer API | Stockage des requêtes GenerateContent et conservation des journaux |
| Google Cloud, projet Vertex | Paramètres de journalisation et de conservation du service concerné |
Suivez le guide BYOK pour configurer la passerelle. Les applications utilisent ensuite leur clé API de passerelle pour les appels d’inférence ordinaires. Renseignez explicitement la liste des modèles d’un endpoint Custom : selon le comportement documenté, une liste vide lui fait prendre en charge tous les modèles. Utilisez les noms de modèles acceptés par cet endpoint, car les alias de la plateforme peuvent différer.
Pour le circuit testé avec un endpoint Custom Developer API, définissez la politique de journalisation applicative au niveau du projet Google. Google documente l’activation et la désactivation de la journalisation du projet dans AI Studio. Si vous la désactivez, vérifiez le résultat avec des requêtes synthétiques avant d’envoyer des prompts sensibles. Nos tests ont porté sur un stockage activé ; nous n’avons pas mesuré le comportement avec ce paramètre désactivé.
Le contrôle par requête reste valable sur l’API native GenerateContent de Google : une valeur store prise en charge y remplace le paramètre du projet. La passerelle ne garantit pas la compatibilité propre à Google de ce paramètre sur le circuit compatible Chat testé ici. Les résultats suivants expliquent pourquoi la configuration côté service est le contrôle recommandé pour cette intégration.
Qu’est-ce qui a changé dans le stockage des requêtes Gemini ?
Les nouveaux projets payants Gemini Developer API stockent désormais les requêtes Generate Content, sauf si l’appelant ou le paramètre du projet désactive ce stockage. Les projets créés avant le 26 octobre conservent leur paramètre existant. Créer une clé dans un ancien projet ne crée pas de nouveau projet et ne permet pas de savoir quel réglage de journalisation par défaut s’applique. Google décrit ce changement dans ses notes de version du 26 octobre.
La propriété store de la requête est prioritaire sur le réglage par défaut du projet. Le guide de journalisation couvre les appels Generate Content synchrones, en streaming et par lots, y compris ceux qui passent par l’interface compatible OpenAI de Google. Les journaux stockés dans le projet sont conservés 55 jours par défaut ; les durées configurables sont de 7, 14, 28 ou 55 jours. Enregistrer un journal dans un jeu de données modifie ce cycle de vie.
Le stockage des requêtes est également distinct de l’utilisation pour l’entraînement et de la journalisation de sécurité. Les conditions des services payants de Google indiquent que les prompts et réponses payants ne servent pas à améliorer ses produits, tout en prévoyant une conservation limitée à des fins de sûreté et de sécurité. Désactiver le journal applicatif ne traite qu’un mécanisme de stockage précis.
Un endpoint Custom peut-il appeler la Gemini Developer API ?
Le circuit isolé d’un endpoint Custom Synthorai a appelé Gemini 3.5 Flash-Lite avec succès via l’endpoint compatible Chat de Google lorsque store était omis. Google a renvoyé HTTP 200 et OK, et la passerelle a renvoyé HTTP 200 au client. Avec store=true ou store=false explicitement placé à la racine, Google a renvoyé HTTP 400, signalant une requête invalide.
L’environnement de test isolé utilisait les valeurs de configuration suivantes pour l’endpoint Custom :
| Paramètre | Valeur |
|---|---|
| Type d’API de l’endpoint | OpenAI Chat Completions (openai_chat) |
| URL de base Google | https://generativelanguage.googleapis.com/v1beta/openai |
| Identifiant | Clé Gemini Developer API existante, envoyée avec une authentification Bearer |
| Liste des modèles | gemini-3.5-flash-lite uniquement |
| Repli vers la plateforme | Désactivé |
L’enregistreur a confirmé que les requêtes clientes au format Chat conservaient chaque booléen explicite dans le JSON sortant. Google renvoyait l’erreur Invalid JSON payload received. Unknown name "store": Cannot find field. Ce résultat concerne le champ à la racine du format Chat ; il ne prouve pas que toutes les extensions propres à Google sont incompatibles.
La matrice synchrone finale montre l’effet du format de requête client sur la transmission :
| Format de requête client | store en entrée | store dans le Chat sortant | HTTP Google / client | Journal AI Studio |
|---|---|---|---|---|
| Chat | true | true | 400 / 400 | Aucune réponse générée |
| Chat | false | false | 400 / 400 | Aucune réponse générée |
| Chat | Omis | Omis | 200 / 200 | Visible |
| Gemini natif | true | Omis | 200 / 200 | Visible |
| Gemini natif | false | Omis | 200 / 200 | Visible |
| Gemini natif | Omis | Omis | 200 / 200 | Visible |
Chaque ligne correspond à une requête synthétique envoyée au même modèle dans le même projet payant. Après les appels, la liste non filtrée « All datasets » d’AI Studio affichait les marqueurs exacts des quatre cas ayant abouti, dont le cas au format natif avec store=false. Le stockage GenerateContent du projet était activé. La conversion du format natif vers Chat a supprimé ce champ : la requête est donc arrivée chez Google sans la désactivation demandée et est apparue dans le journal applicatif.
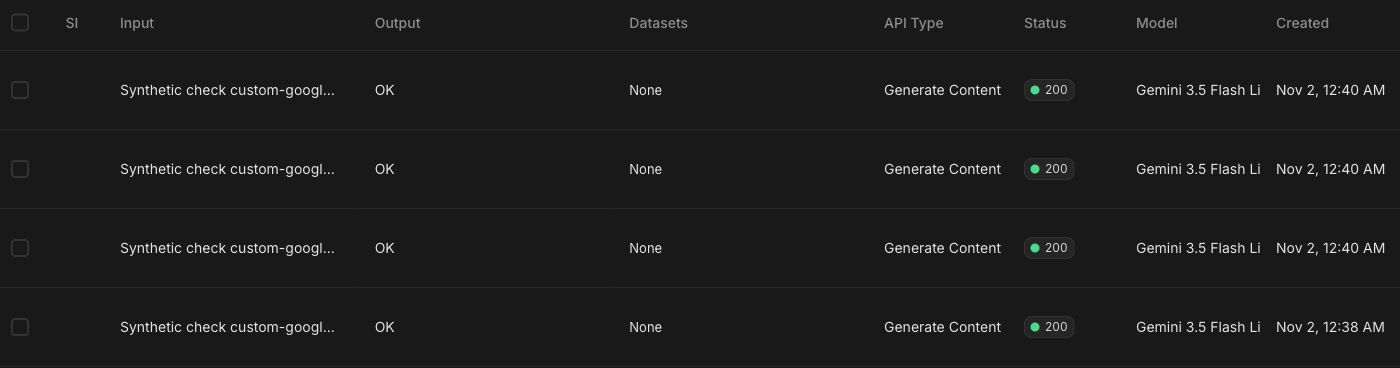
Les cellules d’entrée sont tronquées dans la capture ; nous avons retrouvé chaque marqueur complet dans la liste en ligne. Ses trois premières lignes correspondent aux requêtes natives avec le champ omis, false et true, suivies de la requête Chat avec le champ omis. Cela confirme la visibilité de ces cas dans le journal applicatif, pas le comportement de tous les mécanismes de conservation de Google.
Nous avons exécuté ces tests le 1 novembre 2026 (UTC), avec un projet payant existant et des prompts synthétiques. L’environnement de passerelle isolé fournissait une identité de test utilisateur/espace de travail et un stockage temporaire chiffré des identifiants. Un enregistreur local transmettait à Google, sans modification et via HTTPS, le corps sortant et l’identifiant Bearer du client. La configuration de la console de production, les contrôles des URL de destination publiques, l’authentification client et le streaming étaient hors du périmètre du test.
store=false fonctionne-t-il sur la Developer API native ?
Les appels directs à GenerateContent natif sur Gemini 3.5 Flash-Lite ont accepté store=true comme store=false. Chacune des deux requêtes a renvoyé HTTP 200, un identifiant de réponse et 32 tokens d’entrée plus 1 token de sortie. Environ 13 minutes plus tard, la liste complète d’AI Studio affichait le marqueur true et la sortie OK ; le marqueur false était absent. Ce test témoin en paire montre pourquoi il faut vérifier séparément les interfaces native et compatible Chat.

Pour les appels REST natifs, store est un booléen à la racine, distinct des paramètres de génération de generationConfig. La référence REST définit cette structure. Cet exemple est une requête témoin envoyée directement à Google, indépendante de la configuration BYOK de la passerelle :
import json
import os
import secrets
import urllib.request

marker = "storage-check-" + secrets.token_hex(8)
body = {
    "contents": [{"role": "user", "parts": [
        {"text": f"Synthetic request {marker}. Reply only OK."}
    ]}],
    "generationConfig": {"maxOutputTokens": 16},
    "store": False,
}
request = urllib.request.Request(
    "https://generativelanguage.googleapis.com/v1beta/"
    "models/gemini-3.5-flash-lite:generateContent",
    data=json.dumps(body).encode(),
    headers={"Content-Type": "application/json",
             "x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    method="POST",
)
with urllib.request.urlopen(request, timeout=30) as response:
    result = json.load(response)
print({"marker": marker, "response_id": result.get("responseId"),
       "usage": result.get("usageMetadata")})
Après la requête, recherchez le marqueur dans les journaux du projet autorisé. Utilisez un témoin positif avec true avant d’interpréter l’absence du marqueur false. HTTP 200 confirme que la requête a été acceptée ; l’observation du journal confirme sa visibilité dans le journal applicatif consulté.
Le projet payant avait été créé avant le 26 octobre. Le stockage GenerateContent y était activé, avec une durée de conservation affichée de 55 jours. Nous n’avons modifié aucun de ces deux paramètres. Le détail des journaux individuels ne se chargeait pas dans AI Studio ; nos observations se sont donc appuyées sur les champs prompt, sortie, modèle, statut et horodatage de la liste complète. Ces observations concernent les journaux applicatifs, pas tous les mécanismes de conservation de Google.
Qu’ont vérifié les tests locaux ?
Neuf cas exécutés avec l’enregistreur local couvraient les formats Chat, Responses et Gemini natif, chacun avec store à true, à false ou omis. Chat et Responses conservaient les booléens explicites ; la conversion de Gemini natif vers Chat les omettait. Ces tests utilisaient des identifiants clients synthétiques et des récepteurs locaux, sans appel à Google.
Deux cas supplémentaires utilisaient une réponse HTTP 503 contrôlée de l’endpoint client. Avec le repli désactivé, le client recevait 503 et aucune tentative n’atteignait la plateforme. Avec le repli activé, une tentative vers une simulation de la plateforme renvoyait 200. Cela vérifie un scénario d’échec, pas toutes les conditions de repli ni tous les cas liés au cycle de vie des identifiants.
Le repli peut-il modifier le traitement des données du projet ?
Le repli peut envoyer une requête avec des identifiants associés à d’autres paramètres de projet. Pour une charge de travail qui doit rester dans un projet donné, ce changement doit être pris en compte dans la politique configurée et dans sa vérification.
Le paramètre documenté des endpoints Custom de Synthorai, Repli automatique sur les crédits Synthorai, détermine si la plateforme peut répondre après un échec de cet endpoint. L’implémentation distingue aussi l’échec en amont d’une clé éligible de l’absence ou de l’inéligibilité d’une clé. Ce sont des chemins distincts dans le système.
| Scénario | Points à vérifier |
|---|---|
| Un identifiant client configuré reçoit une erreur en amont | Si le repli autorisé reste dans l’ensemble approuvé d’identifiants et de services |
| La clé est supprimée ou désactivée | Où va la requête suivante ; le guide BYOK documente un repli sur des identifiants partagés après la suppression d’une clé |
| Le modèle ne figure pas dans le filtre de modèles de la clé | Si l’appel est rejeté ou utilise un autre identifiant |
| La résolution des identifiants est indisponible | Si le système refuse l’appel ou applique son mécanisme de repli pour préserver la disponibilité |
| La requête indique explicitement un second modèle | Si ce modèle dispose d’un identifiant et d’un service approuvés séparément |
Pour une charge de travail qui doit rester dans un seul projet, vérifiez que l’appel est rejeté dès qu’aucun identifiant et service approuvés ne sont disponibles. Désactiver uniquement le repli après échec en amont ne garantit pas ce comportement pour toutes les lignes du tableau.
Que vérifier avant la mise en production ?
Pour les outils de développement dont les prompts peuvent apparaître dans les journaux AI Studio, le circuit testé avec un endpoint Custom Developer API a exécuté les requêtes lorsque store était omis. Configurez ses identifiants, sa liste de modèles et sa politique de repli dans la console de la passerelle, puis vérifiez le paramètre de journalisation du projet Google associé.
Pour les charges de travail qui exigent la désactivation de la journalisation applicative, le contrôle au niveau du projet documenté par Google est le réglage recommandé pour cette intégration. Vérifiez le comportement après désactivation dans votre projet ; cette configuration ne faisait pas partie de notre expérience. Ne supprimez pas un champ store=false rejeté en supposant que les propriétés de confidentialité de la requête restent identiques.
Pour les charges de travail sensibles ou contraintes à un projet donné, vérifiez aussi à qui appartiennent les identifiants et toutes les destinations de repli. Examinez également la conservation à des fins de sécurité, les caches et la journalisation cloud. Vertex nécessite un examen distinct de ses propres paramètres. La configuration BYOK seule ne garantit pas ces conditions.
Consignez un marqueur synthétique, le projet/service de destination, le champ de stockage final et l’identifiant de réponse du fournisseur lorsqu’il est disponible. Rapprochez ces éléments des journaux du fournisseur. Une étiquette de facturation BYOK finale ne permet pas d’établir la destination de chaque tentative précédente.
Pour l’ensemble de la chaîne de traitement, consultez la conservation des données LLM et la ZDR. Pour corréler les requêtes, consultez les traces et les sessions.
FAQ
Gemini BYOK désactive-t-il la journalisation des requêtes ?
Gemini BYOK se configure dans la console de la passerelle pour choisir les identifiants du client. La journalisation reste régie par les paramètres du projet du service réellement utilisé et par les options par requête prises en charge. Vérifiez le service de destination et sa configuration de journalisation.
Faut-il configurer BYOK dans les paramètres des requêtes d’inférence ?
Configurez Synthorai BYOK dans la console, puis envoyez des appels d’inférence ordinaires avec la clé API de la passerelle. L’entrée Google standard du coffre d’identifiants cible Vertex ; les endpoints Custom Developer API se configurent séparément. Ni une clé Google ni store=false dans le corps d’une requête d’inférence ne remplacent cette configuration. Configurez séparément le stockage des requêtes dans le projet Google réellement utilisé.
store=false signifie-t-il une conservation nulle des données ?
Le paramètre natif Gemini store=false contrôle le stockage applicatif des requêtes. La conservation à des fins de sécurité chez le fournisseur, la mise en cache et les autres états suivent des règles distinctes. Ce champ seul ne garantit donc pas une conservation nulle des données sur l’ensemble du parcours de la requête.
Désactiver le repli garantit-il que toutes les requêtes restent dans mon projet ?
Le commutateur de repli après échec en amont ne couvre qu’une partie de la décision. Les identifiants absents ou inéligibles et les chaînes de modèles explicites nécessitent des vérifications distinctes. Exigez de constater un rejet chaque fois qu’une charge de travail contrainte à un projet ne dispose d’aucun identifiant et service approuvés.