
Jev face aux LLM flash : 7x moins cher, même coût par label
Sommaire
- Qu’est-ce que Jev, et en quoi diffère-t-il d’un LLM ?
- Comment avons-nous procédé ?
- Quand Jev coûte-t-il moins cher qu’un LLM flash ?
- Jev est-il vraiment plus rapide ?
- Ces résultats confirment-ils les chiffres de TypeSafe ?
- Jev est-il aussi précis qu’un LLM flash ?
- Peut-on se fier au niveau de confiance de Jev ?
- Faut-il choisir Jev ou un LLM flash ?
- FAQ
Le coût de Jev de TypeSafe face à un LLM flash dépend de la tâche. Pour 12 questions sur chaque transcription du support, Jev a coûté 7 fois moins cher que GPT-5.6 Luna sans raisonnement, avec un temps de traitement hors réseau de 0.12 seconde contre 1.66. Pour attribuer un seul label parmi 77, son coût était identique à celui de Qwen3.8 Flash et de GLM 5.3 Flash. Jev est un modèle de décision : au lieu de générer du texte, il renvoie un choix, un score ou une probabilité pour chaque question définie. Nous l’avons comparé à cinq modèles de chat flash, avec leurs réglages de raisonnement les moins chers puis ceux par défaut, sur quatre tests issus de jeux de données publics. Jev a été le modèle le plus rapide sur tous les tests, mais jamais le plus précis.
TL;DR
- Avec 12 questions par cas, les LLM flash ont coûté 4.8 à 37 fois plus cher que Jev et pris 11 à 27 fois plus de temps, pour une précision comparable.
- Pour un label par message, Jev a coûté autant que Qwen3.8 Flash et GLM 5.3 Flash sans raisonnement.
- Avec le réglage de raisonnement par défaut, un label a coûté 1.5 à 26 fois plus cher sur les modèles flash que sur Jev.
- GPT-5.6 Luna a été plus précis que Jev sur tous les tests sauf celui d’injection de prompt.
- Les réponses de Jev avec une probabilité d’au moins 0.99 étaient correctes à 98%.
Qu’est-ce que Jev, et en quoi diffère-t-il d’un LLM ?
Jev est le modèle « System One » de TypeSafe. Il lit un texte ou un objet JSON appelé « state », puis répond à des questions typées, sans générer de texte à parser. Trois types de questions sont disponibles :
| Type de question | Ce que vous demandez | Ce que vous recevez |
|---|---|---|
| Noul (nom donné par TypeSafe aux questions oui/non) | une question fermée oui/non | une probabilité de 0 à 1 |
| Choice | choisir parmi un maximum de 255 options définies par vos soins | l’option, la probabilité de chaque option et un niveau de confiance |
| Score | évaluer selon 2 à 10 niveaux ordonnés définis par vos soins | un score pondéré par les probabilités et un niveau de confiance |
Chaque question d’une requête porte un nom, et la réponse contient un résultat par nom. Dans le format documenté par TypeSafe (référence de l’API), cet exemple pose trois questions oui/non sur un court échange avec le support :
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {"transcript": "Customer: My card was declined twice today.\nAgent: One moment.\nCustomer: Also, how do I change my PIN?"},
    "questions": {
      "declined_card": {"type": "noul", "instructions": "In `transcript`, does the customer report a declined card payment?"},
      "change_pin":    {"type": "noul", "instructions": "In `transcript`, does the customer want to change a PIN?"},
      "lost_card":     {"type": "noul", "instructions": "In `transcript`, does the customer report a lost or stolen card?"}
    }
  }'
Voici la réponse obtenue lors de notre test :
{
  "model": "jev-1.13.0",
  "answers": {
    "declined_card": {"type": "noul", "noul": 0.99},
    "change_pin":    {"type": "noul", "noul": 0.98},
    "lost_card":     {"type": "noul", "noul": 0.02}
  },
  "usage": {"input_tokens": 359, "output_tokens": 56}
}
Votre code lit answers.<question>.noul et compare cette valeur à un seuil, comme n’importe quel nombre. Le champ model indique la version qui a répondu. L’alias jev-latest change quand TypeSafe publie une nouvelle version. Si vous réglez vos seuils pour une version donnée, verrouillez donc jev-1.13.0.
TypeSafe évalue les questions en parallèle. Jev 1.13 coûte $0.042 par million de tokens en entrée, et la sortie est gratuite (modèles). Le token d’entrée coûte donc 3.6 fois moins cher que sur Qwen3.8 Flash, 4.8 fois moins que sur GPT-5.6 Luna et 18 fois moins que sur Gemini 3.8 Flash. L’entrée comprend le template de TypeSafe, soit environ 300 tokens par appel, ainsi que toutes les questions et options définies. L’appel ci-dessus a facturé 359 tokens en entrée, soit $0.000015, tandis que ses 56 tokens de sortie étaient gratuits. TypeSafe recense les faiblesses de Jev dans ses notes sur les irrégularités du modèle : comptage, calcul, comparaison de dates, questions en plusieurs étapes et longs états remplis de texte non pertinent.
Comment avons-nous procédé ?
Nous avons exécuté quatre tests, une fois les 2026-09-21 et 2026-09-22, avec Jev et cinq modèles de chat flash : GPT-5.6 Luna, Qwen3.8 Flash, GLM 5.3 Flash, DeepSeek V4.1 Flash et Gemini 3.8 Flash. Chaque modèle de chat a tourné avec son réglage de raisonnement fonctionnel le moins cher, désactivé ou faible lorsque la désactivation n’était pas acceptée. Sur les trois tests de classification, nous l’avons aussi exécuté avec le réglage par défaut du fournisseur.
- 12 questions par cas : 150 transcriptions du support client, chacune composée d’un à six messages du jeu de données Banking77 (PolyAI, CC BY 4.0), ce qui permet de connaître les bonnes réponses. Chaque modèle répond à 12 questions oui/non par transcription (« le client signale-t-il une carte perdue ou volée ? »), avec une probabilité pour chacune. Jev reçoit 12 questions Noul en un seul appel, tandis que les modèles de chat produisent un objet JSON. Nous avons relancé 60 cas en ajoutant devant la transcription un document de référence de 3,000 puis de 12,000 tokens, constitué d’articles Wikipédia sur la banque.
- Un label : 308 messages de Banking77, soit 4 pour chacune des 77 intentions. Jev reçoit une question Choice avec 77 options. Les modèles de chat reçoivent la même liste et renvoient l’intention.
- 28 labels : 200 commentaires de GoEmotions (Google, Apache 2.0), avec 28 émotions possibles pour chacun.
- Injection de prompt : les 116 lignes du jeu de test deepset sur les injections de prompt (Apache 2.0), avec une question oui/non par ligne.
Le coût correspond au tarif public de chaque fournisseur multiplié par les tokens facturés. Pour la latence, nous avons réalisé séparément 40 appels par modèle sur une connexion maintenue ouverte, puis soustrait l’aller-retour réseau. La section sur les performances détaille la méthode. Nous avons également testé GPT-5.6 Terra et Seed 2.0 Mini sur les trois tests de classification. Ils figurent dans les tableaux, mais pas dans le graphique.
Quand Jev coûte-t-il moins cher qu’un LLM flash ?
Quand un même texte fait l’objet de nombreuses questions, quand le texte est long ou quand le modèle de chat utiliserait autrement le raisonnement. Pour attribuer un seul label à un texte court face à un modèle bon marché sans raisonnement, Jev coûte autant.
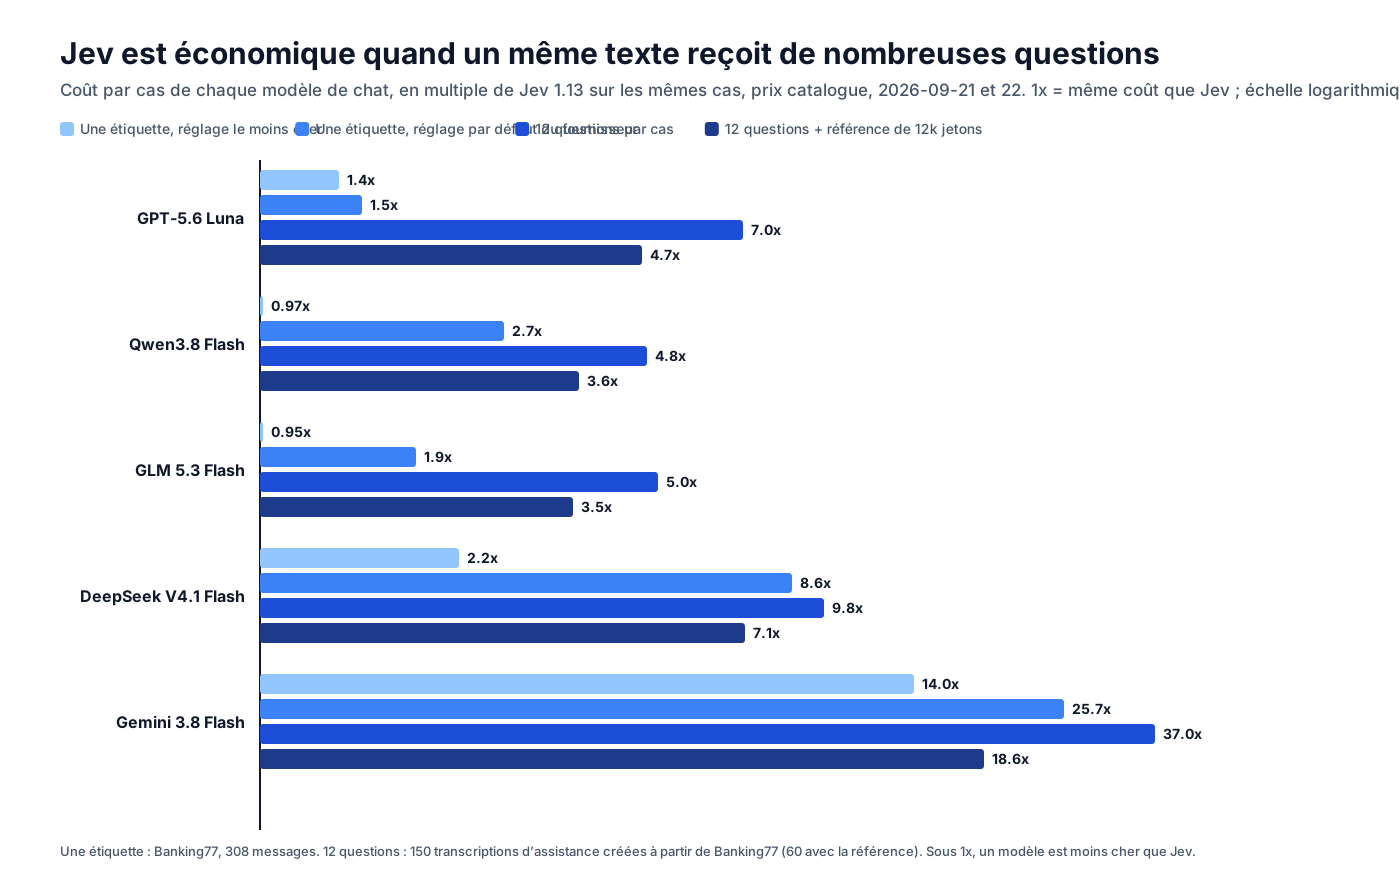
Trois facteurs font varier ce multiple. Le premier est le nombre de questions. Un modèle de chat doit générer une réponse pour chacune, et la sortie est la partie coûteuse. GPT-5.6 Luna facture $1.20 par million de tokens en sortie, contre $0.20 en entrée. Avec Jev, les réponses sont gratuites et chaque question supplémentaire ajoute environ 17 tokens en entrée. Le deuxième facteur est le raisonnement. Avec les réglages par défaut des fournisseurs, les modèles de chat ont généré une médiane allant jusqu’à 161 tokens en sortie par label, contre 3 à 8 sans raisonnement. Leur coût relatif face à Jev a augmenté en conséquence. Le troisième facteur est la longueur de l’entrée. Avec une référence de 12,000 tokens, le template fixe et les réponses pèsent peu. Le multiple se rapproche alors du ratio des prix en entrée : 3.5 fois pour GLM 5.3 Flash, jusqu’à 18.6 fois pour Gemini 3.8 Flash, avec DeepSeek V4.1 Flash à 7.1 fois.
Le test avec un seul label est le cas où Jev n’apporte aucune économie face aux modèles les moins chers. Les 77 options ajoutent environ 1,400 tokens à chaque appel. Un message d’une ligne facture donc environ 1,690 tokens en entrée avec Jev, contre 440 avec Qwen3.8 Flash.
| Test, coût pour 1,000 cas | Jev | Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| 12 questions par cas | $0.027 | $0.19 | $0.13 | $0.14 | $0.27 | $1.02 |
| 12 questions, référence de 12,000 tokens | $0.43 | $2.02 | $1.57 | $1.53 | $3.06 | $8.06 |
| Un label, réglage le moins cher | $0.071 | $0.098 | $0.069 | $0.068 | $0.16 | $0.99 |
| Un label, réglage par défaut du fournisseur | $0.071 | $0.11 | $0.19 | $0.13 | $0.61 | $1.83 |
Jev est-il vraiment plus rapide ?
Environ 7 à 28 fois après retrait du temps réseau. La médiane de Jev se situait entre 0.11 et 0.12 seconde, contre 0.79 à 3.25 secondes pour les modèles de chat.
Nous avons chronométré 40 appels par modèle et par tâche, un à la fois sur une connexion maintenue ouverte, puis soustrait l’aller-retour mesuré sur cette même connexion avec une requête qui ne fait aucun calcul de modèle. Il reste le temps du modèle lui-même et le trajet de notre proxy vers son fournisseur, identique pour tous les modèles.
| Secondes hors réseau, médiane (95e percentile) | Jev | GPT-5.6 Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Un label, réglage le moins cher | 0.11 (0.21) | 1.33 (1.80) | 0.96 (1.68) | 1.22 (3.06) | 0.79 (1.35) | 1.95 (3.76) |
| Un label, réglage par défaut du fournisseur | 0.11 (0.21) | 1.45 (5.29) | 3.25 (21.5) | 2.97 (7.32) | 1.19 (10.4) | 2.18 (8.22) |
| 12 questions par cas | 0.12 (0.20) | 1.66 (2.56) | 3.21 (5.21) | 3.13 (6.20) | 1.33 (1.70) | 2.14 (2.89) |
L’effet du raisonnement apparaît surtout au 95e percentile. Avec les réglages par défaut des fournisseurs, un appel Qwen3.8 Flash sur vingt a pris plus de 21 secondes pour attribuer un seul label. Les appels les plus lents de Jev sont restés proches de 0.2 seconde.
Ajouter des questions n’a pas ralenti Jev : pour un même ticket de support, passer de 1 à 60 questions oui/non a déplacé la médiane de moins de 0.1 seconde, et l’appel à 60 questions a facturé 1,371 tokens en entrée, soit $0.000058. Sur les appels à 20 questions, toutes les réponses étaient justes lors des cinq exécutions.
Ces résultats confirment-ils les chiffres de TypeSafe ?
Ils vont dans le même sens, mais avec des écarts plus faibles, car les comparaisons ne portent pas sur les mêmes cas. Dans son billet de lancement, TypeSafe annonce jusqu’à 444.6 fois moins cher et 193.6 fois plus rapide. Ces mesures comparent Jev à des modèles frontier avec raisonnement sur des workflows en plusieurs étapes. TypeSafe présente ces chiffres comme « la tranche supérieure des gains réels » (billet de lancement).
Ses évaluations de workflows publiées incluent GPT-5.6 Luna. Jev y atteint 67.8% de précision, pour $0.0004 et 0.4 seconde par cas, contre 66.8%, $0.0033 et 12.9 secondes pour Luna. Jev est donc environ 8 fois moins cher et 32 fois plus rapide. Dans notre test à 12 questions, Luna sans raisonnement a coûté 7 fois plus cher que Jev et pris 14 fois plus de temps hors réseau, soit le même ordre de grandeur. Face aux modèles flash les moins chers sur un seul label, l’écart de coût disparaît.
Jev est-il aussi précis qu’un LLM flash ?
Il est proche sur le test de workflow, en retrait sur les tests de classification et jamais premier. Avec 12 questions par cas, le micro F1 de Jev, calculé sur toutes les réponses oui et non avec 1.0 comme score parfait, se situait dans la plage des modèles de chat. Ses probabilités classaient également les réponses correctes et incorrectes presque aussi bien que les meilleurs modèles.
| 12 questions par cas (150 transcriptions) | Micro F1 au seuil de 0.5 | 12 réponses correctes | AUC |
|---|---|---|---|
| Jev 1.13 | 0.909 | 61.3% | 0.990 |
| GPT-5.6 Luna, raisonnement désactivé | 0.933 | 71.3% | 0.973 |
| GPT-5.6 Luna, réglage par défaut | 0.931 | 71.3% | 0.992 |
| Gemini 3.8 Flash, faible | 0.919 | 66.7% | 0.974 |
| Qwen3.8 Flash, raisonnement désactivé | 0.913 | 62.7% | 0.975 |
| GLM 5.3 Flash, faible | 0.906 | 64.7% | 0.975 |
| DeepSeek V4.1 Flash, raisonnement désactivé | 0.896 | 60.0% | 0.958 |
L’AUC mesure la qualité du classement par probabilité. Un score de 1.0 signifie que chaque vrai « oui » a reçu une probabilité supérieure à tous les « non ». Avec une référence de 12,000 tokens placée avant la transcription, Jev a conservé sa précision : F1 de 0.914, contre 0.922 sur les mêmes 60 transcriptions sans cette référence.
Sur les tests de classification, les modèles de chat ont pris l’avantage, surtout avec leurs réglages de raisonnement par défaut :
| Modèle et réglage | Un label (Banking77) | 28 labels (micro F1 GoEmotions) | Injection de prompt |
|---|---|---|---|
| Jev 1.13 | 80.2% | 0.228 | 74.1% |
| GPT-5.6 Luna, raisonnement désactivé / par défaut | 85.1% / 87.3% | 0.301 / 0.342 | 69.6% / 72.2% |
| GPT-5.6 Terra, raisonnement désactivé / par défaut | 83.4% / 85.4% | 0.273 / 0.324 | 80.9% / 79.1% |
| Gemini 3.8 Flash, faible / par défaut | 84.4% / 83.8% | 0.373 / 0.372 | 81.9% / 82.8% |
| Qwen3.8 Flash, désactivé / par défaut | 77.6% / 81.5% | 0.286 / 0.338 | 81.9% / 80.2% |
| GLM 5.3 Flash, faible / par défaut | 77.9% / 79.9% | 0.255 / 0.310 | 81.9% / 81.9% |
| DeepSeek V4.1 Flash, désactivé / par défaut | 77.3% / 81.8% | 0.289 / 0.365 | 82.8% / 86.2% |
| Seed 2.0 Mini, raisonnement désactivé | 70.8% | 0.245 | 66.4% |
GPT-5.6 Luna et Terra ont répondu à 115 des 116 textes d’injection et à 199 des 200 commentaires. Pour chacun, une requête a renvoyé une erreur, et la précision est calculée uniquement sur les réponses obtenues. Toute réponse autre que oui ou non est comptée comme incorrecte. Pour les émotions, Jev a trop souvent répondu oui. Une émotion évaluée entre 0.80 et 0.95 ne figurait dans le label humain que 15% du temps. Les labels d’émotion sont peu nombreux par commentaire, les annotateurs n’en ayant choisi qu’un ou deux, ce qui réduit le score de tous les modèles. Tous ont toutefois reçu la même instruction. Sur l’injection de prompt, le seuil par défaut de 0.5 était inadapté, comme le montre la section suivante.
Peut-on se fier au niveau de confiance de Jev ?
Ses probabilités séparent bien les bonnes réponses des mauvaises, mais elles ne sont pas calibrées au sens strict. Chaque tâche nécessite donc son propre seuil. Avec un modèle calibré, une probabilité de 0.8 correspond à 80% de réponses correctes. Sur Banking77, Jev avait raison dans 98% des cas à partir de 0.99, et dans environ la moitié des cas sous 0.8.
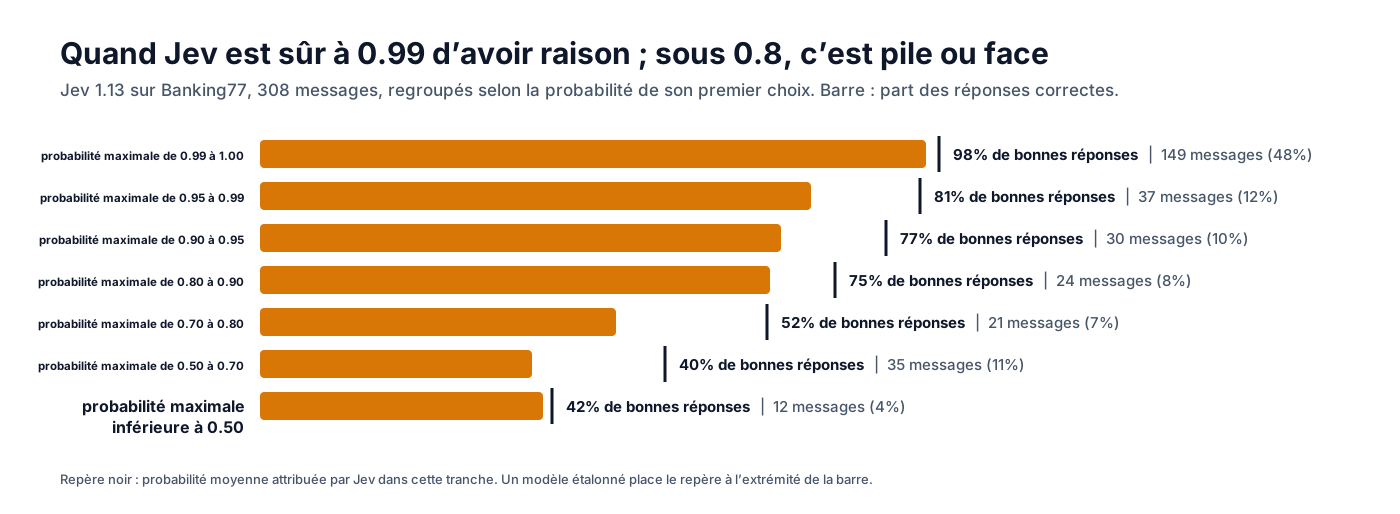
Près de la moitié des messages de Banking77, soit 48%, ont obtenu une probabilité maximale d’au moins 0.99. Un pipeline qui accepte ces réponses et envoie les autres vers un modèle plus puissant conserve donc 98% de précision sur cette part du trafic. Le test d’injection de prompt montre l’autre côté du problème. Avec le seuil par défaut de 0.5, Jev n’a détecté que la moitié des attaques. L’autre moitié a reçu des probabilités comprises entre 0.03 et 0.5. Ces valeurs sont faibles dans l’absolu, mais restent généralement supérieures à celles des textes bénins, dont la médiane était de 0.02. Le classement par probabilité séparait les attaques des textes bénins avec une AUC de 0.984.
| Seuil sur le jeu d’injections | Précision de Jev | Attaques détectées | Faux positifs (sur 56 textes bénins) |
|---|---|---|---|
| 0.5 (par défaut) | 74.1% | 50.0% | 0 |
| 0.1 | 88.8% | 80.0% | 1 |
| 0.05 | 93.1% | 91.7% | 3 |
Ces seuils ont été choisis sur les mêmes 116 textes. Il faut donc les considérer comme une borne haute. Un modèle de chat peut aussi fournir une probabilité lorsque son API renvoie les log-probabilities des tokens, c’est-à-dire la probabilité attribuée par le modèle à chaque token généré. Parmi les modèles de chat testés, Qwen3.8 Flash et Seed 2.0 Mini les ont renvoyées pendant nos essais. La probabilité du token « yes » de Qwen3.8 Flash a classé les textes d’injection avec une AUC de 0.977.
Faut-il choisir Jev ou un LLM flash ?
| Votre tâche | Choix | Résultat de nos tests |
|---|---|---|
| nombreuses questions oui/non ou à choix unique sur un même texte | Jev | 4.8 à 37 fois moins cher, 11 à 27 fois plus rapide hors réseau, précision comparable |
| décision dans une boucle qui doit répondre en moins d’une seconde | Jev | 0.11 à 0.12 s hors réseau |
| documents longs avec quelques évaluations chacun | Jev | le coût se rapproche du ratio des prix en entrée, soit 3.5 à 18.6 fois moins |
| un label par message court au coût minimal | Jev, Qwen3.8 Flash ou GLM 5.3 Flash sans raisonnement | même coût ; les LLM ne renvoient aucune probabilité sans lire les log-probabilities |
| le label le plus précis | GPT-5.6 Luna avec son réglage par défaut | 87.3% sur Banking77 à $0.11 pour 1,000 cas |
| nombres, dates, comptage ou génération de texte | un modèle de chat | TypeSafe les classe parmi les faiblesses de Jev |
La stratégie la plus efficace avec Jev dans nos tests consiste à décomposer la décision en nombreuses questions ciblées sur le même texte, à agir sur les réponses dépassant un seuil réglé avec vos propres données labellisées, puis à envoyer le reste vers un modèle de chat.
FAQ
Qu’est-ce que TypeSafe Jev ?
Jev est un modèle de décision de TypeSafe qui répond à des questions typées, oui/non, choix unique ou évaluation sur une échelle, à propos d’un texte. Il renvoie des probabilités plutôt que du texte généré. Jev 1.13 est la version actuelle, disponible sous l’alias jev-latest, au tarif de $0.042 par million de tokens en entrée, avec une sortie gratuite.
Jev coûte-t-il moins cher qu’un LLM ? Cela dépend de la tâche. Pour 12 questions sur chaque transcription du support, GPT-5.6 Luna sans raisonnement a coûté 7 fois plus cher que Jev, et Gemini 3.8 Flash 37 fois plus cher. Pour attribuer un seul label parmi 77, Qwen3.8 Flash et GLM 5.3 Flash sans raisonnement ont coûté autant que Jev.
Jev est-il plus précis que GPT-5.6 Luna ? Pas dans nos tests. GPT-5.6 Luna sans raisonnement a obtenu un micro F1 de 0.933, contre 0.909 pour Jev, sur 12 questions par cas. Sur Banking77, il a atteint 85.1% contre 80.2%. Avec son seuil par défaut, Jev a toutefois détecté davantage d’injections de prompt que Luna sans raisonnement.
Pourquoi TypeSafe affirme-t-il que Jev est 444 fois moins cher ? Ce chiffre compare Jev à des modèles frontier utilisant le raisonnement sur des workflows en plusieurs étapes. TypeSafe le présente comme une valeur haute. Face aux modèles flash, nous avons mesuré un coût 4.8 à 37 fois inférieur sur un workflow de 12 questions, et presque identique pour un seul label.
Les probabilités de Jev sont-elles calibrées ? Pas au sens strict. Sur Banking77, ses réponses étaient correctes dans 98% des cas avec une probabilité d’au moins 0.99, mais dans environ la moitié des cas sous 0.8. Sur les injections de prompt, il a attribué une probabilité inférieure à 0.5 à la moitié des attaques. Réglez un seuil par tâche à partir de vos propres données labellisées.
À lire aussi : meilleure API de LLM flash en 2026, comparatif des sorties structurées des LLM, réglages du raisonnement des LLM, meilleur LLM selon le cas d’usage.