
PDF : combien de tokens ? 4 fournisseurs, 15 à 2,100 par page
Sommaire
- Comment envoyer un document à un modèle ?
- Comment vérifier que le modèle a vraiment lu le fichier ?
- Comment chaque fournisseur compte-t-il les tokens d’un PDF envoyé comme fichier ?
- Quand le texte extrait ne suffit-il pas ?
- Comment réduire le coût des documents ?
- Que faire d’un fichier Word ?
- Protocole de mesure
- FAQ
- Combien de tokens représente une page de PDF ?
- Est-il moins cher d’envoyer un PDF ou son texte extrait ?
- Un LLM peut-il lire un PDF numérisé ?
- Quels modèles acceptent directement les fichiers PDF ?
- Comment réduire le coût d’un PDF long ?
- À lire aussi
Chaque fournisseur applique sa propre règle de facturation aux PDF envoyés comme fichiers. GPT-6 compte les tokens du texte et ajoute environ 15 tokens par page. Claude compte le texte et ajoute 1,558 tokens par page. Gemini compte 515 tokens par page, sans facturer le texte. Qwen 3.8 ajoute 2,098 tokens par page au texte. Nous avons mesuré ces règles en envoyant les mêmes pages avec de plus en plus de texte. Nous avons ensuite envoyé dix documents à quinze modèles pour trouver, pour chaque type de document, la méthode la moins chère qui conserve des réponses justes.
TL;DR
- Pour chaque page de PDF envoyée comme fichier, GPT-6 ajoute 15 tokens au texte, Claude 1,558 et Qwen 3.8 2,098. Gemini facture un forfait de 515 tokens, sans supplément pour le texte.
- Le texte extrait n’a permis de répondre correctement à aucune des 150 questions sur les graphiques, ni à aucune des 105 questions sur un document numérisé.
- En choisissant le format d’envoi page par page, un document mixte est passé de 17,228 à 6,543 tokens sur Claude Sonnet 5.5, avec 12 réponses justes sur 12.
- Envoyer 4 pages sélectionnées dans un PDF de 120 pages a réduit l’entrée de Claude Sonnet 5.5 de 253,822 à 8,758 tokens.
Comment envoyer un document à un modèle ?
Trois possibilités : envoyer le fichier, des images de ses pages, ou le texte extrait au préalable.
import base64
import pymupdf  # pip install pymupdf

doc = pymupdf.open("report.pdf")
b64 = lambda data: base64.b64encode(data).decode()   # binary written as text, so it fits in JSON

# 1. As a file. The vendor decides how to read it.
as_file = [{"type": "file", "file": {"filename": "report.pdf",                # OpenAI-compatible chat
            "file_data": "data:application/pdf;base64," + b64(open("report.pdf", "rb").read())}}]
as_document = [{"type": "document", "source": {"type": "base64",              # Anthropic Messages API
                "media_type": "application/pdf", "data": b64(open("report.pdf", "rb").read())}}]

# 2. As page images. You render each page; any model that accepts images takes these.
as_images = [{"type": "image_url", "image_url": {"url": "data:image/jpeg;base64," +
              b64(page.get_pixmap(dpi=72).tobytes("jpeg"))}} for page in doc]

# 3. As text. The text layer is the selectable text stored in a PDF. A scan has none.
as_text = "\n\n".join(page.get_text() for page in doc)
Formats acceptés par chacun des quinze modèles sur l’endpoint de chat :
| Modèle | PDF comme fichier | Images des pages | Texte |
|---|---|---|---|
| GPT-6.1 Sol, GPT-6 Luna | oui | oui, jusqu’à 50 par requête | oui |
| Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 | oui | oui | oui |
| Gemini 3.1 Pro, Gemini 3.8 Flash | oui | oui | oui |
| Qwen 3.8 Max, Qwen 3.8 Flash | oui | oui | oui |
| Qwen 3.6 35B (poids ouverts), DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 | non | oui | oui |
| GLM 5.3, DeepSeek V4 Pro | non | non | oui |
Tous les modèles de vision acceptent les images des pages, y compris les quatre modèles à poids ouverts, dont les poids sont publiés mais qui refusent les fichiers. Sur l’endpoint utilisé, les modèles Gemini acceptaient le PDF sous forme de data URL dans une partie image ; l’API de Google l’accepte comme donnée intégrée.
Comment vérifier que le modèle a vraiment lu le fichier ?
Demandez une information présente uniquement dans le fichier et vérifiez le nombre de tokens d’entrée. Un format non pris en charge provoque parfois une erreur 400. Dans d’autres cas, il est ignoré et le modèle répond quand même. Lors de notre test, les deux modèles sans vision ont ignoré la partie image et déclaré 27 et 98 tokens d’entrée pour un document de deux pages. Un autre modèle, auquel nous avions envoyé une URL à la place du fichier, a inventé le contenu de sa réponse.
r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": as_file + [question]}])
read_it = "MF-OPS-2291" in r.choices[0].message.content   # a string found only in the document
plausible = r.usage.prompt_tokens > 200 * len(doc)        # a dropped file leaves a few dozen tokens
Pas besoin de modèle pour déterminer le type d’une page. Le choix du format d’envoi présenté plus loin repose sur cette classification :
def kind(page) -> str:
    if len(page.get_text().strip()) < 40:
        return "scan"        # no text layer: needs OCR or an image
    if page.get_images() or len(page.get_drawings()) > 60:
        return "visual"      # a picture or a chart drawn on the page
    return "text"
Comment chaque fournisseur compte-t-il les tokens d’un PDF envoyé comme fichier ?
Il existe quatre règles différentes. Nous avons créé plusieurs versions d’un PDF de six pages, avec 0, 80, 250, 500 et environ 670 mots par page, puis répété le test en ajoutant un graphique sur chaque page. Chaque version a été envoyée comme fichier et comme texte extrait.
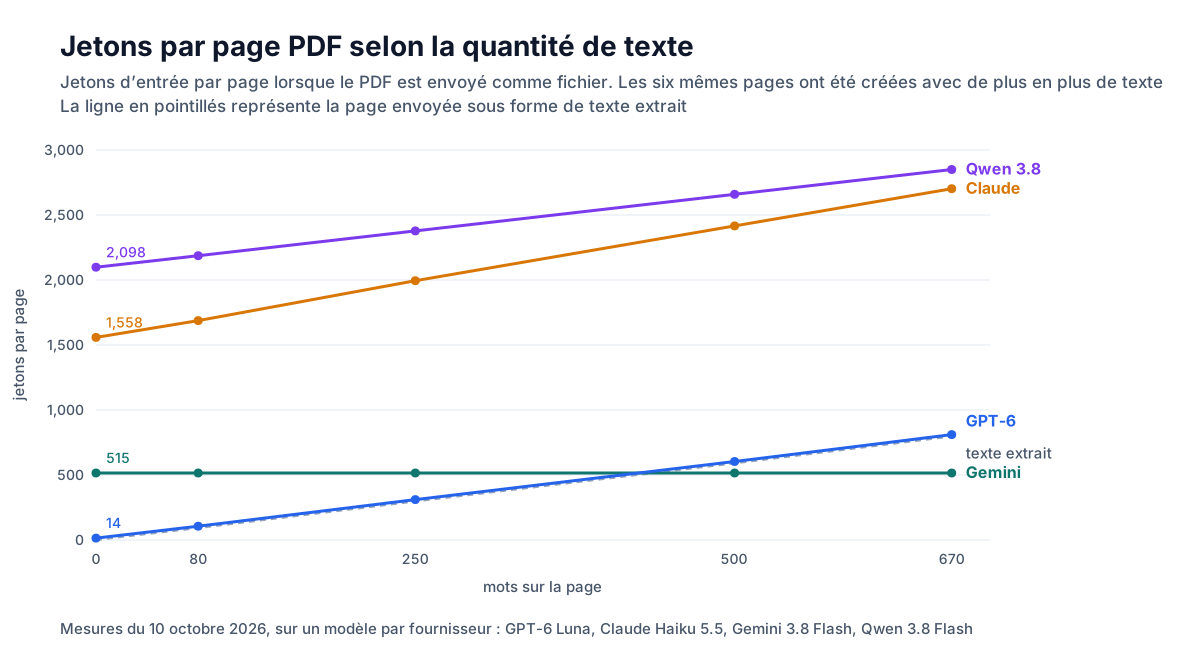
| Fournisseur | Tokens d’un PDF envoyé comme fichier |
|---|---|
| GPT-6 | Tokens du texte plus 14.5 par page. Une image sur la page ajoute environ 650 à 1,700 tokens |
| Claude | Tokens du texte plus exactement 1,558 par page. Un graphique sur la page ne coûte rien de plus |
| Gemini | 515 par page, quel que soit son contenu. Le texte n’est pas compté |
| Qwen 3.8 | Environ 0.94 fois les tokens du texte plus 2,098 par page. Un graphique ajoute environ 770 tokens |
Le token est l’unité de facturation d’un modèle. Il correspond à environ trois quarts d’un mot anglais. Les modèles d’une même famille donnaient les mêmes comptes, à quelques tokens près.
Deux règles diffèrent de celles publiées par les fournisseurs, du moins sur le circuit testé. La documentation de Google annonce 258 tokens par page et aucune facturation du texte du PDF ; nous avons mesuré 515 tokens par page, avec le texte gratuit comme annoncé. Selon OpenAI, le modèle reçoit un PDF sous forme de texte extrait et d’images des pages ; ici, une page de texte seul n’entraînait aucun coût d’image. Anthropic indique que chaque page est traitée comme du texte et comme une image, pour un total généralement compris entre 1,500 et 3,000 tokens, ce qui correspond à nos mesures.
Conséquences de ces règles :
- Les pages peu remplies coûtent cher sur Claude et Qwen. Une page avec une seule ligne coûte 1,558 ou 2,098 tokens comme fichier, contre une douzaine comme texte.
- Les pages denses coûtent peu sur Gemini. Une page d’environ 670 mots coûte les mêmes 515 tokens qu’une page vide, alors que son texte seul représente environ 800 tokens.
- Sur GPT-6, le fichier coûte autant que le texte tant que la page ne contient pas d’image. Une page numérisée, constituée uniquement d’une image, représentait 2,868 tokens.
Un rapport de 12 pages de texte seul, à raison d’environ 250 mots par page, représentait 6,028 tokens comme fichier sur GPT-6.1 Sol, 6,441 sur Gemini 3.8 Flash, 27,297 sur Claude Sonnet 5.5 et 30,934 sur Qwen 3.8 Flash. Son texte extrait représentait entre 5,924 et 8,716 tokens sur l’ensemble des quinze modèles.
Quand le texte extrait ne suffit-il pas ?
Dès que l’information ne figure pas dans la couche texte. Nous avons classé chaque question selon le contenu nécessaire pour y répondre, puis regroupé les résultats des quinze modèles :
| Format d’envoi | Texte courant | Cellule de tableau | Graphique | Page numérisée |
|---|---|---|---|---|
| Texte extrait | 297 sur 300 | 168 sur 170 | 0 sur 150 | 0 sur 105 |
| OCR, puis texte | 104 sur 105 | |||
| PDF comme fichier | 186 sur 186 | 103 sur 103 | 90 sur 90 | 62 sur 63 |
| Images des pages, 110 dpi | 258 sur 260 | 148 sur 148 | 130 sur 130 | 89 sur 91 |
| Images des pages, 72 dpi | 257 sur 260 | 142 sur 148 | 130 sur 130 | 88 sur 91 |
La résolution de rendu d’une page se mesure en points par pouce (dpi) : à 72 dpi, une page au format US Letter fait 612 par 792 pixels. L’OCR, ou reconnaissance optique de caractères, extrait le texte d’une image. Nous avons utilisé Tesseract, un outil open source, en local.
Le texte extrait n’a donné aucune réponse juste sur les graphiques et le document numérisé, quel que soit le modèle, car les nombres ne figuraient pas dans le texte. L’OCR a permis de lire le rapport numérisé au tarif du texte, mais pas les graphiques : sur une présentation de 15 diapositives contenant des graphiques, le texte issu de l’OCR a donné 0 réponse juste sur 7 avec les deux modèles testés. Les tableaux ont bien résisté à l’extraction dans nos tests parce qu’il s’agissait de grilles simples. Les cellules fusionnées et les colonnes avec des retours à la ligne sont plus difficiles à traiter : testez vos propres documents.
Comment réduire le coût des documents ?
Sept méthodes, dont six mesurées.
1. Choisir le format d’envoi selon la règle de comptage. Envoyez du texte pour les pages qui ne contiennent que du texte. Pour les autres, envoyez le fichier sur Gemini et des images à 72 dpi ailleurs : le coût d’une image de page ne dépend pas de la quantité de contenu imprimé. Un formulaire IRS dense de 6 pages représente 13,635 tokens comme texte sur Claude Sonnet 5.5, 22,871 comme fichier et 4,015 comme images à 72 dpi. Les trois méthodes donnent trois réponses justes sur trois.
2. Choisir le format page par page. Un document réel mélange plusieurs types de pages. La fonction kind ci-dessus les classe : les pages de texte sont envoyées comme texte, celles contenant une image comme images à 72 dpi, et les pages numérisées passent par l’OCR. Voici les résultats sur un document de neuf pages (quatre pages de texte, trois graphiques, deux pages numérisées), avec 12 questions :
| Modèle | Comme fichier | Format choisi page par page | Toutes les pages en images à 72 dpi |
|---|---|---|---|
| GPT-6 Luna | 15,106, 12 réponses justes | 5,140, 12 réponses justes | 5,750, 9 réponses justes |
| Claude Sonnet 5.5 | 17,228, 12 réponses justes | 6,543, 12 réponses justes | 6,257, 12 réponses justes |
| Qwen 3.8 Flash | 25,036, 12 réponses justes | 5,313, 12 réponses justes | 4,710, 12 réponses justes |
| Gemini 3.8 Flash | 5,043, 12 réponses justes | 7,110, 12 réponses justes | 10,278, 12 réponses justes |
Le choix page par page a réduit les tokens d’entrée de 62% à 79% par rapport au fichier chez trois fournisseurs, sans perdre une seule réponse juste. Sur Gemini, le fichier reste la solution la moins chère.
3. Réduire la résolution des images, mais pas pour le texte. Le nombre de tokens d’une image de page diminue avec son nombre de pixels, sauf sur Gemini, qui facturait la même quantité à toutes les résolutions. Les diapositives de graphiques avec de grandes légendes restaient lisibles à 36 dpi : les six modèles testés donnaient au moins 6 réponses justes sur 7. Les 15 diapositives représentaient 2,874 tokens sur Claude Haiku 5.5, contre 23,949 comme fichier. Le texte courant nécessitait 72 dpi : à 50 dpi, Claude Haiku 5.5 et Gemini donnaient encore 7 réponses justes sur 7, mais GLM 5.3 Flash tombait à 2 sur 7. GPT-6 Luna perdait des réponses justes avec les images de pages à toutes les résolutions inférieures à 96 dpi : envoyez-lui plutôt le fichier ou le texte.
4. Sur OpenAI, régler detail sur low pour les pages contenant des images. L’API Responses accepte un champ detail pour les fichiers PDF. Avec low, GPT-6 Luna a lu la présentation de 15 diapositives en 9,985 tokens, contre 22,155 avec le réglage par défaut. Le rapport numérisé est passé à 11,387 tokens, contre 34,396 par défaut, avec toutes les réponses justes. Les pages de texte seul n’ont pas changé.
5. N’envoyer que les pages nécessaires. Pour un manuel de 120 pages, GPT-6 Luna a lu le texte extrait (46,420 tokens) et indiqué la page nécessaire pour chacune des quatre questions. Claude Sonnet 5.5 a ensuite répondu correctement aux quatre questions à partir d’un PDF de 4 pages représentant 8,758 tokens. Le fichier complet représente 253,822 tokens sur Claude : le coût d’entrée est donc passé de $0.508 à $0.022, première passe comprise.
6. Faire transcrire le contenu par un modèle peu coûteux, puis raisonner avec un grand modèle. Un modèle de vision peu coûteux a converti les 15 diapositives de graphiques en tableaux Markdown pour $0.002 à $0.011. Claude Opus 5.5 a ensuite répondu correctement aux sept questions à partir d’une transcription d’environ 2,000 tokens, pour $0.010. Le fichier représente, lui, 23,949 tokens et $0.096 d’entrée. La transcription peut être conservée pour d’autres questions.
7. Mettre le document en cache et traiter par lots ce qui peut attendre. Avec un point de mise en cache sur le PDF (le marqueur cache_control dans l’API d’Anthropic), six questions à Claude Sonnet 5.5 ont coûté $0.117 au lieu de $0.461. La première requête a écrit 38,364 tokens dans le cache, puis les cinq suivantes les ont lus pour environ $0.004 chacune. Le traitement par lots est la seule méthode que nous n’avons pas mesurée. OpenAI, Anthropic et Google annoncent tous leur API de traitement par lots à moitié prix, avec des résultats sous 24 heures. Anthropic précise que cette remise se cumule avec la mise en cache.
Un seuil tarifaire mérite attention : un PDF de 120 pages dépasse 250,000 tokens sur Claude. Sur Claude Haiku 5.5, un prompt de plus de 100,000 tokens est facturé cinq fois plus cher. Le texte extrait du même manuel représente 68,382 tokens.
Que faire d’un fichier Word ?
Le convertir. Parmi les six modèles testés, seuls GPT-6.1 Sol et GPT-6 Luna acceptaient un .docx comme fichier. Ils n’en lisaient que le texte, conformément à la documentation d’OpenAI pour les fichiers autres que les PDF. Une conversion en Markdown avec pandoc suffit pour le texte et les tableaux : un contrat de neuf pages représentait 3,144 tokens et tous les modèles répondaient correctement aux 7 questions sur 7. Pour une note contenant un graphique intégré, cette méthode donnait 2 réponses justes sur 5. Après conversion en PDF avec LibreOffice, le score passait à 5 sur 5, pour 1,217 tokens sur Gemini 3.8 Flash et 3,827 sur Claude Sonnet 5.5.
Protocole de mesure
Dix documents : sept générés (un rapport de 12 pages, 8 pages de tableaux financiers, une présentation de 15 diapositives de graphiques, une version numérisée du rapport, un manuel de 120 pages, un contrat Word et une note Word) et trois documents publics (l’article « Attention Is All You Need », le formulaire IRS W-9 et l’AI Risk Management Framework du NIST). Chaque document comportait trois à sept questions ayant une seule réponse vérifiable.
Le test principal a envoyé chaque document dans chaque format à chaque modèle, en une seule requête : 568 requêtes le 10 octobre 2026, dont 566 ont réussi (GPT-6 Luna a refusé deux fois les 120 images de pages). Les mesures des règles de comptage et des coûts ont ajouté 176 requêtes le même jour, sur un modèle peu coûteux par fournisseur. Tout est passé par l’endpoint de chat compatible OpenAI de la passerelle Synthorai, sauf le test de cache (API Messages) et le test de detail (API Responses). Les montants en dollars sont calculés aux tarifs catalogue.
Les nombres de tokens sont ceux déclarés par l’endpoint sur ce circuit. Un autre fournisseur du même modèle peut prétraiter les fichiers différemment : exécutez le test de six pages sur votre propre circuit avant de vous fier à une règle. Avec trois à sept questions par document, un format qui donne toutes les réponses justes prouve que le contenu est lisible, pas qu’il est transmis sans perte.
FAQ
Combien de tokens représente une page de PDF ?
Cela dépend du fournisseur. Envoyée comme fichier, une page coûte les tokens de son texte plus environ 15 sur GPT-6, ceux du texte plus 1,558 sur Claude, un forfait de 515 sur Gemini avec le texte gratuit, et environ 2,098 plus le texte sur Qwen 3.8. Une page numérisée représentait 2,868 tokens sur GPT-6.1 Sol et 1,579 sur Claude Sonnet 5.5.
Est-il moins cher d’envoyer un PDF ou son texte extrait ?
Pour les pages de texte seul, le texte extrait coûte moins cher ou autant partout, sauf sur Gemini. Une page dense y coûte moins de tokens comme fichier, car le texte n’est pas compté. Sur GPT-6.1 Sol, le fichier coûte presque autant que le texte. Le texte extrait ne permet pas de répondre aux questions sur les graphiques ou les pages numérisées.
Un LLM peut-il lire un PDF numérisé ?
Oui, s’il reçoit les pages comme fichier ou comme images. Le texte extrait d’un document numérisé est vide et a donné 0 réponse juste sur 105 dans notre test. Exécuter l’OCR en local puis envoyer le résultat a donné 104 réponses justes sur 105, au tarif du texte. C’est la méthode la moins chère pour un document imprimé puis numérisé.
Quels modèles acceptent directement les fichiers PDF ?
Dans notre test : GPT-6.1 Sol, GPT-6 Luna, les trois modèles Claude 5.5, Gemini 3.1 Pro, Gemini 3.8 Flash, Qwen 3.8 Max et Qwen 3.8 Flash. DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 et Qwen 3.6 35B acceptaient les images des pages, mais pas le fichier.
Comment réduire le coût d’un PDF long ?
Envoyez moins de pages, choisissez le format le moins cher pour chaque page et réutilisez les données envoyées. En faisant sélectionner les pages pertinentes par un modèle peu coûteux, une requête de 120 pages sur Claude Sonnet 5.5 est passée de 253,822 à 8,758 tokens d’entrée. Le choix du format selon le type de page a réduit les tokens d’un document mixte de 62% à 79%. La mise en cache a ramené le coût de six questions sur un même document de $0.461 à $0.117.
À lire aussi
- Combien de tokens représente une image ? : les règles de facturation des images qui s’appliquent aux images de pages.
- Tarifs de Claude Haiku 5.5 : le seuil de 100,000 tokens qu’un PDF long peut dépasser.
- Coût d’écriture du cache de prompt : le coût de la première requête qui met un document en cache.