
GPT-4, GPT-3.5 Turbo arrêtés le 23/10 : relais de 3.5 à près de 5x
Sommaire
OpenAI arrête GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, o1, o3-mini et o4-mini le 2026-10-23. Tous les modèles de texte qu’OpenAI recommande pour les remplacer appartiennent à la gamme GPT-5.6 : cette liste a été rédigée cinq mois avant l’arrivée de GPT-6. Pour les utilisateurs de GPT-3.5 Turbo, la suivre multiplie la facture par environ cinq. Dans notre test, GPT-5.6 Terra, le remplaçant indiqué, coûtait $0.75 pour 1 000 appels courts, contre environ $0.15 aux tarifs de GPT-3.5 Turbo. GPT-6 Luna a traité les mêmes appels pour $0.037, sans aucune erreur.
TL;DR
- L’arrêt prévu par OpenAI le 2026-10-23 concerne GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, gpt-4o-2024-05-13, o1, o1-pro, o3-mini et o4-mini.
- GPT-5.6 Terra, le remplaçant désigné par OpenAI pour GPT-3.5 Turbo, est affiché à $2 / $12 par million de tokens, contre $0.50 / $1.50.
- Les cinq remplaçants testés ont chacun réussi les 96 tâches courtes.
- Coût pour 1 000 appels : GPT-5.6 Sol $1.41, GPT-6.1 Sol $0.72, GPT-5.6 Terra $0.75, GPT-5.6 Luna $0.075, GPT-6 Luna $0.037.
Quels modèles OpenAI s’arrêtent le 23 octobre, et par quoi les remplacer ?
Neuf familles de modèles de texte cesseront de répondre le 2026-10-23. Sur sa page des modèles retirés, OpenAI associe chacune à un modèle GPT-5.6. Chaque ligne englobe les snapshots datés du modèle (versions épinglées comme gpt-4-0613) et ses versions fine-tunées (copies entraînées sur mesure). Les prix affichés sont les tarifs publics par million de tokens, en entrée / sortie, tirés de la page des tarifs et des pages des modèles OpenAI.
| Modèle retiré | Tarif public | Remplaçant indiqué par OpenAI | Tarif public |
|---|---|---|---|
| GPT-4 | $30 / $60 | GPT-5.6 Sol | $4 / $20 |
| GPT-4 Turbo | $10 / $30 | GPT-5.6 Sol | $4 / $20 |
| gpt-4o-2024-05-13 | $5 / $15 | GPT-5.6 Sol | $4 / $20 |
| o1 | $15 / $60 | GPT-5.6 Sol | $4 / $20 |
| o1-pro | $150 / $600 | GPT-5.6 Sol | $4 / $20 |
| o3-mini | $1.10 / $4.40 | GPT-5.6 Sol | $4 / $20 |
| GPT-4.1 nano | $0.10 / $0.40 | GPT-5.6 Luna | $0.20 / $1.20 |
| GPT-3.5 Turbo | $0.50 / $1.50 | GPT-5.6 Terra | $2 / $12 |
| o4-mini | $1.10 / $4.40 | GPT-5.6 Terra | $2 / $12 |
Le même arrêt concerne gpt-image-1 (remplacé par gpt-image-2.5-sunburst ou gpt-image-2.5-flare), ainsi que les modèles fine-tunés babbage-002 et davinci-002. GPT-4o lui-même et ses snapshots plus récents ne figurent pas dans cette liste. Deux autres vagues ont déjà une date : tts-1 et tts-1-hd le 2027-01-06, puis gpt-5.1, gpt-5.3-codex et gpt-5.4-nano le 2027-04-01.
OpenAI a annoncé cette vague le 2026-04-22. GPT-6 est sorti le 2026-09-22 : il ne pouvait donc pas figurer dans la colonne des remplaçants. Quatre des neuf migrations augmentent le tarif public : o3-mini, GPT-4.1 nano, GPT-3.5 Turbo et o4-mini.
Le remplaçant indiqué par OpenAI est-il le moins cher ?
Dans aucun cas : les modèles GPT-6 sont affichés à environ la moitié du prix des GPT-5.6, mais n’apparaissent pas dans le tableau d’OpenAI. Sol, Terra et Luna correspondent aux gammes haute, intermédiaire et petite. Le prix de l’entrée mise en cache s’applique à la partie du prompt servie depuis le prompt cache d’OpenAI.
| Entrée | Entrée mise en cache | Sortie | |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $12.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Le tarif de $4 / $20 de GPT-5.6 Sol est promotionnel. OpenAI indique qu’il restera disponible au moins jusqu’au 2026-11-21. Il n’existe pas de modèle Terra dans la gamme GPT-6, et GPT-5.6 Terra est moins intéressant que les deux modèles qui l’encadrent : GPT-6.1 Sol, de gamme supérieure, coûte autant en entrée et moins en sortie, tandis que GPT-6 Luna coûte vingt fois moins.
Comment avons-nous testé ces modèles ?
Une grille tarifaire donne le prix du token. Pour préparer une migration, il faut aussi savoir si un modèle moins cher remplit toujours la tâche et s’il consomme des tokens supplémentaires pour raisonner. Les cinq candidats sont des modèles à raisonnement. Dans la Responses API, reasoning.effort règle la quantité de raisonnement caché produite avant la réponse. Ces tokens sont facturés comme des tokens de sortie. Sans réglage explicite, le modèle utilise sa valeur par défaut (medium pour GPT-6.1 Sol et GPT-6 Luna). La valeur none désactive le raisonnement.
Nous avons exécuté 96 tâches courtes du type de celles confiées à GPT-3.5 Turbo et GPT-4.1 nano. Pour chacune, une seule bonne réponse était vérifiée par du code :
- Classification : 40 messages de support, 8 catégories, avec des règles pour les messages relevant de deux catégories.
- Extraction : 30 e-mails de commande convertis en objet JSON à 6 champs, avec des éléments trompeurs comme un ancien identifiant de commande ou un sous-total.
- Appels d’outils : 26 demandes au support à convertir chacune en un appel de fonction avec les bons arguments, parmi 5 outils.
Quatre autres demandes d’appel d’outil ne sont pas notées. Elles posent une question avant d’indiquer le changement (« La commande A-88643 n’est pas encore expédiée, n’est-ce pas ? La nouvelle adresse de livraison est à Graz »), et 18 des 56 réponses ont consulté la commande avant de modifier l’adresse : 9 sur 12 pour GPT-6 Luna, 4 sur 12 pour GPT-5.6 Luna, 3 sur 12 pour GPT-5.6 Terra et 1 pour chacun des deux modèles Sol. Les deux lectures se défendent : ces quatre demandes testent donc la formulation plus que le modèle.
Chaque modèle a exécuté ces tâches sans raisonnement, avec low, puis avec son réglage par défaut (GPT-6.1 Sol uniquement avec low et le réglage par défaut, car il n’accepte pas none) : 1 344 appels au total. Chaque appel contenait une chaîne aléatoire unique pour éviter toute réponse provenant d’un cache. Les coûts reposent sur les tarifs publics d’OpenAI. Nous ne pouvons pas appeler les modèles en cours de retrait : leur coût est donc estimé à partir des volumes mesurés (234 tokens en entrée et 24 en sortie par appel), appliqués au tarif de chaque modèle. Les tokenizers, qui découpent le texte en tokens, changent d’une génération à l’autre. Ces estimations sont donc approximatives.
Combien coûte chaque remplaçant pour 1 000 appels ?
Sur ces tâches courtes, le prix départage les modèles : les cinq ont réussi les 96 tâches sur 96, quel que soit le réglage. Le tableau indique le coût pour 1 000 appels sans raisonnement (avec low pour GPT-6.1 Sol).
| Modèle actuel | Coût actuel estimé | Remplaçant indiqué par OpenAI | Option GPT-6 |
|---|---|---|---|
| GPT-4 | $8.48 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-4 Turbo | $3.07 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| gpt-4o-2024-05-13 | $1.53 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-3.5 Turbo | $0.15 | GPT-5.6 Terra, $0.75 | GPT-6 Luna, $0.037 |
| GPT-4.1 nano | $0.033 | GPT-5.6 Luna, $0.075 | GPT-6 Luna, $0.037 |
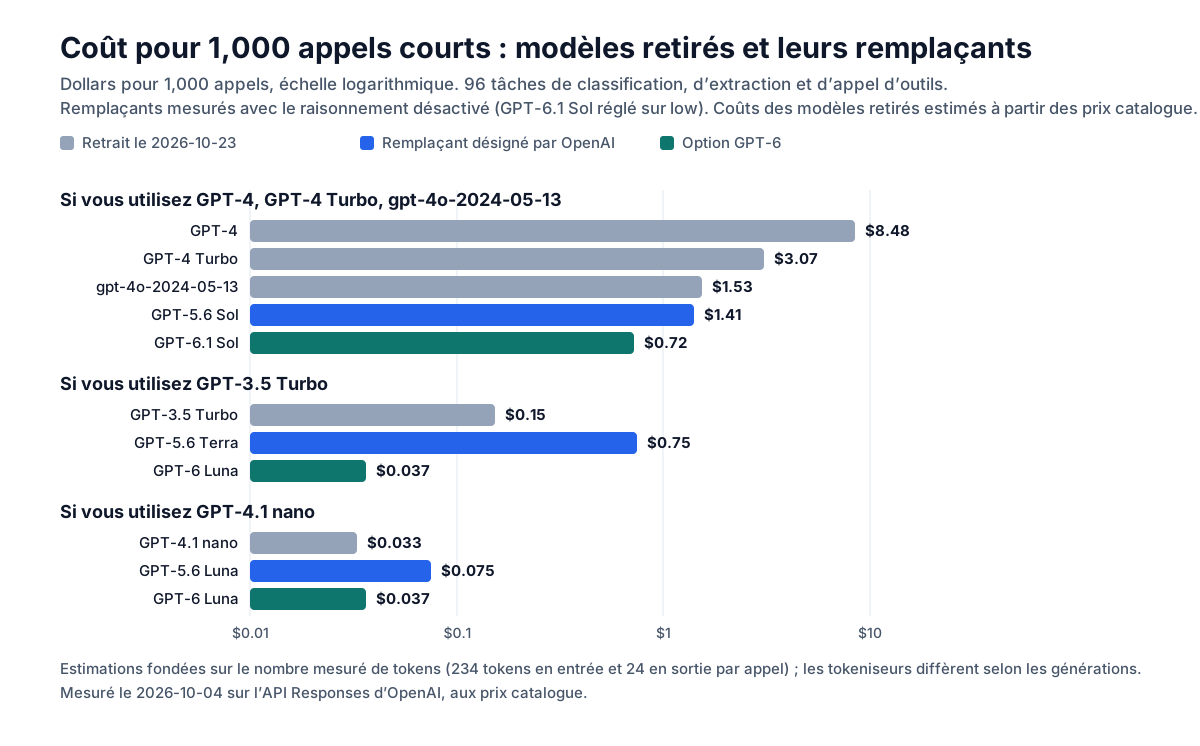
Pour GPT-4 et GPT-4 Turbo, toute migration réduit le coût. Pour gpt-4o-2024-05-13, GPT-5.6 Sol coûte à peu près autant et GPT-6.1 Sol deux fois moins. Pour GPT-3.5 Turbo, le remplaçant indiqué coûte 4.9 fois plus cher et GPT-6 Luna quatre fois moins. Pour GPT-4.1 nano, le remplaçant indiqué coûte 2.3 fois plus cher et GPT-6 Luna à peu près autant.
Les modèles de la série o ne figurent pas dans ce tableau. o1, o3-mini et o4-mini consomment des tokens de raisonnement que nous ne pouvons pas mesurer : seuls leurs tarifs publics du premier tableau peuvent donc servir de référence. Pour les tâches qui nécessitent du raisonnement, nos mesures de GPT-6.1 Sol couvrent 13 tâches à chaque niveau d’effort.
Le raisonnement par défaut augmente-t-il la facture ?
Le réglage par défaut augmente légèrement le coût sur les modèles Sol, et davantage sur les modèles moins chers. Sur ces appels, conserver la valeur par défaut de reasoning.effort a ajouté 5 % au coût de GPT-5.6 Sol et de GPT-6.1 Sol, 22 % pour GPT-5.6 Terra, 34 % pour GPT-6 Luna et 42 % pour GPT-5.6 Luna, sans gain de précision. Le raisonnement restait limité, au plus 25 tokens par appel. Mais pour un appel dont la réponse ne compte que 24 tokens, il double les tokens de sortie.
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "none"},  # no hidden reasoning; use "low" on gpt-6.1-sol
    max_output_tokens=64,
    input="Classify the customer message into exactly one label: ...",
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Une faible limite de sortie, courante dans le code de classification écrit pour GPT-3.5 Turbo, n’a posé aucun problème ici : avec max_output_tokens fixé à 64, les 200 appels ont renvoyé la catégorie, y compris avec le réglage de raisonnement par défaut. Une tâche qui demande davantage de raisonnement pourrait toutefois épuiser une limite basse avant même de produire une réponse. Vérifiez donc output_tokens_details.reasoning_tokens sur vos propres appels.
La latence était comparable pour quatre des cinq modèles, avec une médiane de 2.2 à 2.4 secondes par appel. GPT-6.1 Sol mettait 2.9 à 3.2 secondes.
Le guide de migration d’OpenAI détaille les changements à apporter aux requêtes : retirer temperature, top_p et top_logprobs sauf si l’effort est réglé sur none ; GPT-6.1 Sol n’accepte pas none ; et les appels d’outils avec raisonnement nécessitent la Responses API.
Quel remplaçant choisir ?
Partez de l’usage du modèle retiré. La recommandation d’OpenAI n’est qu’une option parmi d’autres.
| Usage actuel | Choix | Raison |
|---|---|---|
| GPT-3.5 Turbo pour la classification, l’extraction ou le routage | GPT-6 Luna avec reasoning.effort: "none" | $0.037 pour 1 000 appels contre $0.75 avec GPT-5.6 Terra ; 96 réponses correctes sur 96 pour les deux |
| GPT-4.1 nano | GPT-6 Luna avec l’effort none | $0.037 contre $0.033 actuellement ; GPT-5.6 Luna coûte $0.075 |
| GPT-4, GPT-4 Turbo ou gpt-4o-2024-05-13 pour des tâches courtes | GPT-6.1 Sol avec low, ou GPT-6 Luna si vos tests confirment ses résultats | $0.72 contre $1.41 avec GPT-5.6 Sol, dont le tarif est promotionnel |
| GPT-4 pour les documents longs | GPT-6.1 Sol | il produit des textes aussi longs que GPT-5.6 Sol pour 59 % de moins par document dans notre test sur les documents ; GPT-6 Luna produit des textes environ deux fois plus courts sauf si le prompt précise les parties attendues |
| Tâches où chaque appel doit être rapide | GPT-6 Luna ou GPT-5.6 Sol | GPT-6.1 Sol était le plus lent ici, à 2.9-3.2 secondes contre 2.2-2.4 |
| o1, o3-mini, o4-mini | GPT-6.1 Sol avec medium ou plus | son tarif de $2 / $10 est inférieur à ceux des deux remplaçants indiqués ($4 / $20 et $2 / $12), mais supérieur aux $1.10 / $4.40 de o3-mini et o4-mini ; mesurez le coût sur vos tâches, car il dépend du raisonnement nécessaire |
Pour les modèles fine-tunés, changer le nom du modèle ne suffit pas. OpenAI indique un modèle de base pour chacun. Il faut refaire le fine-tuning ou le remplacer par un prompt. Nous n’avons pas testé cette migration.
Nos tâches sont courtes et n’ont qu’une seule bonne réponse. Avant de migrer, testez vos propres prompts avec le modèle envisagé et comparez les sorties. Un modèle moins cher qui réussit nos 96 tâches peut se comporter différemment sur les vôtres.
FAQ
Quand GPT-4 s’arrête-t-il dans l’API ?
GPT-4, GPT-4 Turbo et le snapshot gpt-4o-2024-05-13 s’arrêtent dans l’API OpenAI le 2026-10-23, en même temps que GPT-3.5 Turbo, GPT-4.1 nano, o1, o1-pro, o3-mini et o4-mini. OpenAI a annoncé cette date le 2026-04-22.
Quel modèle remplace GPT-3.5 Turbo ? OpenAI indique GPT-5.6 Terra comme remplaçant de GPT-3.5 Turbo, à $2 / $12 par million de tokens contre $0.50 / $1.50. Dans notre test, GPT-6 Luna, à $0.10 / $0.50, a réussi les mêmes 96 tâches courtes pour un coût vingt fois inférieur à celui de GPT-5.6 Terra.
GPT-6 Luna coûte-t-il moins cher que GPT-3.5 Turbo ? GPT-6 Luna est affiché à $0.10 en entrée et $0.50 en sortie par million de tokens, soit respectivement un cinquième et un tiers des $0.50 et $1.50 de GPT-3.5 Turbo. Sans raisonnement, 1 000 appels courts ont coûté $0.037 dans notre test, contre environ $0.15 aux tarifs de GPT-3.5 Turbo.
Autres mesures : GPT-6.1 Sol face à Claude Sonnet 5.5, GPT-6 Luna face à GPT-5.6 Luna et comment réduire le coût de GPT-5.6.