
GPT-6.1 Terra vs GPT-5.6 Terra y Sol: 192 llamadas API
Contenido
- ¿Dónde encaja GPT-6.1 Terra en la oferta de modelos de OpenAI?
- ¿Qué muestran los benchmarks oficiales?
- ¿Cómo probamos los niveles de razonamiento?
- ¿Qué ocurrió al desactivar el razonamiento?
- ¿Cómo se comparan los tres modelos en nuestras tareas?
- ¿Conviene migrar de GPT-5.6 Terra a GPT-6.1 Terra?
- ¿Conviene elegir GPT-6.1 Terra o GPT-6.1 Sol?
- ¿Cómo se configura el nivel de razonamiento en la API?
- ¿Cómo deben validarse los importes de las facturas en producción?
- Preguntas frecuentes
- ¿Merece la pena migrar de GPT-5.6 Terra a GPT-6.1 Terra?
- ¿Conviene elegir GPT-6.1 Terra o GPT-6.1 Sol?
- ¿Se puede desactivar el razonamiento para procesar facturas?
GPT-6.1 Terra es el modelo de OpenAI para flujos de trabajo visuales de menor coste. Cuesta $1 por millón de tokens de entrada y $5 por millón de tokens de salida, la mitad que GPT-6.1 Sol. El nivel de razonamiento controla el razonamiento interno previo a la respuesta. El ajuste none lo desactiva; en los demás niveles, los tokens de razonamiento se facturan como parte de la salida. Sin razonamiento, el modelo resolvió las 16 tareas de tablas y selección de botones de nuestra prueba, pero solo 3/8 cálculos sobre imágenes de facturas y 0/8 cálculos equivalentes en texto.
TL;DR
- GPT-6.1 Terra con
nonesuperó 16/16 tareas de tablas y capturas de pantalla, pero solo 3/8 cálculos sobre imágenes de facturas en nuestra prueba sintética. - GPT-6.1 Terra con
lowsuperó 24/24 tareas con imágenes y 7/8 tareas equivalentes con facturas en texto; conmedium, superó 24/24 y 8/8. - GPT-6.1 Terra con
mediumcostó $0.028290 para 24 imágenes; GPT-6.1 Sol conlowcostó $0.055012. - En otra ejecución con las mismas condiciones, GPT-6.1 Terra con
mediumcostó $0.028269 para 24 imágenes; GPT-5.6 Terra costó $0.072094.
¿Dónde encaja GPT-6.1 Terra en la oferta de modelos de OpenAI?
GPT-6.1 Terra está orientado al razonamiento visual, las acciones sobre interfaces y la redacción concisa, a un precio inferior al de GPT-6.1 Sol. OpenAI lanzó Terra el 26 de octubre de 2026. Su guía de selección de modelos lo recomienda para tareas bien definidas con resultados verificables, como flujos de trabajo sobre interfaces y correcciones de código acotadas. Sol sigue siendo la opción más generalista para proyectos complejos.
GPT-5.6 Terra es la referencia de la generación anterior para decidir si conviene migrar. Sol es la alternativa actual de mayor precio para elegir qué nivel de modelo usar. Los tres modelos permiten abordar esas dos decisiones:
| Especificación | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Papel en esta comparación | Referencia de la generación anterior | Nuevo modelo para flujos de trabajo visuales | Opción de mayor precio para tareas complejas |
| Precio de entrada Standard por 1M tokens | $2 | $1 | $2 |
| Precio de salida Standard por 1M tokens | $12 | $5 | $10 |
| Precio de lectura de entrada en caché por 1M tokens | $0.20 | $0.05 | $0.10 |
| Ventana de contexto | 1,050,000 tokens | 1,050,000 tokens | 1,050,000 tokens |
| Salida máxima | 128,000 tokens | 128,000 tokens | 128,000 tokens |
| Niveles de razonamiento | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Razonamiento predeterminado | medium | medium | medium |
| Modalidades de entrada / salida | Texto e imagen / texto | Texto e imagen / texto | Texto e imagen / texto |
| Endpoint usado en las pruebas | Responses API | Responses API | Responses API |
Fuentes: las referencias oficiales de GPT-5.6 Terra, GPT-6.1 Terra y Sol, y el registro de cambios. Los precios anteriores se aplican a solicitudes Standard de hasta 272,000 tokens de entrada. Por encima de ese umbral, la tarifa de entrada sin caché se duplica y la de salida aumenta un 50% para toda la solicitud. Las escrituras en caché tienen precios independientes; ninguna de las solicitudes medidas en el estudio principal notificó lecturas ni escrituras en caché.
El nuevo Terra conserva la ventana de contexto, el límite de salida y los nombres de los niveles de razonamiento de la generación anterior. Su precio publicado de entrada baja un 50% y el de salida un 58.3%. La prueba de migración en condiciones equivalentes que presentamos más adelante separa esas rebajas de los cambios en el consumo de tokens y en la exactitud de las tareas.
¿Qué muestran los benchmarks oficiales?
En el anuncio de lanzamiento, OpenAI compara GPT-6.1 Terra con GPT-5.6 Terra y GPT-6.1 Sol. Estos son los resultados que publica:
| Evaluación | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam: flujos de trabajo visuales profesionales | Referencia; no se indica la puntuación absoluta | Con medium, +15 puntos porcentuales respecto a su predecesor, con aproximadamente un tercio del coste por tarea | No se indica la puntuación absoluta |
| MMMU-Pro: razonamiento visual | Por debajo del nuevo Terra en todos los niveles publicados; no se indican puntuaciones | Casi iguala a Sol; no se indican puntuaciones | Se describe como casi igualado por el nuevo Terra; no se indica la puntuación |
| Terminal-Bench 4.0: tareas de programación en terminal | Puntuación publicada del 21.5%; no se especifica el nivel de razonamiento | 50.3% con max | No se indica la puntuación |
| Prueba interna de exactitud factual: menor tasa de error es mejor | 53.6% de errores con low | 16.7% de errores con low | No se indica la tasa de error con low |
Fuente: evaluaciones de lanzamiento de OpenAI. Las puntuaciones ausentes no se han publicado; la evaluación de exactitud factual es interna. Las pruebas de API que siguen abordan las decisiones de migración y de nivel de modelo con las mismas tareas sintéticas.
¿Cómo probamos los niveles de razonamiento?
Probamos GPT-6.1 Terra con none, low y medium, y GPT-6.1 Sol con low, usando 32 entradas por configuración: 24 imágenes y ocho controles equivalentes en texto. Eso supone 128 llamadas en el estudio principal. En una comparación de migración independiente, intercalamos respuestas de GPT-5.6 Terra y nuevas respuestas de GPT-6.1 Terra con medium sobre las mismas 32 entradas. Esto añadió 64 llamadas, hasta un total de 192. La tabla de migración usa únicamente ese lote independiente.
| Tipo de tarea | Entradas por configuración | Resultado exigido |
|---|---|---|
| Imágenes de facturas | 8 | Multiplicar las partidas, restar un descuento, calcular y redondear el impuesto, y restar un anticipo |
| Tablas filtradas | 8 | Agregar los datos de la región y el trimestre correspondientes y calcular una tasa de devoluciones |
| Capturas de aplicaciones | 8 | Identificar el ID del control correcto y un punto dentro de su botón entre varias tarjetas similares |
| Controles con facturas en texto | 8 | Calcular los mismos importes de la factura a partir de una transcripción exacta |
Generamos documentos ficticios con respuestas conocidas a partir de tres plantillas, variando los valores o la disposición. Cada imagen tenía 960 por 640 píxeles y se envió con detail: "high". Las versiones en imagen y texto de cada factura usaban las mismas instrucciones, esquema y reglas de negocio. Cada entrada recibió una respuesta por configuración.
La ejecución utilizó solicitudes Responses con streaming a través de Synthorai el 29 de octubre de 2026, con un límite común de salida de 4,096 tokens y las configuraciones intercaladas. Las 128 respuestas principales se completaron y devolvieron JSON conforme al esquema. Para considerar una tarea correcta, todos los valores solicitados debían coincidir; en las capturas, las coordenadas debían caer dentro del botón correcto. La evaluación se hizo mediante código, con céntimos enteros y redondeo decimal, sin recurrir a otro modelo como juez.
Estas 24 imágenes representan tres plantillas de tareas, no 24 tipos de trabajo distintos. En las 16 comparaciones pareadas de los estudios principal y de migración, ajustadas conjuntamente mediante el método de Holm para tener en cuenta las múltiples diferencias evaluadas, ningún valor p ajustado fue inferior a 0.05. Los recuentos siguientes describen esta ejecución; no establecen una clasificación general de calidad ni la equivalencia entre modelos.
¿Qué ocurrió al desactivar el razonamiento?
GPT-6.1 Terra con none falló cinco de los ocho cálculos sobre imágenes de facturas y los ocho cálculos sobre facturas en texto. En la misma prueba de niveles, low obtuvo 8/8 en imágenes de facturas y 7/8 en los controles de texto; medium obtuvo 8/8 en ambos. Los resultados entre modelos se recogen en la tabla de tres modelos que aparece más adelante.
Los errores en entradas de solo texto muestran que la lectura de imágenes no explica todos los fallos. Los ocho pares de entradas no demuestran una ventaja del formato de imagen.
Esta factura ilustra el fallo:
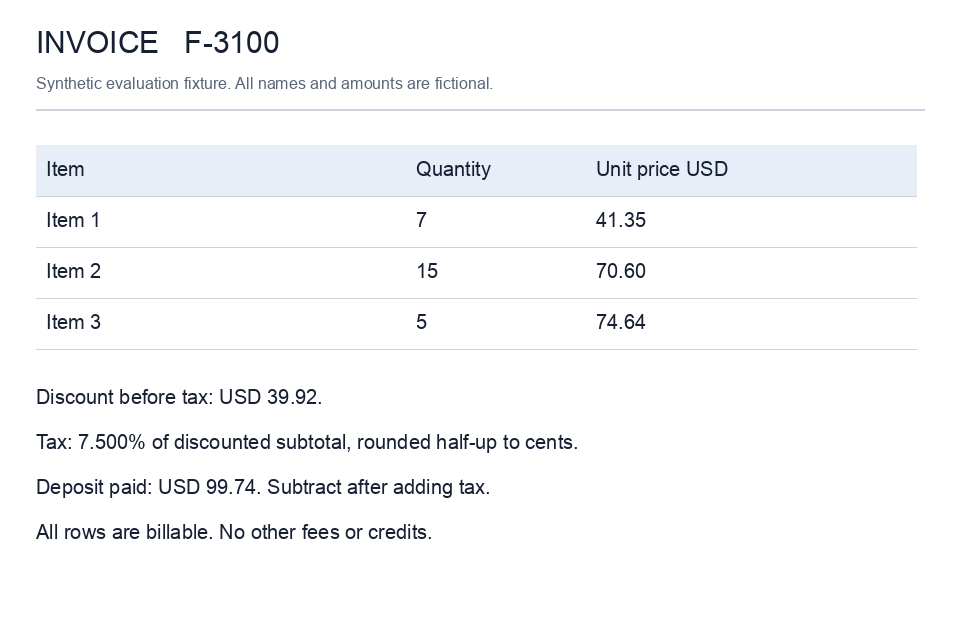
Las partidas son 7 × $41.35, 15 × $70.60 y 5 × $74.64. El subtotal es $1,721.65. Tras descontar $39.92, el impuesto del 7.5%, redondeado al más cercano con los empates hacia arriba, es $126.13; al restar el anticipo de $99.74, quedan $1,708.12 pendientes.
En la versión de texto, Terra con low devolvió un subtotal de $1,711.65, un impuesto de $125.38 y un saldo pendiente de $1,697.37. El JSON cumplía el esquema, pero la aritmética era incorrecta. Aumentar el nivel de razonamiento es una variable que conviene evaluar; una salida tipada no valida por sí sola un importe.
En la prueba principal original, las cuatro configuraciones superaron las ocho tareas de tablas filtradas y las ocho de selección de botones. Esas plantillas no permitieron diferenciar la calidad en esa prueba; los errores en las facturas explican las diferencias en el número de tareas resueltas.
¿Cómo se comparan los tres modelos en nuestras tareas?
Comparamos GPT-5.6 Terra y GPT-6.1 Terra con medium; GPT-6.1 Sol usó low para la comparación práctica entre niveles de modelo. Usamos Terra con medium para la recomendación principal porque obtuvo 8/8 en las facturas de texto, frente a 7/8 con low; para Sol usamos el nivel low probado. La comparación enfrenta configuraciones candidatas con distintos niveles de razonamiento, no su calidad a igual nivel. La diferencia de una tarea no demuestra que medium sea más preciso en general.
Principal es la prueba original de niveles de razonamiento. Migración es la nueva comparación entre el Terra anterior y el nuevo. Cuando las mediciones difieren, la columna del nuevo Terra incluye el valor de cada ejecución. Las recomendaciones de migración usan sus valores de migración; las de Terra frente a Sol usan sus valores del estudio principal. Ninguna relación de costes o latencias que aparece a continuación mezcla lotes.
| Medida | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Configuración | medium, ejecución de migración | medium, ejecuciones principal y de migración | low, ejecución principal |
| Imágenes de facturas correctas | 8/8 | 8/8 en cada ejecución | 8/8 |
| Facturas equivalentes en texto correctas | 8/8 | 8/8 en cada ejecución | 8/8 |
| Tablas filtradas correctas | 8/8 | 8/8 en cada ejecución | 8/8 |
| Tareas de capturas completamente correctas | 2/8 | 8/8 en cada ejecución | 8/8 |
| Total de tareas con imágenes correctas | 18/24 | 24/24 en cada ejecución | 24/24 |
| Coste de 24 imágenes | $0.072094 | Principal: $0.028290; migración: $0.028269 | $0.055012 |
| Mismo consumo de imágenes a $1 de entrada / $5 de salida por 1M tokens | $0.033500 | Principal: $0.028290; migración: $0.028269 | $0.027506 |
| Coste por tarea con imagen correcta | $0.004005 | Principal: $0.001179; migración: $0.001178 | $0.002292 |
| Mediana del tiempo de respuesta con imágenes | 2.57 s | Principal: 5.75 s; migración: 6.43 s | 4.51 s |
El coste por tarea correcta es el coste total dividido entre las respuestas completamente correctas. Incluye el coste de las respuestas incorrectas, sin simular reintentos. Usamos el consumo devuelto por la API con las tarifas Standard fijas y contamos el razonamiento dentro de los tokens de salida. La prueba independiente de llamadas a funciones queda excluida. Los tiempos de respuesta se midieron de extremo a extremo a través del gateway; la infraestructura de servicio no se mantuvo fija de forma independiente.
En los seis fallos del Terra anterior, las coordenadas caían dentro del botón correcto, pero el modelo inventó IDs como cobalt-edit en lugar de leer el ID impreso del control. Son errores en campos que exigen coincidencia exacta. Ambas generaciones calcularon correctamente todas las facturas con medium en la ejecución de migración.
En la prueba principal de niveles, el nuevo Terra con none costó $0.024275 para las 24 imágenes, con 19/24 correctas, frente a $0.027835 y 24/24 correctas con low. El coste observado por tarea con imagen correcta fue, por tanto, de $0.001278 con none y $0.001160 con low. En este conjunto, el menor gasto total con none no se tradujo en un menor coste por resultado correcto.
¿Conviene migrar de GPT-5.6 Terra a GPT-6.1 Terra?
GPT-6.1 Terra merece una evaluación como sustituto de GPT-5.6 Terra cuando importan el coste de inferencia o la extracción exacta de campos visuales. En la ejecución equivalente con medium, el coste de las tareas con imágenes cayó un 60.8%, con 24/24 completamente correctas frente a 18/24. Los seis resultados que cambiaron corresponden a IDs de controles impresos; tras la corrección estadística, la muestra no demuestra una superioridad general de calidad.
La tarifa actual del modelo anterior es de $2 de entrada y $12 de salida por millón de tokens. El nuevo Terra reduce esos precios un 50% y un 58.3%. Con la tarifa común de $1/$5, su consumo en tareas con imágenes sigue costando un 15.6% menos. Los recuentos de entrada fueron similares, 20,765 frente a 20,789 tokens; la salida bajó de 2,547 a 1,496 tokens.
Para el procesamiento interno de documentos o la extracción de campos con validación, pruebe el nuevo modelo con el nivel de razonamiento actual y compruebe los IDs y los importes exactos antes de cambiar. En interacciones sensibles a la latencia, mantenga el modelo anterior como referencia hasta que el nuevo cumpla el objetivo de tiempo de respuesta de la aplicación: en esta ejecución, la mediana de latencia con imágenes fue de 2.57 segundos para el anterior y de 6.43 para el nuevo. En facturas que puedan desencadenar pagos, mantenga la aritmética determinista y los controles de aprobación con cualquiera de las dos generaciones.
¿Conviene elegir GPT-6.1 Terra o GPT-6.1 Sol?
GPT-6.1 Terra con medium es el candidato más barato para estas tareas visuales acotadas; GPT-6.1 Sol con low es la alternativa que conviene mantener en la comparación cuando importan el tiempo de respuesta o las tareas más complejas. En la ejecución principal, ambos resolvieron correctamente 24/24 imágenes, por $0.028290 frente a $0.055012. El ahorro observado del 48.6% se explica por las tarifas de entrada y salida de Terra, un 50% menores: al aplicar $1/$5 al consumo de Sol, el coste queda en $0.027506, ligeramente por debajo de los $0.028290 de Terra.
Para la extracción por lotes con validación, evalúe primero Terra con ejemplos propios y compare los tipos de error. En un flujo interactivo, contraste la mediana observada de Sol, de 4.51 segundos, y la de Terra, de 5.75 segundos, con el objetivo real de latencia del producto. La programación compleja y los proyectos abiertos con agentes requieren una evaluación representativa que vaya más allá de estas tres plantillas; la guía de selección de modelos de OpenAI sitúa a Sol como opción para tareas complejas. Que ambos resolvieran el mismo número de tareas no demuestra una equivalencia general.
¿Cómo se configura el nivel de razonamiento en la API?
Para GPT-6.1 Terra, establezca reasoning.effort explícitamente e inspeccione tanto la respuesta como el consumo devuelto. La guía de GPT-6 indica medium como valor predeterminado y exige Responses para las llamadas a herramientas. Los tokens de razonamiento consumen el límite de salida y se facturan dentro de los tokens de salida, no se suman una segunda vez.
Este ejemplo en Python muestra un patrón de extracción para producción, no reproduce el benchmark de cálculo. Instale openai, configure OPENAI_API_KEY y guarde la factura de la imagen como invoice.png. Solicite las partidas y las reglas impresas, dejando como null los campos ausentes. La regla admitida aquí aplica el descuento antes del impuesto, redondea a céntimos al más cercano con los empates hacia arriba y resta el anticipo después del impuesto.
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
También ejecutamos una prueba local independiente de llamadas a funciones con las cuatro configuraciones principales originales (el nuevo Terra con none/low/medium y GPT-6.1 Sol con low): seleccionar un control de una captura, leer la selección realmente almacenada y devolver un resultado verificado. Las cuatro completaron correctamente la secuencia forzada de tres turnos, con un total de 12 turnos de API. Los resultados de las funciones usaron los IDs de llamada correspondientes y se reenviaron los elementos de salida. Es una prueba local de compatibilidad, no un benchmark de uso autónomo del escritorio.
¿Cómo deben validarse los importes de las facturas en producción?
Para contabilizar facturas y realizar pagos, extraiga operandos tipados y calcule los totales mediante código determinista. Valide los campos de origen y exija aprobación antes de mover dinero, independientemente del modelo que gane la comparación de coste o latencia.
Ejecute este bloque después del ejemplo de extracción. Rechaza las entradas ausentes o no admitidas y calcula los totales de la factura mostrada. Los céntimos enteros evitan errores de coma flotante binaria; Decimal aplica la regla indicada de redondeo del impuesto.
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
La salida está lista para revisión, no para contabilizarse automáticamente. Las comprobaciones de tipos y reglas no garantizan que un precio se haya leído correctamente: contraste los campos extraídos con el documento original y revise las condiciones ambiguas antes de aprobar un pago. El ejemplo de extracción es un patrón de implementación; las 192 llamadas medidas probaron los prompts de cálculo descritos anteriormente.
Para otras mediciones relacionadas, consulte nuestra guía de facturación de imágenes de entrada, las pruebas de coste según la representación de los PDF y la comparación de modelos al mismo precio.
Preguntas frecuentes
¿Merece la pena migrar de GPT-5.6 Terra a GPT-6.1 Terra?
GPT-6.1 Terra redujo el coste de las tareas con imágenes un 60.8% frente a GPT-5.6 Terra con medium en nuestra ejecución equivalente, o un 15.6% al aplicar a ambos $1 de entrada / $5 de salida por millón de tokens. Los dos superaron todos los cálculos de facturas; el modelo anterior falló en seis IDs de controles impresos. La mayor mediana de latencia observada en el modelo nuevo obliga a validar el tiempo de respuesta como parte de la decisión de migración.
¿Conviene elegir GPT-6.1 Terra o GPT-6.1 Sol?
GPT-6.1 Terra con medium costó $0.028290 para 24 tareas con imágenes, frente a $0.055012 de GPT-6.1 Sol con low; ambos obtuvieron 24/24 en la ejecución principal. Evalúe Terra para el trabajo por lotes con validación y compárelo con Sol para el trabajo interactivo: las medianas de tiempo de respuesta fueron de 5.75 y 4.51 segundos, respectivamente. Estas tareas sintéticas no demuestran una equivalencia general de calidad.
¿Se puede desactivar el razonamiento para procesar facturas?
GPT-6.1 Terra con none solo resolvió correctamente 3/8 imágenes de facturas y 0/8 cálculos equivalentes en texto en nuestra ejecución principal. Mantenga los cálculos monetarios exactos en código y valide los operandos extraídos. Para tareas acotadas de tablas o selección de botones, none obtuvo aquí 16/16 y es un candidato para una evaluación específica de su carga de trabajo.