
Coste de comprimir el contexto: turnos hasta amortizarlo
Contenido
- ¿Qué problema quieres resolver con la compresión?
- Escenario 1: ¿qué hacer si el modelo se queda sin contexto?
- Escenario 2: ¿conviene comprimir antes de pasar a un tramo más caro?
- Escenario 3: ¿cuántos turnos adicionales amortizan una compresión?
- ¿La compresión desperdicia el sobrecoste de escritura en caché?
- ¿Cómo se compara la fórmula de amortización con los resultados medidos?
- ¿Qué cambia con la caché implícita de DeepSeek?
- ¿Cómo influye el crecimiento en el momento de comprimir?
- ¿Qué intervalo sugiere el modelo para un trabajo continuado?
- ¿Cómo medir el coste completo?
- ¿Qué política conviene desplegar?
- Preguntas frecuentes
- ¿La compresión del contexto siempre reduce el coste de la API?
- ¿Debo comprimir justo al llegar a un umbral de precios?
- ¿Puedo esperar a que se llene la ventana de contexto?
- ¿Un crecimiento más rápido del contexto siempre amortiza antes un resumen?
- ¿La caché implícita justifica esperar hasta el límite de contexto?
La compresión del contexto en Claude Sonnet 5.5 se amortizó tras 4-6 solicitudes adicionales en seis ejecuciones con caché caliente que partían de unos 14k tokens. Ese intervalo corresponde a esa carga de trabajo concreta. La política debe tener en cuenta la generación del resumen, el modelo real de facturación de la caché y si queda trabajo suficiente para amortizar la intervención.
TL;DR
- Cuando falta espacio en la ventana de contexto, reducir el contexto activo es una necesidad de capacidad; nuestras pruebas no midieron la ventana máxima de ningún modelo.
- Una consulta quedó aproximadamente en el punto de equilibrio tras generar un resumen en el tramo caro ($0.0560882 frente a $0.0560655 conservando el historial); dos consultas amortizaron claramente el resumen en ese ejemplo.
- Una comprobación retrospectiva con la fórmula estimó 4-5 turnos hasta la amortización, frente a los 4-6 medidos; no fue una prueba de predicción a futuro.
- Una tarea de consulta de archivos con seis preguntas costó $0.0156941 con compresión y $0.0059911 sin ella, con una precisión de 6/6.
¿Qué problema quieres resolver con la compresión?
Define por qué necesitas reducir el contexto antes de elegir un umbral de tokens. Un límite estricto de contexto, un tramo de precios más alto y una conversación larga sin otras restricciones requieren decisiones distintas.
La compresión del contexto sustituye el contenido anterior de la conversación por una representación más breve que se usa en las solicitudes posteriores. En nuestros experimentos usamos resúmenes de texto generados en el cliente: una llamada normal al modelo producía el resumen y la aplicación sustituía el historial anterior por ese texto. Las funciones nativas de compresión firmada o cifrada tienen otros contratos de solicitud y de contabilización del uso.
| Situación | Objetivo principal | ¿Cuándo actuar? | Evidencia en este artículo |
|---|---|---|---|
| Cerca del límite de la ventana de contexto del modelo | Poder seguir ejecutando la tarea | Cuando haga falta reservar espacio para la siguiente entrada, el resultado de una herramienta y la salida | Límites documentados del modelo y una política de ingeniería; ningún experimento con la ventana máxima |
| Cerca de un tramo de precios más alto | Reducir el coste total de la carga de trabajo | Cuando el ahorro previsto por la tarifa supere el coste del resumen y de la continuación | Un pequeño experimento de tramos de precios sin caché |
| Con margen en la ventana y en el tramo de precios | Mejorar una carga de trabajo concreta | Cuando quede suficiente trabajo útil para amortizar el resumen sin perder el estado necesario | Comparaciones con retención de estado en caché y una tarea breve de consulta de archivos |
Escenario 1: ¿qué hacer si el modelo se queda sin contexto?
Reduce o reorganiza el contexto activo antes de que la siguiente solicitud pueda superar la ventana admitida. Llegados a ese punto, continuar con la transcripción completa puede dejar de ser viable.
Claude Haiku 5.5 documenta una ventana de 1M tokens y una salida máxima de 128K en sus especificaciones del modelo. Son especificaciones publicadas. No probamos el contexto máximo aceptado en nuestra ruta del gateway, y el experimento de tramos de precios que aparece más abajo no determina ese límite.
Reserva espacio para la siguiente entrada, el resultado de una herramienta y la salida que requiera el servicio. Actúa mientras la solicitud de resumen todavía quepa. Conserva el estado esencial en un resumen o en registros de origen recuperables, y evalúa si la tarea puede continuar correctamente; un rechazo por exceder la ventana no sirve como referencia de ejecución correcta más barata.
Escenario 2: ¿conviene comprimir antes de pasar a un tramo más caro?
Comprime cuando el trabajo restante previsto permita amortizar el resumen con los precios reales. Cruzar un umbral de precios puede hacer que la compresión resulte rentable, pero el propio resumen podría facturarse en el tramo caro.
Claude Haiku 5.5 cambia de precio por encima de 100,000 tokens de entrada. Las tarifas estándar de entrada y salida, consultadas el 4 de noviembre de 2026, son $0.10/$0.50 por millón de tokens hasta ese límite y $0.50/$2.50 por encima.
Enviamos registros ficticios variados de una biblioteca a través del gateway de Synthorai. Una solicitud con 94,350 tokens de entrada costó $0.009437; otra con 111,999 costó $0.0560095. Ambas generaron cuatro tokens de salida. La diferencia de coste incluye tanto la longitud de la entrada como el tramo de precios.
Después resumimos el historial más grande. Esa llamada procesó 112,028 tokens de entrada, sin aciertos de caché notificados, y costó $0.0560715 en el tramo más caro. Ambas opciones respondieron correctamente a las consultas de cantidades y fuentes.
| Consultas restantes | Conservar el historial | Resumen más consultas con contexto reducido | Conservar, recalculado con la tarifa baja | Comprimir, recalculado con la tarifa baja |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
Con una consulta, ambas opciones quedaron prácticamente en equilibrio: la diferencia fue de $0.0000227. Dos consultas amortizaron claramente el resumen en este ejemplo. Recalcular todos los tokens con la tarifa baja permite separar el efecto del volumen del efecto de la tarifa.
Estas solicitudes sin caché describen una sola tarea sintética. Un historial con caché caliente se comporta de otra manera. Comprueba cuánto se aleja el resumen del umbral y cuándo volverá a cruzarlo la nueva entrada; consulta los tramos de precios para contextos largos.
Escenario 3: ¿cuántos turnos adicionales amortizan una compresión?
Medimos 4-6 turnos adicionales para Claude Sonnet 5.5 en seis ejecuciones con caché que comenzaban con unos 13.5k-14.2k tokens de entrada. Aquí, un turno equivale a una solicitud posterior al modelo. El experimento incluyó la generación del resumen y las escrituras posteriores en caché, y localizó el primer punto de amortización dentro de las doce solicitudes de continuación tras el calentamiento compartido. En las seis ejecuciones, una vez alcanzado ese punto, la compresión no volvió a ser más cara hasta la solicitud 12 inclusive. Esta observación no cubre una caducidad posterior de la caché, otro resumen ni un cambio de tarea.
¿La compresión desperdicia el sobrecoste de escritura en caché?
Las escrituras ya pagadas son costes hundidos cuando se toma la decisión. Lo que importa es si el ahorro en lecturas futuras cubre la solicitud de resumen y las nuevas escrituras. Estos experimentos usaron caché explícita de cinco minutos; las cachés implícitas tienen precios específicos de cada proveedor y pueden no aplicar el mismo sobrecoste de escritura.
Una ejecución con crecimiento medio muestra la diferencia entre la primera intervención y otro resumen posterior en la sesión:
| Intervención | Coste de lecturas futuras evitado | Escrituras adicionales durante la continuación | Coste de generar el resumen | Resultado neto al llegar al turno 12 |
|---|---|---|---|---|
| Primer resumen frente a conservar el historial | $0.0159875 | $0.0010175 | $0.0049761 | $0.0099939 más barato |
| Segundo resumen frente a quedarse con uno | $0.0037283 | $0.0013925 | $0.0065302 | $0.0041844 más caro |
La segunda fila incluye $0.0000100 menos en otros tokens. Los cargos del resumen incluyen sus propias categorías de caché; no los cuentes dos veces. Las categorías de tokens no permiten identificar qué entradas concretas nunca se reutilizaron.
¿Cómo se compara la fórmula de amortización con los resultados medidos?
Un modelo sencillo de caché caliente estima los turnos restantes necesarios. Sea H el número de tokens del historial sustituido, S los tokens de entrada del resumen que lo reemplaza, A el coste total de la solicitud de resumen, r el precio por token leído de la caché y w el precio por token escrito en ella. Conserva las instrucciones que no cambien antes del historial sustituido.
En n solicitudes futuras, conservar el historial cuesta n*r*H. Sustituirlo cuesta A + w*S + (n-1)*r*S. La diferencia incremental es:
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
La fórmula supone H > S, que el contenido pueda almacenarse en caché de inmediato, precios constantes y las mismas adiciones, salidas y operaciones con herramientas posteriores. No cubre la caducidad de la caché, las reescrituras adicionales del prefijo conservado ni los costes de recuperar la calidad. Si cambian esas condiciones, calcula el coste por tramos.
Aplicamos la fórmula de forma retrospectiva después de los experimentos. El cálculo usa los registros de uso del calentamiento y del resumen, no los costes posteriores, pero ya conocíamos los resultados. Es una comprobación retrospectiva, no una validación con datos reservados ni una predicción a futuro. El análisis aproxima H con la entrada total del calentamiento y S con los tokens de salida del resumen. No coinciden exactamente con el historial sustituible y la entrada de reemplazo debido a las instrucciones estables, el texto de encuadre y los requisitos de la caché.
| Crecimiento de la entrada | Ejecución | Estimación retrospectiva | Amortización medida |
|---|---|---|---|
| Unos 96 tokens/turno | 1 | 5 turnos | 6 turnos |
| Unos 96 tokens/turno | 2 | 5 turnos | 6 turnos |
| Unos 1.4k tokens/turno | 1 | 5 turnos | 5 turnos |
| Unos 1.4k tokens/turno | 2 | 4 turnos | 4 turnos |
| Unos 5.2k-5.5k tokens/turno | 1 | 5 turnos | 5 turnos |
| Unos 5.2k-5.5k tokens/turno | 2 | 4 turnos | 5 turnos |
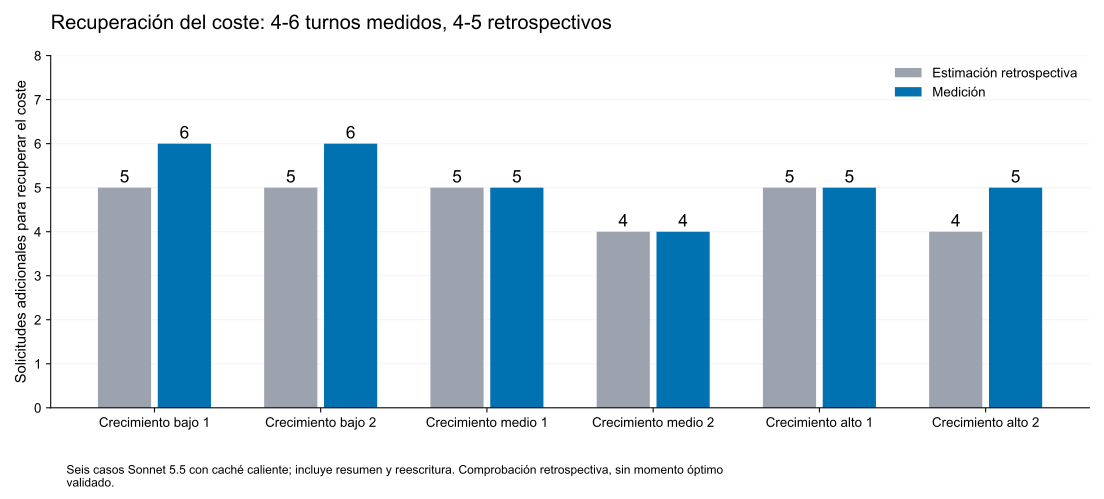
El error de la comprobación retrospectiva fue de un turno como máximo en estas seis ejecuciones. Para tomar una decisión futura hacen falta estimaciones de A y S a partir de resúmenes anteriores y validación con tareas nuevas; esta comparación no garantiza un margen de error general.
¿Qué cambia con la caché implícita de DeepSeek?
Que no haya una tarifa de escritura en caché independiente no significa que la entrada sea gratuita después de comprimir. DeepSeek V4.1 Flash 1017 usa caché automática y precios de entrada distintos para aciertos y fallos de caché. Su página de precios no indica ningún cargo de escritura independiente. Un prefijo de resumen nuevo sigue pagando la tarifa de entrada sin caché cuando no está almacenado.
La documentación de la caché exige que coincidan las unidades de prefijo persistidas. La construcción tarda segundos y los aciertos no están garantizados, por lo que el reemplazo puede provocar fallos de caché en más de una solicitud. Registra prompt_cache_hit_tokens y prompt_cache_miss_tokens; no des por hecho que habrá exactamente una llamada en frío ni que un prefijo de sistema sin cambios siempre tendrá un acierto.
Sea p el precio por token de entrada sin caché y m el número de solicitudes con el prefijo de reemplazo en frío dentro de las n solicitudes futuras. Si la referencia que conserva el historial sigue en caché y los costes comunes posteriores se cancelan:
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
Para una solicitud en frío, sustituye w por p, no por cero. Si no conoces m, calcula varios escenarios o aplica los precios a las categorías reales de aciertos y fallos, incluidos los fallos del prefijo estable y de la llamada de resumen.
Lo siguiente es un cálculo con la fórmula, no un experimento con DeepSeek. Usamos los precios oficiales de Flash fuera de las horas punta: $0.003/M para entrada con acierto de caché, $0.15/M para entrada sin caché y $0.60/M para salida. Suponemos un resumen de 1k tokens, el historial original en caché caliente, una solicitud de reemplazo en frío y un coste de resumen A = r*H + output_price*S. Ignoramos el texto de encuadre, el razonamiento y las herramientas.
| Historial original | Coste supuesto de la llamada de resumen | Amortización calculada |
|---|---|---|
| 10k tokens | $0.000630 | 29 solicitudes |
| 100k tokens | $0.000900 | 4 solicitudes |
Las lecturas baratas pueden favorecer la conservación de un historial corto en caché, mientras que un trabajo más largo puede amortizar la compresión. No medimos la calidad ni la amortización con DeepSeek. Recalcula para las tarifas de horas punta o las sesiones con tarifas mixtas.
¿Cómo influye el crecimiento en el momento de comprimir?
El crecimiento cambia el historial que hay en el momento de decidir. Si pasan j turnos antes de intervenir y cada uno añade g tokens, introduce H_j = H_0 + g*j en la fórmula de amortización, junto con el tamaño y el coste actuales del resumen.
Un crecimiento posterior idéntico añade costes comunes a ambas opciones. Si los precios y el comportamiento de la caché no cambian, esos términos se cancelan. Un crecimiento más rápido alcanza antes los límites de capacidad o de precio, pero no determina por sí solo los turnos hasta la amortización.
En nuestras pruebas de crecimiento, el estado esencial siguió siendo pequeño mientras aumentaba el contenido de archivo. Repetir la compresión costó más que generar un solo resumen con crecimiento medio y menos con crecimiento alto en las dos ejecuciones de doce turnos. Todas las políticas respondieron correctamente a 96/96 consultas de estado, incluida la ampliación; eso no prueba un crecimiento ilimitado del estado esencial.
¿Qué intervalo sugiere el modelo para un trabajo continuado?
Para una tarea larga con crecimiento, tamaño de resumen, precios y comportamiento de caché aproximadamente constantes, sea F el cargo fijo por ciclo de compresión, incluida la salida del resumen y la reescritura del reemplazo. Excluye los costes lineales con el intervalo: su aportación amortizada por turno es constante. Si el modelo que resume lee el historial desde la caché, estima F como A - r*H + w*S; otros esquemas de precios requieren su propio desglose. Si g es el crecimiento por turno y k el intervalo entre resúmenes, el coste medio que depende del intervalo es:
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
Esto requiere valores positivos de F, r y g, resúmenes conservados pequeños y una calidad de ejecución comparable. Si el crecimiento es cero, no hay un disparador periódico motivado por el crecimiento; si las lecturas son gratuitas, este modelo no ofrece amortización por ahorro de lecturas. Con nuestros precios de caché explícita y tamaños de resumen, los intervalos candidatos rondan los 30, 7-8 y 4 turnos para un crecimiento bajo, medio y alto. Prueba los enteros cercanos, con un mínimo de una solicitud y respetando el margen de capacidad; no hicimos un barrido de intervalos que demostrara que estos fueran óptimos. Una caché que cobra por los fallos necesita su propio desglose de costes fijos.
Un cálculo concreto permite ver las unidades. En una ejecución registrada con crecimiento medio, A = $0.0049761, H = 13,712, S ≈ 341 y g ≈ 1,396 tokens/turn. Con r = $0.10/M y w = $2.50/M obtenemos:
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
Este cálculo obtiene un candidato a partir de valores registrados; no demuestra que una política de ocho solicitudes sea óptima. La comprobación del horizonte restante es independiente: si se estima que una intervención se amortizará tras cinco solicitudes y solo quedan tres, omite esa intervención opcional aunque el temporizador periódico indique que ya toca.
Si una tarea está a punto de terminar, omite otro resumen opcional cuando no pueda amortizarse con las solicitudes restantes. La capacidad, los tramos de precios y la conservación de la información necesaria tienen prioridad sobre este modelo monetario simplificado.
Una tarea breve de consulta de archivos ilustra este filtro. Ambas estrategias respondieron correctamente a seis cantidades, pero conservar el historial costó $0.0059911, frente a $0.0156941 con el resumen incluido. Seis consultas no amortizaron esa intervención. El resumen conservó suficiente detalle; no hizo falta ninguna consulta adicional. El horizonte de amortización depende del resumen y de la carga de trabajo reales, no de una regla universal de cuatro a seis turnos.
¿Cómo medir el coste completo?
Incluye el resumen, la primera solicitud reescrita y todas las continuaciones. La reducción de tokens del prompt y el porcentaje de aciertos de caché no bastan para demostrar un ahorro.
Para Claude Sonnet 5.5, calculamos los costes con $2/M para entrada nueva, $2.50/M para escrituras en caché de cinco minutos, $0.10/M para lecturas de caché y $10/M para salida. Las lecturas de caché son baratas, pero siguen costando dinero. Sustituir un historial en caché caliente puede provocar una nueva escritura, mientras que un resumen muy corto puede no cumplir los requisitos mínimos para almacenarse en caché. Nuestros puntos de corte explícitos en los bloques de contenido produjeron escrituras y lecturas de caché medibles; algunos prefijos comprimidos cortos no notificaron ninguna de las dos al principio.
Esta función supone un número determinado de solicitudes con el prefijo en frío. Pasa el precio de escritura explícita o el precio de entrada sin caché implícita como cold_input_per_million:
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
Para decidir antes de comprimir, estima el coste del resumen a partir de llamadas anteriores. Valida con los registros completos de uso, incluidos los fallos y el trabajo de recuperación; que falte un registro no convierte la solicitud en gratuita.
Las mediciones se realizaron el 4 de noviembre de 2026 a través de la interfaz Messages del gateway, con el razonamiento desactivado y sin herramientas alojadas. Las respuestas normales se limitaron a 128 tokens de salida y los resúmenes a 2,048. Los costes se reconstruyeron a partir del uso devuelto, aplicando los precios estándar, y se contrastaron con los costes notificados por el gateway. No constituyen una conciliación con la factura del proveedor. Las cargas de trabajo normales usaron resúmenes en el cliente, no una implementación nativa de compresión.
¿Qué política conviene desplegar?
Aplica primero las restricciones de capacidad y tarifa, dejando margen para entrada, herramientas y salida. En cargas de trabajo de Claude Sonnet 5.5 con caché explícita, incluye los sobrecostes de escritura y los cargos del resumen, y omite las intervenciones opcionales que probablemente no se amorticen antes de terminar. Valida los intervalos enteros cercanos al candidato analítico con las mismas llegadas de tareas y los mismos turnos de finalización.
Para la caché implícita de DeepSeek V4.1 Flash 1017, conserva un prefijo útil si los aciertos son estables y queda poco trabajo. Puede ser razonable activar la compresión más tarde mediante un umbral preventivo de capacidad; que no haya una tarifa de escritura independiente no implica esperar al límite estricto. Para trabajos más largos, estima los costes reales de aciertos y fallos y supervisa las solicitudes posteriores a una reescritura hasta que aparezcan aciertos.
Recalcula cuando cambien los precios, el estado de la caché, el modelo o el tamaño del estado esencial. Conserva fuentes recuperables y valida los valores modificados en las tareas sensibles al detalle. Registra el resumen y el uso posterior en una misma sesión de agente, usando las categorías de tokens correctas.
Preguntas frecuentes
¿La compresión del contexto siempre reduce el coste de la API?
El ahorro debe superar los costes del resumen, la reconstrucción de la caché y la recuperación. Nuestra tarea de archivo con seis consultas costó $0.0156941 con resumen frente a $0.0059911 conservando el historial, en ambos casos con una precisión de 6/6.
¿Debo comprimir justo al llegar a un umbral de precios?
Un umbral de precios es un punto en el que evaluar todo el trabajo restante, no una orden automática de resumir. En nuestro ejemplo con Claude Haiku 5.5, el propio resumen se facturó por encima de 100,000 tokens; una consulta posterior quedó aproximadamente en equilibrio, mientras que dos lo amortizaron claramente.
¿Puedo esperar a que se llene la ventana de contexto?
Deja espacio para la solicitud de resumen, la siguiente entrada o resultado de herramienta y la salida. Si el historial ya es demasiado grande, puede que tampoco quepa en una solicitud para resumirlo. No medimos el límite de fallo de la ventana máxima.
¿Un crecimiento más rápido del contexto siempre amortiza antes un resumen?
Un crecimiento compartido más rápido aumenta el coste de ambas estrategias y no incrementa automáticamente el ahorro de un resumen. Repetir la compresión puede limitar la acumulación posterior, pero añade costes de resumen y reescritura. En nuestras ejecuciones con crecimiento medio, repetir la compresión costó más que un único resumen a lo largo de doce turnos; con crecimiento alto, resultó mejor repetirla. Elige la política según el crecimiento, el horizonte restante y el estado que debas conservar.
¿La caché implícita justifica esperar hasta el límite de contexto?
La caché implícita puede favorecer la conservación de un historial barato en caché caliente durante una tarea corta. DeepSeek V4.1 Flash 1017 sigue cobrando la entrada sin caché cuando el prefijo del resumen no está almacenado, y la persistencia no está garantizada. Estima el beneficio restante y deja margen para herramientas, entrada y salida antes de alcanzar la ventana admitida. Los valores de DeepSeek anteriores son cálculos, no umbrales medidos.