
Caché de prompts: cinco comprobaciones antes de culpar al routing
Contenido
- ¿Qué hay que comprobar primero cuando desaparecen los aciertos de caché?
- ¿Qué ajustes de la aplicación y qué tiempos conviene revisar?
- ¿Qué puede cambiar un gateway entre el cliente y el proveedor?
- ¿Cómo se investiga una regresión de caché en Synthorai?
- Una sesión medida: localizar la regresión y revisar sus spans
- ¿Cómo ayudan los diagnósticos nativos a identificar cambios en una petición?
- ¿Cuándo hay que investigar el propio servicio de inferencia?
- ¿Cómo se demuestra que una corrección ha funcionado?
- Preguntas frecuentes
- ¿Añadir cache_control garantiza un acierto?
- ¿Puede el enrutamiento causar un fallo de caché aunque no cambie el nombre del modelo?
- ¿Por qué los diagnósticos indican que la petición cambió si algunos tokens estaban en caché?
Para diagnosticar fallos de caché de prompts, revisa primero los datos de uso. Después, compara el prefijo reutilizable, los requisitos, los tiempos y el destino real de las peticiones al proveedor con una petición de referencia que haya usado la caché.
TL;DR
- Si faltan los datos de uso de caché, el resultado es desconocido; un valor de cero en las lecturas notificadas no identifica la causa.
- La tasa de aciertos por petición cuenta las peticiones que reutilizan algún contenido; la proporción de tokens reutilizados mide cuánto de la entrada se ha reutilizado.
- Cada estado del diagnóstico nativo requiere una acción distinta: corregir una diferencia, sustituir una referencia ausente o investigar una comparación no concluyente.
- DeepSeek necesita que coincidan unidades de prefijo persistidas; compartir un prefijo de texto puede no bastar.
¿Qué hay que comprobar primero cuando desaparecen los aciertos de caché?
Empieza por comprobar si la respuesta original contiene datos de uso de caché. Si el proveedor notifica lecturas pero el cliente o el panel no las muestran, investiga primero cómo se registran y presentan esos datos. En caso contrario, conserva la última petición con uso de caché confirmado y compara con ella la petición que falla.
| Primera comprobación | Evidencias que recopilar | Siguiente acción mínima útil |
|---|---|---|
| ¿El fallo es real? | Datos de uso originales del proveedor, respuesta del cliente y registro del panel | Comprueba los campos ausentes y la agregación del streaming antes de modificar los prompts |
| ¿Ha cambiado el prefijo? | Herramientas en su orden original, texto de sistema y mensajes anteriores | Compara los componentes; mueve cualquier timestamp o ID de petición variable detrás del contenido reutilizable |
| ¿El prefijo cumplía los requisitos y se escribió en caché? | Mínimo del modelo, controles y datos de lectura/escritura | Comprueba el modelo y la API exactos; revisa el punto de corte previsto |
| ¿La petición llegó demasiado pronto o demasiado tarde? | Hora de inicio de la respuesta, intervalo entre peticiones y duración de la caché | Ejecuta una petición posterior de forma secuencial antes de probar tráfico paralelo |
| ¿Cambió el destino? | Modelo efectivo, servicio, ámbito de la cuenta e intentos de fallback | Pide al operador del gateway que compare los intentos reales enviados a los proveedores |
Usa dos métricas con nombres explícitos, calculadas sobre las peticiones que tengan datos completos de entrada y caché:
- Tasa de aciertos por petición = peticiones con más de cero tokens leídos de caché / peticiones con datos de uso completos.
- Proporción de tokens reutilizados = suma de tokens leídos de caché / suma de todos los tokens de entrada, incluidos los de entrada en caché y las escrituras en caché.
Informa por separado de las peticiones sin datos de uso e incluye los intentos fallidos en el coste del incidente. Si la entrada crece, la proporción de tokens reutilizados puede bajar sin que cambie la tasa de aciertos por petición.
| API nativa | Campo de lectura de caché | Entrada total usada como denominador en la proporción de tokens |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens, que ya incluye la entrada en caché |
| Anthropic Messages | usage.cache_read_input_tokens | input_tokens + cache_read_input_tokens + cache_creation_input_tokens dentro de usage |
| DeepSeek | usage.prompt_cache_hit_tokens | prompt_cache_hit_tokens + prompt_cache_miss_tokens dentro de usage |
Usa el esquema normalizado del gateway cuando se hayan convertido los campos nativos; más abajo aparece la fórmula de Synthorai.
¿Qué ajustes de la aplicación y qué tiempos conviene revisar?
Comprueba si ha cambiado el contenido situado antes del prefijo que esperas reutilizar. Los timestamps del sistema, el orden de las herramientas y el historial reescrito son buenos puntos de partida.
Cambios en el prefijo. Captura huellas separadas (hashes para detectar cambios) de las definiciones de herramientas ordenadas, el texto de sistema estable y los bloques de mensajes anteriores. Deja al final un marcador específico de cada petición. El hash de la petición completa cambiará cuando una conversación crezca añadiendo mensajes, como es normal, y no permitirá localizar la primera diferencia. Los espacios del JSON fuera del texto tampoco son equivalentes a los espacios dentro de una cadena visible para el modelo.
Revisa dónde se inserta el contenido recuperado, los cambios de modo, la compactación y la petición final que genera el framework. Para entradas multimodales, compara el preprocesamiento y las referencias a archivos.
Requisitos y controles. Un punto de corte marca el final del prefijo que se solicita almacenar en caché. El tiempo de vida (TTL) es la duración configurada para esa entrada de caché.
Que la petición completa sea larga no garantiza que el prefijo seleccionado para reutilizar cumpla el mínimo del modelo. Con puntos de corte explícitos, comprueba el contenido anterior al punto de corte. Añadir cache_control no permite reutilizar un prefijo que no cumpla los requisitos. En Anthropic, revisa los controles automáticos frente a los de bloque, los conflictos de TTL y los límites de puntos de corte; una combinación no válida puede producir un HTTP 400, que indica que la petición se ha rechazado, en lugar de una respuesta correcta con cero lecturas de caché. Caché de prompts de Anthropic.
Disponibilidad y caducidad. Enviar una ráfaga de peticiones idénticas antes de que esté disponible la primera escritura puede generar varias peticiones sin caché. Anthropic documenta que la caché está disponible una vez iniciada la primera respuesta. Envía una petición posterior después de que empiece la primera respuesta para establecer una referencia con caché; después, compara las peticiones paralelas usando sus timestamps de inicio de respuesta. Si la conversación ha estado inactiva, compara el intervalo con la duración configurada de la caché y con el comportamiento de renovación documentado. Disponibilidad de la caché de Anthropic.
Unidades persistidas de DeepSeek. DeepSeek busca coincidencias con unidades completas de prefijo persistidas, que son partes guardadas del contexto anterior. Su ejemplo documentado empieza con A+B, seguido de A+C: la segunda petición no puede reutilizar la unidad completa A+B. Cuando el servicio detecta y persiste el prefijo común A, una tercera petición A+D puede reutilizar esa unidad. Aquí, A es el contexto estable y B, C y D son sufijos distintos. Este mecanismo está documentado por el proveedor; no es una medición nuestra.
Para este patrón, conserva A exactamente igual, completa las dos primeras peticiones de forma secuencial, deja margen para que la persistencia tarde unos segundos y revisa los campos de tokens con y sin acierto de caché de la tercera petición. Esperar no garantiza por sí solo que se haya creado la unidad de prefijo común deseada, y el almacenamiento en caché sigue siendo de mejor esfuerzo. Reglas de persistencia de DeepSeek.
¿Qué puede cambiar un gateway entre el cliente y el proveedor?
Un gateway puede modificar tanto la petición efectiva como las evidencias que recibe el cliente. Comprueba ambas cosas por separado antes de atribuir una regresión al enrutamiento.
Revisa los alias de modelos, el ámbito de las credenciales, las modificaciones impuestas por políticas y los intentos de fallback. Si hay conversión de protocolos, inspecciona los controles enviados y los campos nativos devueltos; con streaming, compara los eventos de uso del proveedor con los datos de uso finales del cliente.
Cambios de proveedor en el enrutamiento. El balanceo o la conmutación por error pueden enviar un mismo modelo público a distintos proveedores de inferencia con cachés independientes. Un prefijo ya almacenado en el proveedor A no estará disponible en el proveedor B. Nuestro estudio sobre cambios de proveedor observó nueve destinos de origen y 4/20 aciertos por petición, frente a 19/20 en la comparación con un único backend. Estos resultados describen aquella configuración histórica.
Agrupa los intentos por proveedor, modelo y ámbito de cuenta. Compara las lecturas de caché dentro de cada grupo con prefijos e intervalos estables, incluidos los fallos y los destinos de fallback. Pide al operador que verifique la afinidad (el envío consistente de peticiones relacionadas al mismo destino) y la conmutación por error. Repite la prueba después de un ajuste aprobado. Los cambios de proveedor confirman una variación del destino; los fallos individuales siguen requiriendo comprobaciones de tiempos y requisitos.
Las peticiones de Synthorai no tienen selector de proveedor ni de canal.
¿Cómo se investiga una regresión de caché en Synthorai?
Usa Analytics para las tendencias de la carga de trabajo y Logs para las peticiones. Los nombres de la interfaz se verificaron en el servicio el 6 de noviembre de 2026.
- Acota la carga de trabajo. En Analytics, selecciona
Time rangeyAll keys · all models. En Logs, usaAdd filterconmodelokey. Mantén los mismos criterios de selección para los intervalos normales y los afectados.CACHE HITes una proporción de tokens reutilizados, no una tasa de aciertos por petición. - Inspecciona la petición. En
Overview, compara Input, Cache read, Output y las escrituras que correspondan enCost at your rate. Si las lecturas se mantienen estables mientras crece la entrada, puede deberse al crecimiento del contexto; si bajan las lecturas y suben las escrituras, conviene revisar el prefijo y los tiempos.Rawcontiene los campos almacenados, no la respuesta original del proveedor. - Sigue la traza y la sesión. Desde la petición afectada en Logs, selecciona
Open tracey despuésOpen session. EnTraces in this session, compara las tareas y abre la traza sin reutilización. Haz clic en cada span (operación individual) para revisar lecturas y escrituras de caché y cargos; el diagrama de cascada por sí solo no muestra la reutilización de caché. Usa los filtrossessionotracede Logs para consultar los registros correspondientes. Conserva los enlaces, los timestamps y los ID de respuesta nativos para escalar el caso.
Envía X-Session-Id por conversación, X-Trace-Id por tarea y X-Span-Id por operación. Agrupa por modelo y por el prefijo que se pretende compartir antes de interpretar las tendencias de caché.
La correlación y el enrutamiento son cosas distintas: X-Session-Id también tiene prioridad sobre la clave de caché del cuerpo para la afinidad del gateway; X-Trace-Id solo agrupa observaciones. Mantén estable la identidad de la sesión durante las comparaciones. Ninguno garantiza una caché compartida ni un destino fijo; no agrupes conversaciones sin relación para conseguir aciertos.
Para los registros completos almacenados en Synthorai, calcula la reutilización de tokens así:
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)
Aquí, cached_tokens ya está incluido en prompt_tokens; sumarlo otra vez contaría la entrada por duplicado. Las escrituras en caché van en el denominador, no en el numerador. Excluye los registros sin datos de uso e informa de su número por separado; un cero almacenado no demuestra por sí solo que el proveedor haya enviado una medición de cero.
Una sesión medida: localizar la regresión y revisar sus spans
Tras nuestra investigación del coste de agentes, enviamos seis peticiones Responses secuenciales a través de Synthorai el 6 de noviembre de 2026 con GPT-6.1 Sol. Una sesión contenía tres trazas, cada una con dos llamadas etiquetadas como lookup-1 y lookup-2. Estas etiquetas identifican llamadas sintéticas al modelo; no se ejecutó ninguna herramienta de búsqueda. El modelo, las herramientas y el ID de sesión no cambiaron. Para provocar la regresión, se añadió al principio de cada petición un valor nuevo con formato similar a un timestamp; la reparación restauró el prefijo original. Los marcadores de petición se mantuvieron al final.
| Traza | Tokens de entrada | Lecturas de caché | Reutilización | Coste notificado |
|---|---|---|---|---|
| referencia | 4,729 | 2,273 | 48.1% | $0.0063923 |
| regresión | 4,764 | 0 | 0% | $0.0119350 |
| reparación | 4,732 | 4,546 | 96.1% | $0.0009446 |
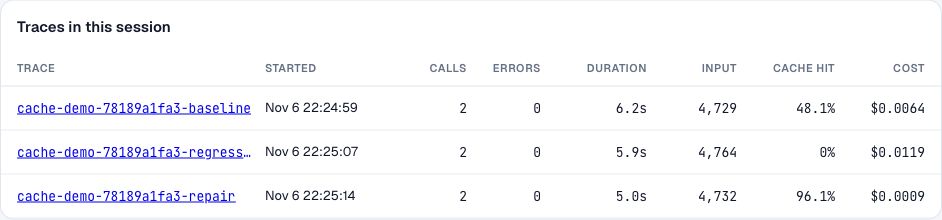
En Traces in this session, abre la fila de la regresión sin reutilización. La referencia incluye una primera llamada sin caché; la reparación reutiliza un prefijo ya almacenado. Esta demostración de seis llamadas muestra el fallo introducido y la recuperación, no una tasa de ahorro esperable en producción. La reutilización total de la sesión es 6,819 / 14,225 = 47.9%; esa media oculta la regresión.
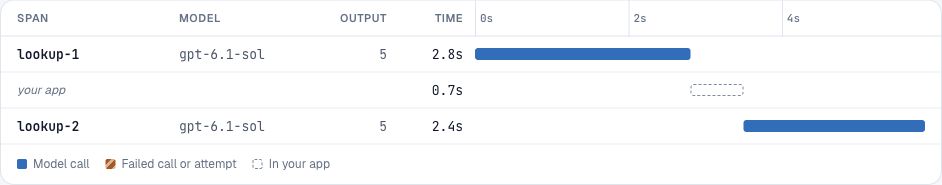
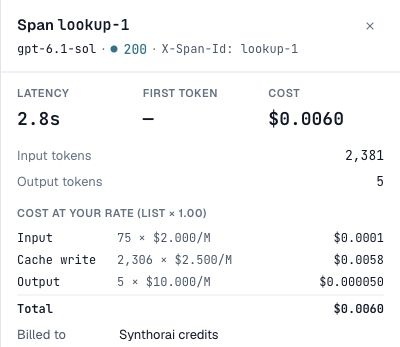
Selecciona lookup-1 en el diagrama de cascada. El detalle muestra 2,306 tokens de escritura en caché de un total de 2,381 tokens de entrada, coherente con la reconstrucción del prefijo modificado. Las peticiones sintéticas almacenadas permiten confirmar la diferencia introducida; la línea temporal por sí sola no puede identificarla. Usa Open in Logs para acceder al registro de la petición y comparar las huellas del prefijo capturadas en la aplicación.
En esta demostración no se solicitaron comparaciones de diagnóstico nativo. El cambio de prefijo introducido y los datos de uso notificados permiten confirmar la regresión y la recuperación observadas; no se verificó de forma independiente que el proveedor real se mantuviera. La identidad de la sesión no cambió, por lo que el experimento no mide el beneficio de la afinidad.
Con BYOK, distingue entre el coste notificado por el proveedor y el estimado antes de conciliar la factura. Solicita al operador evidencias de los destinos y fallbacks cuyos detalles no estén disponibles.
¿Cómo ayudan los diagnósticos nativos a identificar cambios en una petición?
Los diagnósticos nativos identifican diferencias entre peticiones; los datos de uso miden la reutilización notificada. Interprétalos juntos. La ruta elegida en el gateway debe admitir y conservar los campos nativos. Nuestra prueba comparativa anterior en Synthorai no devolvió diagnósticos, por lo que la documentación del proveedor no basta para confirmar su disponibilidad a través del gateway.
OpenAI Responses acepta prompt_cache_options.comparison_response_id en los modelos compatibles. Conserva el ID de la respuesta de referencia completada y envía el contenido real de la petición posterior; la referencia de comparación no carga el historial de conversación. Los resultados aparecen en prompt_cache_diagnostics, también en el evento response.completed cuando se usa streaming. Usa los estados siguientes para elegir la próxima acción. Las estimaciones de tokens del diagnóstico son independientes del uso facturado. Diagnósticos de caché de OpenAI.
Anthropic Messages usa diagnostics: {"previous_message_id": null} para activar inicialmente los diagnósticos y, en las siguientes peticiones con diagnósticos activados, el ID nativo del mensaje anterior. En streaming, el resultado aparece en message_start. Antes de interpretar un resultado nulo, comprueba que ambas peticiones activaron los diagnósticos y que la segunda envió una referencia real. Anthropic documenta los diagnósticos para la API de Claude, pero no para Amazon Bedrock ni para Claude gestionado por Google. Diagnósticos de caché de Anthropic.
| API y estado devuelto | Significado | Siguiente acción |
|---|---|---|
OpenAI cache_hit | La comparación no detectó ningún fallo | Consulta los datos de uso para cuantificar la reutilización; los tokens nuevos del sufijo pueden seguir necesitando procesamiento |
OpenAI cache_miss | Una diferencia clasificada afectó a la reutilización esperada | Revisa reason, corrige el componente previsto y vuelve a comparar |
OpenAI comparison_response_not_found | El registro de referencia no existe o ha caducado | Elige una respuesta reciente completada en la misma organización |
OpenAI unavailable | Comparación no compatible o no concluyente | Verifica la compatibilidad del modelo; prueba con una referencia reciente y, si persiste, recurre a comprobaciones manuales |
Anthropic diagnostics: null | Solo indica ausencia de diferencias si se ejecutó una comparación válida con los diagnósticos activados; también se devuelve sin activación o en el primer turno | Verifica primero la activación y la referencia; si la comparación es válida y hay pocas lecturas, comprueba la disponibilidad de la caché |
Anthropic cache_miss_reason: null dentro de un objeto de diagnóstico | Comparación pendiente | Comprueba el siguiente turno con los diagnósticos activados; no clasifiques el resultado pendiente como un fallo |
Anthropic, tipo de motivo *_changed | Primer componente diferente identificado | Corrige ese componente y vuelve a comparar; puede haber más diferencias posteriores |
Anthropic previous_message_not_found | No se conserva ninguna huella de referencia | Comprueba la activación en la petición anterior, la organización o el espacio de trabajo y el tiempo transcurrido; establece una nueva referencia |
Anthropic unavailable | Comparación no concluyente, incluidos ciertos cambios en otros parámetros o límites de comparación | Compara el valor efectivo de tool_choice, los ajustes de razonamiento y salida y las cabeceras beta; si persiste, recurre a comprobaciones manuales |
| Campo de diagnóstico ausente en cualquiera de las dos API | Faltan evidencias | Comprueba la compatibilidad de la API y el modelo, las opciones de la petición, la conversión y la captura de eventos de streaming |
El estado prompt_cache_key_changed de OpenAI requiere especial atención: los datos de uso pueden notificar un fallo sin que haya un fallo físico de caché. Comprueba si la clave cambió de forma intencionada para separar la contabilización antes de atribuir el resultado a la disponibilidad de la caché. Mantén la clave estable dentro del grupo de contabilización previsto y comprueba también su función en la afinidad del gateway. Motivos de diagnóstico de OpenAI.
¿Cuándo hay que investigar el propio servicio de inferencia?
Investiga la disponibilidad de la caché después de confirmar que el contenido cumple los requisitos, los tiempos son válidos, el ámbito del destino es comparable y los datos de uso son fiables. Incluso entonces, que la entrada no haya cambiado no garantiza que exista una entrada reutilizable.
Entre las posibles causas están la caducidad, la persistencia incompleta, la presión sobre la capacidad y la planificación del lado del servicio. OpenAI documenta restricciones de enrutamiento y disponibilidad de caché; una etiqueta de sesión no garantiza el acceso a un worker concreto. Un acierto parcial también puede indicar que un prefijo anterior sigue siendo reutilizable, mientras que el contenido posterior debe procesarse. Caché de prompts de OpenAI.
Un primer token lento o cero lecturas no demuestran un cambio de clúster. Al escalar el caso, aporta los ID de respuesta nativos, los timestamps, los intervalos y las etiquetas de destino; no des por resuelto el mecanismo sin evidencias del proveedor.
Los recursos de caché explícitos requieren otra comprobación: revisa la existencia, la caducidad y el ámbito del objeto referenciado. No diagnostiques un ID de recurso explícito obsoleto con los mismos supuestos que usarías para la caché automática de prefijos.
¿Cómo se demuestra que una corrección ha funcionado?
Compara el tráfico normal, el afectado y el posterior a la reparación usando datos de uso, diagnósticos y destinos.
Incluye los reintentos en el coste. Una corrección de los datos de uso debe hacer que coincidan los datos nativos y los del cliente. Una corrección del prefijo debe eliminar la diferencia y restaurar una reutilización comparable. Una corrección del enrutamiento debe confirmar el destino previsto y la recuperación dentro de ese ámbito. Si no se cumple la condición correspondiente, mantén el caso como no resuelto y continúa con las evidencias restantes.
Preguntas frecuentes
¿Añadir cache_control garantiza un acierto?
Los controles de caché siguen sujetos a la longitud del prefijo, su posición, la disponibilidad y la duración. Comprueba los requisitos del modelo y los datos de uso originales.
¿Puede el enrutamiento causar un fallo de caché aunque no cambie el nombre del modelo?
Un nombre de modelo estable en el cliente puede resolverse a distintos proveedores, modelos o ámbitos de cuenta. Compara los intentos reales con el operador del gateway usando el procedimiento para investigar cambios de proveedor.
¿Por qué los diagnósticos indican que la petición cambió si algunos tokens estaban en caché?
Un cambio en una parte avanzada de la petición puede dejar reutilizable un prefijo anterior. Interpreta el componente modificado junto con el número absoluto de tokens leídos de caché. La comparación de diagnóstico y la contabilización de caché describen aspectos distintos de la petición.
Para investigaciones relacionadas, consulta la auditoría de caché del gateway, los costes de escritura en caché y el momento de la compactación.