
GPT Image 1 Mini vs GPT Image 2
Welches Modell wofür
gpt-image-1-mini ist die günstige Stufe: $2 pro Million Eingabe und $8 pro Million Ausgabe gegenüber $5 und $30 - rund 2.5x und 3.75x weniger - auf einem festen Größensatz 1024x1024 / 1536x1024 / 1024x1536 / auto. gpt-image-2 kauft Auflösung: beliebige Größen mit Kanten bis 3840x2160 in Vielfachen von 16. Masken-Inpainting, png/jpeg/webp-Ausgabe und bis zu 10 Bilder pro Anfrage sind auf beiden gleich - nehmen Sie also das mini für 1K in großer Menge und gpt-image-2, wenn ein Bild größer als 1536px werden muss.
Preise
| GPT Image 1 Mini | GPT Image 2 | Δ | |
|---|---|---|---|
| Eingabe / 1M Tokens | $2 | $5 | 0.4× |
| Ausgabe / 1M Tokens | $8 | $30 | 0.27× |
Preise aus dem Live-Katalog, Stand des letzten Builds. Die aktuellen Preise stehen auf der jeweiligen Modellseite.
Einordnung: Ausgabepreis pro 1M Tokens aller 9 Bildgenerierung-Modelle mit dieser Abrechnungseinheit (logarithmische Skala)
Spezifikationen
| GPT Image 1 Mini | GPT Image 2 | |
|---|---|---|
| Eingabemodalitäten | Text Bild | Text Bild |
| Ausgabemodalitäten | Bild | Bild |
| Veröffentlicht | 2025-10-06 | 2026-04-21 |
| Ausgabegrößen |
|
|
| Eingabemodi | text-to-image, image edit with mask inpainting | text-to-image, image edit with mask inpainting |
| Bilder pro Anfrage | 10 | 10 |
| Formate | png, jpeg, webp | png, jpeg, webp |
| Anmerkungen | Cost-efficient version of GPT Image 1 1024x1024 / 1024x1536 / 1536x1024 editing via v1/images/edits vendor lists indicative per-image costs by quality tier (token-billed on Synthorai; see the live prices above) | Flexible resolutions: edges up to 3840px in multiples of 16, ratio <=3:1, ~0.65-8.3MP total (incl. 4K 3840x2160) editing with mask inpainting all image inputs processed at high fidelity significantly improved text rendering (precise placement can still struggle) |
Die Spezifikationen stammen aus der Dokumentation des jeweiligen Anbieters. Veröffentlicht ein Anbieter eine Angabe nicht, lassen wir die Zeile weg, statt sie zu schätzen. Vollständige Quellen: GPT Image 1 Mini · GPT Image 2
Ein Prompt, beide Modelle, gemessen über das Gateway
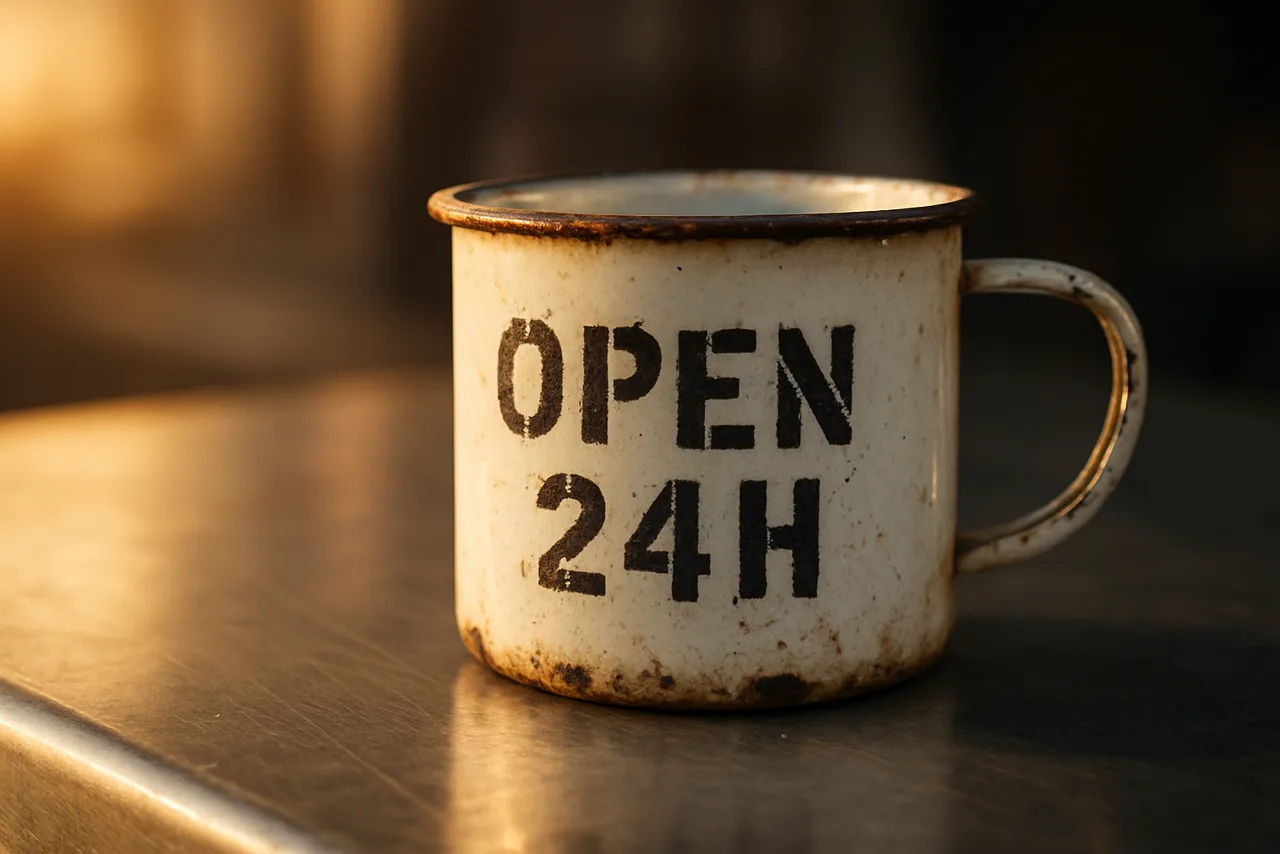
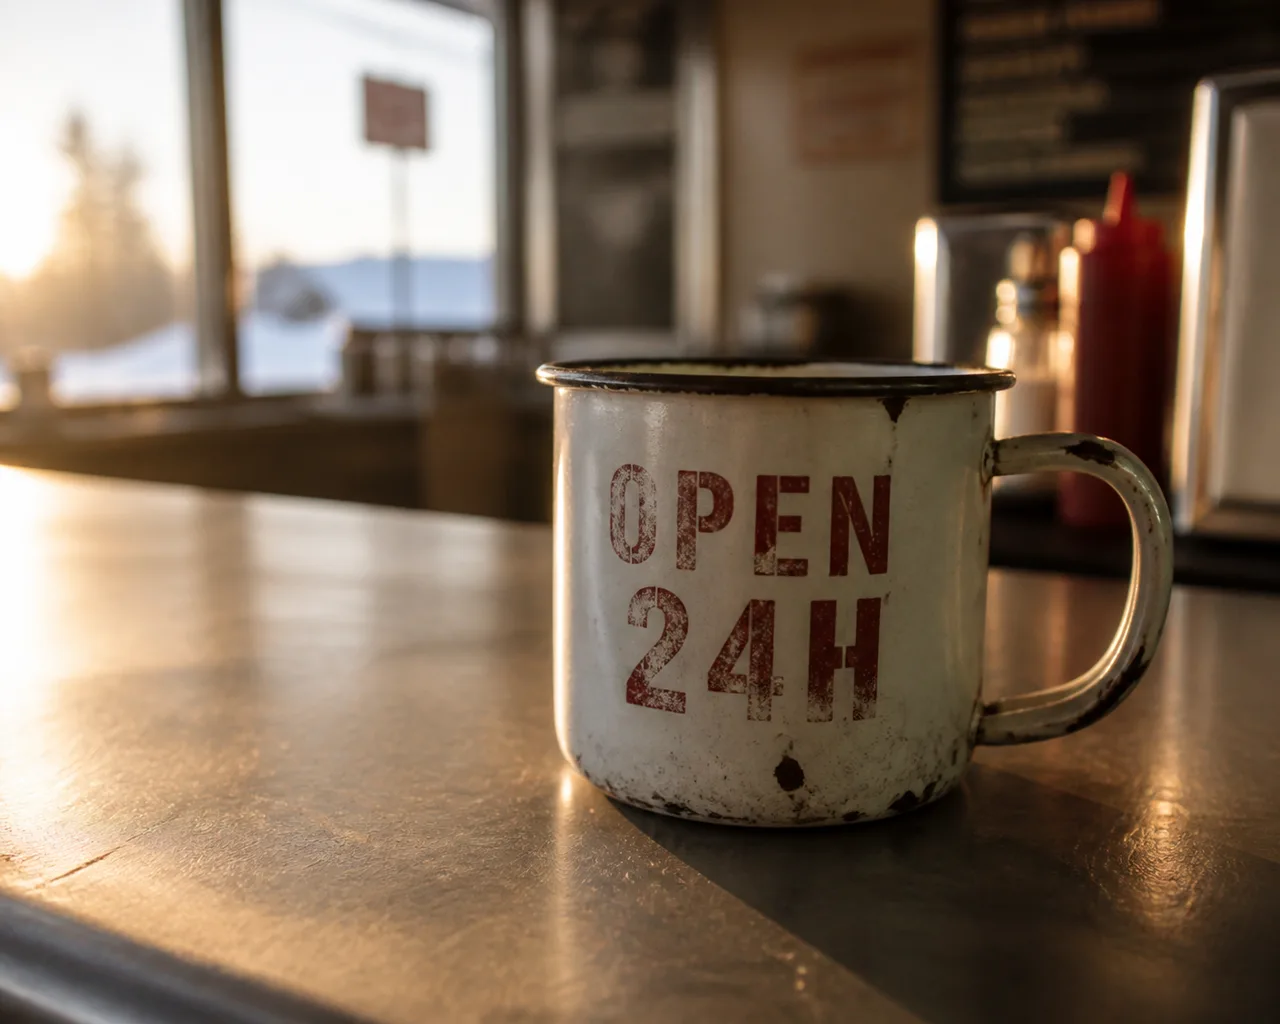
Ein Prompt, eine Anfrage pro Modell, keine Wiederholungen und keine Auswahl der besten Ergebnisse: Sie sehen das erste Ergebnis, das jedes Modell geliefert hat. Größe und Dauer haben wir nicht vorgegeben. Jedes Modell hat seinen eigenen Standardwert verwendet, denn eine Anfrage, die auf alle zugeschnitten ist, würde keinem gerecht. Die Dateien wurden für das Web neu kodiert. Beurteilen Sie deshalb Bildaufbau und Prompt-Treue, nicht die Kompression.
Eine Zeile genügt für den Wechsel
Beide IDs stehen in jedem Tab unten. Die beiden hervorgehobenen Zeilen sind die einzige Änderung. Gleicher Endpunkt, gleicher Schlüssel, gleiches Anfrageformat.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gpt-image-1-mini",
    # model="gpt-image-2",  # diese Zeile einkommentieren, die darüberliegende auskommentieren
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gpt-image-1-mini",
// model: "gpt-image-2", // diese Zeile einkommentieren, die darüberliegende auskommentieren
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-1-mini",
# "model": "gpt-image-2", # diese Zeile einkommentieren, die darüberliegende auskommentieren
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gpt-image-1-mini",
// Model: "gpt-image-2", // diese Zeile einkommentieren, die darüberliegende auskommentieren
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gpt-image-1-mini")
// .model("gpt-image-2") // diese Zeile einkommentieren, die darüberliegende auskommentieren
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Welches Modell ist günstiger: GPT Image 1 Mini oder GPT Image 2?
GPT Image 1 Mini ist bei Eingabe / 1M Tokens günstiger ($2 vs. $5, Faktor 2.5). Bei anderen Zeilen kann es umgekehrt sein. Die Tabelle oben zeigt alle Preise, und die tatsächlichen Kosten hängen von Ihrem Mix ab.
Kann ich GPT Image 1 Mini gegen GPT Image 2 A/B-testen, ohne zweimal zu integrieren?
Ja. Beide laufen über denselben OpenAI-kompatiblen Endpunkt mit einem API-Schlüssel. Für den Wechsel ändern Sie nur eine Zeile, den Modellnamen. So können Sie einen Teil des Traffics an jedes Modell schicken und die Kosten direkt vergleichen.
Ändert sich der Preis mit der Bildgröße?
Das hängt davon ab, wie das Modell abrechnet. Modelle mit Preis pro Bild kosten immer gleich viel, egal wie lang der Prompt oder wie groß die Ausgabe ist. Bei Modellen mit Token-Abrechnung steigt der Preis mit der Auflösung, ein 4K-Bild kostet also ein Vielfaches eines kleinen. Die Tabelle oben zeigt, was für welches Modell gilt.