
Bildbearbeitung: GPT Image 2.6 Sunburst vs Flare vs GPT Image 2
Inhalt
- Was ist neu bei GPT Image 2.6?
- Wie schneiden GPT Image 2, 2.5 und 2.6 in Arena ab?
- Wie bewältigten GPT Image 2, Sunburst und Flare dieselben Änderungen?
- Wie schnell lieferten die drei Modelle die Programmbearbeitung?
- Verbesserert hohe Komplexität die Programmbearbeitung?
- Wann hilft Markup GPT Image 2.6 bei der Auswahl des richtigen Objekts?
- Wie wurden die Bildbearbeitungen getestet?
- Häufige Fragen
- Ist der Vergleich mit GPT Image 2 beim Planungsaufwand gleichgesetzt?
- Wurde GPT Image 2.5 über Synthorai getestet?
- Wann sollte ich Markup für eine Bildbearbeitung verwenden?
- Wurden die Programmbearbeitungen mit hoher Komplexität zuverlässiger?
GPT Image 2 und beide Varianten von GPT Image 2.6 aktualisierten drei Felder auf demselben Lebensmitteletikett, ohne den übrigen Text zu verändern. Bei einem Konferenzprogramm bestand Sunburst 2/4 Durchläufe mit mittlerer Komplexität. Flare mit mittlerer Komplexität und GPT Image 2 mit Standardplanung bestanden jeweils 0/4. Im Programm sollten die Modelle zwei Vorträge tauschen und das Label FULL zusammen mit einem davon verschieben.
TL;DR
- GPT Image 2 und beide 2.6-Varianten bestanden dieselbe Änderung eines Lebensmitteletiketts.
- Beim Programm bestand Sunburst 2/4 mit mittlerer Komplexität. GPT Image 2 und Flare bestanden jeweils 0/4.
- Sunburst bestand 2/4 Programmbearbeitungen mit mittlerer und hoher
complexity. Flare tauschte beide Vorträge in 0/4 Durchläufen mit mittlerer und 2/4 mit hoher Komplexität. Vollständig korrekt waren bei beiden Einstellungen 0/4. - Ein visueller Hinweis steigerte die korrekte Zielauswahl von 1/4 auf 4/4, wenn der Text keine Position vorgab.
Was ist neu bei GPT Image 2.6?
OpenAI veröffentlichte Images 2.6 am 4. November 2026. Sunburst ist für detailreiche Arbeiten und konsistente Änderungen ausgelegt, Flare für schnellere Iterationen. Neu hinzugekommen sind außerdem visuelle Annotationen in der API, eine Steuerung für die Planung sowie GIF und SVG als Ausgabeformate. Versionshinweise von OpenAI
Die Einstellung complexity steuert die Planung vor dem Rendering. Die separate Einstellung quality bestimmt den Detailgrad beim Rendering. OpenAI dokumentiert die drei Planungsstufen low, medium und high. In der eigenen API ist high der Standardwert. Bei den 2.6-Anfragen wurden beide Parameter explizit gesetzt. OpenAI-Leitfaden zur Bilderzeugung
Wie schneiden GPT Image 2, 2.5 und 2.6 in Arena ab?
Die Werte für GPT Image 2.5 stammen ausschließlich aus Arenas öffentlichem Leaderboard für die Bearbeitung einzelner Bilder. Im Snapshot vom 12. November 2026 lagen die angezeigten Werte beider 2.5-Einträge über denen der aufgeführten 2.6-Medium-Einträge. Die Arena-Scores bilden die Präferenzen der Abstimmenden ab. Die Einträge unterscheiden sich bei der Anzahl der Stimmen und den Konfigurationsbezeichnungen. Die Werte unten übernehmen die von Arena ausgewiesene Unsicherheit. Arena-Leaderboard für die Bearbeitung einzelner Bilder
| Arena-Eintrag | Angezeigter Score | Stimmen |
|---|---|---|
| GPT Image 2.5 Sunburst | 1519 ± 5 | 131,648 |
| GPT Image 2.5 Flare | 1484 ± 4 | 128,720 |
| GPT Image 2.6 Sunburst (Medium) | 1476 ± 11 | 3,493 |
| GPT Image 2 (Medium) | 1462 ± 3 | 364,695 |
| GPT Image 2.6 Flare (Medium) | 1460 ± 10 | 3,534 |
„Medium“ ist die Bezeichnung des Arena-Eintrags. In unserem Gateway-Test enthielt die Anfrage an GPT Image 2 kein Feld complexity.
Wie bewältigten GPT Image 2, Sunburst und Flare dieselben Änderungen?
Alle drei Modelle bestanden die Änderung des Lebensmitteletiketts. GPT Image 2 und beide 2.6-Varianten änderten den Natriumwert, den Chargencode und das Nettogewicht korrekt. Der übrige Text blieb jeweils unverändert. Sunburst und Flare bestanden außerdem jeweils sechs von sechs einfachen Änderungen. Bei den Aufgaben mit Flaschenverschlüssen und Referenz-Labels blieben die umliegenden Details erhalten, sofern eine eindeutige Position angegeben war.
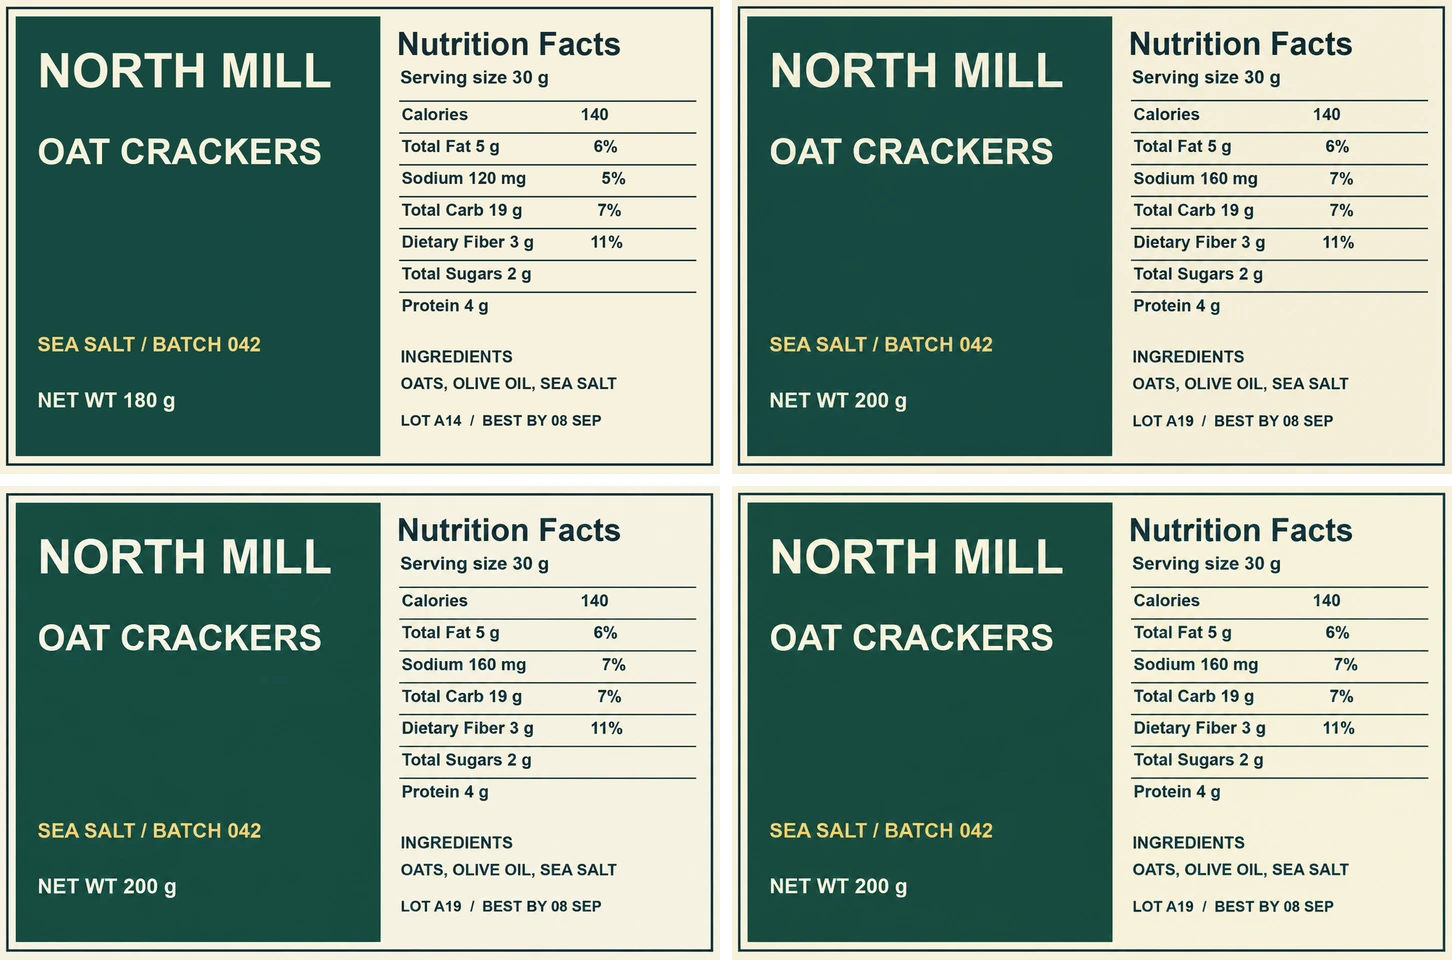
Obere Reihe: Original und GPT Image 2. Untere Reihe: Sunburst und Flare. GPT Image 2 verwendet die Standardplanung, beide 2.6-Varianten verwenden mittlere Komplexität.
Beim Programm sollten die Modelle die Titel und Sprecher von Studio B um 10:00 und Studio C um 11:30 tauschen und anschließend Sound Lab an seiner neuen Position mit FULL versehen. GPT Image 2 ließ Sound Lab durchgehend an seiner ursprünglichen Position und tauschte zwei andere Vorträge. Sunburst verschob in allen vier Durchläufen mit mittlerer Komplexität beide angeforderten Vorträge korrekt. In zwei davon blieb das Label an der alten Position.
| Modell | Planungseinstellung | Lebensmitteletikett, vollständig korrekt | Programm, beide Vorträge an den richtigen Positionen | Programm, vollständig korrekt |
|---|---|---|---|---|
| GPT Image 2 | Standard, Feld weggelassen | 1/1 | 0/4 | 0/4 |
| GPT Image 2.6 Sunburst | Medium | 1/1 | 4/4 | 2/4 |
| GPT Image 2.6 Flare | Medium | 1/1 | 0/4 | 0/4 |
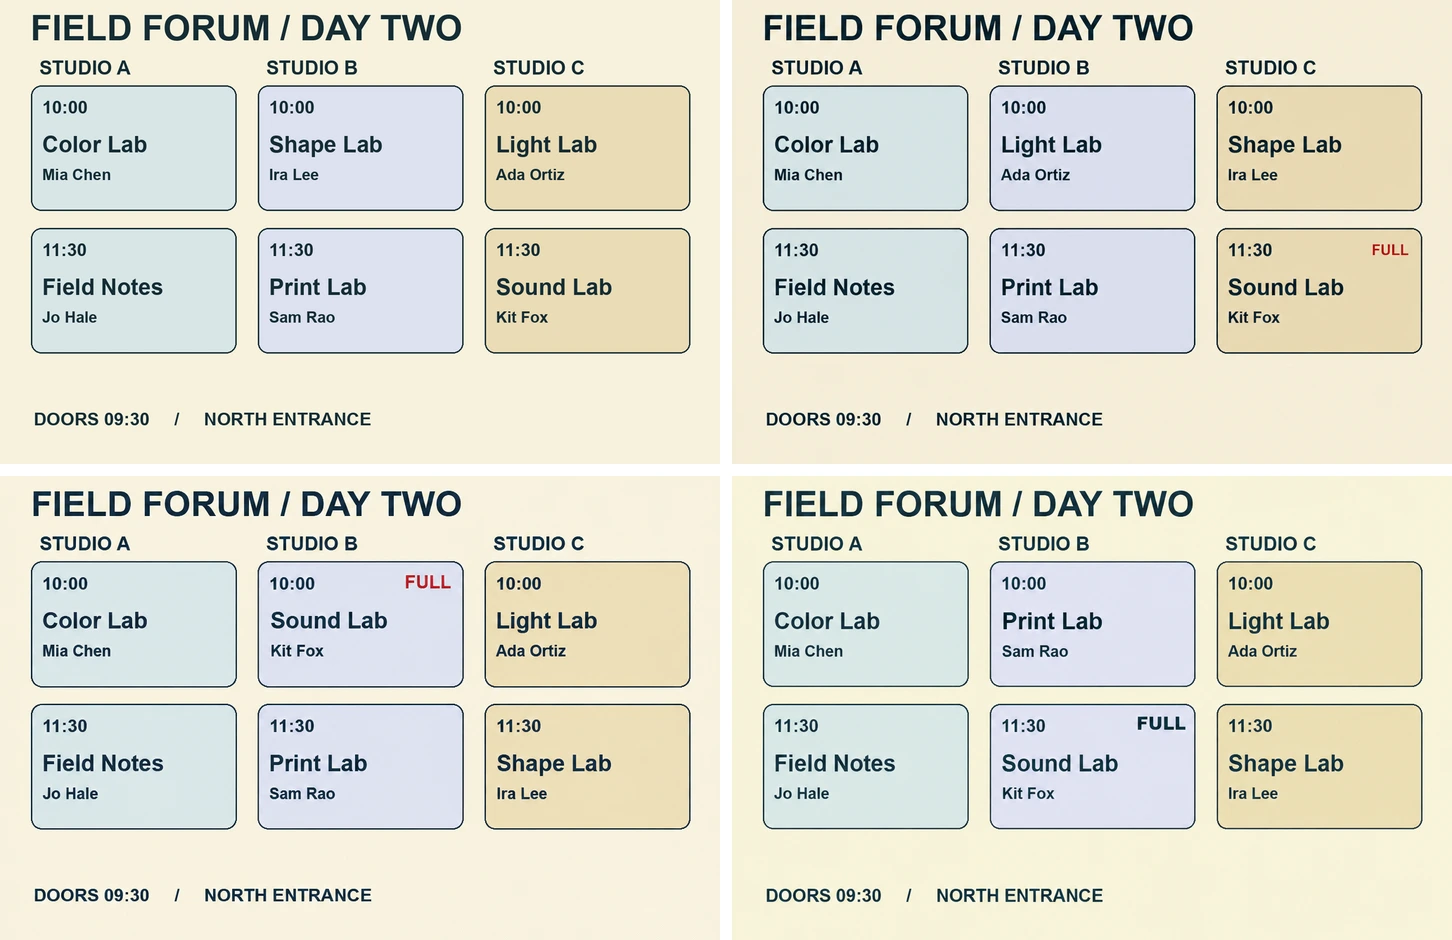
Obere Reihe: Original und GPT Image 2. Untere Reihe: je ein Ergebnis von Sunburst und Flare. Die Tabelle umfasst alle vier Durchläufe pro Modell. GPT Image 2 verwendet die Standardplanung, beide 2.6-Varianten verwenden mittlere Komplexität.
Alle drei Modelle erhielten über Synthorai dieselben Ausgangsbilder und Prompts. Auch die Ausgabegröße und die angeforderte Einstellung quality: "medium" waren identisch. Bei GPT Image 2 wurde complexity weggelassen. Für die beiden 2.6-Anfragen wurde in dieser Tabelle ausdrücklich complexity: "medium" gesetzt. Die tatsächlich verwendete Planungsstufe von GPT Image 2 ist unbekannt. Die Tabelle vergleicht daher die drei API-Konfigurationen so, wie sie ausgeführt wurden. Der Score für das Lebensmitteletikett basiert jeweils auf einem Durchlauf. Der Score für das Programm basiert auf vier Versuchen mit demselben Layout.
Wie schnell lieferten die drei Modelle die Programmbearbeitung?
Beim selben Programmbild und Prompt lieferte Flare das Bild mit einem Median von 7.5 Sekunden. Danach folgten Sunburst mit 18.9 Sekunden und GPT Image 2 mit 27.0 Sekunden. Jeder Median umfasst vier erfolgreiche API-Antworten vom selben Testhost über Synthorai. Gemessen wurde vom Absenden der Anfrage bis zum vollständigen Empfang der Bildantwort.
| Modell und Planungseinstellung | Erfolgreiche Antworten | Median | Spanne |
|---|---|---|---|
| GPT Image 2, Standard | 4 | 27.0 s | 26.0 bis 47.5 s |
| GPT Image 2.6 Sunburst, Medium | 4 | 18.9 s | 18.3 bis 21.3 s |
| GPT Image 2.6 Flare, Medium | 4 | 7.5 s | 7.2 bis 8.0 s |
Die Messwerte beschreiben die End-to-End-Latenz einer einzelnen Bearbeitung mit mittlerer Rendering-Qualität. GPT Image 2 lief in einem separaten Batch, wobei das Planungsfeld weggelassen wurde.
Verbesserert hohe Komplexität die Programmbearbeitung?
Flare tauschte beide Vorträge in zwei Durchläufen mit hoher Komplexität und in keinem Durchlauf mit mittlerer Komplexität. Bei beiden Einstellungen erzielten die Modelle jeweils gleich viele vollständig korrekte Ergebnisse. Für das Programm mussten zwei Änderungen miteinander verknüpft bleiben. Zuerst sollten die Titel und Sprecher von Studio B um 10:00 und Studio C um 11:30 getauscht werden, während Raum und Uhrzeit an ihrer ursprünglichen Position blieben. Danach musste die Karte, die nun Sound Lab enthielt, das Label FULL erhalten. Ein Ergebnis konnte beide Vorträge korrekt tauschen und FULL trotzdem an der alten Position platzieren.
Genau das geschah im folgenden Beispiel mit Sunburst. Beide Ergebnisse verschoben Sound Lab nach Studio B um 10:00 und Shape Lab nach Studio C um 11:30. Das Ergebnis mit mittlerer Komplexität setzte FULL auf Sound Lab. Das Ergebnis mit hoher Komplexität setzte es auf Shape Lab, also an die frühere Position von Sound Lab.
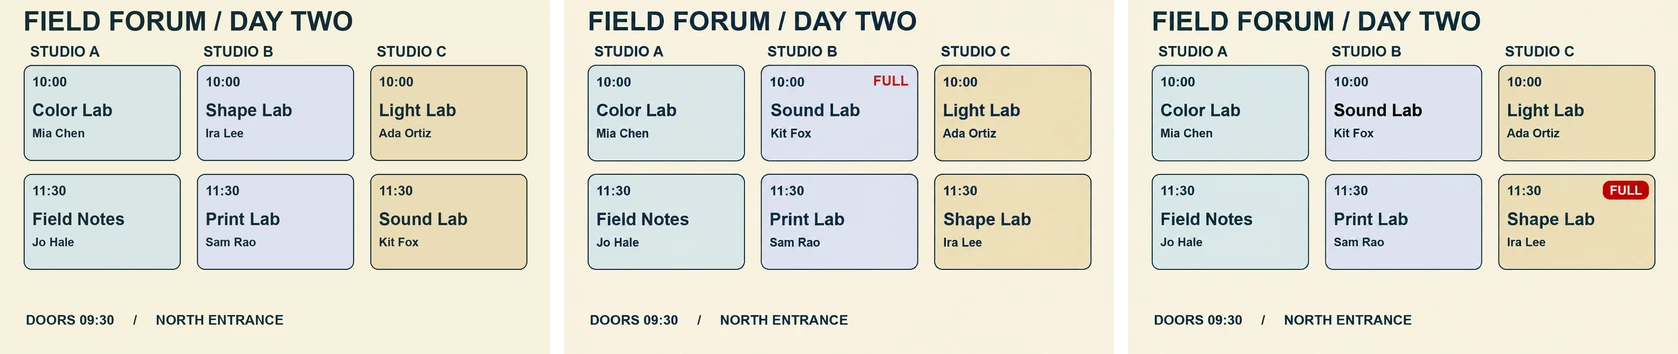
Von links nach rechts: ursprüngliches Programm, korrektes Sunburst-Ergebnis mit mittlerer Komplexität und Sunburst-Ergebnis mit hoher Komplexität, bei dem das Label an der alten Position steht.
Für die 16 Durchläufe wurde dasselbe Ausgangsprogramm verwendet, mit vier Ergebnissen pro Modell und Komplexitätseinstellung.
| Modell | Medium, beide Vorträge korrekt getauscht | Medium, vollständig korrekt | High, beide Vorträge korrekt getauscht | High, vollständig korrekt |
|---|---|---|---|---|
| Sunburst | 4/4 | 2/4 | 4/4 | 2/4 |
| Flare | 0/4 | 0/4 | 2/4 | 0/4 |
Bei zwei Sunburst-Ergebnissen pro Einstellung stand FULL auf der falschen Karte. Auch beide Flare-Ergebnisse mit hoher Komplexität, die die Vorträge korrekt tauschten, platzierten das Label falsch. Bei vier Durchläufen pro Einstellung auf einem einzelnen Programm gelten diese Zahlen nur für diese konkrete Bearbeitung. Die 12 wiederholten Anfragen meldeten bei beiden Einstellungen identische Zahlen für Input- und Output-Token.
In einem Workflow zur Veröffentlichung von Veranstaltungen sollte vor der Freigabe jede betroffene Position geprüft und das Label aus dem fertigen Bild zurückgelesen werden. Stammt das Programm aus strukturierten Veranstaltungsdaten, sollten Text und Label direkt daraus gerendert werden. Dann folgt das Label der Veranstaltung, wenn sich deren Position ändert.
Wann hilft Markup GPT Image 2.6 bei der Auswahl des richtigen Objekts?
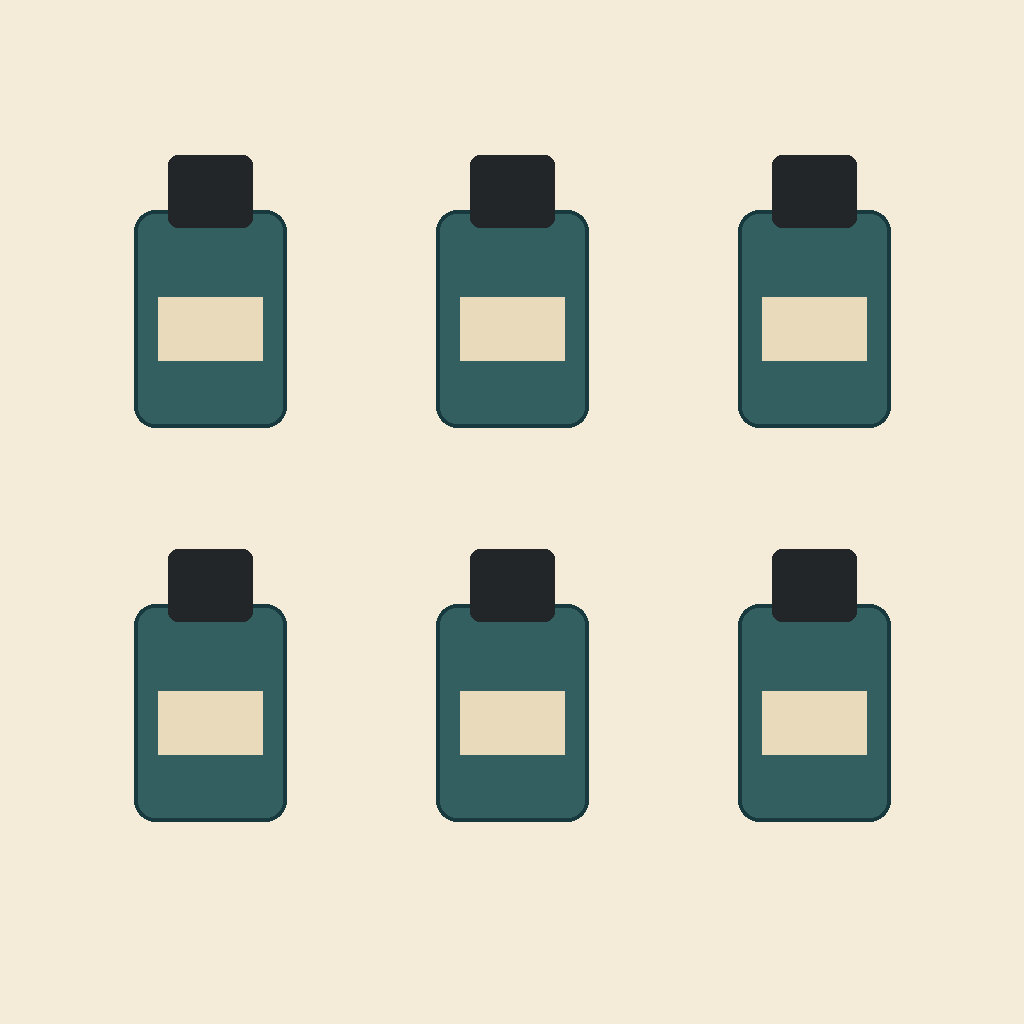
Markup half, wenn das Bild mehrere gleichwertige Ziele enthielt und der Text keine Auswahl vorgab. Wir gaben GPT Image 2.6 Sunburst und GPT Image 2.6 Flare ein Raster aus sechs identischen Flaschen. Genau ein Verschluss sollte in poliertes Gold geändert werden. Der Wortlaut blieb in allen Varianten identisch. Bei vorhandener Annotation sollte das Modell den eingekreisten Verschluss bearbeiten. Eine Position wurde im Text nicht genannt.
Als vorgegebene Ziele verwendeten wir den Verschluss oben in der Mitte und den Verschluss unten rechts. Ohne Overlay war jede Übereinstimmung mit dem vorgegebenen Verschluss zufällig. In der Abbildung unten wählte Flare ohne Markup den Verschluss oben in der Mitte. Mit Overlay bearbeitete es den Verschluss unten rechts und ließ die anderen fünf schwarz.
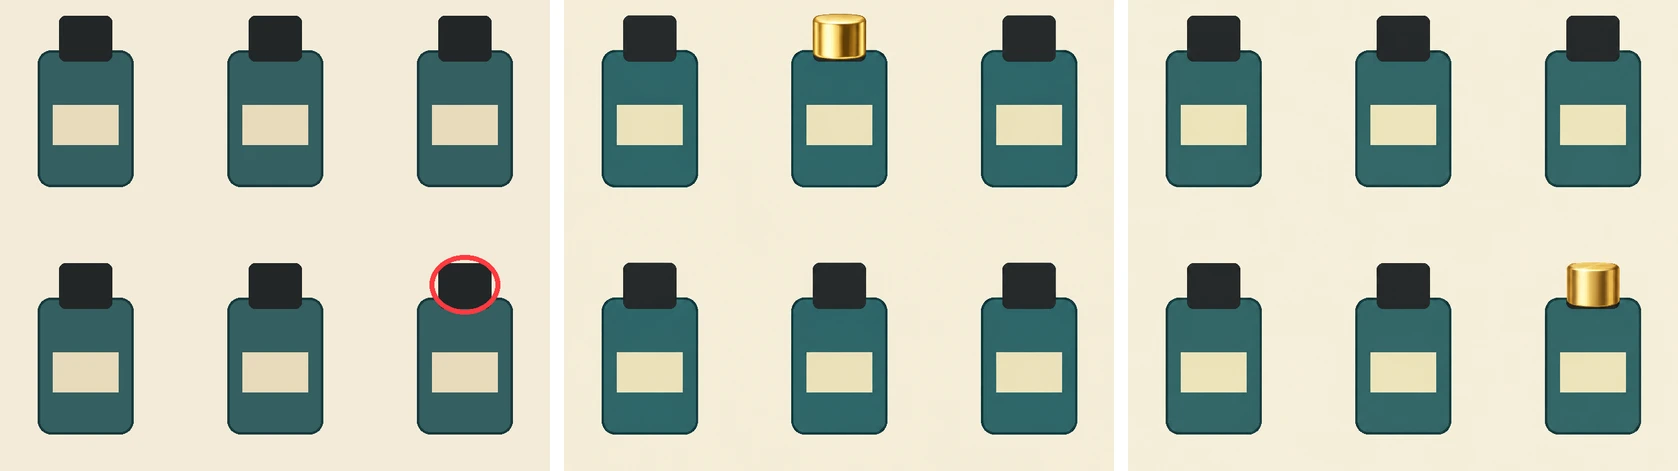
Von links nach rechts: Eingabebild mit rot dargestelltem Overlay, Flare ohne Markup und Flare mit Markup. Die Anfrage übermittelte Ausgangsbild und Overlay als separate Eingaben.
| Vorgegebener Verschluss | Sunburst ohne Markup | Sunburst mit Markup | Flare ohne Markup | Flare mit Markup |
|---|---|---|---|---|
| Oben Mitte | Oben Mitte | Oben Mitte | Oben rechts | Oben Mitte |
| Unten rechts | Oben Mitte | Unten rechts | Oben Mitte | Unten rechts |
| Richtige Ziele | 1/2 | 2/2 | 0/2 | 2/2 |
In allen acht Ergebnissen änderten die Modelle genau einen Verschluss, ließen die anderen fünf schwarz und übernahmen den Kreis nicht in das gerenderte Bild. Das Overlay bestimmte, welcher Verschluss bearbeitet wurde. Bei zwei weiteren Aufgaben, in denen der Text das Ziel bereits lokalisierte, bestanden in beiden Varianten jeweils 4/4 Ergebnisse die Testkriterien. Dabei wurden ausgewählte Flaschenverschlüsse ersetzt und ein Label auf einer Verpackung platziert.
Das Ergebnis zur Zielauswahl basiert auf zwei Zielpositionen in einem synthetischen Bild, mit jeweils einem Durchlauf pro Modell und Variante. Für einen Workflow, in dem jemand ein Objekt auf einer Arbeitsfläche auswählt, zeigt die Abbildung eine direkte Anwendung dieser Auswahl. Wenn der Text bereits ein eindeutiges Ziel bezeichnete, brachte das zusätzliche Overlay bei den beiden genannten Aufgaben keinen beobachtbaren Vorteil.
Wie wurden die Bildbearbeitungen getestet?
Wir sendeten JSON-Anfragen an den Synthorai-Endpunkt zur Bilderzeugung. Jede Anfrage erzeugte ein PNG mit 1024 × 1024 Pixeln und fest eingestellter quality von medium. Beim Vergleich der Flaschen blieb die Komplexität auf Medium, während das Overlay variiert wurde. Für den Programmvergleich gab es vier erfolgreiche Ausgaben pro Modell und Einstellung. Die Anfragen an GPT Image 2 liefen in einem separaten Batch, und der Prüfer kannte beim Bewerten das Modell. Bei den Wiederholungstests bewertete derselbe Prüfer nummerierte 2.6-Bilder anhand derselben Aufgaben-Checkliste. Ein Programm galt nur dann als bestanden, wenn die beiden Zielkarten korrekt waren, das Label Sound Lab folgte, die vier anderen Karten sowie die Raum- und Zeitangaben erhalten blieben und Footer und Raster intakt waren.
Das Beispiel verwendet den JSON-Endpunkt von Synthorai unter /v1/images/generations. OpenAI dokumentiert Markup-gesteuerte Bearbeitungen für den eigenen Endpunkt /v1/images/edits. OpenAI-Leitfaden zur Bilderzeugung Synthorai Image API
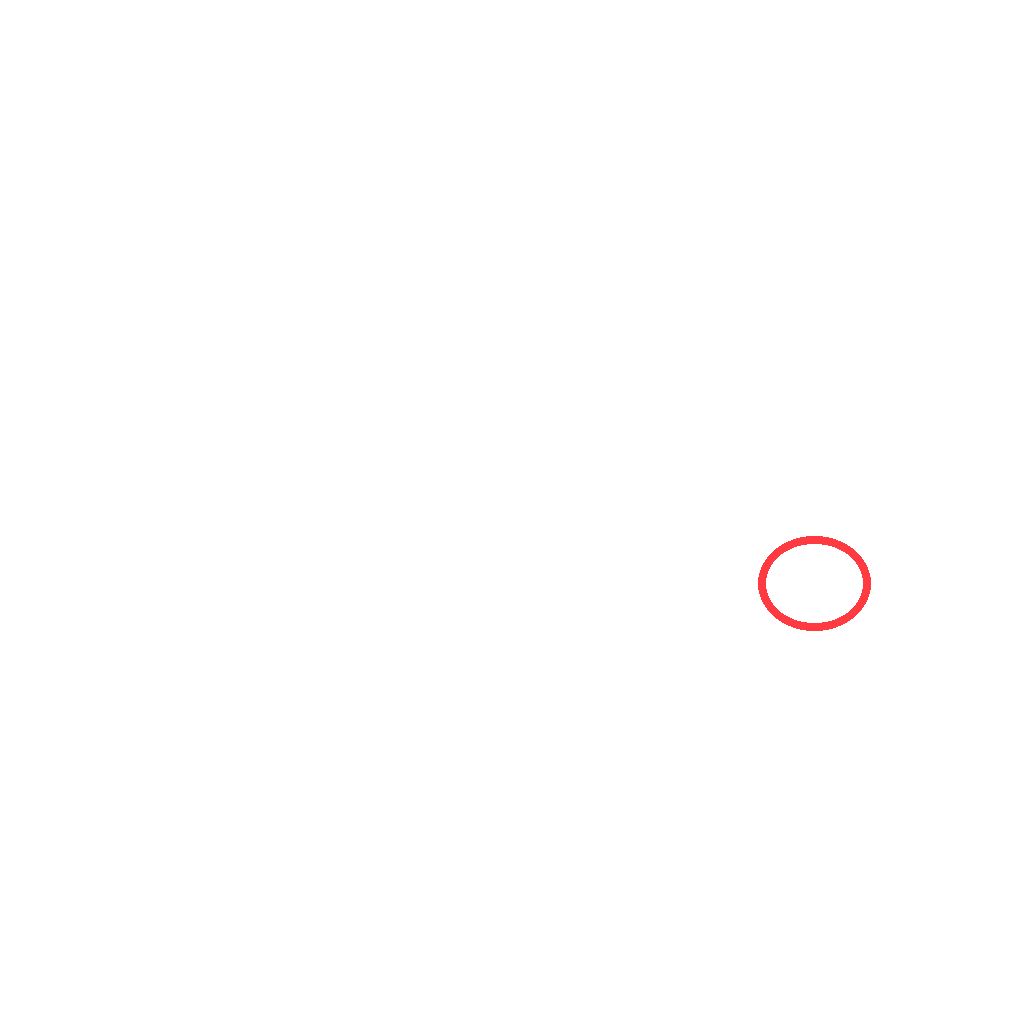
Um die markierte Flare-Anfrage nachzustellen, müssen beide Dateien neben dem Skript gespeichert werden. Das Overlay ist ein transparentes PNG mit denselben Abmessungen wie das Ausgangsbild und einem Kreis um den Verschluss unten rechts. Ausgangs-PNG · Overlay-PNG
import base64
import json
import os
from pathlib import Path
from urllib.request import Request, urlopen

def png_data_url(path):
    return "data:image/png;base64," + base64.b64encode(Path(path).read_bytes()).decode()

payload = {
    "model": "gpt-image-2.6-flare",
    "prompt": (
        "Change exactly one bottle cap from black to polished gold. "
        "If a cap is circled in the annotation, change that cap. "
        "Keep all other caps black and preserve the six bottles and layout. "
        "Do not reproduce the circle."
    ),
    "image": png_data_url("bottles.png"),
    "markup": png_data_url("cap-overlay.png"),
    "complexity": "medium",
    "quality": "medium",
    "size": "1024x1024",
    "n": 1,
    "output_format": "png",
}

request = Request(
    "https://synthorai.io/v1/images/generations",
    data=json.dumps(payload).encode(),
    headers={
        "Authorization": f"Bearer {os.environ['SYNTHORAI_API_KEY']}",
        "Content-Type": "application/json",
    },
)
with urlopen(request, timeout=240) as response:
    result = json.load(response)

Path("edited.png").write_bytes(base64.b64decode(result["data"][0]["b64_json"]))
print(result.get("usage"))
Häufige Fragen
Ist der Vergleich mit GPT Image 2 beim Planungsaufwand gleichgesetzt?
Bei der Anfrage an GPT Image 2 wurde complexity weggelassen. Sunburst und Flare verwendeten in der Tabelle mit drei Modellen ausdrücklich mittlere Komplexität. Eingaben und Ausgabeeinstellungen sind identisch. Die Ergebnisse gelten für diese konkreten API-Konfigurationen.
Wurde GPT Image 2.5 über Synthorai getestet?
GPT Image 2.5 Sunburst und Flare erscheinen nur in der öffentlichen Arena-Tabelle. Im Synthorai-Experiment wurden GPT Image 2, GPT Image 2.6 Sunburst und GPT Image 2.6 Flare verwendet. Arena-Leaderboard für die Bearbeitung einzelner Bilder
Wann sollte ich Markup für eine Bildbearbeitung verwenden?
Verwende markup, wenn du das gewünschte Objekt im Bild markieren kannst, besonders wenn mehrere Objekte ähnlich aussehen. Übermittle die Annotation als separates transparentes PNG und beschreibe die Änderung im Prompt. Im Bild mit den sechs Flaschen wurde der gewünschte Verschluss bei 4/4 Anfragen mit Markup und bei 1/4 Anfragen ohne Markup ausgewählt.
Wurden die Programmbearbeitungen mit hoher Komplexität zuverlässiger?
Bei diesem Layout bestand Sunburst mit beiden Einstellungen 2/4, Flare mit beiden Einstellungen 0/4. Flare platzierte in zwei Durchläufen mit hoher Komplexität beide Vorträge korrekt, setzte aber in beiden Fällen das Label FULL an die falsche Position.