
gemini-3.1-flash-lite-image vs Seedream 5.0 Lite
Welches Modell wofür
Diese beiden rechnen in unterschiedlichen Einheiten ab - gemini-3.1-flash-lite-image berechnet pro Token ($0.25 pro Million Input, $30 pro Million Output), während seedream-5-0-260128 pauschal $0.035 pro Aufruf berechnet - daher ist keine einzelne Umrechnung zwischen ihnen ehrlich; planen Sie Ihr Budget anhand Ihrer eigenen Prompt-Größen und Ihres Aufrufvolumens. Wählen Sie das Google-Modell, wenn Sie neben Bildern auch Text zurück benötigen, da es sowohl Text als auch Bild (bis zu 4096 Ausgabe-Tokens) aus Text- oder Bildeingaben ausgibt. Wählen Sie das ByteDance-Modell für reine Text-oder-Bild-zu-Bild-Aufgaben zu vorhersehbaren Kosten pro Aufruf.
Preise
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | Δ | |
|---|---|---|---|
| Pro generiertem Bild | - | $0.035 | - |
| Eingabe / 1M Tokens | $0.25 | - | - |
| Ausgabe / 1M Tokens | $30 | - | - |
Die beiden Modelle werden in unterschiedlichen Einheiten abgerechnet, deshalb zeigen wir kein Δ: Für eine Umrechnung müssten wir etwas annehmen, das wir nicht gemessen haben. Oben steht jeder Preis in seiner eigenen Einheit.
Spezifikationen
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | |
|---|---|---|
| Eingabemodalitäten | Text Bild | Text Bild |
| Ausgabemodalitäten | Text Bild | Bild |
| Veröffentlicht | 2026-06-30 | 2026-01 |
| Knowledge-Cutoff | 2025-01 | - |
| Ausgabegrößen | 1K only (1:1 = 1024x1024) |
|
| Eingabemodi | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, single-image image-to-image, multi-reference image-to-image (2-14 refs), batch/sequential image sets |
| Bilder pro Anfrage | - | 15 |
| Formate | - | png, jpeg |
| Anmerkungen | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | 2K/3K/4K output, png/jpeg text-to-image + single/multi-reference image editing batch generation with reference + generated images <=15 500 max IPM |
Die Spezifikationen stammen aus der Dokumentation des jeweiligen Anbieters. Veröffentlicht ein Anbieter eine Angabe nicht, lassen wir die Zeile weg, statt sie zu schätzen. Vollständige Quellen: gemini-3.1-flash-lite-image · Seedream 5.0 Lite
Ein Prompt, beide Modelle, gemessen über das Gateway
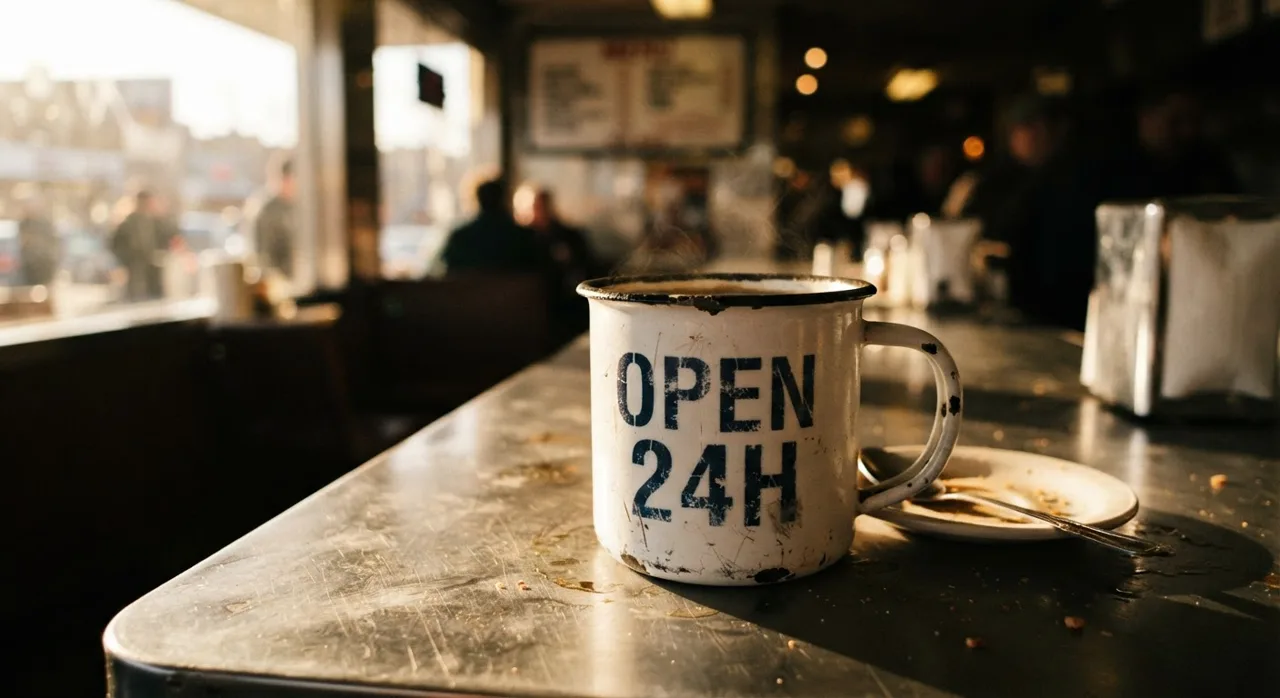
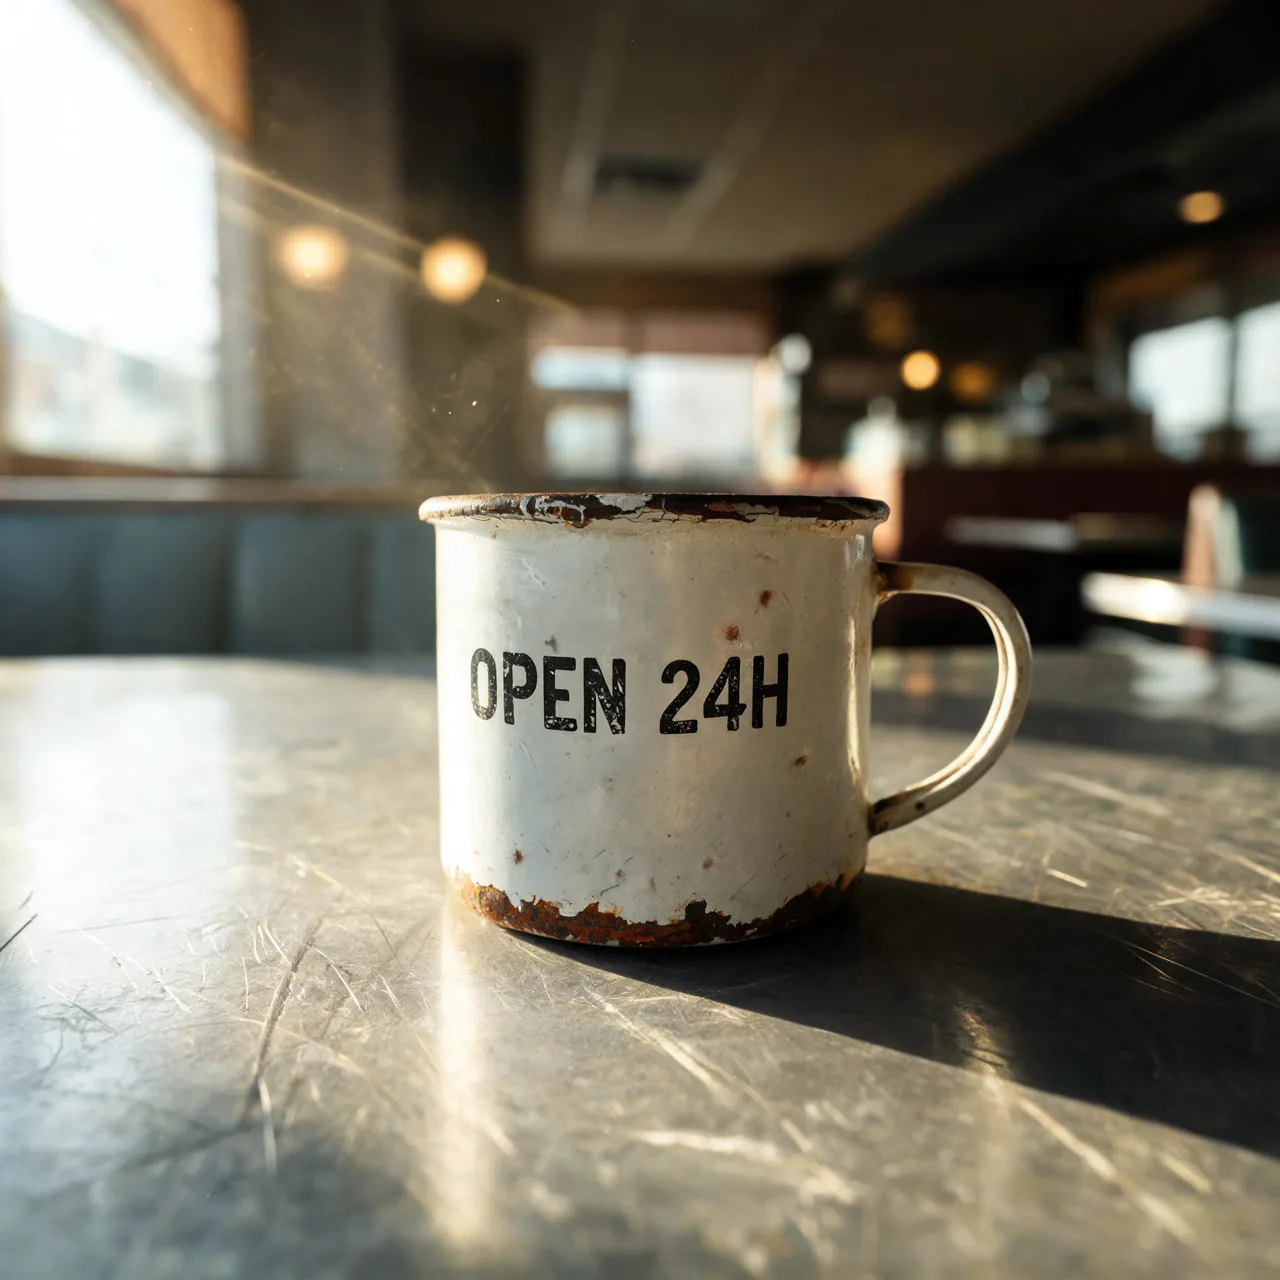
Ein Prompt, eine Anfrage pro Modell, keine Wiederholungen und keine Auswahl der besten Ergebnisse: Sie sehen das erste Ergebnis, das jedes Modell geliefert hat. Größe und Dauer haben wir nicht vorgegeben. Jedes Modell hat seinen eigenen Standardwert verwendet, denn eine Anfrage, die auf alle zugeschnitten ist, würde keinem gerecht. Die Dateien wurden für das Web neu kodiert. Beurteilen Sie deshalb Bildaufbau und Prompt-Treue, nicht die Kompression.
Eine Zeile genügt für den Wechsel
Beide IDs stehen in jedem Tab unten. Die beiden hervorgehobenen Zeilen sind die einzige Änderung. Gleicher Endpunkt, gleicher Schlüssel, gleiches Anfrageformat.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="seedream-5-0-260128",  # diese Zeile einkommentieren, die darüberliegende auskommentieren
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "seedream-5-0-260128", // diese Zeile einkommentieren, die darüberliegende auskommentieren
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "seedream-5-0-260128", # diese Zeile einkommentieren, die darüberliegende auskommentieren
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "seedream-5-0-260128", // diese Zeile einkommentieren, die darüberliegende auskommentieren
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("seedream-5-0-260128") // diese Zeile einkommentieren, die darüberliegende auskommentieren
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Welches Modell ist günstiger: gemini-3.1-flash-lite-image oder Seedream 5.0 Lite?
Die beiden werden in unterschiedlichen Einheiten abgerechnet, eine einzelne belastbare Zahl gibt es deshalb nicht: gemini-3.1-flash-lite-image und Seedream 5.0 Lite stehen in der Tabelle oben jeweils in ihrer eigenen Einheit. Vergleichen Sie sie mit Ihrem eigenen Workload. Welche Abwägung dahintersteckt, beschreibt das Fazit oben auf dieser Seite.
Kann ich gemini-3.1-flash-lite-image gegen Seedream 5.0 Lite A/B-testen, ohne zweimal zu integrieren?
Ja. Beide laufen über denselben OpenAI-kompatiblen Endpunkt mit einem API-Schlüssel. Für den Wechsel ändern Sie nur eine Zeile, den Modellnamen. So können Sie einen Teil des Traffics an jedes Modell schicken und die Kosten direkt vergleichen.
Ändert sich der Preis mit der Bildgröße?
Das hängt davon ab, wie das Modell abrechnet. Modelle mit Preis pro Bild kosten immer gleich viel, egal wie lang der Prompt oder wie groß die Ausgabe ist. Bei Modellen mit Token-Abrechnung steigt der Preis mit der Auflösung, ein 4K-Bild kostet also ein Vielfaches eines kleinen. Die Tabelle oben zeigt, was für welches Modell gilt.