
Gemini 3.1 Flash-Lite Image, vermarktet als Nano Banana 2 Lite, ist Googles Modell für Bildgenerierung und -bearbeitung mit ultraniedriger Latenz, beschrieben als der Effizienzspezialist der Familie und ausgelegt auf Tempo und Skalierung dort, wo Geschwindigkeit und Kosten die wichtigsten betrieblichen Beschränkungen sind; die Modellseite führt eine End-to-End-Latenz von unter 2 Sekunden für interaktive Anwendungen mit hohem Volumen an.
- Eingabe
- Text Bild $0.25/M
- Ausgabe
- Bild Text $30/M
- Knowledge-Cutoff
- 2025-01
Preis im Vergleich
Der Preis im Feld von 9 vergleichbaren Modellen
Der Balken zeigt, wo der Preis dieses Modells unter allen Modellen derselben Art auf Synthorai liegt. An beiden Enden stehen das günstigste und das teuerste Modell. Angegeben sind Grundpreise; Rabatte für Batch, Region und Cache-Schreibzugriffe stehen auf der Preisseite.
Spezifikationen & Limits
Tokens
| Max. Ausgabe (laut Anbieter) | 4.096 |
|---|---|
| Knowledge-Cutoff | 2025-01 |
Thinking
| Anbieter-Parameter | thinkingLevel |
|---|---|
| Zulässige Werte | minimal · high (low and medium are not supported) |
| Standardwert | minimal gilt, wenn die Anfrage nichts angibt |
| Abschaltbar | Nein |
| Thinking-Verhalten | high ist die dynamische Einstellung; als Gemini-3-Bildmodell ist sein Thinking-Durchlauf standardmäßig aktiv und lässt sich über die API nicht abschalten. |
| Parameter | reasoning_effort |
| Werte | minimal · low · medium · high Parameter des Gateways; maßgeblich ist das Anbieter-Mapping oben |
Bild
| Größen | nur 1K (1:1 = 1024x1024) |
|---|---|
| Eingabemodi | Text-to-Image, verschränkte Generierung und Bearbeitung, bis zu 14 Referenzbilder |
| Bildfunktionen |
|
Modell
| Modalitäten | Text + Bild → Bild + Text |
|---|
- Optimiert für interaktiven Einsatz mit sehr niedriger Latenz und hohem Volumen
- Caching und strukturierte Ausgaben werden nicht unterstützt
- Thinking minimal/high
Ein Prompt, gemessen über das Gateway
gemini-3.1-flash-lite-image
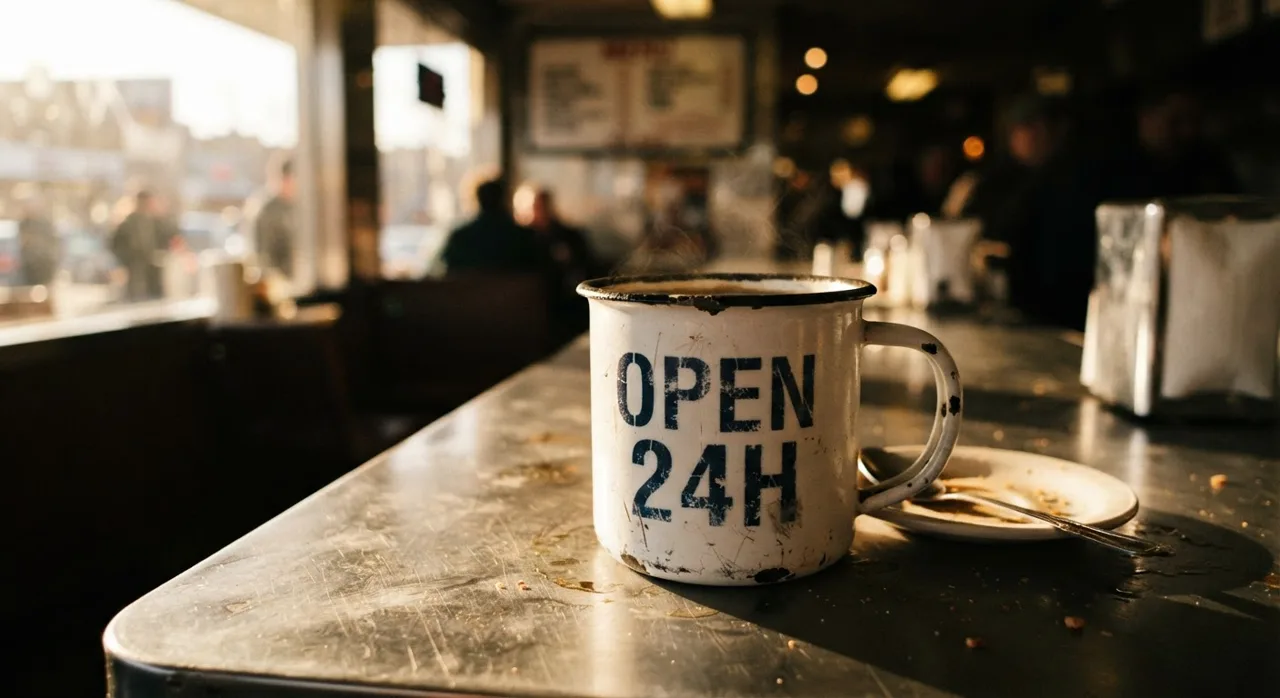
Vom Modell zurückgegeben 1408×768 Latenz 3 s
Ein Prompt, eine Anfrage pro Modell, keine Wiederholungen und keine Auswahl der besten Ergebnisse: Sie sehen das erste Ergebnis, das jedes Modell geliefert hat. Größe und Dauer haben wir nicht vorgegeben. Jedes Modell hat seinen eigenen Standardwert verwendet, denn eine Anfrage, die auf alle zugeschnitten ist, würde keinem gerecht. Die Dateien wurden für das Web neu kodiert. Beurteilen Sie deshalb Bildaufbau und Prompt-Treue, nicht die Kompression.
gemini-3.1-flash-lite-image in 30 Sekunden nutzen
OpenAI-kompatibel: base_url austauschen, SDK behalten. POST /v1/images/generations
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));Über gemini-3.1-flash-lite-image
- Es verarbeitet verschachtelte Text-und-Bild-Prompts und glänzt bei lokalen Bearbeitungen wie Farbwechseln, Sticker-Generierung und Hintergrundanpassungen, wobei es laut Google zuverlässige Prompt-Treue, starke Charakterkonsistenz und lesbaren Text im Bild beibehält.
- Die Ausgabe ist fest auf 1K-Auflösung über zehn Seitenverhältnisse gesetzt, das erste Mal, dass die Lite-Stufe eine Steuerung des Seitenverhältnisses hat, und sie akzeptiert bis zu vierzehn Objekt-Referenzbilder, die höchste Zahl der Familie.
- Die Kompromisse stehen ausdrücklich in der Dokumentation: Das Output-Budget beträgt 4.096 Token gegenüber 32.768 bei den Geschwistern, die Bearbeitung über mehrere Runden ist eingeschränkter als bei Flash oder Pro, und Search Grounding, Image Search Grounding sowie Videoeingabe fehlen sämtlich, während Function Calling unterstützt wird und Thinking mit minimal oder high verfügbar ist.
- Google positioniert es als Upgrade-Pfad für alle, die noch auf dem ursprünglichen Nano Banana sind.
- Jedes Bild trägt SynthID- und C2PA-Wasserzeichen.
- Synthorai stellt es über dieselbe OpenAI-kompatible API bereit, die für seine Textmodelle verwendet wird.
FAQ
Lässt sich die gemini-3.1-flash-lite-image API kostenlos testen?
Ja. Neue Konten erhalten 10 Testaufrufe und bis zu $1 Gratisguthaben, ohne Kreditkarte. Das reicht, um gemini-3.1-flash-lite-image mit Ihrem realen Workload auszuprobieren, bevor Sie eine Zahlungsmethode hinterlegen.
Worin ist gemini-3.1-flash-lite-image am besten?
End-to-End-Latenz von unter 2 Sekunden; glänzt bei lokalen Bearbeitungen und Stickern; SynthID- und C2PA-Wasserzeichen auf jedem Bild. Mehr dazu im Über-Abschnitt, der auf den offiziellen Release Notes des Anbieters beruht.
Was kostet gemini-3.1-flash-lite-image?
gemini-3.1-flash-lite-image kostet auf Synthorai $0.25 pro Million Eingabe-Tokens und $30 pro Million Ausgabe-Tokens. Das ist der Listenpreis des Anbieters, ohne Plattformaufschlag.
Wie generiere ich Bilder mit der gemini-3.1-flash-lite-image API?
Senden Sie auf Synthorai einen POST an /v1/images/generations mit model="gemini-3.1-flash-lite-image". Das Format entspricht der Images-API von OpenAI, ein Anbieter-SDK brauchen Sie nicht. Unterstützte Größen: nur 1K (1:1 = 1024x1024).
Wie erhalte ich Zugang zu gemini-3.1-flash-lite-image?
Setzen Sie in Ihrem vorhandenen OpenAI SDK base_url="https://synthorai.io/v1" und model="gemini-3.1-flash-lite-image", mehr ist nicht nötig. Ein API-Schlüssel gilt für alle Modelle im Gateway.
Verwandte Modelle
Vergleichen
Jeder Wert auf dieser Seite stammt aus der oben verlinkten Dokumentation des Anbieters und trägt das Datum, an dem wir ihn geprüft haben. Preise vergleichen wir über den gesamten Katalog. Spezifikationen, die Anbieter unterschiedlich definieren, zeigen wir mit einem Hinweis auf den Unterschied und nicht als Diagramm. Wir messen hier nichts selbst und vergeben keine Bewertungen.