
Gemini BYOK deaktiviert Googles Anfragespeicherung nicht
Inhalt
- Wie hängen BYOK, Vertex und die Developer API zusammen?
- Wo werden BYOK und die Anfragespeicherung konfiguriert?
- Was hat sich bei der Speicherung von Gemini-Anfragen geändert?
- Kann ein Custom Endpoint die Gemini Developer API aufrufen?
- Funktioniert store=false auf der nativen Developer API?
- Was haben die lokalen Kontrolltests geprüft?
- Kann Fallback den Umgang mit Daten im Projekt verändern?
- Was sollte vor dem Produktionseinsatz geprüft werden?
- FAQ
- Deaktiviert Gemini BYOK die Protokollierung von Anfragen?
- Sollte BYOK über Parameter der Inferenzanfrage konfiguriert werden?
- Bedeutet store=false, dass keine Daten aufbewahrt werden?
- Garantiert deaktiviertes Fallback, dass jede Anfrage in meinem Projekt bleibt?
Gemini BYOK (bring your own key) legt fest, welche Kundenzugangsdaten verwendet werden. Die Speicherung von Anfragen wird dadurch nicht deaktiviert. Für den hier getesteten Gateway-Pfad wird BYOK in der Synthorai-Konsole konfiguriert, die Speicherrichtlinie dagegen im zugehörigen Google-Projekt. In unseren Tests lehnte Googles Chat-kompatible API store=false auf oberster Ebene ab. Bei der Konvertierung nativer Gemini-Anfragen in das Chat-Format ging das Feld verloren.
TL;DR
- Gemini ist eine Modellfamilie. Gemini Developer API und Vertex AI sind getrennte Google-Dienste, über die sich diese Modelle aufrufen lassen.
- Der standardmäßige Google-BYOK-Eintrag in Synthorai ist für Vertex vorgesehen. Ein separat konfigurierter Custom Endpoint kann die Chat-kompatible Schnittstelle der Developer API ansprechen.
- Zugangsdaten und Fallback werden in der Synthorai-Konsole konfiguriert, die Projektprotokollierung der Developer API in Google AI Studio.
- In sechs synchronen Gateway-Tests führten explizite boolesche Speicheroptionen im Chat-Format zu HTTP 400. Bei der Konvertierung vom nativen Format in das Chat-Format entfielen diese Werte. Die erfolgreichen Anfragen erschienen in den AI-Studio-Logs.
Wie hängen BYOK, Vertex und die Developer API zusammen?
BYOK beschreibt, wessen Zugangsdaten das Gateway verwendet. Vertex AI und die Gemini Developer API bezeichnen den Google-Dienst, der die Anfrage erhält. Ein Modellname mit Gemini sagt weder etwas über den Dienst noch über dessen Speicherrichtlinie aus.
| Google-Dienst | Google-API-Host | Konfiguration in Synthorai | Zu prüfende Speichereinstellungen |
|---|---|---|---|
| Gemini auf Vertex AI | aiplatform.googleapis.com, einschließlich regionaler Hosts | Standardmäßiger Google-BYOK-Eintrag mit der Bezeichnung Vertex und für Vertex autorisierten Zugangsdaten | Dienstspezifische Einstellungen für Protokollierung und Aufbewahrung im ausgewählten Google-Cloud-Projekt |
| Gemini Developer API | generativelanguage.googleapis.com | Separater Custom Endpoint mit Googles OpenAI-kompatibler Schnittstelle und einem Developer-API-Key | Projektprotokollierung in AI Studio; von der verwendeten API-Schnittstelle unterstützte Optionen auf Anfrageebene |
Ein Custom Endpoint ist eine Gateway-Konfiguration, kein dritter Google-Dienst. Er legt Ziel-URL, API-Format, Kundenschlüssel und Modellliste fest. Googles Chat-kompatible Schnittstelle ist eine Schnittstelle zur Developer API. Deren native GenerateContent-Schnittstelle verwendet ein anderes Anfrageformat.
Der standardmäßige Vertex-BYOK-Eintrag hat kein eigenes Feld für einen Gemini-Developer-API-Key. Ein Google-Cloud-Dienstkonto, wie es häufig für Vertex verwendet wird, ist eine Anwendungsidentität mit Projektberechtigungen. Ein Developer-API-Key verweist auf eine andere Dienstkonfiguration. Verwenden Sie Zugangsdaten, die für das gewählte Ziel autorisiert sind.
Die folgenden Experimente beziehen sich auf die Developer API. Für Vertex gelten Googles dienstspezifische Aufbewahrungseinstellungen. Aus der Änderung an der Protokollierung der Developer API lässt sich kein Verhalten von Vertex ableiten.
Wo werden BYOK und die Anfragespeicherung konfiguriert?
Hinterlegen Sie die Kundenzugangsdaten in der Synthorai-Konsole und prüfen Sie anschließend die Speichereinstellungen in der Konsole des gewählten Google-Dienstes. Diese Einstellungen steuern unterschiedliche Abschnitte des Anfragepfads.
| Ort | Konfiguration |
|---|---|
| Synthorai-Konsole, BYOK | Kundenzugangsdaten oder Custom Endpoint, vorgesehene Modelle, Aktivierungsstatus und Fallback-Richtlinie |
| Google AI Studio, Developer-API-Projekt | Speicherung von GenerateContent-Anfragen und Aufbewahrung der Logs |
| Google Cloud, Vertex-Projekt | Einstellungen für Protokollierung und Aufbewahrung des jeweiligen Dienstes |
Richten Sie das Gateway nach der BYOK-Anleitung ein. Anwendungen verwenden danach für normale Inferenzaufrufe ihren Gateway-API-Key. Geben Sie die Modellliste eines Custom Endpoints explizit an: Laut Dokumentation übernimmt eine leere Liste sämtliche Modelle. Verwenden Sie Modellnamen, die der Endpoint akzeptiert, da die Aliase der Plattform davon abweichen können.
Für den getesteten Custom-Endpoint-Pfad zur Developer API sollte die Richtlinie für Anwendungslogs über die Google-Projekteinstellung festgelegt werden. Google dokumentiert das Aktivieren und Deaktivieren der Projektprotokollierung in AI Studio. Prüfen Sie nach dem Deaktivieren das Ergebnis mit synthetischen Anfragen, bevor Sie sensible Prompts verwenden. In unseren Tests war die Speicherung aktiviert. Die deaktivierte Einstellung haben wir nicht untersucht.
Auf Googles nativer GenerateContent-API lässt sich die Speicherung weiterhin pro Anfrage steuern. Ein unterstützter store-Wert überschreibt dort die Projekteinstellung. Für den hier getesteten Chat-kompatiblen Pfad garantiert das Gateway keine Google-spezifische Unterstützung dieses Parameters. Die folgenden Ergebnisse zeigen, warum für diese Integration die Konfiguration auf Anbieterseite empfohlen wird.
Was hat sich bei der Speicherung von Gemini-Anfragen geändert?
Neue kostenpflichtige Projekte der Gemini Developer API speichern Generate-Content-Anfragen jetzt, sofern die Speicherung nicht durch den Aufrufer oder die Projekteinstellung deaktiviert wird. Projekte, die vor dem 26. Oktober erstellt wurden, behalten ihre bisherige Einstellung. Ein neuer Schlüssel in einem älteren Projekt erstellt weder ein neues Projekt noch lässt sich daraus ableiten, welcher Standard für die Protokollierung gilt. Google beschreibt die Änderung in den Versionshinweisen vom 26. Oktober.
Die Eigenschaft store auf Anfrageebene hat Vorrang vor dem Projektstandard. Die Anleitung zur Protokollierung behandelt synchrone, Streaming- und Batch-Aufrufe von Generate Content, einschließlich Aufrufen über Googles OpenAI-kompatible Schnittstelle. Gespeicherte Projektlogs werden standardmäßig 55 Tage aufbewahrt. Einstellbar sind 7, 14, 28 oder 55 Tage. Wird ein Log in einem Dataset gespeichert, ändert sich dieser Lebenszyklus.
Die Speicherung von Anfragen ist außerdem von der Nutzung für das Training und von Sicherheitslogs zu unterscheiden. Laut Googles Bedingungen für kostenpflichtige Dienste werden kostenpflichtige Prompts und Antworten nicht zur Verbesserung der Produkte verwendet. Die Bedingungen beschreiben zugleich eine begrenzte Aufbewahrung für Sicherheitszwecke. Das Abschalten des Anwendungslogs betrifft nur einen bestimmten Speichermechanismus.
Kann ein Custom Endpoint die Gemini Developer API aufrufen?
Die isolierte Custom-Endpoint-Pipeline von Synthorai konnte Gemini 3.5 Flash-Lite über Googles Chat-kompatiblen Endpoint erfolgreich aufrufen, wenn store fehlte. Google antwortete mit HTTP 200 und OK, das Gateway lieferte HTTP 200 an den Client. Bei explizitem store=true oder store=false auf oberster Ebene antwortete Google mit HTTP 400. Die Anfrage war damit ungültig.
In der isolierten Testumgebung hatte der Custom Endpoint folgende Konfiguration:
| Einstellung | Wert |
|---|---|
| API-Typ des Endpoints | OpenAI Chat Completions (openai_chat) |
| Google-Basis-URL | https://generativelanguage.googleapis.com/v1beta/openai |
| Zugangsdaten | Vorhandener Gemini-Developer-API-Key, als Bearer-Authentifizierung gesendet |
| Modellliste | Nur gemini-3.5-flash-lite |
| Plattform-Fallback | Deaktiviert |
Der Recorder bestätigte, dass bei Client-Anfragen im Chat-Format jeder explizite boolesche Wert im ausgehenden JSON erhalten blieb. Googles Fehlermeldung lautete Invalid JSON payload received. Unknown name "store": Cannot find field. Dieses Ergebnis betrifft das Chat-Feld auf oberster Ebene. Es belegt nicht, dass sämtliche denkbaren Google-spezifischen Erweiterungen nicht unterstützt werden.
Die abschließende synchrone Testmatrix zeigt, wie sich das Anfrageformat des Clients auf die Übertragung auswirkte:
| Anfrageformat des Clients | Eingehendes store | Ausgehendes Chat-store | HTTP bei Google / Client | AI-Studio-Log |
|---|---|---|---|---|
| Chat | true | true | 400 / 400 | Keine generierte Antwort |
| Chat | false | false | 400 / 400 | Keine generierte Antwort |
| Chat | Nicht gesetzt | Nicht gesetzt | 200 / 200 | Sichtbar |
| Natives Gemini | true | Nicht gesetzt | 200 / 200 | Sichtbar |
| Natives Gemini | false | Nicht gesetzt | 200 / 200 | Sichtbar |
| Natives Gemini | Nicht gesetzt | Nicht gesetzt | 200 / 200 | Sichtbar |
Jede Zeile steht für eine synthetische Anfrage an dasselbe Modell im selben kostenpflichtigen Projekt. Nach den Aufrufen zeigte die ungefilterte Liste „All datasets“ in AI Studio die exakten Marker aller vier erfolgreichen Fälle, einschließlich der Anfrage im nativen Format mit store=false. Die GenerateContent-Speicherung des Projekts war aktiviert. Bei der Konvertierung vom nativen Format in das Chat-Format ging das Flag verloren. Die Anfrage erreichte Google deshalb ohne die angeforderte Deaktivierung der Speicherung und erschien im Anwendungslog.
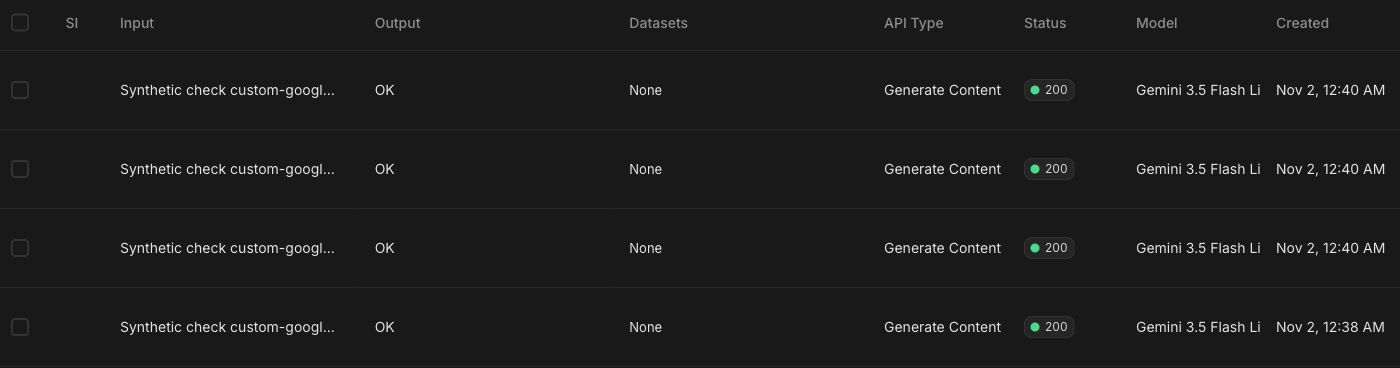
Die Eingabezellen im Screenshot sind abgeschnitten. Wir haben jeden vollständigen Marker in der Live-Liste abgeglichen. Die ersten drei Zeilen entsprechen den nativen Anfragen ohne Wert, mit false und mit true, gefolgt von der Chat-Anfrage ohne Wert. Damit ist die Sichtbarkeit dieser Fälle im Anwendungslog belegt, nicht das Verhalten sämtlicher Aufbewahrungsmechanismen von Google.
Wir haben diese Tests am 1. November 2026 (UTC) mit einem bestehenden kostenpflichtigen Projekt und synthetischen Prompts durchgeführt. Die isolierte Gateway-Umgebung stellte eine Testidentität für Benutzer und Workspace sowie einen temporären verschlüsselten Speicher für Zugangsdaten bereit. Ein lokaler Recorder leitete den ausgehenden Body und die Bearer-Zugangsdaten des Kunden unverändert per HTTPS an Google weiter. Die Einrichtung in der Produktionskonsole, Prüfungen öffentlicher Ziel-URLs, Client-Authentifizierung und Streaming waren nicht Teil dieses Tests.
Funktioniert store=false auf der nativen Developer API?
Direkte native GenerateContent-Aufrufe an Gemini 3.5 Flash-Lite akzeptierten sowohl store=true als auch store=false. Beide Anfragen lieferten HTTP 200, eine Antwort-ID sowie 32 Eingabe-Token und 1 Ausgabe-Token. Etwa 13 Minuten später zeigte die vollständige AI-Studio-Liste den true-Marker und die Ausgabe OK. Der false-Marker fehlte. Dieser Kontrollvergleich zeigt, warum die native und die Chat-kompatible Schnittstelle getrennt geprüft werden müssen.

Bei nativen REST-Aufrufen ist store ein boolesches Feld auf oberster Ebene, getrennt von den Generierungsparametern in generationConfig. Die REST-Referenz definiert diese Struktur. Das folgende Beispiel ist eine direkte Kontrollanfrage an Google, unabhängig von der BYOK-Konfiguration des Gateways:
import json
import os
import secrets
import urllib.request

marker = "storage-check-" + secrets.token_hex(8)
body = {
    "contents": [{"role": "user", "parts": [
        {"text": f"Synthetic request {marker}. Reply only OK."}
    ]}],
    "generationConfig": {"maxOutputTokens": 16},
    "store": False,
}
request = urllib.request.Request(
    "https://generativelanguage.googleapis.com/v1beta/"
    "models/gemini-3.5-flash-lite:generateContent",
    data=json.dumps(body).encode(),
    headers={"Content-Type": "application/json",
             "x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    method="POST",
)
with urllib.request.urlopen(request, timeout=30) as response:
    result = json.load(response)
print({"marker": marker, "response_id": result.get("responseId"),
       "usage": result.get("usageMetadata")})
Suchen Sie nach der Anfrage in den Logs des autorisierten Projekts nach dem Marker. Führen Sie zunächst eine Positivkontrolle mit true durch, bevor Sie das Fehlen eines Logs mit false-Marker bewerten. HTTP 200 belegt, dass die Anfrage angenommen wurde. Die Beobachtung im Log belegt die Sichtbarkeit im untersuchten Anwendungslog.
Das kostenpflichtige Projekt wurde vor dem 26. Oktober angelegt. Die GenerateContent-Speicherung war aktiviert, die angezeigte Aufbewahrungsdauer betrug 55 Tage. Wir haben keine der beiden Einstellungen geändert. Die Detailansichten einzelner Logs in AI Studio ließen sich nicht laden. Deshalb stützten wir uns auf Prompt, Ausgabe, Modell, Status und Zeitstempel in der vollständigen Liste. Diese Beobachtungen betreffen Anwendungslogs, nicht sämtliche Aufbewahrungsmechanismen von Google.
Was haben die lokalen Kontrolltests geprüft?
Neun lokale Recorder-Tests deckten die Anfrageformate Chat, Responses und natives Gemini ab, jeweils mit store auf true, false und ohne gesetzten Wert. Chat und Responses behielten explizite boolesche Werte bei. Bei der Konvertierung von nativem Gemini in das Chat-Format entfielen sie. Diese Tests verwendeten synthetische Kundenzugangsdaten und lokale Empfänger, ohne Aufrufe an Google.
Zwei weitere Tests verwendeten einen kontrollierten HTTP-503-Fehler am Kunden-Endpoint. Bei deaktiviertem Fallback erhielt der Client 503, und es gab keinen Versuch über die Plattform. Bei aktiviertem Fallback lieferte ein simulierter Plattformversuch 200. Das prüft ein einzelnes Fehlerszenario, nicht sämtliche Zustände im Lebenszyklus von Zugangsdaten oder alle Fallback-Bedingungen.
Kann Fallback den Umgang mit Daten im Projekt verändern?
Ein Fallback kann eine Anfrage mit Zugangsdaten senden, für die andere Projekteinstellungen gelten. Bei einer an ein Projekt gebundenen Workload muss dieser Wechsel in der konfigurierten Richtlinie und deren Prüfung berücksichtigt werden.
Die dokumentierte Custom-Endpoint-Einstellung Automatischer Fallback auf Synthorai-Guthaben legt fest, ob die Plattform nach einem Fehler dieses Endpoints antworten darf. Die Implementierung unterscheidet außerdem zwischen einem zulässigen Schlüssel, dessen Upstream-Aufruf fehlschlägt, und einem fehlenden oder nicht zulässigen Schlüssel. Das sind unterschiedliche Pfade durch das System.
| Szenario | Was zu prüfen ist |
|---|---|
| Konfigurierte Kundenzugangsdaten führen zu einem Upstream-Fehler | Ob der erlaubte Fallback ausschließlich freigegebene Zugangsdaten und Dienste verwendet |
| Der Schlüssel wird entfernt oder deaktiviert | Wohin die nächste Anfrage geht; die BYOK-Anleitung beschreibt nach dem Entfernen eines Schlüssels einen Fallback auf gemeinsam genutzte Zugangsdaten |
| Das Modell liegt außerhalb des Modellfilters des Schlüssels | Ob der Aufruf abgelehnt wird oder andere Zugangsdaten verwendet |
| Die Auflösung der Zugangsdaten ist nicht verfügbar | Ob das System den Aufruf ablehnt oder auf seinen Verfügbarkeits-Fallback zurückgreift |
| Die Anfrage nennt explizit ein zweites Modell | Ob für dieses Modell separat freigegebene Zugangsdaten und ein freigegebener Dienst vorhanden sind |
Muss eine Workload in einem einzigen Projekt bleiben, prüfen Sie, dass Anfragen immer abgelehnt werden, wenn keine freigegebenen Zugangsdaten und kein freigegebener Dienst verfügbar sind. Allein das Deaktivieren des Fallbacks bei Upstream-Fehlern belegt dieses Verhalten nicht für jede Zeile der Tabelle.
Was sollte vor dem Produktionseinsatz geprüft werden?
Bei Entwicklungswerkzeugen, deren Prompts in AI-Studio-Logs erscheinen dürfen, funktionierte der getestete Custom-Endpoint-Pfad zur Developer API ohne store. Konfigurieren Sie Zugangsdaten, Modellliste und Fallback-Richtlinie in der Gateway-Konsole und prüfen Sie die Protokollierungseinstellung des zugehörigen Google-Projekts.
Für Workloads, bei denen Anwendungslogs deaktiviert sein müssen, ist die von Google dokumentierte Projekteinstellung die empfohlene Steuerung für diese Gateway-Integration. Prüfen Sie das Verhalten bei deaktivierter Protokollierung in Ihrem Projekt. Diese Konfiguration war nicht Teil unseres Experiments. Entfernen Sie ein abgelehntes store=false-Feld nicht in der Annahme, das Datenschutzverhalten der Anfrage bleibe gleich.
Prüfen Sie bei projektgebundenen oder sensiblen Workloads außerdem, wem die Zugangsdaten gehören und wohin jeder Fallback führt. Prüfen Sie auch die Aufbewahrung zu Sicherheitszwecken, Caches und Cloud-Logs. Für Vertex müssen die eigenen Einstellungen separat untersucht werden. Eine BYOK-Konfiguration allein bestätigt diese Bedingungen nicht.
Erfassen Sie einen synthetischen Marker, das Zielprojekt und den Zieldienst, das endgültig übertragene Speicherfeld sowie die Antwort-ID des Anbieters, sofern vorhanden. Gleichen Sie diese Angaben mit den Logs des Anbieters ab. Eine abschließende BYOK-Kennzeichnung in der Abrechnung belegt nicht das Ziel jedes vorherigen Versuchs.
Die gesamte Verarbeitungskette behandelt der Beitrag Datenaufbewahrung bei LLMs und ZDR. Zur Zuordnung von Anfragen siehe Traces und Sitzungen.
FAQ
Deaktiviert Gemini BYOK die Protokollierung von Anfragen?
Gemini BYOK wird in der Gateway-Konsole eingerichtet und legt die Kundenzugangsdaten fest. Die Protokollierung wird weiterhin durch die Projekteinstellungen des tatsächlich verwendeten Dienstes und dessen unterstützte Optionen auf Anfrageebene gesteuert. Prüfen Sie den Zieldienst und seine Protokollierungskonfiguration.
Sollte BYOK über Parameter der Inferenzanfrage konfiguriert werden?
Konfigurieren Sie Synthorai BYOK über die Konsole und senden Sie anschließend normale Inferenzaufrufe mit dem Gateway-API-Key. Der standardmäßige Google-Eintrag im Schlüsselspeicher ist für Vertex vorgesehen. Custom Endpoints für die Developer API werden separat eingerichtet. Weder ein Google-Schlüssel noch store=false im Payload einer Inferenzanfrage ersetzt diese Einrichtung. Konfigurieren Sie die Anfragespeicherung in einem separaten Schritt im tatsächlich verwendeten Google-Projekt.
Bedeutet store=false, dass keine Daten aufbewahrt werden?
Die native Gemini-Einstellung store=false steuert die Speicherung von Anfragen im Anwendungslog. Für die Aufbewahrung zu Sicherheitszwecken beim Anbieter, Caching und sonstige gespeicherte Zustände gelten eigene Regeln. Das Flag allein belegt deshalb keine vollständige Datenlöschung beziehungsweise Zero Data Retention für den gesamten Anfragepfad.
Garantiert deaktiviertes Fallback, dass jede Anfrage in meinem Projekt bleibt?
Ein Schalter für Fallback bei Upstream-Fehlern deckt nur einen Teil der Entscheidung ab. Fehlende oder nicht zulässige Zugangsdaten sowie explizite Modellketten müssen separat geprüft werden. Verlangen Sie eine nachweisbare Ablehnung, sobald für eine projektgebundene Workload keine freigegebenen Zugangsdaten und kein freigegebener Dienst verfügbar sind.