
提示詞 A/B 測試:10% 灰度發布抓出 1.9 倍成本
以工作階段為分流單位,設定將 10% 的正式環境流量分配給新版提示詞,而非逐次呼叫隨機切換。實測 200 個工作階段,其中 16 個使用新版,占比為 8.0%,比設定值低 2 個百分點;所有工作階段全程維持同一提示詞版本,新版每次呼叫成本則為原版的 1.94 倍。
我們的推薦
即時價格| 模型 | 結論 | 價格 |
|---|---|---|
| GPT-6 Luna support-answer 的 v1 在推出期間的 1,272 次呼叫中,每次呼叫成本為 $0.000110,延遲中位數為 4.9 s。將 reasoning_effort 設為 none 時,成本為 $0.000034。 | 示範中的正式環境版本 | 低至 $0.1/百萬 |
| DeepSeek V4.1 Flash v3 在此模型上使用相同提示詞,回覆速度較快(延遲中位數為 3.1 s),但每次呼叫成本為 $0.000213,是 v1 的 1.94 倍,因為輸出的 token 數量為 1.6 倍,且每個 token 的價格較高。 | 示範中的候選版本 | 低至 $0.3/百萬 |
目錄
提示詞灰度發布會把同一個提示詞 ID 的部分呼叫分配給候選版本,其餘繼續使用正式版本。這樣就能先用真實流量比較兩個版本,再決定是否全面切換。在 Synthorai 提示詞庫中,這項設定放在 production 標籤上,例如「v1,並分配 10% 給 v3」。閘道依工作階段 ID 決定每次呼叫使用的版本,因此同一段對話不會中途切換版本。這次實測設定為 10%,200 個工作階段中有 16 個(8.0%)分到候選版本,而且每個工作階段都維持同一版本。候選版本改用了另一個模型,先前沒有人量測過這項變更的成本。光看 10% 階段的各版本統計,就發現候選版本的每次呼叫成本是原本的 1.92 倍。
TL;DR
- 灰度比例設為 10% 時,200 個工作階段中有 16 個使用候選版本,占 8.0%(95% 區間為 5.0 到 12.6%);設為 50% 時,則是 200 個中的 111 個(55.5%)。
- 全部 400 個三輪對話工作階段都維持同一個提示詞版本。透過
_user、請求本文的user或safety_identifier識別的終端使用者也都維持同一版本。 - 候選版本使用相同提示詞,將 GPT-6 Luna 換成 DeepSeek V4.1 Flash。每次呼叫成本從 $0.000110 增至 $0.000213,延遲中位數則從 4.9 s 降至 3.1 s。
- 固定使用
prompt_version=1的呼叫都沒有分到候選版本:40 次中有 0 次。
本文接續提示詞版本管理,沿用其中設定的兩個提示詞及其版本。在 github.com/synthorai-io/use-cases 的同一個目錄執行:
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
這次灰度發布於 2026 年 10 月 19 日執行,共發出 1,840 次呼叫;終端使用者分流檢查則在 10 月 20 日執行。正式版本是 support-answer 的 v1,使用 GPT-6 Luna。候選版本是 v3,使用相同的系統文字與訊息,但改用 DeepSeek V4.1 Flash,唯一的變更就是模型。
如何將 10% 的正式流量分配給新版本?
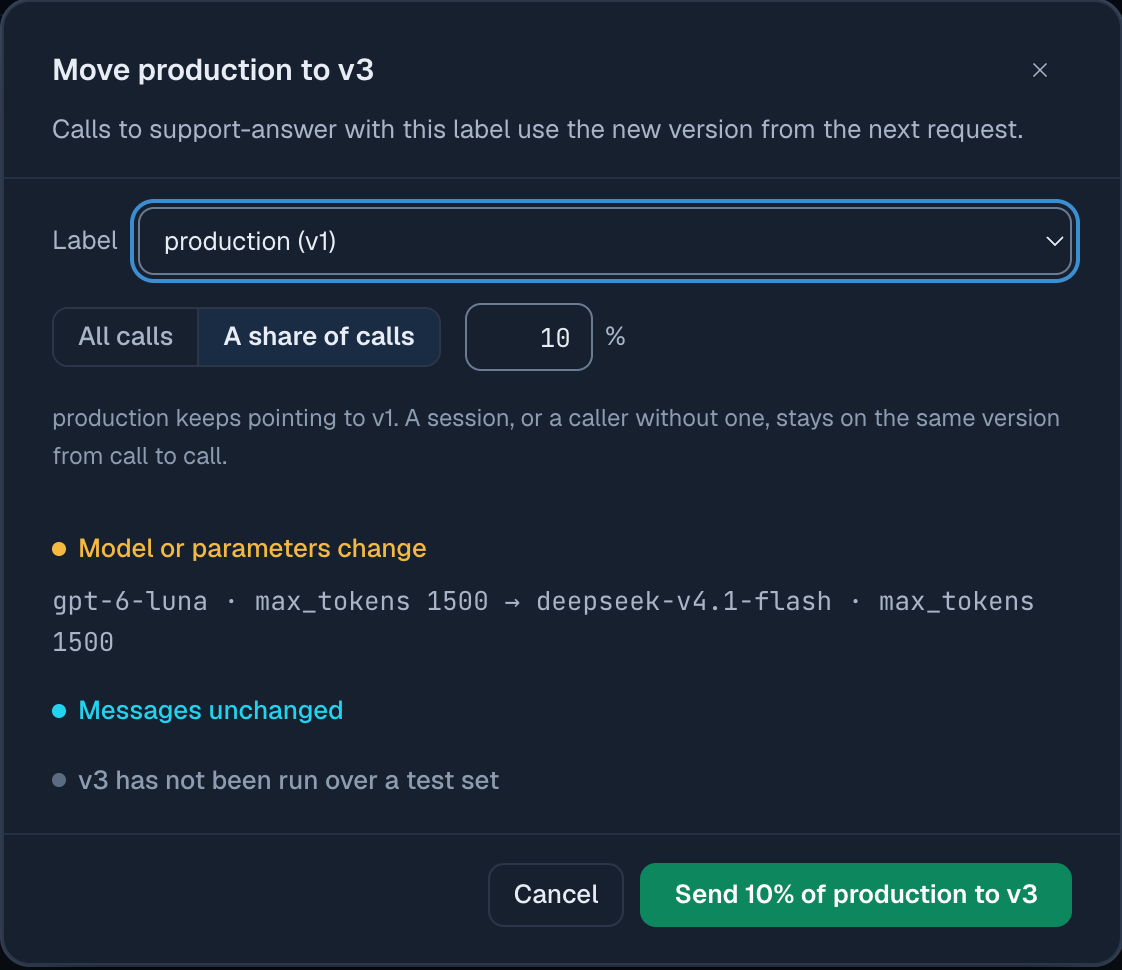
在 production 標籤上指定第二個版本及其流量比例。有管理員金鑰就能用一次呼叫啟用,再用另一次呼叫停止:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
呼叫端不必修改:照常呼叫 support-answer,不指定版本即可。每次呼叫實際使用的版本會放在回應標頭 X-Synthorai-Prompt-Version。要正式上線候選版本時,將 production 移到該版本,灰度發布就會結束。在主控台上,對應設定是候選版本頁面的「逐步發布」,設定後提示詞清單會將標籤顯示為「production v1 · v3 10%」。
哪些呼叫會分到候選版本?
閘道會根據每次呼叫的固定識別鍵選擇版本。只要比例不變,同一個識別鍵就一定會分到同一版本。識別鍵依下列優先順序,採用呼叫中第一個存在的值:
- 工作階段 ID(
X-Session-Id,也就是追蹤 LLM 代理程式使用的標頭); - 終端使用者:先取
X-Synthorai-Metadata中的_user標籤,若沒有則依序取請求本文的user、safety_identifier或 Anthropic 的metadata.user_id; - 以上皆無:使用請求本身,每次呼叫獨立分配。
rollout.py 分別以 10% 和 50% 的比例檢查各種情況。每個工作階段有 3 輪對話,每位終端使用者發出 2 次呼叫:
| 呼叫 | 10% 時:使用 v3 | 50% 時:使用 v3 | 維持同一版本 |
|---|---|---|---|
200 個工作階段,X-Session-Id | 16 = 8.0%(5.0 到 12.6%) | 111 = 55.5%(48.6 到 62.2%) | 400 個工作階段中的 400 個 |
50 位終端使用者,_user 標籤 | 6 | 27 | 100 位使用者中的 100 位 |
| 100 次呼叫,兩者皆無 | 11 = 11.0%(6.3 到 18.6%) | 49 = 49.0%(39.4 到 58.7%) | 不適用 |
20 次固定使用 prompt_version=1 的呼叫 | 0 | 0 |
括號內是 95% 信賴區間,表示在這個試驗次數下,真實比例可能落入的範圍;每個區間都包含設定的比例。另外一次測試以 50% 比例檢查兩個請求本文欄位:50 位使用者只用本文的 user 欄位識別,另有 20 位只用 safety_identifier 識別,每位各呼叫 2 次。全部 70 位都維持同一版本,其中前者有 25 位、後者有 8 位使用 v3。
實際發布時要注意兩件事。工作階段 ID 能讓多輪對話維持一致,因此同一段對話的每次呼叫都應帶上它;若完全沒有識別鍵,同一位使用者可能這次拿到 v1,下次就拿到 v3。另外,以 prompt_version 指定版本的呼叫不參與灰度分流:測試或批次工作只要固定指定版本,就會一直取得該版本。
如何比較兩個版本?
Prompts 頁面會按版本統計呼叫次數、錯誤、費用、token 數與延遲。Requests API 也能透過 prompt_id 和 prompt_version 篩選取得相同指標。示範程式在灰度發布後讀到以下結果:
| 版本 | 請求數 | 費用 | 每次呼叫費用 | 延遲中位數 | 每次呼叫輸出 token 平均數 | 每次呼叫推理 token 平均數 |
|---|---|---|---|---|---|---|
| v1,GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3,DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
推理 token 是模型在回覆前用來思考的 token。它們按輸出計費,但不會顯示在回答中。
提示詞的 Calls 分頁也會顯示這類統計。7 天的統計會納入各版本的所有示範呼叫,不只這次灰度發布,因此數字比上表大。
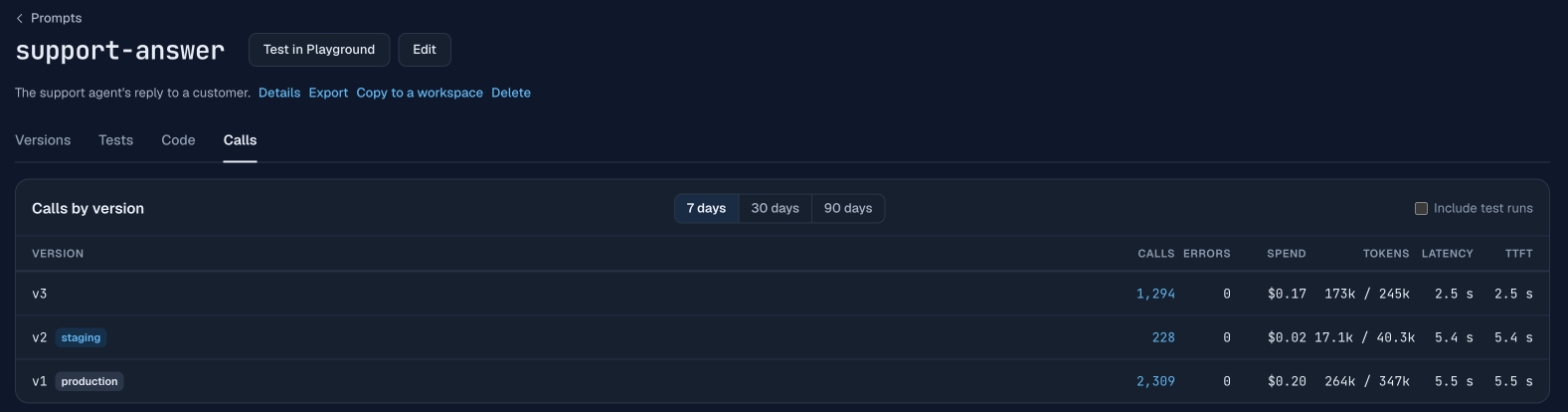
整次執行中,v3 比較快,但每次呼叫成本是 v1 的 1.94 倍。這是兩個因素加起來的結果。在這個閘道上,DeepSeek V4.1 Flash 的每 token 單價比 GPT-6 Luna 高:離峰時段每百萬輸入與輸出 token 分別為 $0.15 和 $0.60,後者則為 $0.10 和 $0.50。此外,v3 產生的輸出 token 是 v1 的 1.6 倍,差異幾乎都來自推理:每次呼叫的推理 token 為 256 對 149,而回答本身的 token 中位數為 65 對 48。這兩項數字都無法從提示詞文字看出來。光在 10% 階段就已經出現差距:v3 回答的 71 次呼叫,每次成本為 $0.000212;v1 回答的 749 次則為 $0.000111,相差 1.92 倍。
價格也會隨時段變動。這次灰度發布的所有 DeepSeek 呼叫,都落在閘道為此模型設定的離峰時段(北京時間 22:00 到 08:00),費率是尖峰時段 $0.30 和 $1.20 的一半。10 月 20 日的 140 次呼叫則在尖峰時段執行,其中 v3 有 66 次、v1 有 74 次,每次成本分別為 $0.000394 和 $0.000107,相差 3.7 倍。
1,840 次呼叫中,有 1,839 次回傳 200。有一次在 300 s 後於用戶端逾時,計為錯誤;該工作階段的其他輪次仍正常取得回覆。
關閉推理會改變結果嗎?
兩個版本的成本都會減少三分之二以上,但 v3 仍然比較貴。effort.py 對每個版本各呼叫 50 次不帶 reasoning_effort 的請求,以及 50 次由呼叫端傳入 reasoning_effort: "none" 的請求。輸入使用提示詞上線前測試測試集中的客戶訊息,每則都提到訂單編號(共 40 則訊息,其中 10 則各使用兩次):
| 版本 | reasoning_effort | 每次呼叫成本 | 輸出 token 平均數 | 延遲中位數 | 回答包含訂單編號 | 判定有回答問題 |
|---|---|---|---|---|---|---|
| v1,GPT-6 Luna | 預設 | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1,GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3,DeepSeek V4.1 Flash | 預設 | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3,DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
「none」在兩個模型上都完全停用了推理,v1 每次呼叫成本減少 68%,v3 則減少 75%。就 50 次呼叫能觀察到的範圍,回答品質仍維持住:每個回答都包含訂單編號,而評分檢查(呼叫 Claude Sonnet 5.5 判斷回覆是否回答客戶問題)的通過數,在 50 次中分別變動 2 次和 4 次,Fisher 精確檢定的 p 值為 0.82 和 0.44。Fisher 精確檢定計算的是:假設「none」沒有影響,出現至少這麼大差異的機率。這麼高的數值表示,差異仍在隨機波動的範圍內。兩者都設為「none」時,v3 每次呼叫成本仍為 v1 的 1.44 倍($0.000049 對 $0.000034)。這批 DeepSeek 呼叫也都在閘道的離峰時段執行。
灰度發布期間,呼叫端不知道哪個版本會回覆,因此它傳入的 reasoning_effort 會同時套用到兩個版本。也可以改將推理強度存到版本上:版本可以儲存 reasoning_effort,當呼叫本身沒有設定推理參數時,閘道會將它寫入 Chat Completions 和 Responses 請求。這樣儲存的候選版本會帶著自己的設定參與灰度發布,各版本統計比較的就是實際上線時的設定。
測試執行會影響比較結果嗎?
預設不會。Prompts 頁面的版本統計會排除測試流量,包括 Playground 呼叫(含主控台的測試執行),以及在 X-Synthorai-Metadata 中標記 source: prompt-test 或 source: eval 的呼叫。開啟「納入測試執行」才會計入。在 support-answer 上,開啟後 v1 和 v2 各增加 150 次呼叫,分別來自帶標籤評估執行的各 110 次,以及主控台測試執行的各 40 次,v3 則沒有變化。日誌和 Requests API 仍會列出每次呼叫,因此若灰度發布期間有執行評估,就要在查詢時依標籤篩選:
X-Synthorai-Metadata: {"source":"eval"}本文未涵蓋的部分
- 成本與延遲的統計檢定。上面的版本表格只比較總計與平均值,沒有對差異做檢定。依差異採取行動前,應先做檢定,尤其是差異很小的時候。
- 真實流量的回答品質。灰度發布能告訴你版本的成本與速度。至於回答是否正確,發布前用固定輸入集比較容易檢查;提示詞上線前測試示範了如何對 v2 進行這項檢查。
- 自動停止。示範程式不會在候選版本的錯誤率或成本超過門檻時自動停止灰度發布。管理員需要自行調整比例、將標籤移到候選版本,或停止灰度發布。
常見問題
如何在正式環境對提示詞做 A/B 測試?
為正式環境標籤設定候選版本與流量比例,照常用提示詞 ID 呼叫,再比較兩個版本的統計。示範中,10% 的比例讓 200 個工作階段中的 16 個分到候選版本;幾百次呼叫後,就能從統計看出成本差異。
灰度發布會讓每段對話維持同一版本嗎?
只要呼叫帶有工作階段 ID,同一段對話就會維持同一版本。示範中的全部 400 個工作階段,在三輪對話中都維持同一版本。沒有工作階段 ID 時,會改用終端使用者識別資訊;兩者都沒有時,就會逐次獨立分配呼叫。
提示詞文字不變,成本也可能上升嗎?
相同文字換用不同模型,就可能發生,這次示範就是如此。使用 DeepSeek V4.1 Flash 的候選版本,每次呼叫成本是 GPT-6 Luna 版本的 1.94 倍,因為它在這個閘道上的每 token 單價較高,推理也用了更多 token。應比較整個版本的每次呼叫成本,而不只是模型單價。
延伸閱讀
- 提示詞版本管理:透過 ID 呼叫提示詞,以及移動標籤。
- 提示詞上線前測試:測試集與檢查方法,以 v2 對照 v1。
- 為什麼我的 LLM 代理程式這麼貴?:從追蹤紀錄中找出的另外四種高額費用成因。
- 提示詞庫指南:灰度發布、各版本統計與所有欄位。