
用 3 個 HTTP 標頭追蹤 LLM 代理,不必安裝追蹤 SDK
在代理程式的模型呼叫中加入三個請求標頭,即可取得每次執行的瀑布圖,檢視平行呼叫、自己的程式碼所花費的時間、失敗的呼叫及費用。透過同一次執行的時間軸,區分模型呼叫與自有程式碼的耗時,查看哪些呼叫同時進行、哪些呼叫失敗,並掌握該次執行的成本。
我們的推薦
即時價格| 模型 | 結論 | 價格 |
|---|---|---|
| GPT-6 Luna 處理示範中的函式呼叫迴圈。在本頁顯示的執行中,每回合的兩次呼叫(規劃與回答)合計費用為 $0.0002。 | 示範中的主要代理程式 | 低至 $0.1/百萬 |
| DeepSeek V4.1 Flash 在關閉推理的情況下,平行執行三項單句檢查。在本頁顯示的工作階段中,其六次呼叫的費用為 $0.0004,而第七次子代理程式呼叫失敗,費用為 $0。 | 示範中的子代理程式 | 低至 $0.3/百萬 |
目錄
如果代理為了回答一則訊息要呼叫模型五次,光看逐筆請求記錄很難除錯:你看不出哪些呼叫屬於同一次執行、哪些同時進行,也不知道等待時間有多少花在自己的程式碼上。本文在一個小型客服代理中加入三個請求標頭,再到 Synthorai 主控台查看追蹤(以時間軸呈現一次執行)與工作階段(一段對話及其費用)。不必安裝追蹤 SDK,也不必執行 collector(接收追蹤資料的獨立服務)。原始碼位於 github.com/synthorai-io/use-cases 的 agent-tracing/ 目錄。需要 Python 3.10 以上版本,以及從主控台取得的 API 金鑰。
TL;DR
- 每次模型呼叫都帶上三個請求標頭(
X-Trace-Id、X-Span-Id、X-Session-Id),Synthorai 主控台就能把請求記錄整理成追蹤與工作階段,不必使用追蹤 SDK。 - 範例追蹤的實際耗時為 8.5 s,其中約 7.0 s 用於模型呼叫,1.6 s 用於呼叫之外的代理程式碼與網路傳輸。
- 一次回傳 404 的失敗呼叫仍保留在追蹤中,費用為 $0。
- 範例共執行 21 次模型呼叫,費用為 $0.0017。
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
我們在 2026 年 10 月 11 日執行時,不到一分鐘就完成 21 次模型呼叫,費用為 $0.0017。程式會印出兩個工作階段 ID 與四個追蹤 ID。在主控台開啟追蹤,就能看到相同的 ID。主控台使用瀏覽器的時區顯示時間,因此本頁截圖中的 19:24 對應 UTC 11:24。
要傳送哪些資料才能產生追蹤?
每次模型呼叫都傳送三個標頭,值是由你指定的字串。閘道原本就會記錄每筆請求;這些標頭只是告訴它哪些請求屬於同一組。
| 標頭 | 哪些呼叫使用相同的值 | 產生的結果 |
|---|---|---|
X-Trace-Id | 同一次執行的所有呼叫(從頭到尾處理一則使用者訊息) | 將呼叫畫在同一張瀑布圖上 |
X-Span-Id | 僅用於一次呼叫 | 該呼叫在瀑布圖中的列名稱 |
X-Session-Id | 同一段對話的所有呼叫 | 將各次執行歸為一組,並統計整段對話的總量 |
span 是追蹤中的一個步驟。本文每個 span 都對應一次模型呼叫。每個 ID 最多可使用 128 個可列印的 ASCII 字元。閘道會在回應中傳回這些 ID,不會轉送給模型供應商。
另有三個選用標頭。X-Agent-Id 指出哪個子代理發出呼叫,X-Parent-Agent-Id 指出哪個代理啟動了該子代理,X-Synthorai-Metadata 則攜帶功能或終端使用者等標籤。完整說明見請求標頭參考。範例會傳送 X-Agent-Id 與標籤,但不傳送 X-Parent-Agent-Id:唯一的子代理由主代理啟動,沒有需要描述的巢狀關係。
範例用一個函式建立每次呼叫的標頭,這個函式就是整個追蹤層:
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
代理中的每次模型呼叫都經過同一個包裝函式,由它附加標頭。使用 OpenAI Python SDK 時,個別請求的標頭放在 extra_headers:
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id")   # the gateway's id for this call
使用 with_raw_response 只是為了讀取回應標頭。如果不需要請求 ID,直接用 create(..., extra_headers=...) 即可。
範例代理做了什麼?
它分四個階段、五次模型呼叫來回答客戶訊息,刻意安排這個流程,讓追蹤圖有內容可看。主代理使用 GPT-6 Luna,子代理使用 DeepSeek V4.1 Flash,兩者都透過環境變數設定。子代理呼叫設定 reasoning_effort="none",因為只要用一句話完成的檢查,不需要模型先進行推理。如果改用不接受這個值的子代理模型,請修改或清除 ANALYST_REASONING。
| Span | 執行者 | 執行內容 |
|---|---|---|
plan | 主代理 | 讀取訊息並要求使用工具(function calling:模型傳回函式名稱與引數,供你的程式碼執行) |
| 無 | 你的程式碼 | 在本機平行執行兩個工具:訂單查詢(1.2 s)與政策搜尋(0.6 s) |
sentiment, policy-check, risk | 子代理 analyst | 同時送出三項檢查,每項以一句話作答 |
answer | 主代理 | 根據工具結果與三項檢查撰寫回覆 |
工具是一般的 Python 函式,內含 sleep,用來模擬資料庫與搜尋索引。加上 --fail 後,其中一次 policy-check 呼叫會先要求不存在的模型,收到 404,再以 policy-check.retry 作為 span 名稱重試。
run.py 會執行兩段對話,每段各有兩輪。每段對話使用一個工作階段 ID,每一輪則產生新的追蹤 ID:
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
如何解讀瀑布圖?
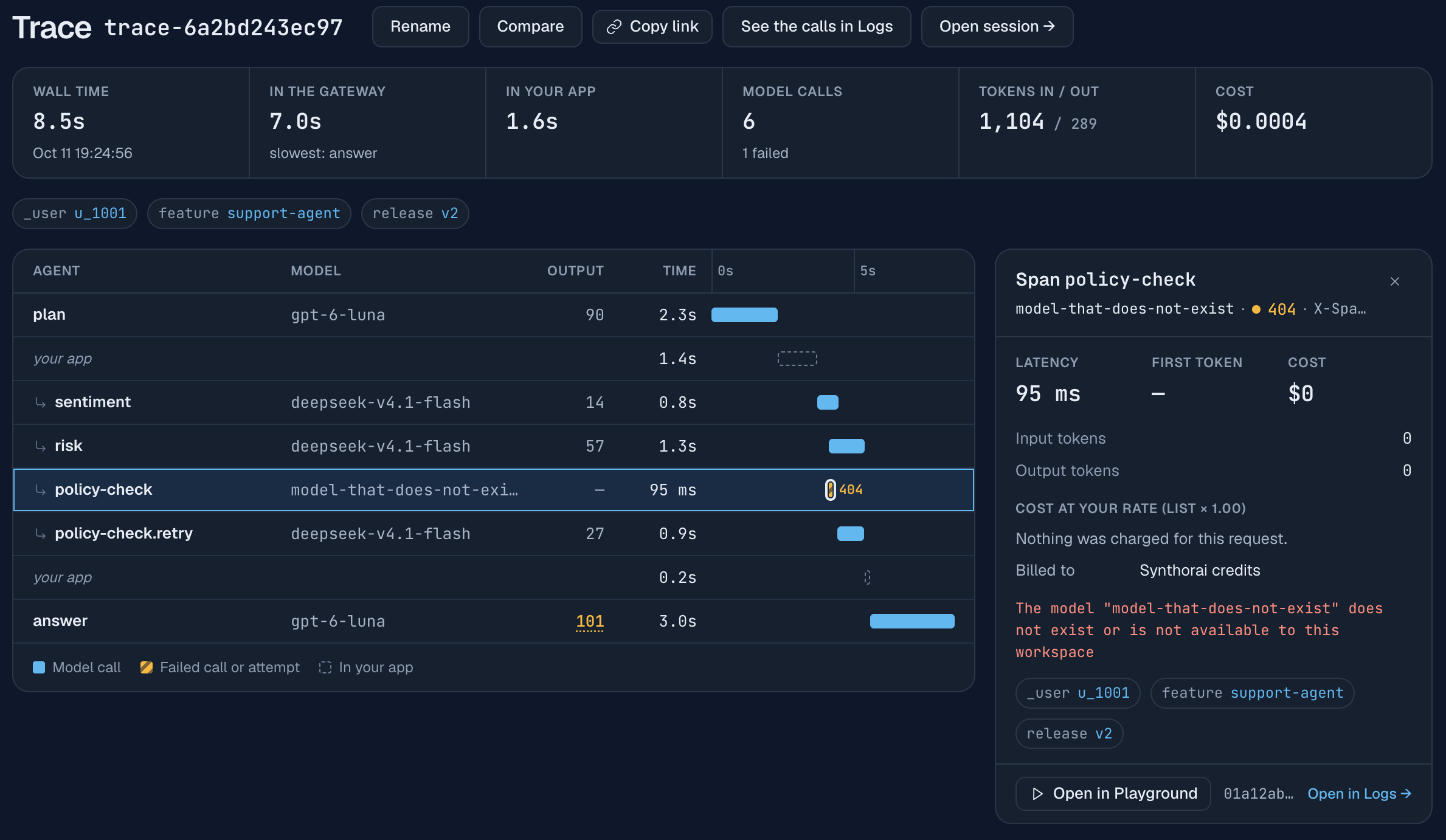
每一列代表一次模型呼叫,或自己的程式碼執行期間留下的空檔。時間軸從該次執行的第一個呼叫抵達閘道時開始。上方截圖是第一段對話的第二輪,由上往下讀:
plan耗時 2.3 s。長條表示閘道處理該請求的時間,從收到請求到完成回應為止。your app耗時 1.4 s。這段期間沒有處理中的請求,因此時間花在閘道之外:你的程式碼,以及程式碼與閘道之間的網路傳輸。此處是兩個本機工具,較慢的那個會暫停 1.2 s。在實際代理中,這一列能讓你看到耗時的資料庫查詢或向量搜尋。sentiment、risk與policy-check.retry互相重疊。代理透過asyncio.gather送出三項檢查,重疊的長條表示平行呼叫。名稱前的箭頭表示呼叫來自子代理。policy-check是標有404的 95 ms 斜線記號。失敗呼叫仍會留在追蹤中,並顯示程式碼收到的狀態碼。answer耗時 3.0 s,是最慢的呼叫,瀑布圖上方的摘要也會指出這一點。- Output 欄顯示每次呼叫的輸出 token 數。呼叫的時間主要花在輸出,因此這一欄通常能解釋旁邊長條的長度:
answer輸出 101 個 token,三項檢查各輸出 14 到 57 個。較大的輸出若大多用於推理,主控台會在數量下方加上底線,此處的 101 就是如此。
摘要將 8.5 s 的實際耗時拆成閘道內的 7.0 s,以及應用程式的 1.6 s。這個拆分能回答大多數延遲調查的第一個問題:該查模型呼叫,還是自己的程式碼?這次執行有 82% 的等待時間花在模型上,主代理的 plan 與 answer 兩次呼叫就占了 5.3 s。因此,替主代理換成更快的模型,比加快三項檢查更有幫助。
閘道看不到程式碼內部。它根據請求之間的空檔推算 your app 列,所以空檔只告訴你程式碼執行了多久,不會告訴你它做了什麼。如果自己的函式也需要 span,就要使用開放追蹤標準 OpenTelemetry 的 SDK。兩者可以共用 ID:未傳送 X-Trace-Id 時,閘道會讀取攜帶追蹤 ID 的標準標頭 traceparent。
工作階段比追蹤多提供了什麼?
工作階段將同一段對話的各次執行歸為一組,並計算總量。你可以從追蹤清單開啟工作階段,也可以在任一追蹤中使用「開啟工作階段」。
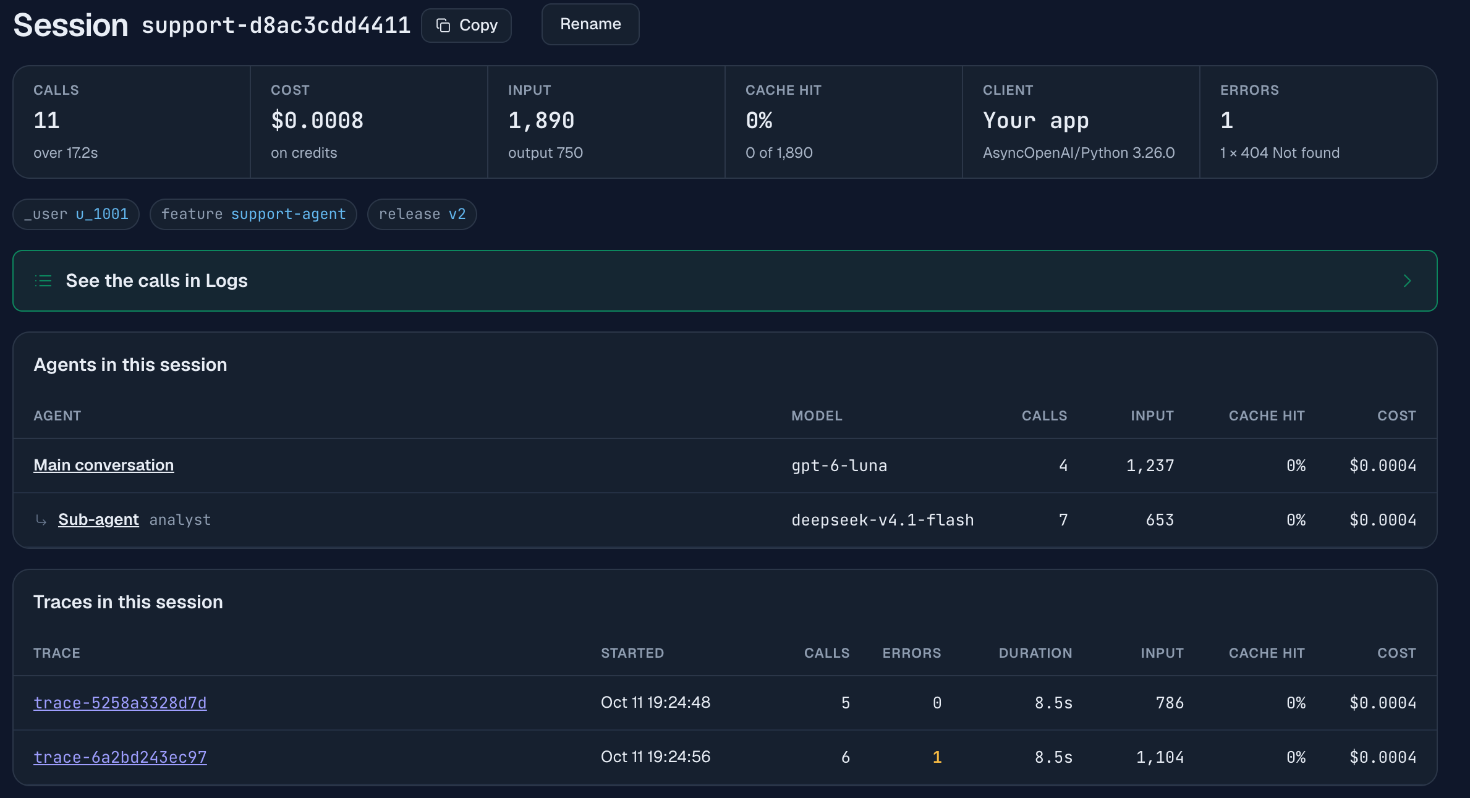
上方工作階段是一段兩輪的客戶對話:11 次呼叫、1,890 個輸入 token、750 個輸出 token、費用 $0.0008,以及一次錯誤。頁面分為三個部分:
- 此工作階段中的代理 依代理拆分呼叫次數與費用。主代理使用 GPT-6 Luna 呼叫 4 次,費用 $0.0004;
analyst子代理呼叫 7 次,費用 $0.0004,其中六次使用 DeepSeek V4.1 Flash,另一次是失敗呼叫。因為子代理呼叫帶有X-Agent-Id: analyst,才會出現這張表。未帶此標頭的呼叫會計入主對話。 - 此工作階段中的追蹤 列出每一輪的錯誤、耗時、輸入 token、快取命中率與費用。不必捲動記錄,就能找出長對話中較慢、失敗或費用較高的那一輪。
- 快取命中率 是從供應商 prompt cache 讀取的輸入 token 比例。此處為 0%,因為 prompt 只有幾百個 token,而供應商只會快取超過最低長度的前綴(多數供應商為 1,024 個 token,詳見 prompt 快取)。
當 prompt 長到足以使用快取時,工作階段 ID 還有另一個重要用途。同一段對話的每次呼叫都傳送相同的 X-Session-Id,閘道會用它維持該對話的 prompt cache 命中一致性,讓第二輪讀取第一輪寫入的快取。在 /v1/chat/completions 與 /v1/responses 上,如果框架不方便設定標頭,也可以把值放在請求主體的 session_id。
如何依功能或使用者拆分費用?
透過 X-Synthorai-Metadata 傳送值皆為字串的扁平 JSON 物件,再依它分組或篩選。範例在每次呼叫加上功能、版本與終端使用者標籤:
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}這些標籤會以小標籤顯示在追蹤與工作階段上。若要看總量,開啟分析頁面,選擇分類明細分頁,找到「依中繼資料統計費用」卡片。選取一個鍵後,卡片會列出該鍵的所有值,以及各自的請求數、錯誤數、輸入 token 與費用:
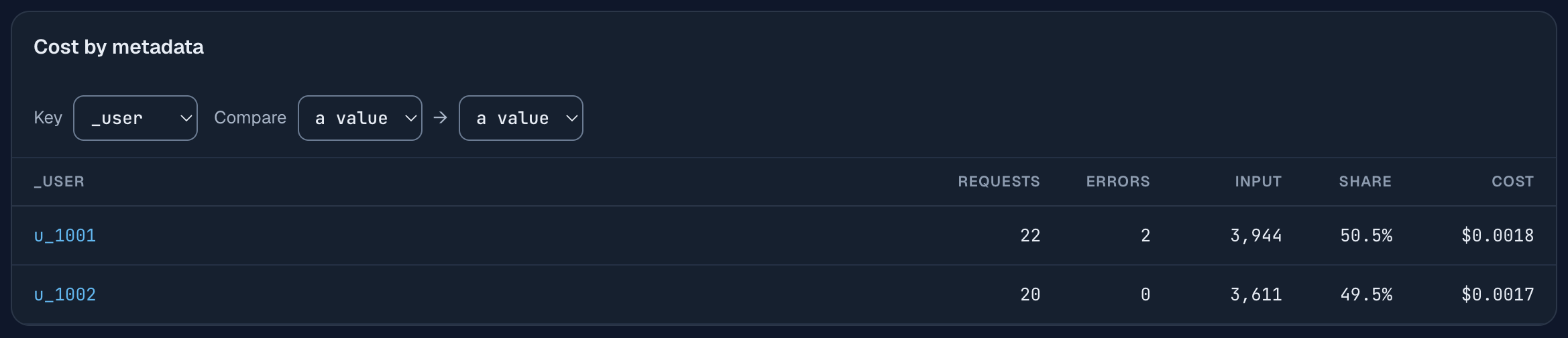
上方卡片涵蓋範例執行兩次的一小時:u_1001 的執行包含兩次失敗呼叫,共 22 筆請求、$0.0018;u_1002 則有 20 筆請求、$0.0017。執行一次後,你會看到 11 與 10。選取 feature 可查看各功能的費用,選取 release 則能查看修改 prompt 對費用的影響。卡片也可以並排比較同一個鍵的兩個值。同一分頁還有「依代理統計費用」卡片,可跨工作階段加總各 X-Agent-Id 的費用。
要找出某個數字背後的執行,標籤也能用來搜尋。在追蹤清單的搜尋框輸入 metadata._user = u_1002 並按 Enter,就只會保留該使用者的工作階段與追蹤。記錄頁面的篩選框也接受同樣的運算式,用來篩選個別請求。
標籤規則很簡單:
- 每筆請求最多 10 個標籤。鍵長度為 1 到 32 個字元,可使用
a-z、0-9、_、.與-。值是最多 128 位元組的字串。 _user用來標示該請求所服務的終端使用者。其他底線開頭的鍵為保留名稱。- 違反規則的標籤會被捨棄,但請求仍會執行。回應標頭
X-Synthorai-Metadata-Dropped會列出被捨棄的鍵,設定時請記錄這個標頭。我們傳送名為Bad?Key的鍵來測試,回傳標頭中確實包含Bad?Key。 - 不要把 prompt 文字、個人資料或機密放進標籤。
_user請使用內部使用者 ID,不要使用電子郵件地址。
呼叫失敗時會發生什麼事?
它會以附有狀態碼的斜線記號保留在追蹤中,而且不收費。範例中失敗的 policy-check 要求了一個不存在的模型 ID。在瀑布圖中選取它,會開啟上方截圖右側的面板,顯示程式碼收到的錯誤:The model "model-that-does-not-exist" does not exist or is not available to this workspace,以及 95 ms 延遲、$0 費用與未收費註記。
範例為重試指定獨立的 span 名稱:
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
保留追蹤 ID、改變 span 名稱,就能把失敗與重試並排放在同一張圖中。如果重試邏輯位於重複使用相同標頭的函式庫,兩次嘗試仍然會顯示,只是會成為名稱相同的兩列。
錯誤也會彙總。追蹤摘要會顯示「6 次模型呼叫,1 次失敗」,工作階段會依狀態碼列出錯誤(1 × 404 Not found),追蹤清單則有可排序的錯誤欄,方便找出需要處理的執行。
如何在程式碼中取得每次呼叫的費用?
使用回應傳回的請求 ID,向閘道查詢該請求的計費記錄。GET /v1/generation?id=<request id> 會傳回一筆請求的費用、token 數、延遲與狀態。
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
記錄會在回應完成後不久寫入,因此函式會重試,直到收到 200。呼叫端建立一次 httpx.AsyncClient,設定 Authorization 標頭,再將它傳入每次查詢。透過同一個 client 查詢二十次呼叫,只需重複使用少數連線。如果每次查詢都建立新的 client,就會同時開啟二十條連線;我們執行時,其中一兩條曾中斷。範例會根據自行量測的時間與這些記錄,為每次呼叫印出一行。以下是截圖中工作階段的第一輪:
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
這裡的時間由 client 量測,包含網路傳輸,因此比主控台的長條更長;主控台量測的是請求在閘道內的時間。在上方瀑布圖所示的第二輪,plan 在 client 端耗時 2,499 ms,在閘道內為 2.3 s;answer 則分別為 3,161 ms 與 3.0 s。平行送出的呼叫可能差距更大:失敗呼叫在 client 端耗時 694 ms,在閘道內只有 95 ms。
如果想在自己的記錄中寫入每次呼叫實際計費的金額,可以複製這個函式。但它不適合用來中止花費過高的執行,因為每筆記錄都要等呼叫完成後才產生,函式也可能等待數秒。若要即時控管預算,請在執行過程中自行依每個回應的 usage 計算費用,之後再用這些記錄核對計算結果。
如果代理已經傳送追蹤標頭呢?
這種情況可能不必再加任何東西。對於請求未攜帶的三種 ID,閘道會分別讀取常見工具已經傳送的對應標頭:
| 使用的工具 | 傳送的標頭 | 解讀為 |
|---|---|---|
| OpenTelemetry HTTP instrumentation | traceparent | 追蹤,並以其父 ID 作為 span |
| LiteLLM SDK | X-Litellm-Trace-Id, X-Litellm-Session-Id | 追蹤、工作階段 |
| Langfuse SDK | baggage: langfuse_trace_id=…, langfuse_session_id=… | 追蹤、工作階段 |
| Open WebUI | X-OpenWebUI-Chat-Id | 工作階段 |
| Claude Code | X-Claude-Code-Session-Id | 工作階段 |
| OpenAI Codex CLI | Session-Id | 工作階段 |
兩種標頭同時存在時,以你設定的 X-Trace-Id、X-Span-Id 與 X-Session-Id 為優先。完整清單見請求標頭參考。如果代理框架不會傳送任何這類標頭,就要透過它提供的自訂標頭設定加上去。
有了追蹤之後,可以做什麼?
最常見的用途是與另一筆追蹤比較。每個追蹤頁面都有比較按鈕:選取第二筆追蹤後,主控台會在同一頁顯示兩者,每項指標列出 A、B 與差異,同名呼叫互相配對,兩張瀑布圖則共用一條時間軸。這樣就能確認修改 prompt、模型或自己的程式碼,對執行造成了什麼影響。
以下三篇延伸指南使用相同的代理與標頭,並以這種方式重現問題、修正問題,再比較結果:
- LLM 代理為什麼這麼慢? 依序執行的呼叫、程式碼中的慢工具,以及單行回答仍使用推理的問題。
- LLM 代理為什麼這麼貴? 破壞快取的時間戳記、不斷增加的上下文、重試迴圈與選錯模型。
- 為 LLM 代理除錯 從使用者抱怨一路查到出錯的呼叫。
另外三篇從不同角度查看同一份記錄:
- 依子代理分析 Claude Code 費用 透過相同的工作階段與代理檢視,分析不是自己寫的程式碼代理。
- 向 Claude 詢問 LLM 記錄 透過唯讀 MCP 連線,在聊天視窗中詢問這些工作階段的相關問題。
- 為代理提供記錄查詢工具 在自己的程式中使用相同工具,以及模型 token 的費用。
範例沒有涵蓋哪些部分?
範例涵蓋模型呼叫。正式環境通常還會補上以下四個面向:
- 自己的程式碼 span。閘道會顯示模型呼叫之間的空檔,但不知道空檔裡執行了什麼。使用 OpenTelemetry 對工具、檢索與佇列加入追蹤,並傳遞
traceparent,就能用同一個追蹤 ID 串起兩種檢視。 - Prompt 與回應主體。本文使用每次呼叫的時間、token 與費用記錄,不涵蓋檢查實際送給模型的內容。
- 預算。
cost_of提供事後的實際計費金額。要在達到上限時停止執行,就得在每個回應抵達時,依其usage計算費用;這需要在代理迴圈中加入幾行程式碼,範例未包含這部分。 - 取樣。每次呼叫都會記錄,因為追蹤是由閘道原本就保留的請求記錄建立的。沒有需要取樣的資料,代理端除了幾個標頭以外,也沒有額外負擔。
常見問題
追蹤 LLM 代理需要 OpenTelemetry 嗎?
不需要。每次模型呼叫帶上三個請求標頭(X-Trace-Id、X-Span-Id、X-Session-Id),就能產生模型呼叫的瀑布圖,呼叫之間的時間則顯示為應用程式耗時。如果自己的函式也需要 span,OpenTelemetry 才派得上用場。
追蹤與工作階段有什麼差別?
追蹤代表代理的一次執行,也就是處理一則使用者訊息或一項任務所做的所有事情。工作階段則是一段對話,由多次執行組成。範例中,每段客戶對話都是一個工作階段,包含兩筆追蹤,每筆追蹤有五或六次模型呼叫。
追蹤標頭會改變路由、計費或模型看到的內容嗎?
X-Trace-Id 與 X-Span-Id 不會改變任何行為。X-Session-Id 會維持同一段對話的 prompt cache 命中一致性。這些標頭都不會轉送給模型供應商,計費則以閘道自己的請求 ID 為依據。
追蹤會保留多久?
追蹤與工作階段由請求記錄建立,同樣涵蓋 90 天。追蹤清單預設顯示最近 7 天。
失敗呼叫會收費嗎?
範例中因未知模型 ID 而回傳 404 的失敗呼叫,記錄的費用為 $0,並註明未收費。
延伸閱讀
- 建立 LLM 聊天機器人:單一代理的案例,包含上下文管理、記憶與 prompt 快取。
- 請求標頭參考:本頁所有標頭,以及從其他工具讀取的別名。
- 主控台中的追蹤與工作階段:清單、瀑布圖與工作階段頁面。
- 解析 LLM token 用量:各供應商記錄中的 token 數分別代表什麼。