
提示詞版本管理:不到 10 秒上線,不必重新部署
將 LLM 提示詞集中存放於提示詞程式庫,透過 prompt_id 呼叫;部署時只需移動標籤,讓線上呼叫使用對應提示詞。實測從標籤變更到線上呼叫套用約需 8 到 9 秒;與直接在請求中傳入提示詞相比,提示詞 token 數維持相同,兩者皆為 114.5,未因改用程式庫而增加。
我們的推薦
即時價格| 模型 | 結論 | 價格 |
|---|---|---|
| GPT-6 Luna 提供 support-answer 的 v1 和 v2。透過提示詞 ID 呼叫時,送出的提示詞 token 數與直接在請求中傳送轉譯後提示詞的方式相同,皆為 114.5(20 組配對的中位數)。 | 示範中回答提示詞使用的模型 | 低至 $0.1/百萬 |
| DeepSeek V4.1 Flash 執行 policy-check v1,使用儲存在該版本上的輸出結構定義:以 18 個輸出 token 產生 JSON 回答,費用為 $0.000033,reasoning_effort 設為 none。 | 示範中 JSON 檢查使用的模型 | 低至 $0.3/百萬 |
目錄
提示詞版本管理,就是把每個提示詞移出程式碼,存成有編號、不可變更的版本,以 ID 呼叫,再用標籤指定正式環境要使用哪個版本。標籤是具名的指標,例如 production 或 staging,同一時間只指向一個版本。在 Synthorai 提示詞庫中,請求以 prompt_id 指定提示詞,閘道會填入該版本的訊息、模型與參數;移動 production 標籤,就能改變後續呼叫使用的內容。實測中,持續有流量時,標籤移動後需要 8 到 9 秒才會套用至線上呼叫;若流量已暫停一段時間,恢復後的第一個呼叫就會使用新版本。以 ID 呼叫與在程式碼中完整寫出同一份請求,送出的提示詞 token 數完全相同。
TL;DR
- 以
prompt_id呼叫 Synthorai 閘道,在 20 組配對測試中,提示詞 token 數的中位數為 114.5,與直接傳入完整請求相同。 - 持續有流量時,移動
production標籤後,經過 8.0 到 8.5 s(中位數)便會套用至呼叫;若先暫停呼叫 15 s,則會立即套用。 - 在 20 次標籤移動中,只要第一個呼叫取得新版本,之後就沒有呼叫再取得舊版本。
- 無法處理的呼叫會在執行模型前回傳 400 或 404,不收費。
本文將追蹤 LLM 代理程式中的客服代理程式提示詞移入提示詞庫,並示範閘道支援的所有呼叫方式。程式碼放在 github.com/synthorai-io/use-cases 的 prompt-library/ 目錄下。執行環境需要 Python 3.10 以上版本、推論金鑰,以及從控制台取得、具備 prompts.write 權限的管理金鑰。
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put both keys in it
cd prompt-library
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python setup.py         # saves the prompts and their versions; safe to run again
python call.py          # every way to call a prompt
python ship.py          # moves production and times it
python errors.py        # what a call that cannot be served answers
本文的測試執行於 2026 年 10 月 19 日。setup.py 會儲存兩個提示詞。support-answer 用於代理程式的回覆步驟,共有四個版本,每個版本各做一項實務上可能出現的變更;policy-check 則用於子代理程式的檢查步驟,以 JSON 回覆:
| 提示詞 | 版本 | 變更內容 | 模型 |
|---|---|---|---|
support-answer | v1 | 基準版本:寫出訂單編號,絕不承諾退款日期 | GPT-6 Luna |
support-answer | v2 | 縮短系統文字,移除訂單編號規則 | GPT-6 Luna |
support-answer | v3 | 使用 v1 的文字,但改用另一個模型 | DeepSeek V4.1 Flash |
support-answer | v4 | 在 v1 加入沒有預設值的 {{tone}} 變數 | GPT-6 Luna |
policy-check | v1 | 依 schema 輸出 JSON,包含主題與風險等級 | DeepSeek V4.1 Flash |
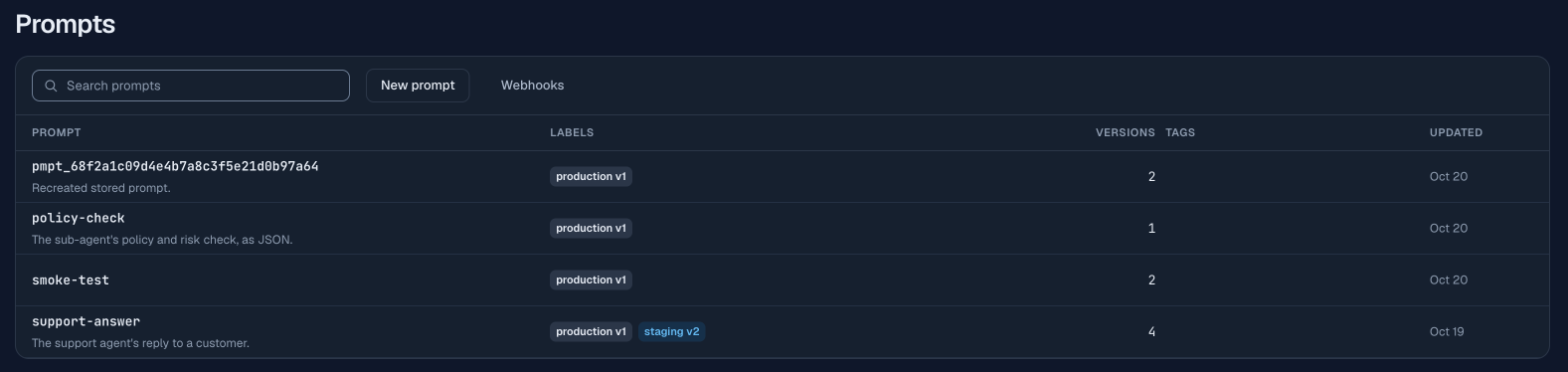
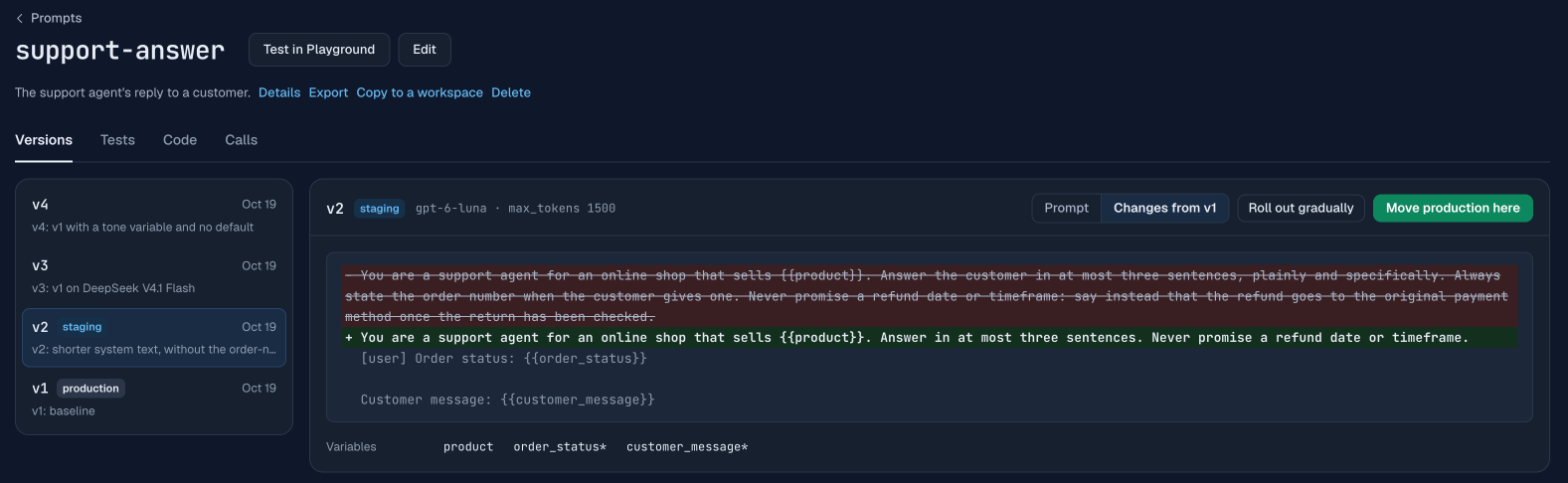
production 指向 v1,staging 指向 v2。後續兩篇教學會使用 v2 與 v3:上線前測試版本與將版本推出至部分正式流量。控制台會顯示每個版本與前一版的差異:
如何以 ID 呼叫提示詞?
向 /v1/chat/completions、/v1/responses 或 /v1/messages 傳送一般請求,並在主體加入 prompt_id 和 prompt_variables。變數是版本文字中的 {{name}} 佔位符,prompt_variables 則提供這次呼叫要代入的值。SDK 要求必須提供模型與訊息,因此傳入任意模型名稱和一則空白的使用者訊息即可:閘道會採用版本設定的模型,並移除空白訊息。使用 OpenAI Python SDK 時,這些額外欄位放在 extra_body:
import os
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key=os.environ["SYNTHORAI_API_KEY"])

raw = client.chat.completions.with_raw_response.create(
    model="any",                                   # the version's model is used
    messages=[{"role": "user", "content": ""}],    # required by the SDK; dropped
    extra_body={
        "prompt_id": "support-answer",
        "prompt_variables": {
            "customer_message": "Where is order A-50977? It has been a week.",
            "order_status": "in transit, shipped on 2026-10-01",
        },
    },
)
print(raw.headers["x-synthorai-prompt-version"])   # which version answered
print(raw.parse().choices[0].message.content)
呼叫中沒有 product,因為版本已設定預設值(「家用電子產品」)。X-Synthorai-Prompt-Version 回應標頭會指出實際使用的版本;透過標籤呼叫時,這是呼叫端得知版本的唯一方式。
未指定版本時,呼叫會使用 production 指向的版本。若要選擇其他版本,可使用以下兩個欄位之一,不能同時傳入:
| 欄位 | 範例 | 示範中使用的版本 |
|---|---|---|
| 無 | v1(production) | |
prompt_label | "staging" | v2 |
prompt_version | 1 | v1 |
同樣的 ID 呼叫方式,在三個端點都能正常運作:Chat Completions 與 Responses 使用 OpenAI SDK,Messages 則使用 Anthropic SDK,搭配相同的 extra_body。三者都使用 v1,模型為 GPT-6 Luna。在 Responses 中,版本的訊息會放入 input;各欄位在不同端點的對應方式,請見提示詞庫指南。
以 ID 呼叫,會比把提示詞寫在程式碼中更貴嗎?
費用相同,因為閘道送給供應商的仍是一般請求。我們用 20 組配對測試驗證:每組先把變數代入提示詞,直接傳送展開後的完整請求,再以 ID 傳入相同的值。兩種呼叫順序交替進行,同一組使用相同的 salt(加在訊息中的簡短隨機標記,確保不同組不會是完全相同的請求):
| 提示詞 token 數,中位數 | 用戶端延遲,中位數 | |
|---|---|---|
以 prompt_id 呼叫 | 114.5 | 4.1 s |
| 直接傳入 | 114.5 | 4.6 s |
token 數完全相同。以 ID 呼叫反而較快,而額外開銷不可能讓請求變快,因此我們將差距視為 GPT-6 Luna 每次呼叫之間的波動,結論是以 ID 呼叫沒有增加可量測的耗時。我們未對延遲差異進行統計檢定。
若想查看實際會送出什麼內容,又不想呼叫模型,可以先展開提示詞。POST /v1/prompts/{id}/render 接受相同的變數,回傳展開後的請求與解析出的版本:
curl https://synthorai.io/v1/prompts/support-answer/render \
  -H "Authorization: Bearer $SYNTHORAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"format": "chat", "prompt_variables": {"customer_message": "Where is order A-50977?", "order_status": "in transit"}}'
展開提示詞不收費,也不會出現在 Logs 中:示範執行展開操作後,Logs 中沒有該 session ID 的請求紀錄。不過,這項操作仍會計入金鑰的速率限制。
移動標籤後,多久會套用至呼叫?
不到 10 秒:實測持續有呼叫時需要 8 到 9 s;若流量已暫停一段時間,則立即生效。版本上線只需用管理金鑰呼叫一次 API,將標籤指向指定的版本編號:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})
admin.put("/prompts/support-answer/labels/production", json={"version": 3}).raise_for_status()
回復舊版也使用相同呼叫,只要換成舊版本編號。程式碼繼續呼叫同一個 ID,不必重新部署任何東西。只有管理員或工作區擁有者能移動標籤,每次移動都會記錄在工作區的稽核紀錄中。
ship.py 負責計時。它每隔 0.5 s 傳送一次呼叫,透過 API 移動 production,持續呼叫直到回應標頭顯示新版本,再繼續呼叫 10 s。它從 v1 切到 v3 共 5 次,再切回 v1 共 5 次;接著重複這 10 次移動,但每次都先暫停呼叫 15 s:
| 情境 | 最後一個由舊版本回覆的呼叫,送出時間 | 第一個由新版本回覆的呼叫,送出時間 |
|---|---|---|
| 每 0.5 s 呼叫一次,v1 切到 v3 | 移動後的中位數為 8.02 s(7.53 到 8.53) | 中位數 8.52 s(8.03 到 9.03) |
| 每 0.5 s 呼叫一次,v3 切到 v1 | 中位數 7.52 s(7.52 到 8.52) | 中位數 8.02 s(8.02 到 9.02) |
| 暫停呼叫 15 s 後,兩個方向皆同 | 無 | 10 次移動皆為 0.0 s |
時間從移動標籤的 API 呼叫回傳時開始計算。文件說明,移動後約「10 秒」會套用至呼叫。這兩種情境都符合以下行為:閘道在讀取標籤後,會保留讀到的內容數秒。持續有流量時,要等這份副本到期才會看到變更;暫停一段時間後,第一個呼叫會重新讀取標籤。20 次移動中,第一個呼叫取得新版本後,就沒有任何呼叫再取得舊版本,因此變更傳播期間不會在新舊版本之間來回切換。
無法處理呼叫時會怎樣?
呼叫會在執行任何模型前失敗,回傳 400 或 404,錯誤格式依呼叫的端點而定,且不收費。errors.py 傳送了五種這類呼叫:
| 呼叫 | 狀態碼 | 錯誤碼 | 訊息 |
|---|---|---|---|
呼叫 v4,但未提供 tone | 400 | prompt_variable_missing | 「prompt_variables:缺少 tone(未提供值,也沒有預設值)」 |
| 同時指定版本與標籤 | 400 | prompt_invalid | 「請傳入 prompt_version 或 prompt_label,不可同時傳入」 |
| 不存在的 ID | 404 | prompt_not_found | 「prompt_id:此工作區中沒有提示詞 “support-answer-missing”」 |
| 版本 99 | 404 | prompt_not_found | 「提示詞 “support-answer” 沒有版本 99」 |
| 未指向任何版本的標籤 | 404 | prompt_not_found | 「提示詞 “support-answer” 的 “development” 標籤尚未指向任何版本」 |
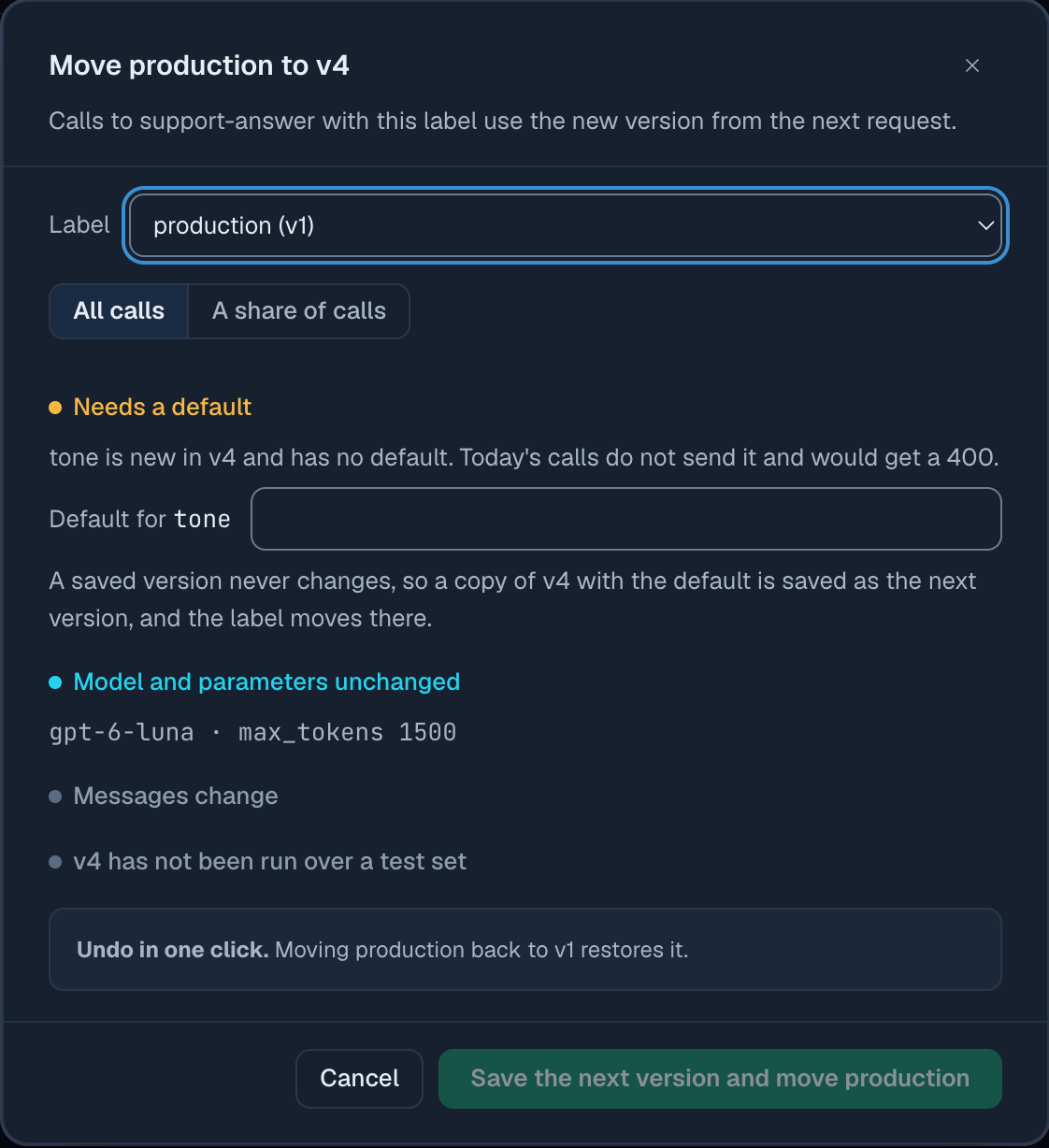
這五個呼叫都沒有計費紀錄。第一列就是會讓既有呼叫失敗的變更:v4 新增了沒有預設值的變數,所以凡是未傳入 tone 的呼叫都會失敗。控制台會在上線前攔下這個問題。將 production 移到 v4 時,會開啟對話框,檢查變更對目前呼叫端的影響,要求填入預設值,再將結果儲存為下一個版本。
如果提示詞庫暫時無法讀取,閘道會使用最後讀到的副本,最長可使用 24 小時,並在回應中加入 X-Synthorai-Prompt-Stale: 1。若某個提示詞沒有近期副本,則回傳 503 prompt_unavailable;此時請重試。示範中未觀察到這兩種情況。
除了文字,版本還能儲存什麼?
版本可儲存系統文字、訊息、模型、五個參數、輸出 schema,以及函式工具。參數以呼叫端設定為優先:只有請求未設定對應欄位時,才會套用版本中的 temperature、max_tokens、top_p、response_format 與 reasoning_effort。
policy-check 將 JSON schema 存在版本中,因此呼叫端不必傳入格式,也能取得符合 schema 的 JSON。透過 API 儲存時,版本在 params 指定格式,並在 schema 儲存結構:
version = {
    "model": "deepseek-v4.1-flash",
    "system": "You review messages to an online electronics shop's support desk. ...",
    "messages": [{"role": "user", "content": "{{customer_message}}"}],
    "params": {"max_tokens": 300, "response_format": "json_schema"},
    "schema": {"name": "policy_check", "strict": True, "schema": {
        "type": "object",
        "properties": {"topics": {"type": "array", "items": {"type": "string"}},
                       "risk": {"type": "string", "enum": ["low", "medium", "high"]}},
        "required": ["topics", "risk"], "additionalProperties": False}},
}
admin.post("/prompts/policy-check/versions", json={"body": version, "note": "v1: JSON check"}).raise_for_status()
儲存 schema 時若未設定 response_format: "json_schema",API 會回傳 400 拒絕請求,並在訊息中說明原因。使用 DeepSeek V4.1 Flash 呼叫一次 policy-check,回傳了 {"topics": ["shipping", "refunds"], "risk": "medium"},使用 151 個輸入 token 與 18 個輸出 token,費用為 $0.000033。該呼叫由呼叫端傳入 reasoning_effort: "none",因為示範版本儲存時,版本還不支援這個欄位。現在已能將它存入版本的 params:我們儲存了一個含有 reasoning_effort: "none" 的測試版本並展開,確認 Chat Completions 請求帶有 reasoning_effort,Responses 則帶有 reasoning.effort。Messages 會省略版本中的這個值,因為 Claude 模型使用不同格式的思考設定;呼叫這個端點時,請由呼叫端傳入。
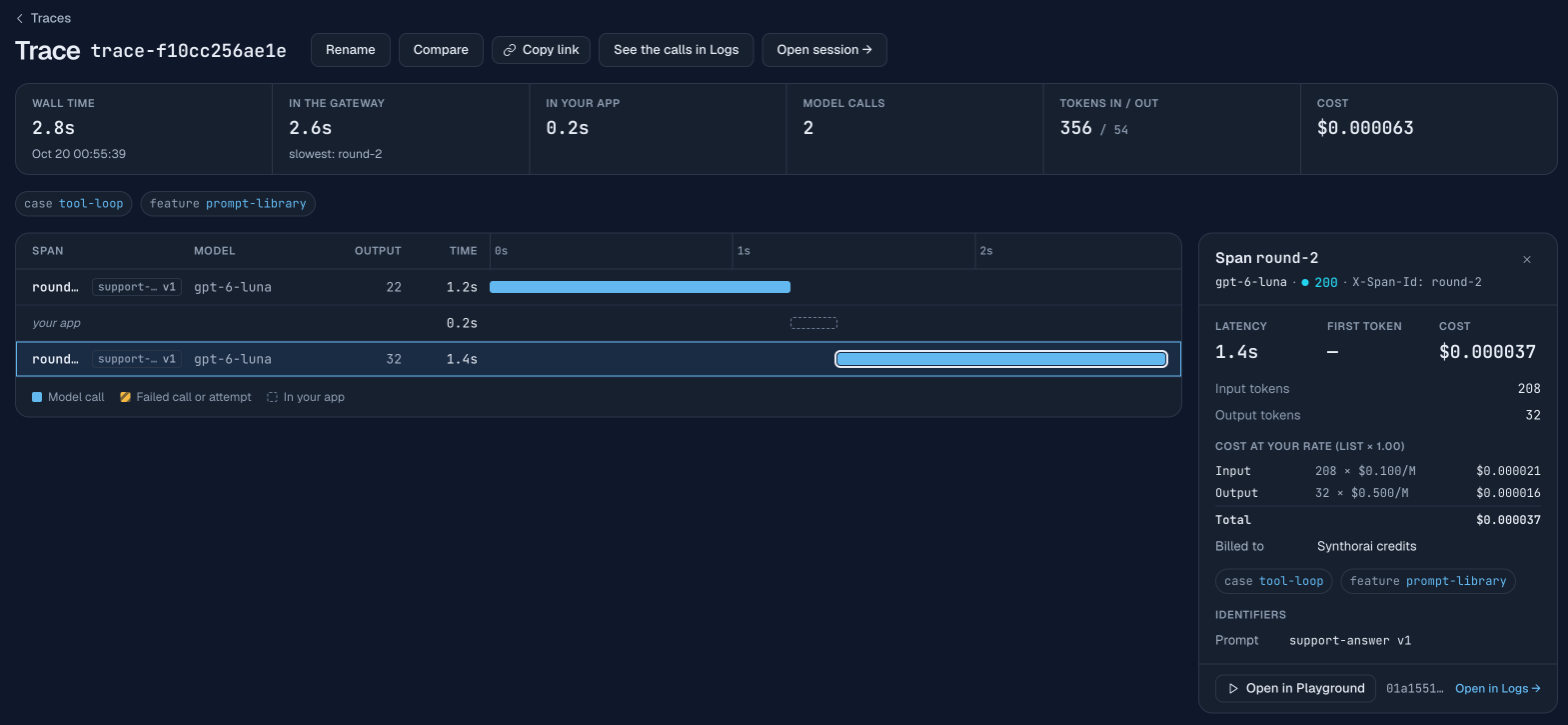
工具呼叫與多輪對話的運作方式,和不使用提示詞庫時相同。版本中的訊息放在前面,呼叫端傳入的對話接在後面。在示範的工具呼叫迴圈中,第 1 輪模型要求執行 lookup_order({"order_id": "A-50977"});第 2 輪以同一個 ID 呼叫,將模型的工具呼叫與工具結果當作一般訊息傳入,v1 便根據結果回覆。
在哪裡查看呼叫使用了哪個版本?
每個呼叫都會記錄提示詞與版本,可從三個地方查看:
- 回應中: 查看
X-Synthorai-Prompt-Version標頭,示範程式會把它寫在每個呼叫的結果旁。 - Logs 中: 使用
prompt = support-answer搭配prompt_version = 3篩選,即可列出該版本的呼叫;請求詳細資料也會列出提示詞與版本。GET /api/v1/requests接受相同的prompt_id與prompt_version篩選條件。 - 追蹤紀錄中: 瀑布圖中每個模型呼叫的列都有「prompt vN」標記,呼叫面板也會列出提示詞與版本。追蹤 LLM 代理程式中的追蹤標頭不必修改,即可用於以 ID 發出的呼叫。
提示詞頁面會按版本彙總 7、30 或 90 天內的呼叫次數、錯誤、費用、token 數與延遲。分批上線教學就是使用這個畫面,比較兩個版本在線上流量中的表現。
本文未涵蓋哪些內容?
- 分批上線與測試。 如何將部分正式流量導向候選版本,請見對提示詞變更進行 A/B 測試;如何使用固定輸入集測試版本,請見提示詞上線前測試。
- 共用片段。 一段文字只儲存一次,再透過
{{>id}}引入多個提示詞;每個儲存的版本都會固定使用當時引入的片段版本。 - 變更 webhook。 提示詞新增版本或標籤移動時,傳送帶有簽章的 POST,可用來將提示詞同步至 git 或聊天頻道。示範的
webhook.py能驗證簽章,但我們沒有收到實際推送。 - 建立操作的冪等性。
Idempotency-Key標頭可確保重試請求不會重複建立:24 小時內,API 遇到相同的 key 會回傳第一次的回應,不會建立兩次提示詞。即使提示詞已刪除也一樣,因此要重新建立已刪除的提示詞,請使用新的 key。
常見問題
什麼是提示詞版本管理?
提示詞版本管理,就是將每個提示詞存成有編號的版本,儲存後不再變更,再用標籤選擇正式環境使用的版本,不必修改程式碼。要回復舊版,只需將標籤指回前一個版本。
以 ID 呼叫提示詞,會增加延遲或 token 數嗎?
在我們的 20 組配對測試中,兩者都沒有增加:兩種方式的提示詞 token 數中位數都是 114.5,以 ID 呼叫也沒有比較慢。閘道會解析版本,再向供應商傳送一般請求。
提示詞變更多久會套用至正式環境?
約 10 秒內。實測持續有呼叫時,第一個由新版本回覆的呼叫,是在標籤移動後 8.0 到 8.5 s(中位數)送出;若流量已暫停 15 s,則立即使用新版本。
可以繼續使用 OpenAI 或 Anthropic SDK 嗎?
兩個 SDK 都不必修改:透過 extra_body 傳送提示詞欄位,並提供任意模型名稱與一則空白的使用者訊息,滿足 SDK 的必填參數要求即可。
延伸閱讀
- 提示詞庫指南:本文提到的所有欄位、錯誤與回應標頭。
- 控制台中的提示詞管理:編輯器、版本差異比較與移動標籤對話框。
- 對提示詞變更進行 A/B 測試:將版本推出至 10% 的流量,並比較各版本。
- 提示詞上線前測試:測試集、檢查項目,以及單次執行能判斷與無法判斷的事。
- 追蹤 LLM 代理程式:示範程式持續傳送的 session 與追蹤標頭。