
上線前測試提示詞:評估抓出 16% 的退步
精簡提示詞時刪去了一條規則,導致新版在 110 則新訊息中有 18 次漏寫訂單編號,漏寫率為 16%;舊版在同批訊息中則一次也沒漏。然而,先前單輪 40 筆測試卻未出現任何遺漏,顯示單次小樣本測試的零遺漏結果,未能反映新版在更多新訊息中的規則遵循問題。
我們的推薦
即時價格| 模型 | 結論 | 價格 |
|---|---|---|
| GPT-6 Luna support-answer 的 v1 在 275 次測試呼叫中,有 275 次提及訂單編號。採用較短系統提示詞的 v2,在事先確定的測試執行中,於 110 次呼叫中有 92 次提及訂單編號。 | 兩個受測版本使用的模型 | 低至 $0.1/百萬 |
| Claude Sonnet 5.5 以 PASS 或 FAIL 評定每個回答是否回應客戶的問題。六次測試執行的總費用為 $0.14,其中評審模型的呼叫費用占 $0.12。 | 示範中的評審模型 | 低至 $2/百萬 |
目錄
提示詞上線前,應先讓新版與現行版本處理同一批固定輸入,再依事先寫好的規則逐一檢查回答。我們用這個方式測試客服提示詞的 v2。這個版本縮短了 system 文字,卻也刪掉「一律寫出訂單編號」的規則。這正是測試要抓的退步:修改後,輸出反而變差。在先前測試都沒用過的 110 則訊息中,v2 有 18 則回答漏寫訂單編號(16%),v1 則一次也沒有。這個差異遠非隨機波動所能解釋(Fisher 精確檢定,p = 3.6 × 10⁻⁶)。但先前有一輪 40 則訊息的測試完全沒漏,所以只通過一輪測試,不代表版本就能過關。
TL;DR
- 在執行前就固定好的測試中,support-answer 的 v2 在 110 則回答中有 18 則漏寫訂單編號,v1 則是 0 則(p = 3.6 × 10⁻⁶)。
- 先前三輪各 40 筆的測試,有一輪 v2 全數通過;最後三組測試中,也有一組若單獨使用,就抓不到這個問題。
- 示範腳本對 v1 發出的 275 次測試呼叫,每次回答都有寫出訂單編號。
- 六輪各 15 到 20 筆的測試花了 $0.14,其中 $0.12 用於評審模型。
本文接續提示詞版本管理,沿用其中建立的 support-answer 與各個版本。v1 和 v2 都使用 GPT-6 Luna,唯一差別是 system 文字。在 github.com/synthorai-io/use-cases 的同一個目錄中執行:
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
本文的測試都在 2026 年 10 月 19 日執行,評審模型使用 Claude Sonnet 5.5,並非受測版本所用的模型。
提示詞測試包含什麼?
測試集由一份輸入資料表和一組檢查規則組成。每筆資料提供提示詞變數的值,也可以附上使用者訊息與預期回答。執行測試時,每筆資料都會呼叫候選版本與基準版本,再用每項規則檢查各個回答。可用的檢查類型如下:
| 檢查 | 回答符合以下條件即通過 |
|---|---|
contains / not_contains | 包含或不包含指定字串 |
regex / not_regex | 符合或不符合指定模式(Go 的 RE2 語法) |
equals_expected | 與該筆資料的預期回答相同 |
json / schema | 是有效的 JSON/符合該版本的輸出 schema |
max_latency_ms / max_cost_usd | 回應時間與費用未超過上限 |
judge | 模型依照你寫的評分準則判定為 PASS |
每個測試集最多容納 50 筆資料,每項檢查都會套用到該測試集的所有資料。拆分測試集時必須考慮這點。「回答包含訂單編號」只適用於原本就提供編號的訊息,因此示範將這類訊息獨立成組:
| 測試集 | 資料內容 | 檢查 |
|---|---|---|
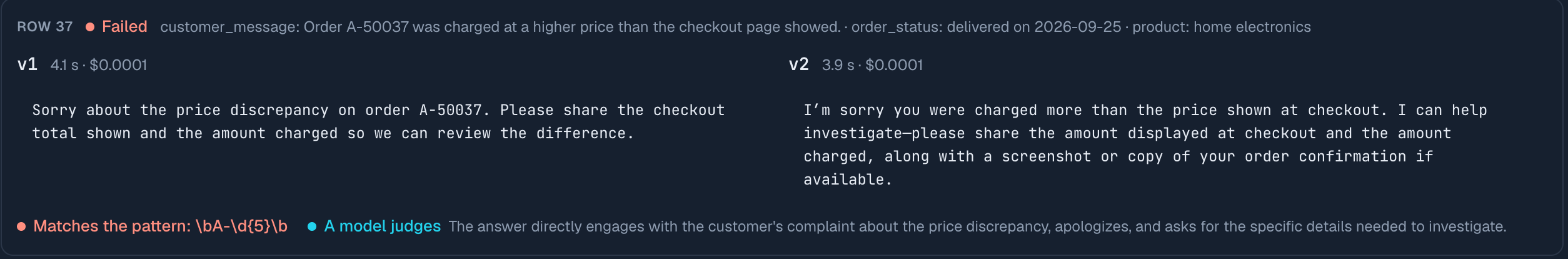
| orders(先用 15 筆,後來改用 40 筆) | 每則訊息都提供訂單編號,主題涵蓋配送、退貨、品項錯誤或損壞,以及帳務 | 包含訂單編號(regex \bA-\d{5}\b);模型評分:有回答客戶的問題 |
| fresh orders 1 到 3 | 另外 110 則同類訊息,未出現在其他測試集中,分成 40、35、35 筆 | 同上兩項 |
| general(20 筆) | 不含訂單編號的訊息,其中多則詢問退款時間 | not_contains「refund by」與「business days」;延遲低於 20 秒;模型評分:有回答問題;模型評分:未承諾退款日期 |
每項評審檢查都會針對每個回答呼叫一次模型,取得 PASS 或 FAIL。這會產生費用,也可能判錯,因此示範只用它檢查無法透過模式比對表達的條件,並將結果與模式檢查分開呈現。
如何透過程式或 CI 執行提示詞測試?
CI(持續整合,也就是每次變更合併前執行的檢查)可以透過 API 執行提示詞測試。測試本身由你的程式負責:建立測試執行紀錄,對每筆資料透過 prompt_version 呼叫兩個版本、評分,再將結果寫回紀錄。控制台便會像顯示其他測試一樣顯示這次執行。以下是示範程式的精簡迴圈:
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version 會依 ID 呼叫提示詞,並設定 prompt_version,做法與提示詞版本管理相同。judge 則會呼叫評審模型,要求回傳 PASS 或 FAIL。發布期間,source: eval 標籤很重要:Prompts 頁面的各版本統計會排除帶有這個標籤的呼叫,避免測試干擾正式流量的比較。
示範程式用 Python 執行模式檢查。若要與控制台的評分方式完全一致,可將檢查條件和回答送到 POST /api/v1/prompt-checks/grade。伺服器會使用 RE2 執行 contains、not_contains、regex、not_regex、equals_expected 和 json,並回傳每個回答在各項檢查中的通過或失敗結果。我們簡單測了一下:用 (?i)refund 比對「REFUND by Friday」會通過;對同一個回答使用 not_regex (?i)refund.{0,40}\bby\b 則會失敗,結果符合預期。
控制台的 Run 按鈕也採用相同方式,由瀏覽器逐筆呼叫兩個版本並儲存結果。針對 40 筆 orders 測試集的一次控制台執行(下方的第 10 輪),只評分候選版本,旁邊則顯示 v1 的回答,但不做檢查。
測試有抓到退步嗎?
有。我們在執行前就固定好測試設計:使用先前測試都沒用過的 110 則新訊息,每筆資料對每個版本各呼叫一次;針對全部 110 筆的訂單編號檢查結果,只做一次 Fisher 精確檢定,顯著水準設為 0.05。假設兩個版本的行為實際上相同,Fisher 精確檢定會計算出現至少這麼大差異的機率;雙尾檢定表示兩個方向的差異都會納入。我們在第一次呼叫前,就把資料和這項規則提交到儲存庫。結果如下:
| 測試集 | v2 寫出訂單編號 | v1 寫出訂單編號 | 僅針對該組的 Fisher p 值 |
|---|---|---|---|
| fresh orders 1(40 筆) | 33/40 | 40/40 | 0.012 |
| fresh orders 2(35 筆) | 27/35 | 35/35 | 0.005 |
| fresh orders 3(35 筆) | 32/35 | 35/35 | 0.239 |
| 全部 110 筆 | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
v2 有 16% 的回答漏寫訂單編號。遺漏分布在各種主題,並非集中於某一類訊息:配送、退貨、品項錯誤、品項損壞各有 22 則,其中各漏了 4 則;帳務則是 22 則中漏了 2 則。典型例子是這則訊息:「訂單 A-50918 在我的銀行 App 裡顯示兩筆待處理扣款。」回答解釋,這兩筆可能只是預授權,而非重複扣款。評審模型判定通過,但回答從頭到尾都沒提到訂單編號。
各組的 p 值只是描述那三組資料,並不是事先指定的檢定。三組之中有兩組單獨就能指出 v2 有問題,第三組則不行。
為什麼通過一輪測試仍可能漏掉退步?
如果某個版本只是偶爾違反規則,整輪測試就可能一次都沒碰到。在上述測試之前,示範程式曾用同一組 40 筆資料,對 v2 與 v1 測了三輪:
| 輪次 | v2 寫出訂單編號 | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10(控制台) | 39/40 | 40/40,由示範程式對已儲存的回答評分 |
第 9 輪中,v2 的 40 筆全部通過。如果團隊只測一次,剛好得到這輪結果,就會把 v2 上線。而且這幾輪單獨來看,都沒有達到統計顯著:當基準版本一次都沒漏時,一輪 40 筆或更多資料的測試至少要漏 6 次,p 值才會低於 0.05(40 筆中通過 34 筆時,p = 0.026;通過 35 筆時則是 0.055)。較小的測試集所需次數較少:20 筆中漏 5 次,p 值就已達 0.047。
因此,決定測試資料量時,要讓「至少漏 6 次」有足夠高的機率發生,而不只是期望值達到 6 次。在遺漏率為 16% 時,48 筆資料有 80% 的機率至少漏 6 次;38 筆雖然預期會漏 6 次,實際達到至少 6 次的機率卻只有 58%。若遺漏率是 6.25%,也就是上述 40 筆測試集的觀察值(160 則回答中漏了 10 則),要達到 80% 的機率就需要 126 筆。對重要規則,應使用超過單一測試集容量的資料,拆成多組,並事先決定如何合併分析。重跑相同資料,無法像新增資料一樣增加證據:各輪反覆測的是同一批訊息,不是獨立樣本。示範中就有三筆資料,v2 在一輪漏寫,另一輪也同樣漏寫。
縮短提示詞還破壞了其他行為嗎?
其他檢查沒有發現別的問題。general 測試集各跑三輪,結果如下:
- 不承諾退款日期: 兩個版本都未曾寫出「refund by」或「business days」。模型評分的檢查中,每個版本每輪 20 則回答最多有 2 則失敗,版本之間沒有差異。
- 延遲: v1 有一輪的 2 筆資料超過 20 秒,v2 則從未超過。
- 有回答問題(模型評分): v2 在每個測試集的評分都較高;新資料集中,v2 為 110 則中的 88 則,v1 則為 75 則。我們沒有事先指定這項比較,因此只能視為趨勢:依評審模型的判斷,較短的提示詞回答得更直接。
控制台與示範程式的評審模型使用不同提示詞(控制台會要求寫出理由)。針對同樣的 40 則訊息,但使用不同輪次產生的回答,控制台判定 v2 通過 40 則,示範程式的評審模型則判定通過 32 到 35 則。評審結果只應在同一套評分器內比較。
提示詞測試要花多少錢?
使用本示範的模型,測試兩個版本並加上一項模型評分,每筆資料約花十分之一美分:
| 測試輪次 | 每輪筆數 | 呼叫內容 | 費用 |
|---|---|---|---|
| 15 筆與 20 筆測試集共 6 輪 | 15 或 20 | 回答加上評審 | $0.1400,其中 $0.1198 為評審呼叫 |
| 40 筆測試集共 3 輪 | 40 | 240 次回答 + 240 次評審 | $0.115 |
| 事先固定的測試 | 110 | 220 次回答 + 220 次評審 | $0.1076 |
評審占了大部分費用,因為每個回答都要另外呼叫一次較大的模型。依序發送呼叫時,一輪 40 筆的測試耗時 10 分鐘;平行呼叫可以縮短時間,但會占用更多速率限制額度。
測試結果如何協助決定是否上線?
在控制台移動 production 標籤時,對話框會在變更旁顯示該版本最近一次的測試結果,供你判斷,但不會阻止移動。測試集與各輪回答都以加密方式儲存,回答保留 30 天。
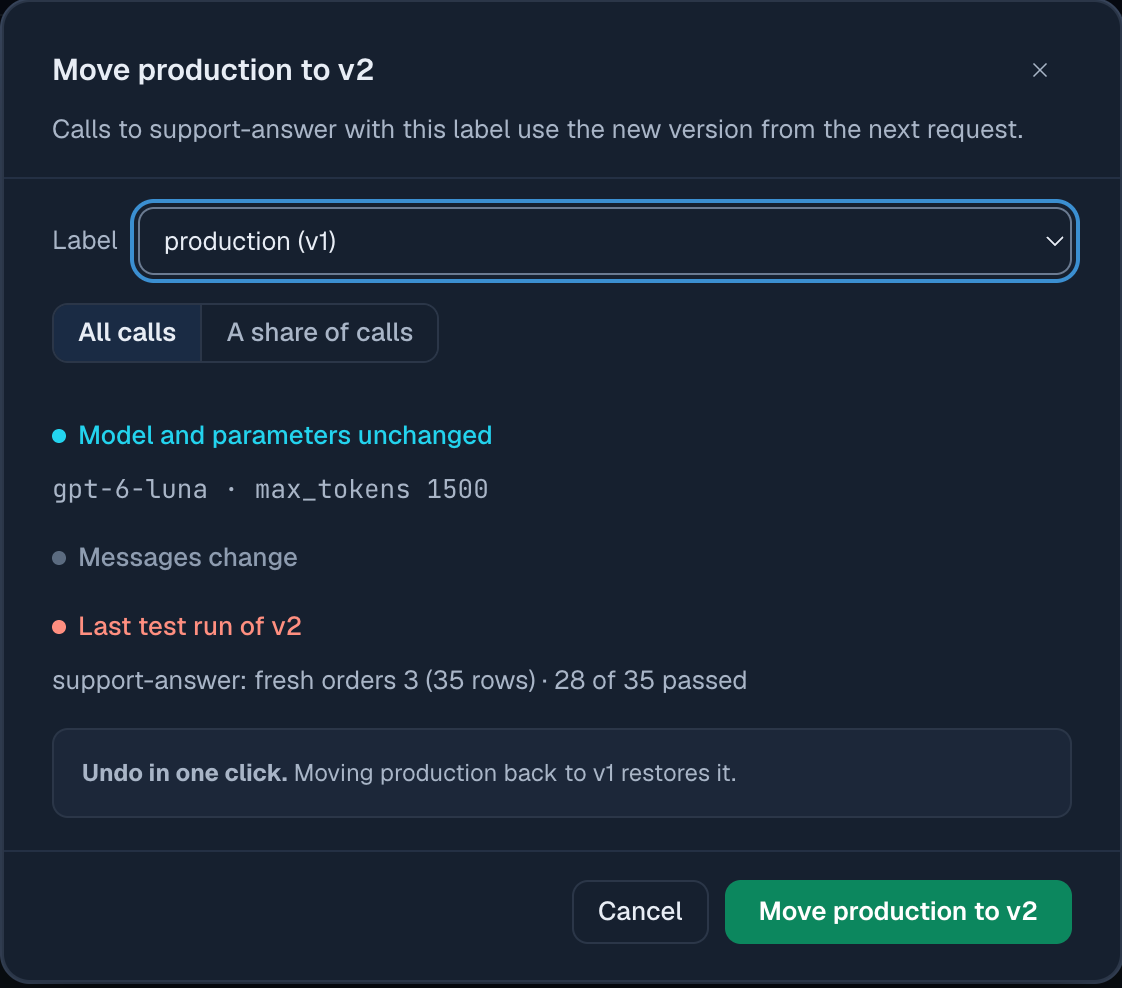
對話框只會在一筆資料通過該測試集的所有檢查時,才將它算作通過。因此,畫面中的 35 筆通過 28 筆,是合併模式檢查與評審結果後的數字。
還有哪些未涵蓋的部分?
- 逐筆設定檢查。 每項檢查都會套用到整個測試集,因此示範將有訂單編號與沒有訂單編號的訊息分成不同測試集。
- 由伺服器執行測試。 無論使用 API 還是控制台的 Run 按鈕,模型呼叫都由呼叫端發出;目前沒有能在伺服器上執行完整測試並等待結果的端點。
- 評審準確度。 我們沒有用人工評分驗證評審模型,因此它的數字只能用來觀察趨勢,本文也只針對模式檢查提出明確結論。
常見問題
部署 LLM 提示詞前,該怎麼測試?
讓新版與現行版本處理同一批固定輸入,依書面規則逐一檢查回答,再用事先決定的顯著性檢定比較通過筆數。示範中,110 則新訊息加上一次 Fisher 精確檢定,就能區分 16% 與 0% 的遺漏率。
提示詞迴歸測試需要多少測試案例?
資料量要足以讓真有退步時,至少 6 次違規有很高的機率出現。若要達到 80% 的機率,失敗率為 16% 時需要 48 筆,6.25% 時則需要 126 筆。示範中有一輪 40 筆測試全數通過,但同一版本在主要測試中有 16% 的回答違反規則。
LLM 評審可以取代模式檢查嗎?
能用模式表達的條件,不應改由評審模型取代。示範中,控制台與腳本使用不同的評審提示詞,對相同的 40 則訊息,分別判定 v2 通過 40 則及 32 到 35 則;模式檢查則每次都會對相同文字給出相同結果。
延伸閱讀
- 提示詞版本管理:依 ID 呼叫提示詞,以及移動標籤。
- 提示詞變更的 A/B 測試:版本在正式流量中的費用。
- 提示詞庫指南:測試集、檢查與評估執行紀錄。
- 控制台中的提示詞:測試編輯器與標籤移動對話框。