
LLM 代理為什麼這麼貴?從追蹤記錄找出四個原因
逐一重現並修正 AI 代理帳單偏高的四個原因:破壞快取的時間戳記、持續膨脹的上下文、重試迴圈,以及選錯模型。其中,時間戳記問題修正後,快取命中率從 0% 提升到 73%。其餘案例則分別檢查上下文增長、反覆重試與模型選擇,對照各項問題的重現及修正結果。
我們的推薦
即時價格| 模型 | 結論 | 價格 |
|---|---|---|
| GPT-6 Luna 將時間戳記移出提示的第一行後,冷啟動時四輪互動中的 5,729 個輸入 token 有 4,157 個從快取讀取。時間戳記放在第一行時,5,579 個輸入 token 全部未從快取讀取。 | 示範中的主要代理 | 低至 $0.1/百萬 |
| DeepSeek V4.1 Flash 三項各一句的檢查在 GPT-6.1 Sol 上花費 $0.0010,在此模型上花費 $0.0001。 | 示範中的子代理 | 低至 $0.3/百萬 |
目錄
代理的費用上升,原因往往藏在單次請求看不到的地方:提示詞從未命中快取、對話每一輪都重送更多內容、迴圈反覆做同樣的工作,或是讓昂貴模型處理便宜模型就能完成的任務。把呼叫依工作階段與追蹤記錄分組後,這些問題就會清楚浮現。本文用一個小型客服代理重現這四種情況,指出它們在 Synthorai 控制台的哪裡出現,逐一修正,並比較修正前後的費用。
TL;DR
- 提示詞第一行的時間戳記讓快取命中率一直停在 0%。移到結尾後,命中率提高到 73%,GPT-6 Luna 的輸入費用降低 66%。
- 每輪都重送所有工具結果的對話歷史,用了三倍的輸入權杖,但輸入費用只多 21%,因為 71% 的輸入來自快取。
- 重試迴圈把只需 2 次的模型呼叫增加到 10 次,而且狀態碼全是 200。
- GPT-6.1 Sol 上的三次子代理呼叫,占了某個工作階段費用的 81%。
本文延續追蹤 LLM 代理的設定。該文說明如何用請求標頭將呼叫歸入工作階段與追蹤記錄。請先依照該文設定範例環境(Python 3.10 以上版本,並啟用 virtualenv),再從 github.com/synthorai-io/use-cases 的同一個目錄執行四個案例,以及另一種導致快取失效的案例 replay-mismatch:
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
每個案例都會執行兩次,先跑有問題的版本,再跑修正版,並以 case 和 variant 標記呼叫。以下數字取自 2026 年 10 月 11 日各案例的一次執行。範例規模很小,費用都不到一美分;真正能用來推估實際工作負載的是比例。
| 案例 | 觀察位置 | 修正前 | 修正後 |
|---|---|---|---|
cache-miss | 工作階段頁面上每輪的快取命中率 | 0% 來自快取,$0.0015 | 冷啟動(快取尚無資料)時 73% 來自快取,$0.0011 |
context-growth | 工作階段頁面上逐輪增加的輸入量 | 24,546 個輸入權杖,輸入費用 $0.0011 | 8,053 個輸入權杖,輸入費用 $0.0009 |
replay-mismatch | 工作階段頁面上始終為 0% 的快取命中率 | 0% 來自快取,$0.0038 | 76% 來自快取,$0.0015 |
retry-loop | 單筆追蹤記錄的呼叫次數遠超過一輪所需 | 10 次呼叫,$0.0004 | 2 次呼叫,$0.0001 |
wrong-model | 工作階段頁面的代理表格 | $0.0012 | $0.0003 |
費用比預期高,該從哪裡查起?
先開啟 Traces 清單,依費用排序。每一列都是一個工作階段或一筆追蹤記錄,列出呼叫次數、耗時與費用,最貴的對話會排在最上面。打開其中一筆,就能確認它是否有下列問題。
如果你用 X-Synthorai-Metadata 標記請求,先縮小清單範圍。Traces 清單的搜尋框支援標籤查詢:metadata.feature = support-agent 只保留某個功能的工作階段與追蹤記錄,metadata.case = cache-miss 則能找出本文該案例的兩次執行。要看彙總數字,可到 Analytics 的 Breakdown 分頁,使用 Cost by metadata 卡片。選擇一個鍵,就會列出每個值的請求數、輸入權杖數與費用。
快取命中率為什麼是零?
提示詞開頭附近的內容若每次請求都改變,快取命中率就會是零。提示詞快取讓供應商以較低的輸入價格,計費重複出現的提示詞開頭,但快取只涵蓋到第一個與前次請求不同的權杖為止。這個案例的問題版本把目前時間放在約 1,300 個權杖的系統提示詞第一行:
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
在 GPT-6 Luna 上進行四輪對話後,工作階段頁面顯示 Cache hit 為 0%,5,579 個輸入權杖中沒有任何一個來自快取。修正方式是把會變動的部分移到結尾:
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"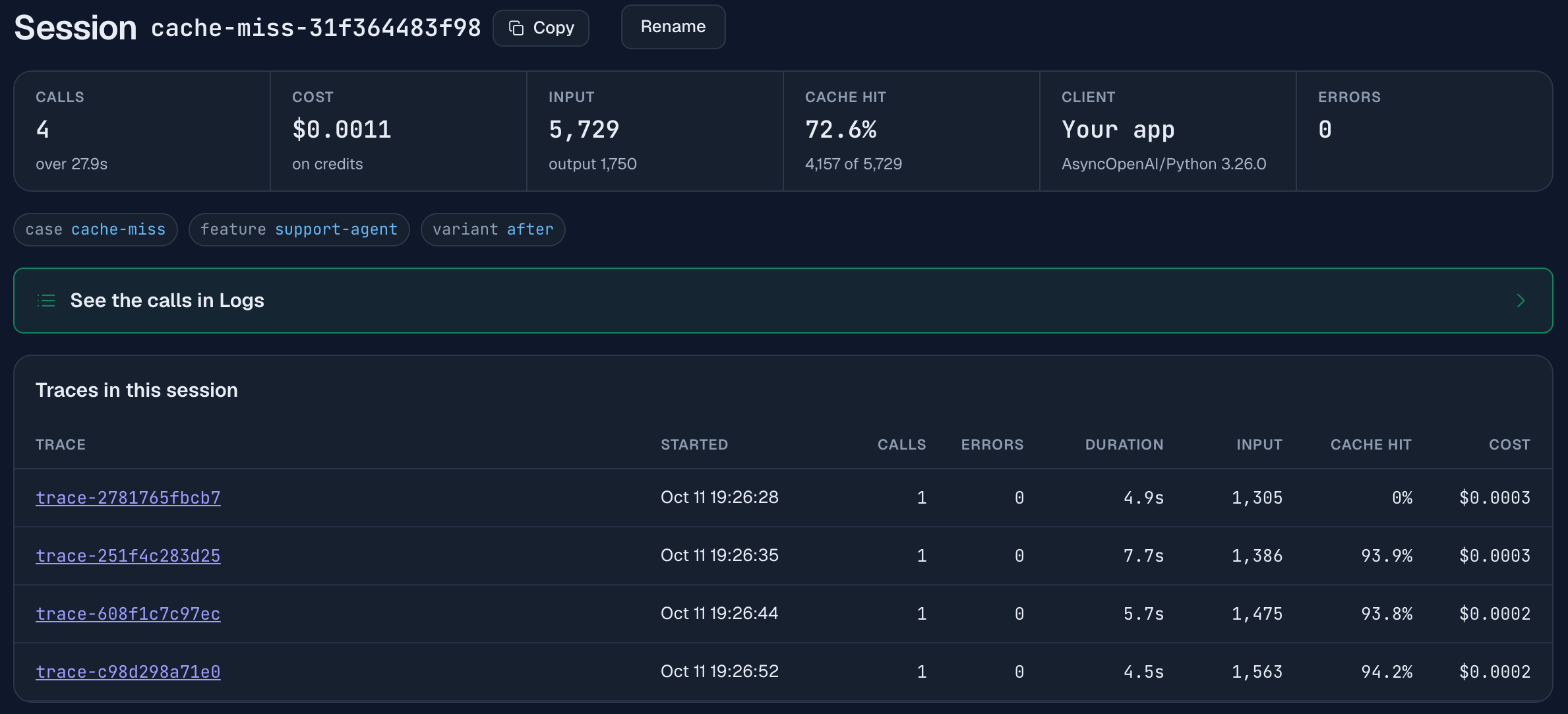
工作階段頁面逐輪列出輸入量與快取命中率,第一列是 0%。第一輪對話無法讀取尚未由任何請求寫入的快取項目,因此只會寫入,不會讀取。接下來三輪分別從快取讀取 1,302、1,383 與 1,472 個權杖,幾乎涵蓋前一輪送出的全部內容,因此每輪約有 94% 的輸入來自快取。整段對話合計是 5,729 個輸入權杖中的 4,157 個,也就是 73%。
省下的是輸入費用。這個模型每百萬個輸入權杖收費 $0.10,寫入快取的權杖收費 $0.125,讀取快取的權杖收費 $0.01。長提示詞的權杖幾乎都會落在快取寫入或讀取這兩類。
問題版本寫入了 5,567 個權杖,沒有讀取任何快取。修正版寫入 1,560 個、讀取 4,157 個,因此輸入費用從 $0.00070 降到 $0.00024,減少 66%。工作階段總費用則從 $0.0015 降到 $0.0011,降幅比單看輸入費用小,因為這次帳單主要是輸出費用,而且修正版剛好多產生了一些輸出(1,750 個權杖,原本是 1,599 個)。
能省多少,取決於對話開始時快取裡已有什麼。這次是冷啟動,第一輪完全沒有讀取快取。流量穩定的代理應該能超過 73%,因為每段對話都以相同的系統提示詞開頭;只要請求持續在快取到期前到達,上一段對話留下的項目就還在。如果某個提示詞只會出現在一段對話中,第一輪就得支付快取寫入費用。
時間戳記是最典型的原因。請求 ID、隨機問候語、插入第一段的使用者名稱,或順序不同的工具定義,都會造成同樣的問題。快取命中還需要滿足兩個條件:穩定前綴(提示詞開頭不變的部分)必須超過供應商規定的最小長度(多數為 1,024 個權杖,請參閱提示詞快取),而且同一段對話的呼叫應帶上相同的 X-Session-Id,讓閘道能維持該對話的快取命中一致性。
為什麼每一輪送出的內容都比上一輪多?
因為對話每輪都會重送歷史內容。歷史越來越長,輸入量略增很正常。這個案例的問題版本增加得更快:每輪都查詢客戶資料,取得約 1,100 個權杖的 JSON 訂單紀錄,並把查詢結果留在歷史中。因此到了第六輪,提示詞裡已經有六份幾乎相同的資料。
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]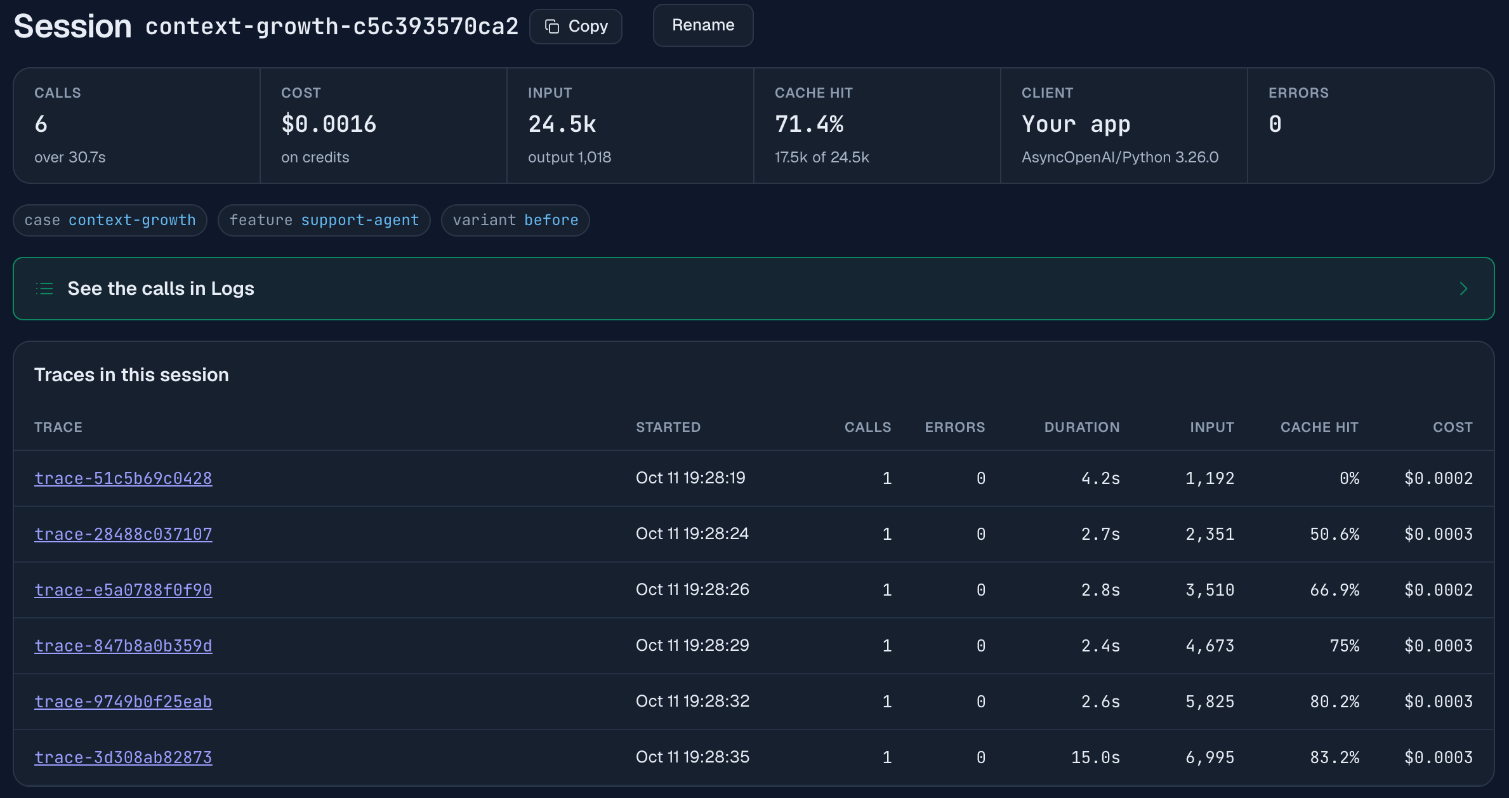
徵兆就在「Traces in this session」表格的 Input 欄位:每輪增加約 1,160 個權杖,從第一輪的 1,192 個增至第六輪的 6,995 個,但回覆始終只有兩句話。六輪共用了 24,546 個輸入權杖。修正版仍會提供當輪最新的查詢結果,但不再保留舊查詢,因為助理回覆已經記下重要資訊。這樣六輪只需 8,053 個輸入權杖,約為原本的三分之一。
Input 旁邊的兩個欄位,說明了這個問題為什麼不容易被發現。Cache hit 隨輸入量增加,每輪費用卻維持在 $0.0002 到 $0.0003。每輪都以完整的前一輪提示詞開頭,因此供應商會從快取讀取這部分:24,546 個輸入權杖中有 17,536 個,也就是 71%。問題版本的輸入費用是 $0.0011,修正版則是 $0.0009:輸入權杖是三倍,输入費用卻只多 21%。
這組比較的工作階段總費用,完全看不出修正效果。問題版本費用為 $0.0016,修正版為 $0.0017,因為修正版剛好多產生了一些輸出(1,756 個權杖,原本是 1,018 個)。額外輸出增加約 $0.0004,比輸入省下的 $0.0002 還多。應該比較修正實際影響的 Input 與 Cache hit 欄位,而不是單看某個工作階段的總費用。
提示詞快取能抵銷歷史持續增長所帶來的大部分費用,但它做不到三件事:
- 它不會縮小上下文。第六輪仍然送出 6,995 個權杖。長工作階段一樣會碰到模型的上下文長度限制,快取權杖也仍按快取費率計費。
- 只有完全依照原樣重送歷史,快取才有效。範例中的
replay-mismatch就是這種情況:每則使用者訊息送出時都會附加一段指令,儲存時卻沒有保存那段指令。因此每輪重建的提示詞,前一輪都不曾送過。這段對話的 24,557 個輸入權杖中,沒有任何一個來自快取,費用為 $0.0038。改成儲存實際送出的訊息後,24,702 個權杖中有 18,844 個來自快取,也就是 76%,費用降為 $0.0015。 - 不是每個模型都有快取。以本案例使用的 GPT-6 Luna 完整輸入價格計算,24,546 個權杖要 $0.0025,使用快取後實際收費約為 $0.0011。依賴快取之前,先確認 Cache hit 欄位。
對自己的代理來說,工具結果通常是歷史中最大、也最不值得重送的內容。保留使用這些結果寫出的回覆,或一行摘要,並移除原始資料。這樣無論模型有沒有快取,都能省下費用。聊天機器人指南說明了更通用的做法:把舊對話輪次壓縮成摘要。
重試迴圈看起來是什麼樣子?
同一筆追蹤記錄中的呼叫次數遠超過一輪應有的數量,而且 span 名稱反覆出現。在這個案例中,物流業者的追蹤 API 無法使用。代理呼叫工具後收到逾時,接著回覆無法查到包裹位置。程式再檢查回覆是否提到包裹所在地,發現沒有,就重新執行整輪,最多執行五次:
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused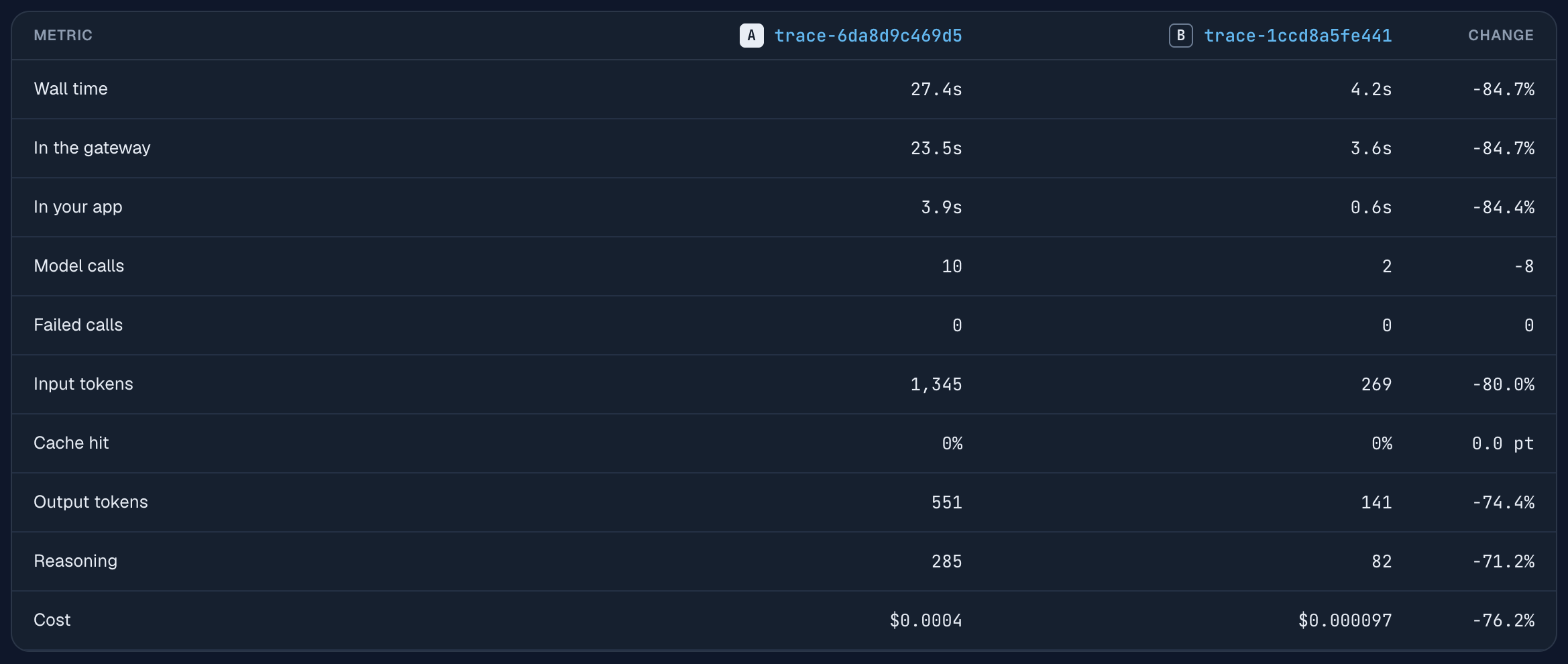
這是兩次執行的 Compare 檢視:打開一筆追蹤記錄,選擇 Compare,再選另一筆。問題版本花了 27.4 s,呼叫模型 10 次,費用為 $0.0004,但客戶最後得到的仍是同樣的答案。兩邊的「Failed calls」都是 0。迴圈中的每次呼叫都成功回傳狀態碼 200,因此這裡沒有任何錯誤紀錄。修正版會區分工具故障與回覆不合要求;如果問題出在工具,就不重試:2 次呼叫、4.2 s、$0.0001。
問題版本的瀑布圖中,呼叫依序命名為 plan-1、answer-1、plan-2、answer-2 等。像這樣用步驟與嘗試次數命名 span,就能一眼看出迴圈。要找出尚未察覺的迴圈,可將 Traces 清單依呼叫次數排序。
怎麼找出正在做簡單工作的昂貴模型?
查看「Agents in this session」表格,它會依代理拆分工作階段的呼叫次數與費用。這個案例的問題版本讓子代理在 GPT-6.1 Sol 上執行三次只需一句話的檢查。該模型每百萬個輸入權杖收費 $2,每百萬個輸出權杖收費 $10;主代理則用 GPT-6 Luna 回答:
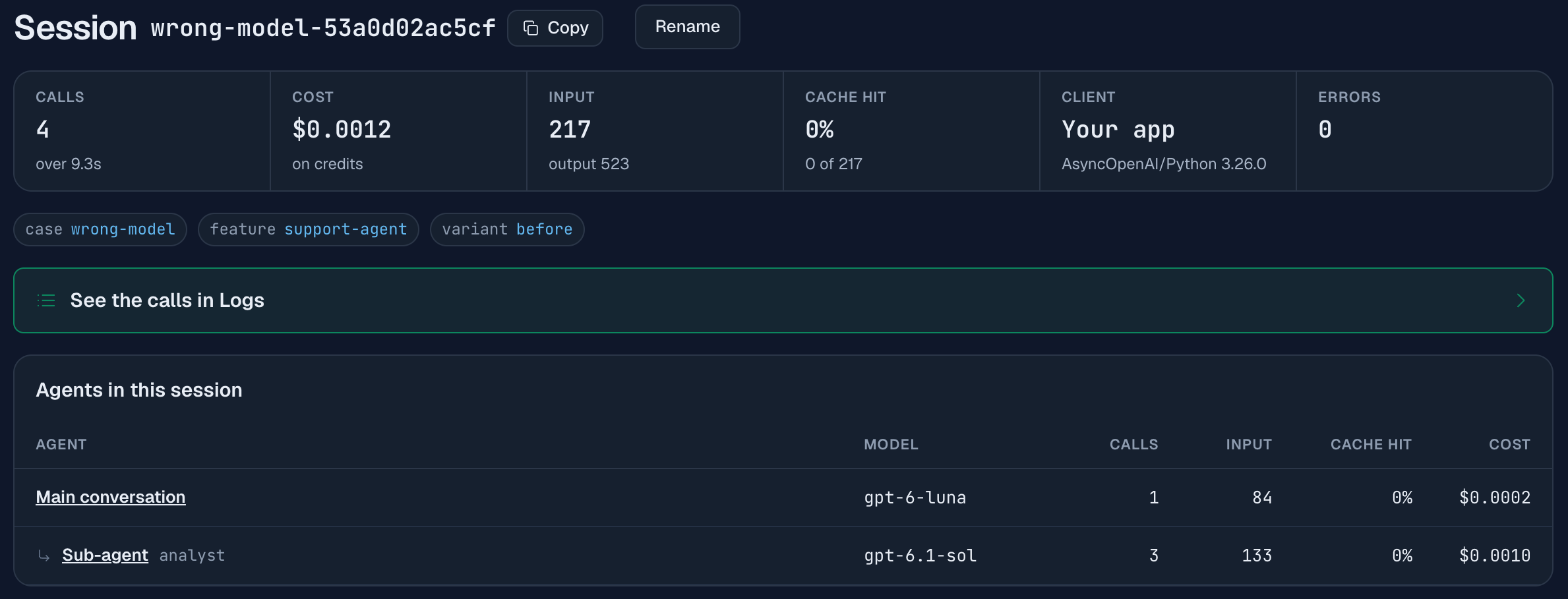
子代理三次呼叫的費用為 $0.0010,工作階段總費用為 $0.0012。整次執行中最簡單的工作,卻占了帳單的 81%。改用 DeepSeek V4.1 Flash 執行相同的三次檢查,費用為 $0.0001,工作階段總費用為 $0.0003。兩個版本執行檢查時都關閉 reasoning,因此差異來自模型價格。
這個案例只衡量費用。我們沒有評分檢查結果;只有在答案品質足以完成該步驟時,便宜模型才是合適的選擇。表格告訴你錢花在哪裡,讓你知道哪個步驟值得換便宜模型測試。
子代理呼叫帶上 X-Agent-Id 後,就會出現這種拆分。沒有這個標頭時,「Models in this session」表格會依模型拆分;只有每個代理都使用自己的模型時,兩種拆分才相同。如果要查看某個代理跨所有工作階段的費用,可到 Analytics 的 Breakdown 分頁使用 Cost by agent 卡片。
常見問題
怎麼知道 LLM 代理哪個部分最花錢?
用請求標頭將呼叫歸入工作階段與追蹤記錄,再把 Traces 清單依費用排序,打開最上面的一筆。工作階段頁面會依代理、模型與對話輪次拆分費用,足以分辨是快取問題、上下文問題,還是模型選擇問題。
為什麼提示詞快取命中率是 0%?
最常見的原因是提示詞開頭附近有會變動的值,例如時間戳記。快取只涵蓋到第一個不同的權杖為止。在範例中,把時間戳記從系統提示詞第一行移到使用者訊息結尾,冷啟動時的快取命中率就從 0% 提升到 73%。
為什麼對話第一輪沒有命中快取?
快取項目是由請求寫入的,而第一輪正是負責寫入的那次請求,所以無法命中。範例中,四輪對話分別有 0%、93.9%、93.8% 與 94.2% 的輸入來自快取。只有先前的對話近期送過相同前綴,而且快取項目仍未到期,第一輪才能讀取快取。
提示詞快取能讓很長的對話歷史免費嗎?
不能,但它能掩蓋大部分費用。範例中,每輪重送所有舊工具結果的對話,輸入權杖是精簡版的三倍(24,546 對 8,053),輸入費用卻只多 21%,因為 71% 的輸入來自快取。這些權杖仍然占用上下文視窗,而重送的歷史一旦與當初送出的內容不同,折扣就會消失:範例的 replay-mismatch 案例因為儲存的訊息與實際送出的不同,讓整段對話的快取比例降為 0%,費用增加到兩倍以上。
提示詞快取能省多少?
取決於模型的快取輸入價格,以及輸入占整張帳單的比例。在 GPT-6 Luna 的範例中,整段對話有 73% 的輸入來自快取,讓輸入費用降低 66%;工作階段費用為 $0.0011,沒有快取時則為 $0.0015。這張帳單大部分是輸出權杖費用,而快取不會影響輸出。
重試迴圈會顯示為錯誤嗎?
不一定。範例中,迴圈的每次呼叫都回傳狀態碼 200。問題呈現在同一筆追蹤記錄裡:原本只需 2 次呼叫,卻執行了 10 次。因此除了錯誤率,也要看每筆追蹤記錄的呼叫次數。
延伸閱讀
- 追蹤 LLM 代理:本文使用的標頭、工作階段與標籤。
- LLM 代理為什麼這麼慢?:用相同方法分析延遲。
- 除錯 LLM 代理:從使用者反映的問題,找到出錯的呼叫。
- 依子代理分析 Claude Code 費用:將相同的工作階段檢視用於程式開發代理,其中快取寫入占一次執行費用的 77%。
- 用 Claude 查詢 LLM 日誌:透過 MCP 找出這些工作階段中最昂貴的一個。
- 讓代理使用日誌工具:用自己的程式讀取相同日誌,以及模型權杖的費用。
- 提示詞快取:各供應商的最小前綴長度與價格。
- 依使用情境挑選最合適的 LLM:依工作負載型態分析費用,協助選擇每個步驟的模型。