
LLM 代理為什麼這麼慢?用追蹤找出 3 個原因
逐一重現並修正 AI 代理執行緩慢的三個原因:循序呼叫模型、自己撰寫的程式碼中有慢速工具,以及對只需一行的回答啟用推理。模型呼叫修正後,耗時從 3.7 秒降至 1.8 秒,減少 1.9 秒;另兩項則分別處理工具執行過慢與簡短回答不必要的推理。
我們的推薦
即時價格| 模型 | 結論 | 價格 |
|---|---|---|
| GPT-6 Luna 5 次單句回答在預設推理強度下的耗時中位數為 25.6 s,將 reasoning_effort 設為 none 時則為 10.2 s,輸出 token 數從 1,150 降至 190。 | 示範中的主要代理 | 低至 $0.1/百萬 |
| DeepSeek V4.1 Flash 3 次單句檢查使用相同的 127 個輸入 token,依序送出時的耗時中位數為 3.7 s,一起送出時則為 1.8 s。 | 示範中的子代理 | 低至 $0.3/百萬 |
目錄
代理變慢,通常有三種原因:模型呼叫本來不必互相等待,卻被排成循序執行;兩次呼叫之間,自身的程式碼跑得太慢;或是某次模型呼叫做了超出該步驟需求的工作。追蹤會把每次呼叫畫在時間軸上,也會顯示呼叫之間的空檔,幾秒內就能看出是哪一種。本文用一個小型客服代理重現這三種問題,再逐一修正,並在 Synthorai 主控台中並排比較修正前後的執行結果。
TL;DR
- 用
asyncio.gather同時送出三個互不相依的模型呼叫,中位數耗時從 3.7 s 降到 1.8 s,成本不變。 - 同時執行四次模擬的 1.1 s 資料庫查詢,代理自身程式碼的耗時從 4.6 s 降到 1.3 s。這部分無法靠更換模型改善。
- 讓 GPT-6 Luna 回答五個只需一句話的問題時,關閉推理(
reasoning_effort="none")可將耗時從 25.6 s 降到 10.2 s,輸出 token 數從 1,150 降到 190。
本文延續追蹤 LLM 代理的設定。該指南說明了如何用三個請求標頭,把模型呼叫串成一筆追蹤。請先依照指南設定範例環境(Python 3.10 或更新版本,並啟用 virtualenv),再從 github.com/synthorai-io/use-cases 的同一個目錄執行三個案例:
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
每個案例都會執行兩次,先跑有問題的版本,再跑修正版。每次執行會印出一行結果,包含追蹤 ID:
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
模型每次呼叫的延遲都會波動,因此我們在 2026 年 10 月 11 日將每個案例各執行五次。下表列出中位數,括號內是最快與最慢的執行時間。第三個案例的修正版有一次失敗,因此其中位數取自四次執行。上面的範例輸出與截圖中的比較,各來自另外一次執行,不包含在這五次測試中。時間均為腳本量測的實際經過時間,也就是從開始到結束的耗時。
| 案例 | 追蹤呈現的現象 | 修正方式 | 修正前 | 修正後 |
|---|---|---|---|---|
serial-checks | 長條呈階梯狀,彼此沒有重疊 | 同時送出互不相依的呼叫 | 3.7 s(3.5 到 4.5) | 1.8 s(1.7 到 2.0) |
slow-tool | your app 列很長 | 修正自身程式碼 | 11.0 s(9.5 到 12.2) | 9.2 s(6.7 到 11.0) |
reasoning | 輸出 token 數遠高於回覆長度 | 降低推理強度 | 五個回答共 25.6 s(19.0 到 31.8) | 10.2 s(7.9 到 12.1) |
代理執行很慢,該從哪裡查起?
先看追蹤頂端的摘要。它會將總耗時分成閘道內的時間,以及應用程式內的時間。總耗時就是使用者實際等待的時間。「In the gateway」指至少有一個模型請求尚未結束的時段。「In your app」則是其餘時間:請求之間只有你的程式碼在執行的空檔。這部分也包含程式碼與閘道之間的網路傳輸時間;本文的執行結果中,每次呼叫約占零點幾秒。
根據這個拆分,就能決定下一步要查哪裡:
- 大部分時間在閘道內,長條呈階梯狀:呼叫在互相等待。請看第一個案例。
- 應用程式內的時間占比很高:問題不在模型。請看第二個案例。
- 大部分時間在閘道內,而且有一條特別長的長條:某次呼叫占了大部分時間。摘要會將它標為「slowest」。請看第三個案例。
要確認修改的效果,先開啟修正前的追蹤,選擇 Compare,再選取修正後的追蹤。主控台會在同一頁呈現兩次執行:每個指標都有 A、B 與差異;同名呼叫會配對比較;兩張瀑布圖也會共用同一條時間軸。本文所有圖片都來自這個檢視畫面。
可以同時執行的呼叫,卻逐一執行時,追蹤會長什麼樣子?
瀑布圖會呈階梯狀:前一條長條結束,下一條才開始。範例代理使用 DeepSeek V4.1 Flash,針對客戶訊息執行三項只需一句話回答的檢查:情緒、政策與風險。這三項檢查都不需要其他檢查的結果,但有問題的版本卻在迴圈中逐一等待:
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
只要改一行:
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))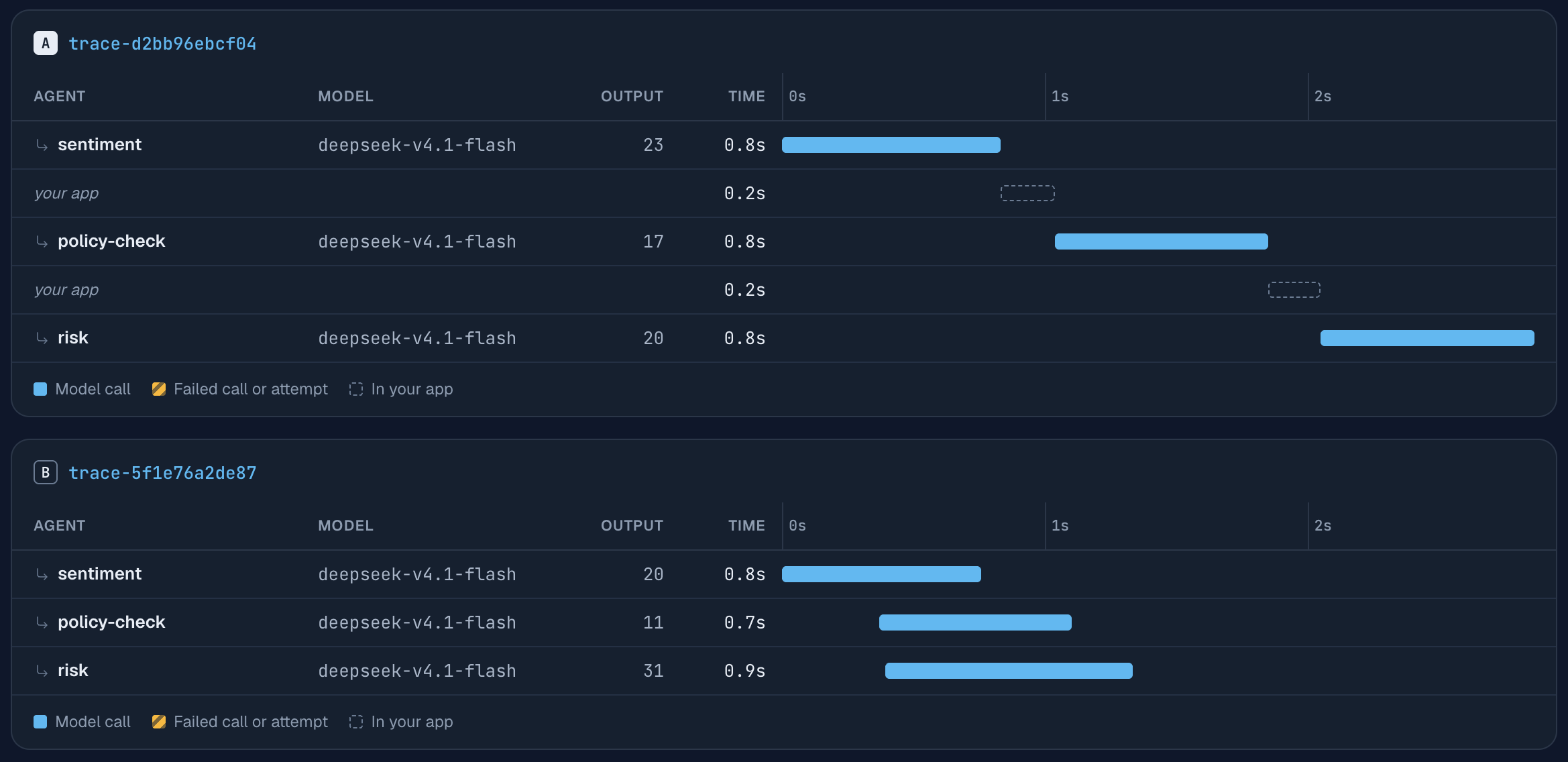
追蹤 A 的總耗時是 2.9 s:三次呼叫各花 0.8 s,逐一執行,彼此之間還有 0.2 s 的空檔。追蹤 B 的長條互相重疊,總耗時是 1.3 s。同一個主控台頁面上,截圖區域上方的比較表顯示,總耗時從 2.9 s 降到 1.3 s,減少 53.4%(以未四捨五入的時間計算)。腳本對這組執行量到的時間是 3.5 s 與 1.5 s,因為它也計入建立連線,以及每次呼叫的網路傳輸時間。
兩次執行的輸入都是 127 個 token。成本會隨輸出量變化,而每次執行的輸出長度略有不同:這組執行的成本是 $0.000110 與 $0.000112;五次執行的中位數則是循序版 $0.000105、並行版 $0.000109。並行呼叫收送的 token 相同,因此不會增加成本。
檢查自己的代理時,可以逐一查看相鄰的兩條長條,確認第二次呼叫是否用到了第一次的輸出。如果沒有,就可以讓它們重疊執行。前後有相依關係的呼叫,例如先產生計畫,再執行計畫中的步驟,仍然必須依序執行。
怎麼判斷慢的是自己的程式碼?
your app 列會很長。這個案例中,有問題的版本會先從四張資料表查詢客戶資料,再回答問題,而且一次只查一張表。每次查詢都用 1.1 s 的 sleep 模擬資料庫呼叫:
rows = [await lookup(t) for t in tables] # four queries, one at a time同樣只要改一行,就能同時執行四次查詢:
rows = await asyncio.gather(*(lookup(t) for t in tables))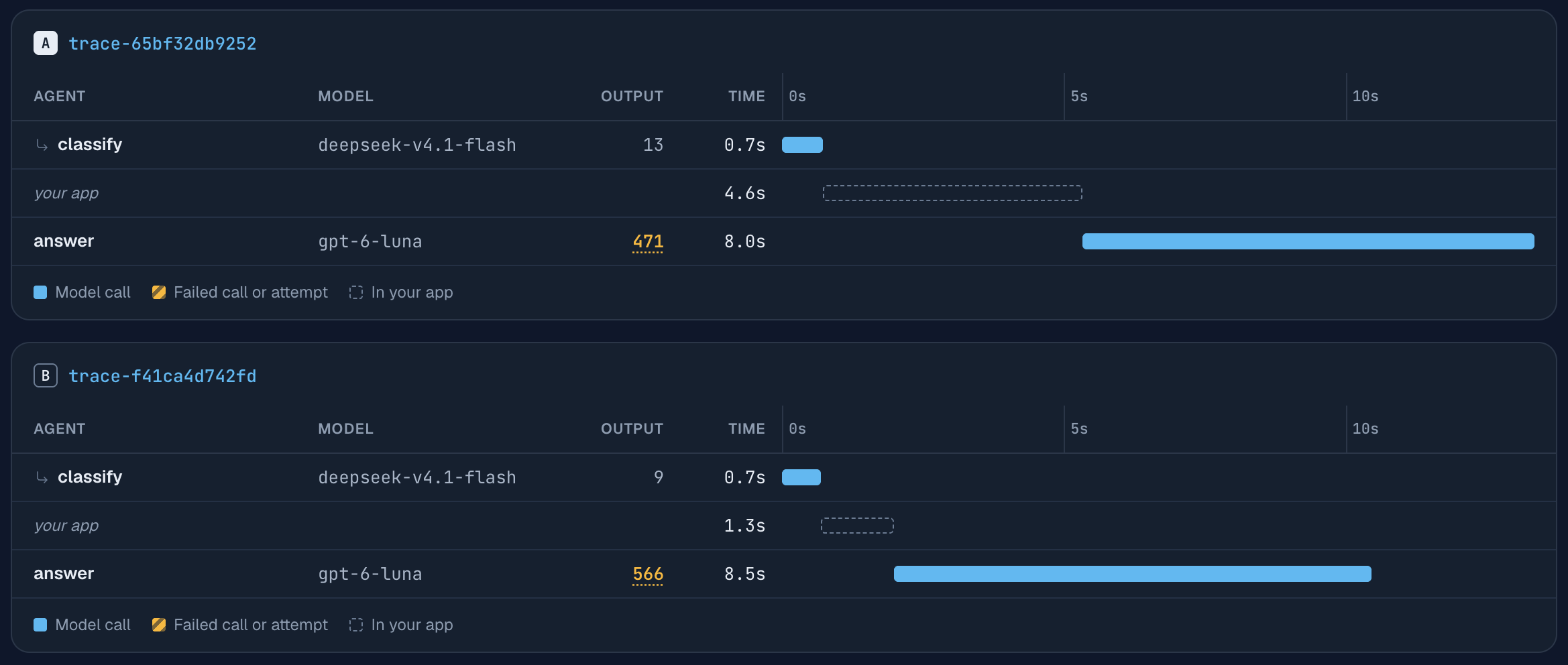
修正的那一列從 4.6 s 縮短到 1.3 s。比較表顯示「In your app」減少 71.8%,同樣是以未四捨五入的時間計算。更換模型或修改 prompt 都無法改善這一段:當時沒有任何模型請求尚未結束,代理只是在等待自己的查詢。
總耗時的變化就沒這麼單純。這組執行從 13.3 s 降到 10.5 s;修正本身省了 3.3 s,整體卻只省了 2.8 s。少掉的半秒來自 GPT-6 Luna 的 answer 呼叫:第一次輸出 471 個 token,第二次輸出 566 個,耗時分別為 8.0 s 與 8.5 s。表中的五次執行,兩個版本的時間範圍有重疊:修正版為 6.7 到 11.0 s,有問題的版本為 9.5 到 12.2 s。因此,單次修正版執行仍可能比單次未修正版更慢。
所以應該比較你修改的那一列,而不是只比較單次執行的總耗時。比較畫面的逐次呼叫表會將對應呼叫排在一起,以 A 與 B 顯示時間、輸出量和成本。若要確認端到端效能是否改善,應比較兩個版本各自多筆追蹤的執行時間。Logs 中的 p95 延遲(95% 的請求能在此時間內完成)不會反映這項修正。它量測的是單次請求,而這裡省下的是請求之間的時間。
閘道只能看見空檔持續多久,無法知道你的程式碼在這段時間做了什麼。如果空檔很長,而且原因不明,就該用 OpenTelemetry 為自己的函式加上 span。
如果慢的是某一次模型呼叫呢?
先看那次呼叫產生了多少 token,因為產生輸出需要時間。推理模型會先思考再回答,即使可見回覆只有一句話,思考過程仍會算入輸出 token 的費用與耗時。這個案例中,有問題的版本向 GPT-6 Luna 提出五個簡短的政策問題,要求「用一句話回答」,但保留預設推理強度。修正版只增加一個參數:
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")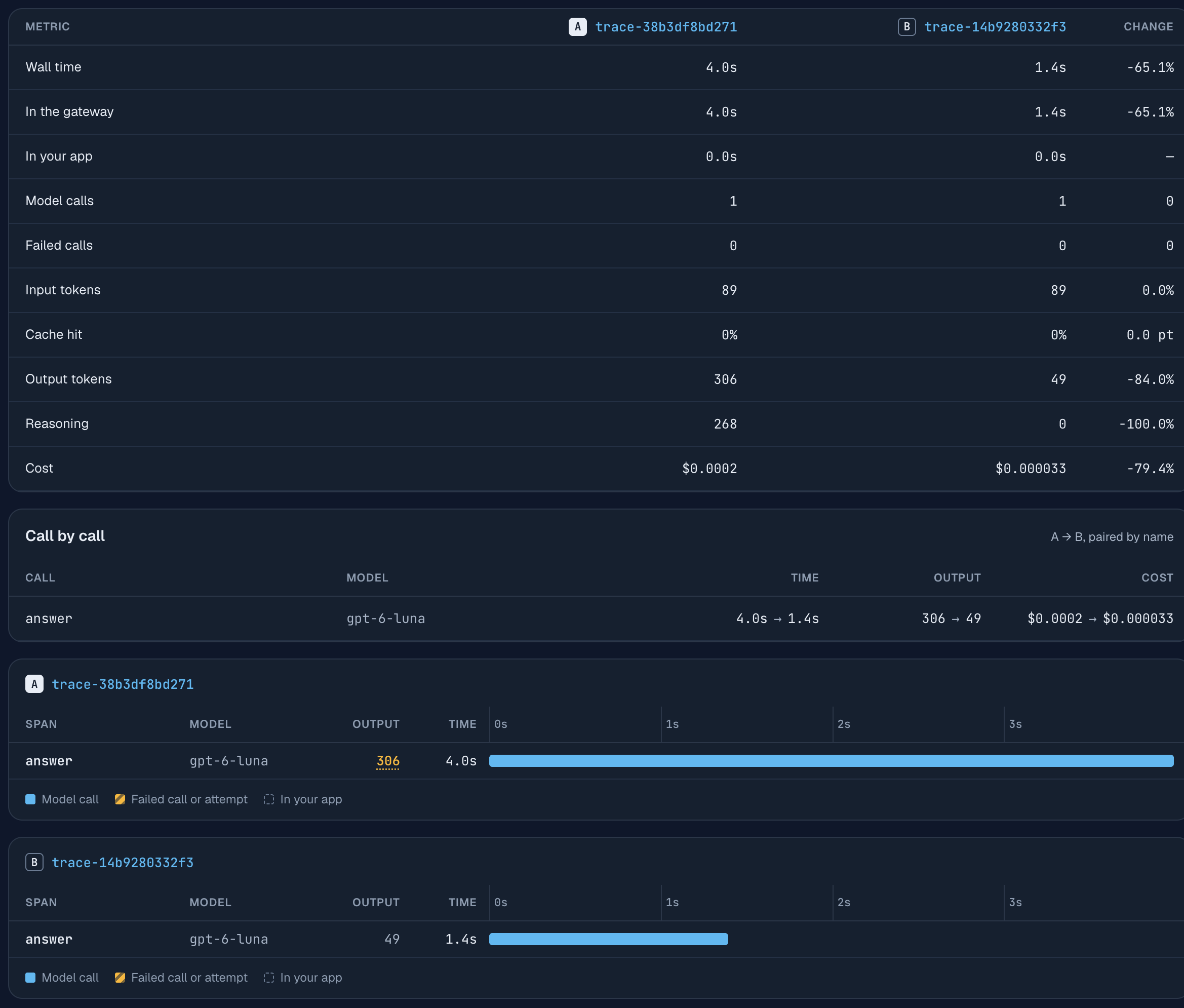
這是五個問題中第一題的修正前後比較。兩次回覆都只有一句話。使用預設推理強度時,模型為了產生這句回答,輸出了 306 個 token,其中 268 個用於推理,耗時 4.0 s。關閉推理後,輸出 49 個 token,耗時 1.4 s。這次呼叫的成本從 $0.00016 降到 $0.000033;主控台會將前者四捨五入顯示為 $0.0002。
| 五個單句回答(五次執行的中位數,第二列為四次) | 時間 | 輸出 token 數 | 成本 |
|---|---|---|---|
| 預設推理強度 | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
不必開啟比較畫面,也能發現這個問題。瀑布圖有 Output 欄位;當某次呼叫的輸出量較大,而且大部分用於推理時,數量下方會加上底線,上面的 306 就是如此。選取該呼叫後,面板會在輸出 token 數下方,用獨立一列顯示推理 token 數。
查詢、分類、改寫工具結果這類步驟,適合關閉推理。需要多步推理的任務則不適合,而本範例並未測試這類任務。我們的 GPT-6 Luna 實測列出各設定下,每個回答的推理 token 數與成本;推理強度指南則列出各模型接受哪些值。請依步驟調整,並檢查調整前後的回答。
本文沒有涵蓋哪些問題?
有兩項。第一項是使用者感受到的回覆速度。串流不會縮短一次呼叫的總耗時,但使用者能更早看到文字;對聊天回覆來說,這往往才是重點。呼叫面板中的 First token 欄位就是用來觀察這件事。這些追蹤中的欄位是空白,因為範例沒有使用串流。
第二項是代理以外的原因:例如供應商在那個時段變慢,或速率限制讓用戶端必須等待並重試。這些問題會呈現為一條很長的長條,或一次失敗呼叫之後接著重試,無法靠調整程式碼結構解決。
常見問題
如何找出 LLM 代理最慢的步驟?
開啟該次執行的追蹤,查看摘要:它會標出最慢的呼叫,並將總耗時拆成閘道內與應用程式內的時間。下方瀑布圖會以長條呈現每次呼叫,因此最長的長條或最長的 your app 列,就是要檢查的步驟。
並行呼叫 LLM 比循序呼叫更貴嗎?
不會。範例中的三項檢查,循序送出的成本中位數為 $0.000105,並行送出為 $0.000109,輸入同樣是 127 個 token;差異來自每次執行的輸出長度不同。成本取決於 token 數,而並行呼叫收送的 token 相同。需要留意的是速率限制,因為並行呼叫會同時送達。
回覆很短,為什麼模型呼叫還是很慢?
通常是模型先進行了推理。推理會產生輸出 token,但這些 token 不會出現在可見回覆中。GPT-6 Luna 的五個單句回答,在預設推理強度下,輸出 token 數中位數為 1,150;使用 reasoning_effort="none" 時則為 190。
如何量測修正是否讓代理變快?
比較你修改的部分,不要只看一次執行的總耗時。範例中,同時執行四次查詢,讓自身程式碼的耗時從 4.6 s 降到 1.3 s;但因為其中一次模型呼叫的耗時會波動,修正後各次執行的總耗時仍介於 6.7 s 到 11.0 s。應以追蹤的執行時間,比較兩個版本的多次結果。
閘道能顯示兩次模型呼叫之間,我的程式碼做了什麼嗎?
它會用 your app 列顯示空檔持續多久,但不會顯示這段時間內發生了什麼。若要查看自身程式碼內的 span,請使用 OpenTelemetry SDK,並將它的 traceparent 標頭一路傳遞,讓兩個檢視畫面共用同一個追蹤 ID。
延伸閱讀
- 追蹤 LLM 代理:本文使用的標頭與瀑布圖。
- LLM 代理為什麼這麼貴?:用同樣的方法分析費用。
- 除錯 LLM 代理:從使用者回報追查到出錯的呼叫。
- 按子代理拆分 Claude Code 成本:將相同的檢視方式用在不是你自己寫的程式開發代理上。
- 讓 Claude 回答 LLM 日誌問題:透過 MCP 回答請求日誌相關問題。
- 為代理提供日誌工具:用自己的程式讀取同一份日誌,以及模型 token 的成本。
- GPT-6 Luna 與 GPT-5.6 Luna 比較:各推理強度設定下的推理 token 數與每個回答的成本。