
LLM 代理除錯:追蹤中的 3 種失敗,其中一種回傳 200
依照標籤找出某位使用者的一次代理執行紀錄,再閱讀該次執行的追蹤內容,辨識三種失敗情況:收到 404 後進行重試、HTTP 狀態碼為 200 但回覆內容遭截斷,以及第二輪對話出現 400。分別確認追蹤中的重試紀錄、回覆截斷情形與錯誤發生輪次,區分這三種失敗。
我們的推薦
即時價格| 模型 | 結論 | 價格 |
|---|---|---|
| GPT-6 Luna 當儲存的歷史紀錄遺失了一次工具呼叫時,在 0.5 s 內以 400 拒絕了對話的第二輪,且未收費。 | 示範中的主代理程式 | 低至 $0.1/百萬 |
| DeepSeek V4.1 Flash max_tokens 設為 40 時,連續三次呼叫都回傳狀態碼 200,且輸出恰好 40 個 token,但沒有可用的回覆。提高上限並關閉推理後,一次呼叫以 49 個 token 作答。 | 示範中的子代理程式 | 低至 $0.3/百萬 |
目錄
「昨天下午助理給我的回答根本沒用。」代理的錯誤回報通常就是這樣:只有一位使用者、大概的時間,沒有請求 ID。要找出那次執行,請求上得有標籤;要弄清楚問題,則需要追蹤紀錄。因為出錯的往往只是多次呼叫中的某一次,而且看起來不一定像錯誤。本文從使用者回報出發,找出出問題的呼叫,再用一個小型客服代理重現三種失敗,看看它們在 Synthorai 主控台中各自呈現什麼樣子。
TL;DR
- 每個請求都加上
_user標籤,就能在 Traces 清單中用一次搜尋找出該使用者的代理執行紀錄。 - 重試時沿用追蹤 ID,失敗的呼叫和重試就會並列顯示。範例中的 404 耗時 95 ms,費用為 $0。
- 推理模型設為
max_tokens=40時,三次呼叫都回傳狀態 200,輸出各有 40 個 token,卻沒有回覆。 - 儲存的歷史紀錄遺失了工具呼叫,導致第二輪對話回傳 400,未產生費用。
本文延續追蹤 LLM 代理,該篇說明了這裡使用的請求標頭。請依照該篇設定範例環境(Python 3.10 以上,並啟用 virtualenv),接著在 github.com/synthorai-io/use-cases 的同一個目錄中執行:
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
本文的數據來自 2026 年 10 月 11 日,每個範例各執行一次的結果。
| 追蹤紀錄中看到的現象 | 代表的意義 | 案例 |
|---|---|---|
| 帶有狀態碼的斜線標記,後面接著一個類似的呼叫 | 呼叫失敗後重試 | run.py --fail |
| 同一個 span 出現多次,全部都是 200,Output 欄位等於設定的上限 | 回覆在產生可用內容前就遭截斷 | cut-off |
| 工作階段的第二輪出現 400,0 個 token,$0 | 程式組出的請求不合法 | bad-history |
如何找出特定使用者的執行紀錄?
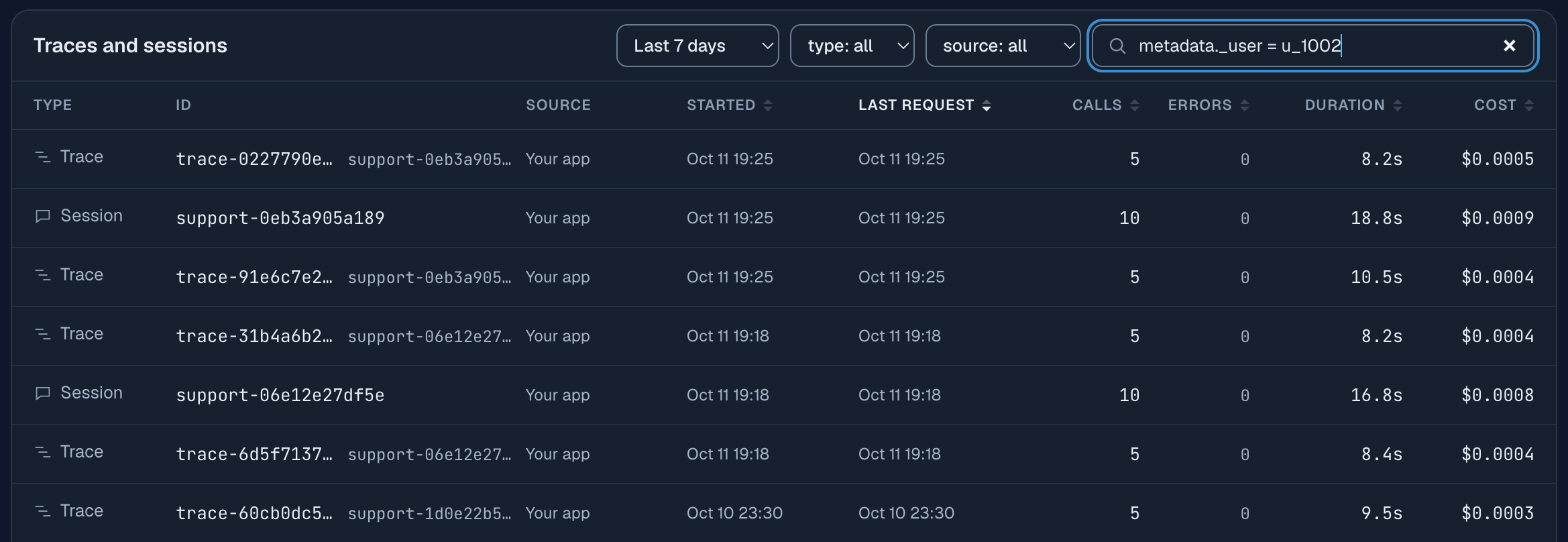
用請求附帶的標籤來找。只要每個請求都在 X-Synthorai-Metadata 中帶上 _user,套用一個篩選條件就能找到該使用者的請求:
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- 開啟 Traces,在搜尋框輸入
metadata._user = u_1002,再按 Enter。將時間範圍設為涵蓋使用者回報的時段。 - 查看清單。現在只會列出該使用者的工作階段及其追蹤紀錄,每筆都有呼叫次數、錯誤數、耗時與費用;Calls、Errors、Duration 和 Cost 欄位都可以排序。先看有錯誤的追蹤,或呼叫次數明顯高於前後紀錄的追蹤。
- 開啟該筆追蹤。這裡會顯示完整的執行過程;「Open session」可查看前後的對話,「See the calls in Logs」則會列出其中的個別請求。
如果要搜尋個別請求,而不是整次執行,Logs 的篩選框也支援同樣的標籤,還能搭配 status(error、success、4xx、5xx 或特定狀態碼)、latency、cost、model、session 和 trace。
沒有標籤時,就從手上已有的資訊找起:將自家日誌中的追蹤 ID 貼進 Traces 搜尋框;從回應標頭取得的請求 ID,則在 Logs 中用 request_id 篩選。因此,應該把回應標頭 x-request-id 和自家的使用者 ID、對話 ID 一起記錄下來。
_user 請使用內部使用者 ID,不要放電子郵件地址或姓名。標籤會和請求一起儲存。
呼叫失敗後重試,在追蹤中會是什麼樣子?
失敗的呼叫會顯示為帶有狀態碼的斜線標記,旁邊就是取代它的重試呼叫。在追蹤教學中,三個平行檢查之一指定了不存在的模型 ID。追蹤中,policy-check 是一個標示 404、耗時 95 ms 的標記,旁邊的 policy-check.retry 則是正常的長條。追蹤摘要顯示「6 model calls, 1 failed」,工作階段頁面列出「1 × 404 Not found」。失敗的呼叫費用為 $0。
這張圖之所以容易判讀,靠的是程式中的兩個安排。首先,重試沿用追蹤 ID,讓失敗和重試出現在同一張圖中。其次,重試有自己的 span 名稱,可以區分不同嘗試。如果重試另開一筆追蹤,看起來就會像兩次無關的執行,其中一次還不明原因地失敗。
追蹤中有失敗,不一定代表有待處理的問題。這次執行已經恢復正常,客戶也拿到了回答。追蹤會告訴你失敗的代價:這裡是 95 ms,沒有額外費用。知道這些,才能判斷重試是否已經足夠,還是需要修正根本原因。
為什麼每次呼叫都成功,代理卻沒有回覆?
因為狀態 200 只代表請求已完成,不代表產生了可用的回答。這個案例中,使用 DeepSeek V4.1 Flash 的子代理負責判斷一則訊息涉及哪些政策主題,卻沿用了先前較簡單 prompt 的 max_tokens=40。和範例中其他子代理呼叫不同,這個有問題的檢查保留了模型預設的推理設定(程式片段中的 think)。模型先推理再作答,推理就用完了 40 個 token,最後回覆是空的,finish_reason 則為 length。程式看到空回覆就再試,總共嘗試三次:
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again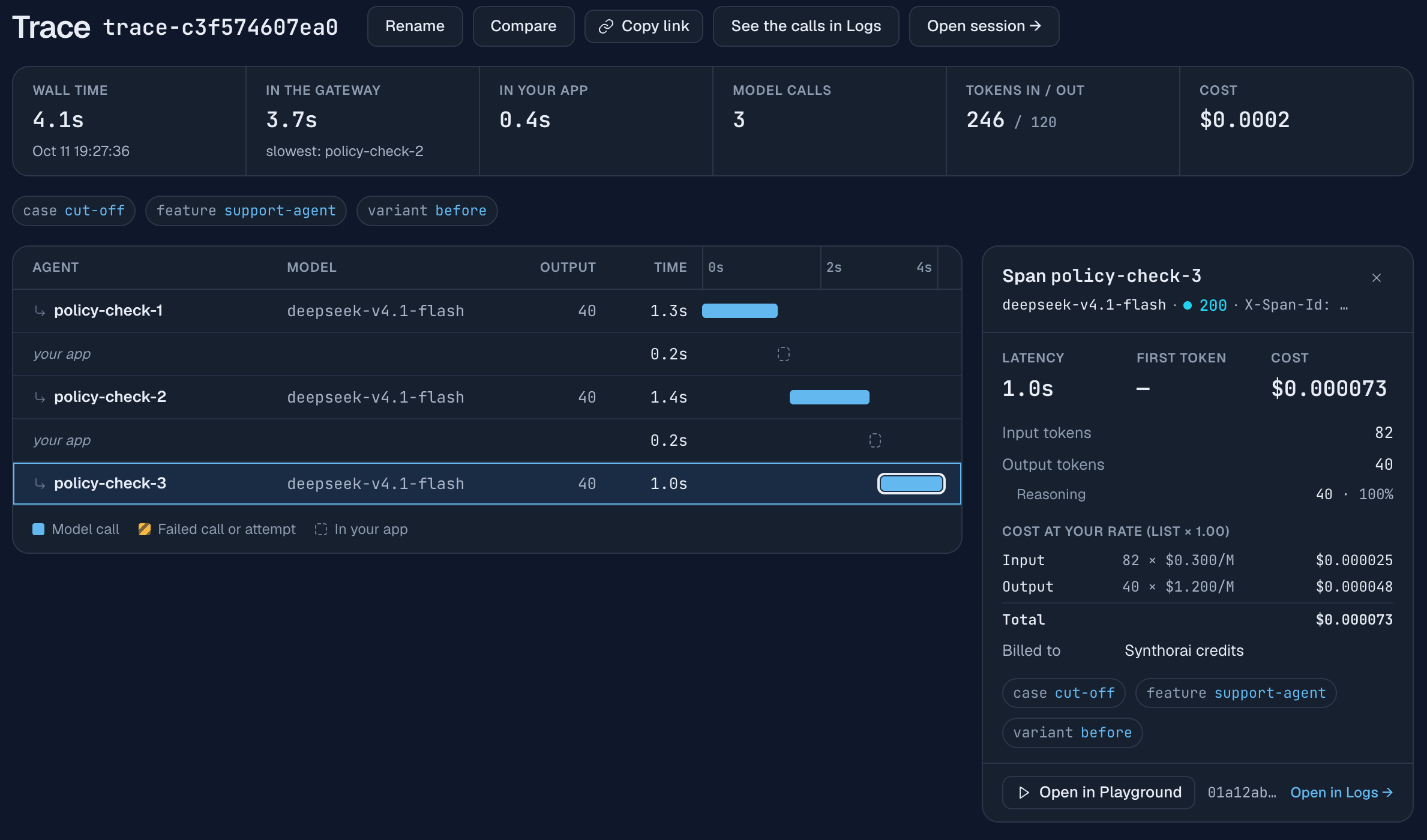
瀑布圖中沒有任何呼叫被標記為失敗。線索是重複出現的 span,以及 Output 欄位中的 40、40、40,剛好都是上限。選取呼叫後,右側面板會確認這點:狀態 200、40 個輸出 token,下方一列顯示「Reasoning 40 · 100%」。
輸出數量剛好等於設定的上限,就是回覆遭截斷的特徵。修正版將上限提高到 2,000,並關閉這項檢查不需要的推理。這樣一次呼叫就能用 49 個輸出 token 回答,追蹤中的三個長條也變成一個。只提高上限同樣能停止重試,但那次呼叫用了 1,876 個輸出 token 進行推理,耗時 22 s。
自己的代理也應該做到以下幾點:
- 每次呼叫都檢查
finish_reason。length代表回覆遭截斷。即使狀態是 200,也要在自家日誌中視為失敗。 - 設定
max_tokens時,要同時預留推理和回覆的額度。推理模型的上限涵蓋兩者。如果只按照使用者看得到的回答來設定,可能根本沒有剩餘額度可供作答。 - 回覆遭截斷後,不要沿用同一個上限重試。第二次仍會撞上同樣的限制。提高上限、降低推理強度,或兩者一起調整。
為什麼第一輪正常,第二輪卻失敗?
通常是程式在兩輪之間儲存的資料出了問題。模型請求會帶上整段對話,所以儲存或重建歷史紀錄的錯誤,要到第二輪才會出現。這個案例的第一輪使用記憶體中的訊息執行:GPT-6 Luna 發出工具呼叫、取得結果並回答,一切正常。接著程式儲存這一輪對話,卻只把助理訊息存成文字,丟掉了工具呼叫,再把工具結果存到它旁邊:
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
客戶再次傳送訊息時,第二輪會用這份儲存的歷史紀錄組出請求。請求裡有工具結果,對應的呼叫卻已經不在歷史紀錄中,因此遭到拒絕,回傳以下錯誤(「function call output」是供應商對工具結果的稱呼):
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.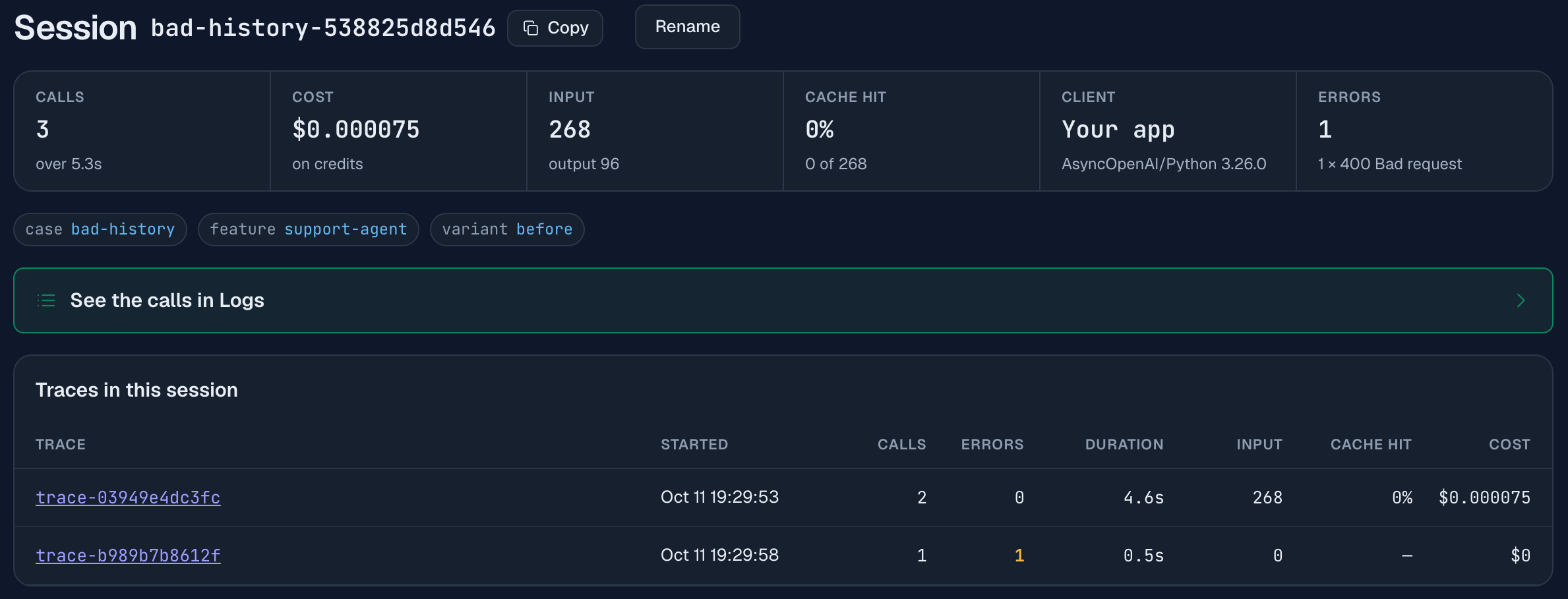
工作階段頁面清楚呈現這個模式:兩筆追蹤,第一筆有 2 次呼叫且沒有錯誤,第二筆有 1 次呼叫和 1 個錯誤,錯誤卡片上顯示「1 × 400 Bad request」。失敗的追蹤顯示 0 個輸入 token、耗時 0.5 s、費用 $0。這三個數值合起來表示模型根本沒有執行:請求因為不合法而遭拒絕。這也能區分請求錯誤與模型或供應商的問題;後者通常會看到 token、較長的耗時,或 5xx 狀態。
400 是請求本身的錯誤,重試沒有用,錯誤訊息也已指出該修正什麼。完整儲存助理訊息後,第二輪就能成功。
其他幾種歷史紀錄錯誤也會呈現相同模式:第一輪正常,後續某一輪遭拒絕。例如,儲存工具結果時漏掉呼叫 ID、訊息順序存錯,或裁切歷史紀錄時從工具互動中間切開,留下結果卻刪掉呼叫。如果要裁切歷史紀錄來控制費用,請在兩輪之間切,不要從一輪中間切開。
每個代理應該記錄哪些資訊,才能這樣除錯?
記錄五項資訊:
- 每次執行的追蹤 ID,以及每段對話的工作階段 ID,透過
X-Trace-Id和X-Session-Id傳送,也寫入自家日誌。 - 每次呼叫的 span 名稱,標明步驟與嘗試次數,例如
plan-2或policy-check.retry。 - 使用者、功能與版本的標籤,透過
X-Synthorai-Metadata傳送。 - 每次呼叫的
x-request-id回應標頭,和自家的 ID 一起記錄。 - 每次呼叫的
finish_reason和輸出 token 數量,並將length視為失敗。
每次呼叫也都要設定用戶端逾時和 max_tokens,而且兩者都要留足餘裕。兩個都沒設,模型寫多久,呼叫就可能持續多久,程式也會一直等。但如果只按可見回覆的長度設定上限,就會重現第二個案例的問題;如果逾時短於長篇生成所需的時間,則會中斷原本正常的呼叫。推理模型的一次呼叫可能花上好幾分鐘。範例的等待時間是 300 s,每次呼叫的輸出上限為 2,000 個 token,除非該呼叫另有設定。
常見問題
如何在正式環境中替 LLM 代理除錯?
先找出那次執行:用使用者或對話標籤篩選請求日誌,再開啟符合條件的請求所屬的追蹤。追蹤會依序顯示這次執行中的每個模型呼叫,並標出失敗的呼叫,不用先讀程式碼就能看出哪個步驟出錯。
為什麼 LLM 回傳狀態 200,回覆卻是空的?
通常是模型還沒寫出回答,就已達到輸出上限。推理模型的 max_tokens 同時涵蓋推理與回覆。檢查 finish_reason:如果是 length,而且輸出 token 數量等於上限,就代表回覆遭截斷。範例中連續三次呼叫都回傳 200,輸出恰好都是 40 個 token,卻沒有可用的回覆。
什麼原因會造成「No tool call found for function call output」?
對話歷史中有工具結果,卻缺少對應的工具呼叫。可能是儲存發出呼叫的助理訊息時,漏掉了 tool_calls;也可能是裁切歷史紀錄時,把呼叫和結果切開了。請完整儲存助理訊息,並且只在兩輪之間裁切。
LLM 呼叫失敗後該重試嗎?
要看狀態碼。429(速率限制)或 5xx(伺服器錯誤)重試後可能成功。400 是請求本身有問題,重試仍會以同樣方式失敗;被 max_tokens 截斷的回覆,如果不調整上限,再試也會遭截斷。重試時請沿用追蹤 ID,讓兩次嘗試出現在同一筆追蹤中。
延伸閱讀
- 追蹤 LLM 代理:請求標頭、瀑布圖,以及呼叫失敗的範例。
- 為什麼我的 LLM 代理很慢?:從同一份追蹤分析延遲。
- 為什麼我的 LLM 代理費用這麼高?:從工作階段分析費用。
- 依子代理查看 Claude Code 費用:用相同的檢視方式分析不是自己寫的程式開發代理。
- 讓 Claude 查詢你的 LLM 日誌:透過 MCP 回答「這位使用者有任何請求失敗嗎?」。
- 替代理提供日誌工具:用自己的程式讀取同一份日誌,以及模型 token 的費用。
- 請求標頭參考文件:ID、標籤及其限制。