
Claude Opus 5.5 vs Opus 5: mesmas respostas, metade dos tokens
Conteúdo
- O que mudou de fato no Claude Opus 5.5?
- O que mostram os benchmarks de lançamento?
- A promessa de menor custo se confirma em tarefas de uma chamada?
- O que acontece em um loop de ferramentas, onde o custo dos agentes se acumula?
- Quanto da economia vem apenas da redução de preço?
- Um nível de esforço maior compensa em algum caso?
- O que quebra ao trocar o ID do modelo?
- Os limites de prompt continuam válidos?
- Quando vale a pena migrar?
- Perguntas frequentes
O preço de tabela do Claude Opus 5.5 é 20% menor que o do Claude Opus 5: $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída, contra $5 e $25. Esses 20% independem do comportamento do modelo. A questão é quanto ainda se economiza depois de descontá-los. Em 13 tarefas de uma única chamada, com a configuração padrão de cada modelo, o Opus 5.5 custou 65% menos. Mesmo com preços idênticos, ainda seria 56% mais barato. Em um loop de ferramentas com várias etapas, a diferença cai bastante: 37% na fatura e 22% com a mesma tabela de preços.
TL;DR
- Em 468 chamadas avaliadas, o Opus 5.5 custou $0.0072 por tarefa, contra $0.0204 do Opus 5. Os dois acertaram todas as tarefas.
- Com preços idênticos, o Opus 5.5 ainda foi 56% mais barato nessas tarefas: produziu em média 341 tokens de saída, contra 799.
- Em um loop de ferramentas com quatro perguntas, a diferença cai para 22% com preços iguais, pois os tokens de entrada predominam e os dois modelos leem os mesmos arquivos.
- Com esforço
max, o Opus 5.5 custou 3.3x o próprio padrão nesse loop e não resolveu nada a mais. - Definir
tool_choicecomoanyou indicar uma ferramenta pelo nome agora retorna HTTP 400. O Opus 5 aceita as duas formas.
A Anthropic lançou o Opus 5.5 em 2026-09-22 afirmando que ele “custa 40% menos para operar que o Opus 5” em cargas de trabalho típicas. Só a segunda parte dessa redução, o menor número de tokens por tarefa, depende do comportamento do modelo. É essa parte que vale medir.
O que mudou de fato no Claude Opus 5.5?
A redução de preço é a menor das mudanças. A principal é o fim do controle que ligava ou desligava o thinking. Com o raciocínio adaptativo, o próprio modelo decide quanto tempo vai raciocinar antes de responder. Esses tokens de raciocínio são cobrados como saída, mesmo quando a API não os exibe. No Opus 5.5, esse modo fica sempre ativo. O único controle disponível é effort, um parâmetro da requisição com cinco níveis, de low a max, que limita quanto raciocínio o modelo pode usar.
O Opus 5 aceitava thinking: {"type": "disabled"}. Essa foi a única configuração que igualou seu custo ao do Opus 4.8 em nossas medições do Opus 5. Esse controle não existe mais.
| Opus 5 | Opus 5.5 | |
|---|---|---|
| Preço de tabela (entrada / saída por MTok) | $5 / $25 | $4 / $20 |
| Thinking | adaptativo, pode ser desativado com esforço high ou menor | adaptativo, sempre ativo |
| Esforço padrão | high | medium |
| Uso forçado de ferramenta | aceito | erro 400 (medido) |
| Janela de contexto / saída máxima | 1M / 128K | 1M / 128K |
| Data de corte do conhecimento | maio de 2026 | junho de 2026 |
| Lançamento | 2026-07-24 | 2026-09-22 |
| Texto entre chamadas de ferramentas | blocos text | blocos thinking, vazios na configuração padrão de exibição |
| Categorias de proteção | segurança cibernética | segurança cibernética e biologia, além de recusa à extração do raciocínio |
Duas linhas exigem atenção. O esforço padrão caiu um nível, de high para medium. Portanto, uma requisição sem o campo de esforço não usa a mesma profundidade que usava no Opus 5. A mudança nas atualizações de progresso também é silenciosa. As mensagens curtas que o modelo escrevia entre chamadas de ferramentas agora chegam como blocos de thinking, cujo texto fica vazio quando se usa a configuração padrão de exibição. Uma interface que transmite essas mensagens por streaming simplesmente fica em silêncio, sem gerar um erro que possa ser tratado.
O que mostram os benchmarks de lançamento?
Na tabela publicada pela Anthropic, o Opus 5.5 ficou à frente do Fable 5.1 em todos os benchmarks de programação e trabalho intelectual, além de superar o GPT-6 Astra na maioria deles. Os números abaixo são da Anthropic. Os testes usaram raciocínio adaptativo com esforço máximo, enquanto as linhas do Terminal-Bench usaram xhigh.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programação com agentes) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | não informado |
| GDPval-AA v2.1 (trabalho intelectual, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench (fluxos de trabalho empresariais) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.0 (uso de computador) | 81.8% | 80.7% | 74.0% | não informado |
A própria Anthropic faz uma ressalva pouco comum: nesse nível, “as margens dos benchmarks se tornaram um indicador menos confiável das diferenças no mundo real”. Na prática, a distância para o Fable 5.1 é menor do que as pontuações sugerem. Duas notas de rodapé precisam ser consideradas antes de citar esses números. A execução do AutomationBench foi feita pela Zapier sem modelos de fallback. Por isso, toda intervenção dos mecanismos de proteção contou como falha. Além disso, toda a tabela foi executada com as proteções de produção ativas. Quando um classificador intervinha, tarefas de segurança cibernética eram encaminhadas ao Opus 4.8 e tarefas de biologia ao Opus 5.
Nada disso informa o custo por tarefa. Por isso, fizemos nossas próprias medições.
A promessa de menor custo se confirma em tarefas de uma chamada?
Sim, e a maior parte da diferença vem de eficiência real, não da tabela de preços. Uma tarefa de uma chamada usa uma requisição, uma resposta e nenhuma ferramenta. Os testes incluíram problemas de aritmética e contagem, como uma regra iterativa de 200 etapas ou a contagem de caminhos em uma grade com células bloqueadas. Executamos 13 tarefas, com 3 repetições cada, nos cinco níveis de esforço e também na configuração padrão, tanto no Opus 5.5 quanto no Opus 5. Foram 468 chamadas avaliadas. Antes da execução, todas as respostas foram obtidas por força bruta em Python. Cada prompt recebeu uma string aleatória exclusiva, impedindo que qualquer camada entre nós e o modelo respondesse a partir de uma duplicata em cache. O custo por tarefa foi calculado com os preços de tabela da Anthropic e os tokens cobrados em cada chamada, incluindo o thinking, em vez de ser lido da resposta.
| Esforço | Mediana de tokens de saída do Opus 5.5 | Opus 5.5 $/tarefa | Mediana de tokens de saída do Opus 5 | Opus 5 $/tarefa |
|---|---|---|---|---|
| padrão | 193 | 0.0072 | 448 | 0.0204 |
| low | 185 | 0.0060 | 439 | 0.0201 |
| medium | 218 | 0.0085 | 538 | 0.0200 |
| high | 223 | 0.0094 | 542 | 0.0206 |
| xhigh | 233 | 0.0111 | 525 | 0.0197 |
| max | 762 | 0.0240 | 532 | 0.0220 |
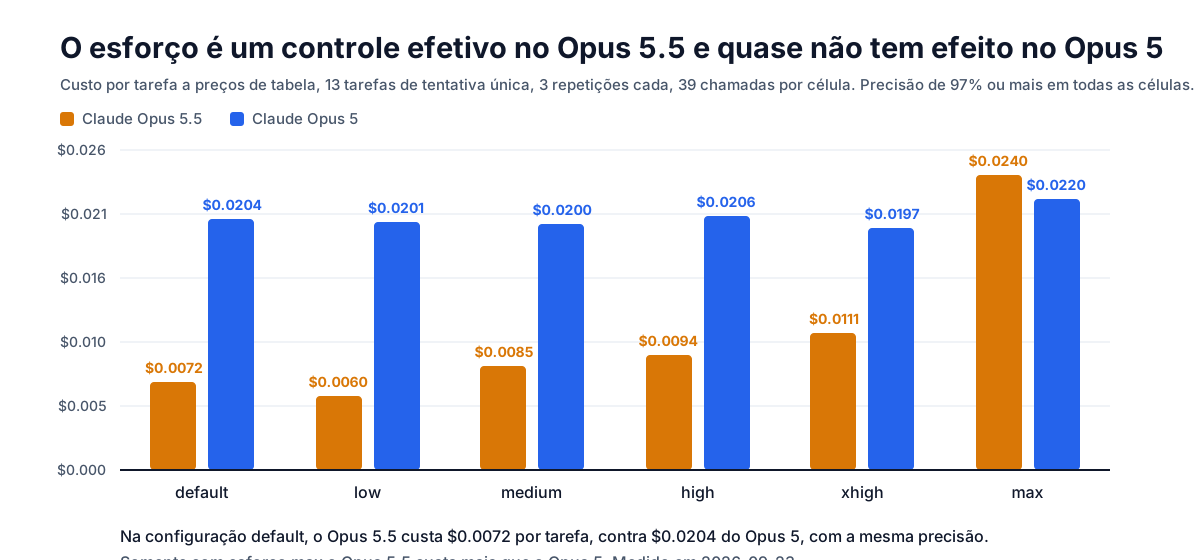
A taxa de acerto foi de 100% para os dois modelos na configuração padrão e de pelo menos 97% em todos os outros níveis. Os três erros ocorreram em tarefas e níveis diferentes, sem concentração na parte inferior da escala. Não houve queda brusca de precisão nesse conjunto de tarefas. Toda a diferença está no custo.
A escala de esforço se comporta de maneira diferente nos dois modelos. No Opus 5, o custo permanece praticamente estável, de $0.0197 a $0.0220 entre low e max, uma variação de 12%. No Opus 5.5, a diferença chega a 4x, de $0.0060 a $0.0240. O esforço funciona como um controle efetivo no Opus 5.5, mas tem pouco efeito no Opus 5. Uma migração que apenas copie a configuração pode chegar a um resultado bem diferente do original.
Nas cinco tarefas mais difíceis, a diferença aumenta. Na configuração padrão, o Opus 5.5 custou $0.0113 por tarefa, contra $0.0375 do Opus 5. A mediana de tokens de saída foi de 585 contra 1,145.
O que acontece em um loop de ferramentas, onde o custo dos agentes se acumula?
A economia continua existindo no loop, mas com uma diferença menor. Um loop de ferramentas é o teste mais realista entre o Opus 5.5 e o Opus 5. Cada turno corresponde a uma requisição: o modelo solicita uma ferramenta, seu código a executa e envia todo o histórico de volta. Em uma conversa de cinco turnos, o histórico crescente é cobrado cinco vezes. O número de turnos, não o preço por token, determina o custo. Disponibilizamos três ferramentas aos dois modelos, para listar arquivos, ler arquivos e pesquisar. Elas operavam sobre um pequeno serviço sintético. Também fornecemos quatro perguntas cujas respostas exigiam seguir uma cadeia de chamadas por três ou quatro arquivos. Depois, executamos 12 rodadas por configuração, usando a mesma interface, as mesmas ferramentas e o mesmo prompt.
| Configuração | Resolvidas | Mediana de turnos | Mediana de chamadas de ferramentas | Mediana de tokens de saída | $/execução |
|---|---|---|---|---|---|
| Opus 5.5, padrão | 12/12 | 4 | 5 | 427 | 0.0326 |
Opus 5.5, low | 12/12 | 4.5 | 5 | 430 | 0.0330 |
Opus 5.5, max | 12/12 | 5 | 12 | 3,124 | 0.1087 |
| Opus 5, padrão | 11/12 | 5 | 7 | 666 | 0.0519 |
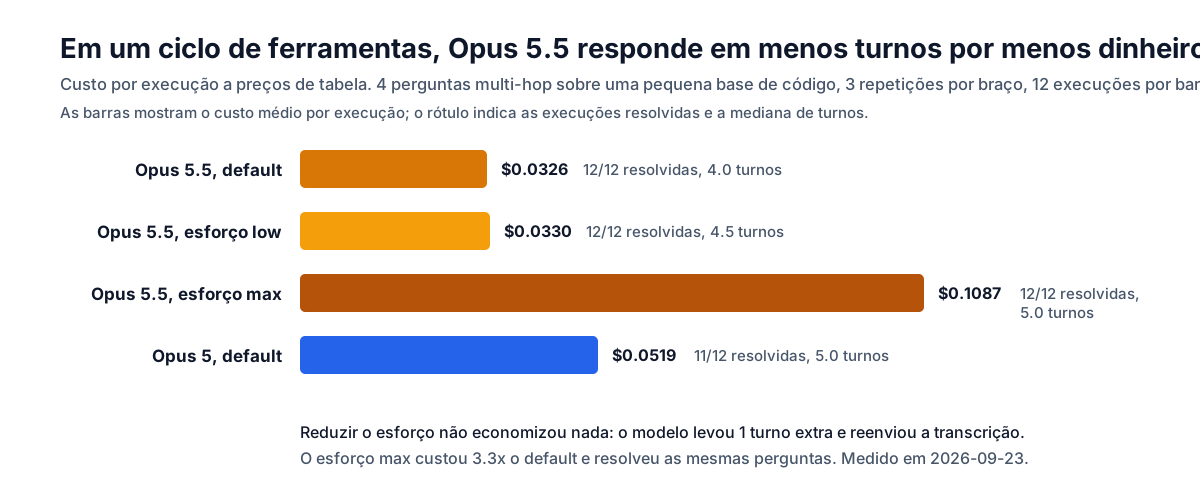
Na configuração padrão, o Opus 5.5 custou 37% menos por execução que o Opus 5, com 12% menos turnos e 30% menos tokens de saída. Por pergunta resolvida, a diferença aumenta para 43%, pois o Opus 5 falhou em uma execução. Esse resultado fica próximo dos “40% menos para operar” anunciados pelo fornecedor e corresponde ao valor que aparece na fatura.
Esse também é o tipo de carga em que a tabela de preços responde pela maior parte da economia. Há uma razão: o loop reenvia o histórico em todos os turnos, os dois modelos leem os mesmos arquivos e o total de tokens caiu apenas 19%, enquanto os tokens de saída caíram 30%. Produzir menos texto ajuda menos justamente onde o gasto é maior. A próxima seção quantifica esse efeito.
Reduzir o Opus 5.5 para low não gerou economia no loop. Em média, o modelo precisou de mais um turno, e o custo adicional de reenviar o histórico consumiu a redução de tokens. O controle de esforço funciona bem em tarefas de uma chamada, mas deixa de compensar em um loop, pois o custo depende do número de turnos, não da profundidade do raciocínio.
Quanto da economia vem apenas da redução de preço?
De um sétimo a dois quintos, dependendo do formato da carga. A coluna central abaixo recalcula o custo dos tokens medidos do Opus 5.5 usando os preços do Opus 5. Ela mostra quanto o Opus 5.5 economiza ao produzir menos texto, mantendo a mesma tabela de preços do Opus 5.
| Carga de trabalho | Diferença cobrada | Com preços idênticos | Tokens de saída |
|---|---|---|---|
| 13 tarefas de uma chamada, padrão | -65% | -56% | -57% |
| cinco tarefas mais difíceis | -70% | -62% | -63% |
| loop de ferramentas com várias etapas, padrão | -37% | -22% | -30% |
As linhas de tarefas de uma chamada mostram um ganho real de eficiência. A redução de preço responde por apenas 14% da economia. O restante vem do modelo escrever menos. A linha do loop de ferramentas é a mais útil para planejamento, pois corresponde ao formato da maior parte do tráfego de agentes. Nesse caso, a redução de preço representa 41% do resultado anunciado.
Um nível de esforço maior compensa em algum caso?
Não nesta carga de trabalho, e o custo adicional é alto. Com max, o Opus 5.5 custou $0.1087 por execução no loop de ferramentas, 3.3x o próprio padrão, e resolveu exatamente as mesmas 12 perguntas. O orçamento adicional foi gasto em chamadas de ferramentas: mediana de 12, contra 5 no padrão, além de 3,124 tokens de saída, contra 427. Nas tarefas de uma chamada, max foi o único nível em que ele custou mais que o Opus 5: $0.0240 contra $0.0220.
Esse orçamento é consumido pelo raciocínio. Nessas tarefas com uma única resposta, o thinking representou 98.4% dos tokens de saída do Opus 5.5 na configuração padrão e 99.6% em max. Todos esses tokens são cobrados pela tarifa de saída e não aparecem quando se usa a configuração padrão de exibição. A própria Anthropic recomenda reservar max para problemas de fronteira. Nossos resultados mostram o efeito prático: em tarefas que o modelo já resolve, cada nível adicional só aumenta o custo.
O que quebra ao trocar o ID do modelo?
Dois formatos de requisição aceitos pelo Opus 5 retornam 400 no Opus 5.5. Ambos são comuns em código existente.
O uso forçado de ferramentas é rejeitado. Qualquer cliente que fixe uma chamada de ferramenta, prática comum para obter JSON estruturado de um modelo de chat, recebe este erro:
tool_choice: type "tool" and "any" are not supported for this model.O mesmo erro ocorre em clientes compatíveis com OpenAI, nos quais a requisição usa tool_choice: "required" ou uma função pelo nome. auto e none continuam funcionando. Para migrar, descreva no prompt quando a ferramenta deve ser usada e adote schemas estritos de ferramentas ou saídas estruturadas quando precisar de JSON válido conforme o schema.
Também não é possível desativar o thinking. Tanto thinking: {"type": "disabled"} quanto um budget_tokens manual falham. Em interfaces compatíveis com OpenAI, o equivalente reasoning_effort: "none" também é recusado. O parâmetro de esforço é o substituto:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "Summarize this incident report in five bullets."}],
    output_config={"effort": "low"},   # low | medium | high | xhigh | max; medium is the default
)

# Thinking is billed as output whether or not you can read it.
print(response.usage.input_tokens, response.usage.output_tokens)
low é a opção mais próxima do antigo modo sem thinking. Em nosso conjunto de tarefas de uma chamada, foi o nível mais barato e manteve a precisão. Mesmo assim, o raciocínio continua ativo e seus tokens continuam sendo cobrados como saída.
Os limites de prompt continuam válidos?
Os limites em tokens continuam exatamente iguais. As mesmas quatro entradas tiveram as mesmas contagens nos dois modelos: 1,277 tokens contra 1,275 em um texto em inglês, 583 contra 581 em Python, 482 contra 480 em um bloco JSON com argumentos de ferramenta e 500 contra 498 em um texto em chinês. A diferença constante de dois tokens vem do enquadramento da requisição, não do texto. Portanto, limites de contexto ou pontos de corte para divisão em blocos ajustados no Opus 5 não precisam ser recalibrados no Opus 5.5.
Quando vale a pena migrar?
Para reduzir custos, migre para o Opus 5.5 assim que corrigir os dois formatos de requisição descritos acima. Mesmo desconsiderando a redução de preço, obter a mesma precisão com custo 56% menor em tarefas de uma chamada e 22% menor em um loop de ferramentas não é uma diferença pequena. Comparar as configurações padrão é também o cenário que a maioria das implantações encontrará na prática.
Reajuste o esforço em vez de reaproveitar a configuração anterior. O padrão mudou de high para medium, e o controle agora cobre uma faixa quatro vezes maior que no Opus 5. O melhor nível depende do formato da carga: low foi o mais barato e preciso nas tarefas de uma chamada, enquanto a configuração padrão superou tanto low quanto max no loop de ferramentas.
Perguntas frequentes
O Claude Opus 5.5 é realmente 40% mais barato que o Opus 5? Na fatura, chega perto. Em nosso loop de ferramentas, o Opus 5.5 custou 37% menos por execução que o Opus 5, além de custar 65% menos por tarefa de uma chamada. Vinte pontos percentuais vêm da tabela de preços mais baixa e independem do comportamento do modelo. Descontando essa parte, o ganho de eficiência é de 22% no loop e 56% nas tarefas de uma chamada.
Ainda posso desativar o thinking no Opus 5.5?
Não. thinking: {"type": "disabled"} e limites manuais de tokens retornam 400 no Opus 5.5. Use output_config.effort, cuja configuração mais barata é low. Os tokens de thinking são cobrados como saída em todos os níveis.
O que substitui o uso forçado de ferramentas?
Mantenha tool_choice: {"type": "auto"} e deixe explícito no prompt quando a ferramenta deve ser usada. Quando precisar de JSON válido conforme o schema, use schemas estritos de ferramentas ou saídas estruturadas. No Opus 5.5, as formas any e ferramenta pelo nome são rejeitadas com erro 400, em vez de sofrerem um downgrade silencioso. O resultado é uma requisição com falha, não uma resposta incorreta.
Preciso medir novamente o tamanho dos meus prompts? Não. Textos idênticos geraram as mesmas contagens de tokens no Opus 5 e no Opus 5.5 em prosa, código, JSON e chinês. Os limites de contexto continuam válidos sem alterações.
O Opus 5.5 substitui o Fable 5.1? Na tabela de benchmarks da Anthropic, o Opus 5.5 supera o Fable 5.1 em todos os benchmarks listados, custando 40% do preço por token. A Anthropic ainda posiciona o Fable 5.1 para raciocínio exigente e trabalho de agentes com horizontes longos. A empresa também afirma que a diferença no mundo real é menor do que as pontuações sugerem. A resposta mais confiável é executar novamente suas próprias avaliações, não decidir apenas pela tabela.
Medições relacionadas: Claude Opus 5 vs Opus 4.8, a escala de esforço do GPT-6 Astra e controles de thinking entre fornecedores.
Medido em 2026-09-23, um dia após o lançamento, por meio de um gateway para a API do Claude e uma interface compatível com OpenAI. Foram 468 chamadas avaliadas de uma única etapa, com 13 tarefas cujas respostas foram obtidas localmente por força bruta, 3 repetições, 6 configurações de esforço e 2 modelos, além de 48 execuções em loop de ferramentas, com 4 perguntas de várias etapas, 3 repetições e 4 configurações. Os prompts receberam valores aleatórios exclusivos. Cada modelo foi acessado pela interface compatível com seu parâmetro de esforço. Os custos foram calculados com os preços de tabela da Anthropic, em vez de serem lidos das respostas.