
프롬프트 A/B 테스트: 10% 배포로 발견한 1.9x 비용
세션 단위로 운영 트래픽의 10%를 새 프롬프트 버전에 배분하도록 설정했습니다. 측정 결과 200개 세션 중 8.0%가 새 버전을 사용했고, 모든 세션이 한 버전을 유지했으며, 호출당 비용은 1.94배였습니다. 실제 배분율은 목표보다 2.0%포인트 낮았습니다.
추천 모델
실시간 가격| 모델 | 평가 | 가격 |
|---|---|---|
| GPT-6 Luna support-answer의 v1은 롤아웃 중 1,272회 호출에서 호출당 $0.000110의 비용이 들었고, 지연 시간 중앙값은 4.9초였습니다. reasoning_effort를 none으로 설정했을 때 비용은 $0.000034였습니다. | 데모의 프로덕션 버전 | $0.1/100만부터 |
| DeepSeek V4.1 Flash 이 모델에 동일한 프롬프트를 적용한 v3은 더 빠르게 응답했지만(중앙값 3.1초), 호출당 비용은 $0.000213로 v1의 1.94배였습니다. 토큰당 가격이 더 높은 데다 출력 토큰을 1.6배 생성했기 때문입니다. | 데모의 후보 버전 | $0.3/100만부터 |
목차
프롬프트 점진 배포는 같은 프롬프트 ID로 들어오는 호출 중 일부만 후보 버전으로 보내고, 나머지는 기존 운영 버전으로 처리하는 방식입니다. 전체를 전환하기 전에 실제 트래픽으로 두 버전을 비교할 수 있습니다. Synthorai 프롬프트 라이브러리에서는 production 레이블에 “v1, v3는 10%“처럼 설정합니다. 게이트웨이는 세션 ID를 기준으로 각 호출의 버전을 결정하므로 대화 도중 버전이 바뀌지 않습니다. 이번 실행에서는 비율을 10%로 설정했을 때 200개 세션 중 16개(8.0%)가 후보 버전으로 배정됐고, 모든 세션이 같은 버전을 유지했습니다. 후보 버전은 프롬프트를 다른 모델로 옮긴 것이었지만, 그에 따른 비용은 아직 측정하지 않은 상태였습니다. 10% 배포 단계의 버전별 집계만으로도 후보 버전의 호출당 비용이 1.92배라는 사실을 확인할 수 있었습니다.
TL;DR
- 10% 배포에서는 200개 세션 중 16개(8.0%, 95% 구간 5.0-12.6%)가 후보 버전을 사용했습니다. 50%에서는 200개 중 111개(55.5%)였습니다.
- 3턴으로 구성된 400개 세션 모두 같은 프롬프트 버전을 유지했습니다.
_user, 요청 본문의user또는safety_identifier로 식별한 최종 사용자도 모두 같은 버전을 유지했습니다. - 후보 버전은 같은 프롬프트를 GPT-6 Luna 대신 DeepSeek V4.1 Flash에서 실행했습니다. 호출당 비용은 $0.000110에서 $0.000213으로 늘었고, 지연 시간 중앙값은 4.9 s에서 3.1 s로 줄었습니다.
prompt_version=1로 고정한 호출은 후보 버전으로 가지 않았습니다. 40개 중 0개였습니다.
이 글은 두 프롬프트와 각 버전을 설정하는 프롬프트 버전 관리에서 이어집니다. github.com/synthorai-io/use-cases의 같은 디렉터리에서 실행합니다.
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
점진 배포는 2026년 10월 19일에 실행했으며, 총 1,840회를 호출했습니다. 최종 사용자별 배정 검증은 10월 20일에 실행했습니다. 운영 버전은 GPT-6 Luna를 사용하는 support-answer의 v1입니다. 후보 버전은 v3로, 시스템 텍스트와 메시지는 그대로 두고 DeepSeek V4.1 Flash를 사용합니다. 바뀐 것은 모델뿐입니다.
운영 트래픽의 10%를 새 버전으로 보내려면?
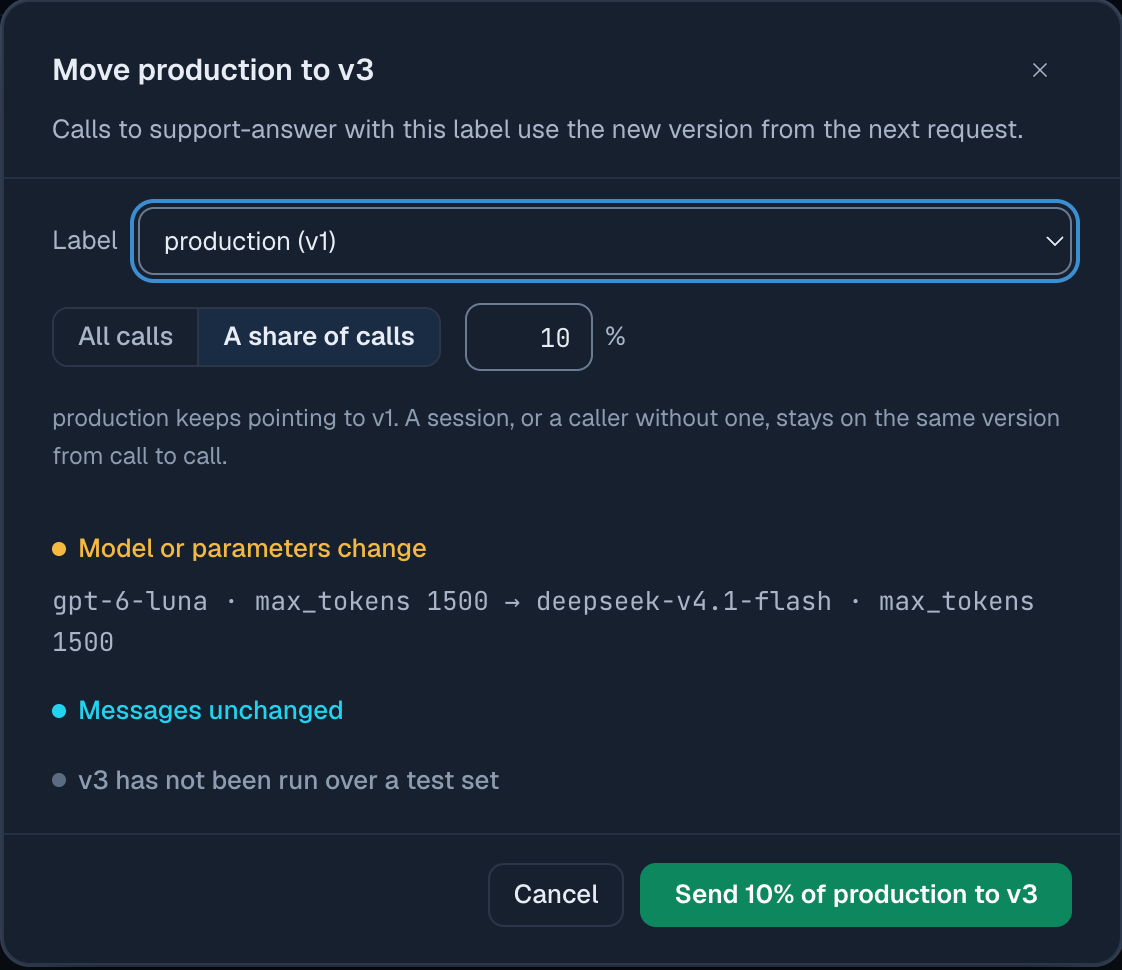
production 레이블에 두 번째 버전과 배정 비율을 지정합니다. 관리자 키가 있으면 API 호출 한 번으로 설정하고, 다른 호출로 중단할 수 있습니다.
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
호출하는 쪽은 바꿀 것이 없습니다. 버전을 지정하지 않고 계속 support-answer를 호출하면 됩니다. 각 호출을 처리한 버전은 응답 헤더 X-Synthorai-Prompt-Version에 표시됩니다. 후보 버전을 정식으로 배포하려면 production을 해당 버전으로 옮깁니다. 그러면 점진 배포가 끝납니다. 콘솔에서는 후보 버전 페이지의 “점진 배포”로 같은 설정을 할 수 있으며, 프롬프트 목록에는 레이블이 “production v1 · v3 10%“로 표시됩니다.
어떤 호출이 후보 버전으로 가나요?
게이트웨이는 각 호출에서 일관된 키를 얻어 버전을 선택합니다. 배정 비율이 같으면 같은 키는 항상 같은 버전으로 갑니다. 호출에 포함된 값 중 다음 순서로 처음 발견한 값을 키로 사용합니다.
- 세션 ID(
X-Session-Id, LLM 에이전트 추적에서 사용하는 헤더). - 최종 사용자:
X-Synthorai-Metadata의_user레이블을 우선 사용하고, 없으면 요청 본문의user,safety_identifier, Anthropic의metadata.user_id순으로 사용합니다. - 모두 없으면 요청 자체를 사용하므로 호출마다 개별적으로 버전을 선택합니다.
rollout.py는 10%와 50%에서 각 경우를 검증했습니다. 세션 하나는 3턴, 최종 사용자 한 명은 2회 호출로 구성했습니다.
| 호출 | 10% 설정: v3 배정 | 50% 설정: v3 배정 | 같은 버전 유지 |
|---|---|---|---|
세션 200개, X-Session-Id | 16 = 8.0% (5.0-12.6%) | 111 = 55.5% (48.6-62.2%) | 400개 세션 중 400개 |
최종 사용자 50명, _user 레이블 | 6 | 27 | 100명 중 100명 |
| 둘 다 없는 호출 100개 | 11 = 11.0% (6.3-18.6%) | 49 = 49.0% (39.4-58.7%) | 해당 없음 |
prompt_version=1로 고정한 호출 20개 | 0 | 0 |
괄호 안의 범위는 95% 신뢰구간입니다. 해당 시행 횟수에서 실제 배정 비율이 있을 것으로 추정하는 범위이며, 모든 구간에 설정한 비율이 포함됐습니다. 별도로 50% 설정에서 요청 본문의 두 필드도 검증했습니다. 본문의 user만으로 식별한 사용자 50명과 safety_identifier만으로 식별한 사용자 20명이 각각 2회씩 호출했습니다. 70명 모두 같은 버전을 유지했고, 50명 중 25명과 20명 중 8명이 v3에 배정됐습니다.
실제 배포에서는 두 가지를 챙기면 됩니다. 여러 턴으로 이어지는 대화를 일관되게 처리하려면 대화의 모든 호출에 세션 ID를 보내야 합니다. 키가 하나도 없으면 같은 사용자라도 첫 호출은 v1, 다음 호출은 v3로 갈 수 있습니다. 또 prompt_version으로 버전을 지정한 호출은 점진 배포 대상이 아닙니다. 버전을 고정한 테스트나 배치 작업은 계속 지정한 버전으로 처리됩니다.
두 버전은 어떻게 비교하나요?
Prompts 페이지는 버전별 호출 수, 오류 수, 비용, 토큰 수, 지연 시간을 집계합니다. Requests API에서도 prompt_id와 prompt_version 필터로 같은 수치를 조회할 수 있습니다. 데모에서는 점진 배포를 마친 뒤 이 값을 조회했습니다.
| 버전 | 요청 수 | 비용 | 호출당 비용 | 지연 시간 중앙값 | 호출당 출력 토큰 평균 | 호출당 추론 토큰 평균 |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3, DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
추론 토큰은 모델이 답변 전에 생각하는 과정에서 생성하는 토큰입니다. 출력 토큰으로 과금되지만 답변에는 표시되지 않습니다.
프롬프트의 Calls 탭에서도 같은 유형의 집계를 볼 수 있습니다. 7일 기준으로 보면 점진 배포 중의 호출뿐 아니라 각 버전으로 실행한 모든 데모 호출이 포함되므로 위 표보다 수치가 큽니다.
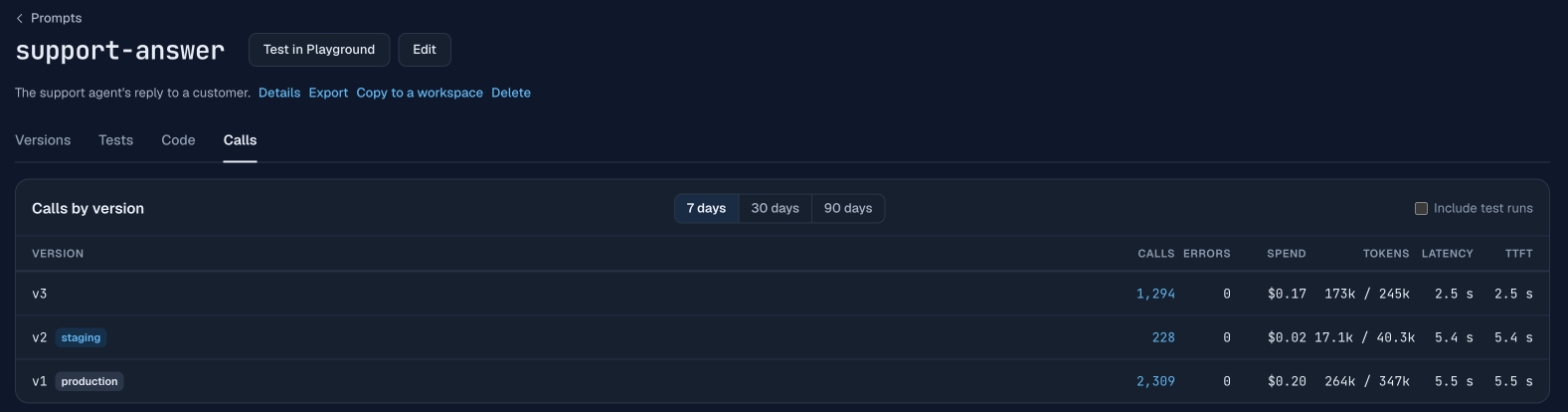
전체 실행에서 v3는 더 빨랐지만 호출당 비용은 1.94배였습니다. 이유는 두 가지입니다. 이 게이트웨이에서 DeepSeek V4.1 Flash의 토큰 단가가 GPT-6 Luna보다 높습니다. 비혼잡 시간대 기준 100만 토큰당 입력 $0.15, 출력 $0.60이며, GPT-6 Luna는 각각 $0.10, $0.50입니다. 또 v3는 출력 토큰을 1.6배 생성했고, 차이의 거의 전부가 추론 토큰이었습니다. 호출당 추론 토큰은 256개 대 149개였지만, 실제 답변은 중앙값 기준 65개와 48개였습니다. 이 수치들은 프롬프트 텍스트만으로는 알 수 없습니다. 10% 배포 단계에서도 이미 차이가 드러났습니다. v3가 처리한 71회 호출은 호출당 $0.000212, v1이 처리한 749회 호출은 $0.000111로, 1.92배 차이였습니다.
가격은 시간대에 따라서도 달라집니다. 점진 배포 중 DeepSeek 호출은 모두 이 모델에 적용되는 게이트웨이의 비혼잡 시간대(베이징 시간 22:00-08:00)에 실행됐습니다. 요금은 혼잡 시간대 단가인 $0.30과 $1.20의 절반이었습니다. 10월 20일의 140회 호출은 혼잡 시간대에 실행됐습니다. 이때 v3는 66회 호출에서 호출당 $0.000394, v1은 74회 호출에서 $0.000107로, v3가 3.7배 비쌌습니다.
1,840회 호출 중 1,839회가 200을 반환했습니다. 1회는 클라이언트에서 300 s 후 타임아웃이 발생해 오류로 집계했습니다. 해당 세션의 나머지 턴은 정상적으로 처리됐습니다.
추론을 끄면 결과가 달라지나요?
두 버전 모두 비용이 3분의 2 이상 줄지만, 그래도 v3가 더 저렴해지지는 않습니다. effort.py는 각 버전을 reasoning_effort 없이 50회, 호출자가 reasoning_effort: "none"을 보내는 방식으로 50회 호출했습니다. 입력은 배포 전 프롬프트 테스트의 테스트 세트에 있는 고객 메시지를 사용했습니다. 모든 메시지에 주문 번호가 포함돼 있으며, 총 40개 메시지 중 10개는 두 번씩 사용했습니다.
| 버전 | reasoning_effort | 호출당 비용 | 출력 토큰 평균 | 지연 시간 중앙값 | 답변에 주문 번호 포함 | 질문에 답했다고 판정 |
|---|---|---|---|---|---|---|
| v1, GPT-6 Luna | default | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1, GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3, DeepSeek V4.1 Flash | default | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3, DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
“none”을 설정하면 두 모델 모두 추론 토큰이 전혀 생성되지 않았고, 호출당 비용은 v1에서 68%, v3에서 75% 줄었습니다. 50회 호출로 확인할 수 있는 범위에서는 답변 품질도 유지됐습니다. 모든 답변에 여전히 주문 번호가 포함됐습니다. 답변이 고객 질문에 답했는지 Claude Sonnet 5.5 호출로 판정한 결과는 50개 중 각각 2개와 4개 차이가 났고, Fisher의 정확 검정에서 p = 0.82와 0.44가 나왔습니다. Fisher의 정확 검정은 “none”이 영향을 주지 않는다는 가정에서 이 정도 이상의 차이가 나타날 확률을 구합니다. 이처럼 값이 높으면 관측된 변화는 우연으로 설명할 수 있는 범위입니다. 두 버전 모두 “none”으로 설정해도 v3의 호출당 비용은 v1의 1.44배였습니다($0.000049 대 $0.000034). 이 호출들도 DeepSeek에 적용되는 게이트웨이의 비혼잡 시간대에 실행됐습니다.
점진 배포 중에는 호출자가 어느 버전이 응답할지 알 수 없으므로, 호출자가 보낸 reasoning_effort는 두 버전 모두에 적용됩니다. 대신 버전에 설정을 저장할 수도 있습니다. 버전에 reasoning_effort를 저장해 두면 호출에서 추론 설정을 직접 지정하지 않았을 때 게이트웨이가 Chat Completions와 Responses 요청에 그 값을 넣습니다. 이렇게 저장한 후보 버전은 점진 배포에서도 자체 설정을 사용하므로, 버전별 집계로 실제 배포될 상태 그대로 비교할 수 있습니다.
테스트 실행이 비교 결과에 영향을 주나요?
기본적으로는 영향을 주지 않습니다. Prompts 페이지의 버전별 집계는 테스트 트래픽을 제외합니다. 여기에는 콘솔의 테스트 실행을 포함한 Playground 호출과, X-Synthorai-Metadata에 source: prompt-test 또는 source: eval이 붙은 호출이 해당합니다. “테스트 실행 포함” 옵션을 켜면 이 호출들도 집계합니다. support-answer에서 이 옵션을 켰을 때 v1과 v2에 각각 150회가 추가됐습니다. 레이블을 붙인 평가 실행이 각각 110회, 콘솔 테스트 실행이 각각 40회였으며, v3는 변하지 않았습니다. 로그와 Requests API에는 여전히 모든 호출이 표시됩니다. 점진 배포 중 평가를 실행했다면 여기서는 레이블로 필터링해야 합니다.
X-Synthorai-Metadata: {"source":"eval"}이번 검증에서 다루지 않은 것은?
- 비용과 지연 시간에 대한 통계 검정. 위 버전별 표는 합계와 평균을 비교한 것이며, 차이에 대한 검정은 하지 않았습니다. 차이를 근거로 조치하기 전에는 검정이 필요합니다. 특히 차이가 작을 때는 더 그렇습니다.
- 실제 트래픽에서의 답변 품질. 점진 배포로는 버전의 비용과 속도를 알 수 있습니다. 답변이 맞는지는 배포 전에 고정된 입력 세트로 확인하는 편이 쉽습니다. 배포 전 프롬프트 테스트에서는 v2를 이렇게 검증합니다.
- 자동 중단. 이 데모에는 후보 버전의 오류율이나 비용이 한도를 넘었을 때 배포를 중단하는 기능이 없습니다. 관리자가 비율을 바꾸거나, 레이블을 후보 버전으로 옮기거나, 점진 배포를 중단해야 합니다.
FAQ
운영 환경에서 프롬프트를 A/B 테스트하려면 어떻게 하나요?
운영 레이블에 후보 버전과 배정 비율을 지정하고, 기존처럼 프롬프트 ID로 호출하면서 두 버전의 집계를 비교합니다. 데모에서는 10% 설정으로 200개 세션 중 16개가 후보 버전으로 갔으며, 수백 회 호출 후 집계에서 비용 차이를 확인했습니다.
점진 배포 중에도 대화마다 같은 버전을 유지하나요?
호출에 세션 ID가 있으면 같은 대화는 같은 버전을 유지합니다. 데모의 400개 세션 모두 3턴 내내 같은 버전을 사용했습니다. 세션 ID가 없으면 최종 사용자 식별자를 사용하고, 둘 다 없으면 호출마다 개별적으로 선택합니다.
텍스트를 바꾸지 않아도 프롬프트 변경으로 비용이 늘 수 있나요?
같은 텍스트라도 모델을 바꾸면 그럴 수 있습니다. 데모에서도 그랬습니다. DeepSeek V4.1 Flash를 쓰는 후보 버전의 호출당 비용은 GPT-6 Luna 버전의 1.94배였습니다. 이 게이트웨이에서 토큰 단가가 더 높았고, 추론에도 더 많은 토큰을 썼기 때문입니다. 모델의 단가가 아니라 버전 전체의 호출당 비용을 비교해야 합니다.
함께 읽기
- 프롬프트 버전 관리: 프롬프트 ID로 호출하고 레이블을 옮기는 방법.
- 배포 전 프롬프트 테스트: 테스트 세트와 검증 항목을 사용한 v2와 v1 비교.
- LLM 에이전트 비용이 높은 이유: 추적 데이터에서 찾은 높은 비용의 다른 원인 4가지.
- 프롬프트 라이브러리 가이드: 점진 배포, 버전별 통계, 전체 필드 설명.