
HTTP 헤더 3개로 LLM 에이전트 추적하기, 추적 SDK 없이
에이전트의 모델 호출에 요청 헤더 3개를 추가하면 각 실행을 워터폴 형태로 확인할 수 있습니다. 실행별로 병렬 호출이 어떻게 이루어졌는지, 자체 코드에서 시간이 얼마나 소요됐는지 살펴보고 실패한 모델 호출과 호출 비용도 함께 확인합니다.
추천 모델
실시간 가격| 모델 | 평가 | 가격 |
|---|---|---|
| GPT-6 Luna 데모의 함수 호출 루프를 처리합니다. 이 페이지에 표시된 실행에서 턴당 두 번의 호출(계획 및 응답)에 든 비용은 총 $0.0002입니다. | 데모의 메인 에이전트 | $0.1/100만부터 |
| DeepSeek V4.1 Flash 추론을 끈 상태에서 한 문장으로 된 세 가지 검사를 병렬로 실행합니다. 이 페이지에 표시된 세션에서 여섯 번의 호출에 든 비용은 $0.0004이며, 일곱 번째 하위 에이전트 호출은 $0의 비용으로 실패했습니다. | 데모의 하위 에이전트 | $0.3/100만부터 |
목차
- 트레이스를 보려면 무엇을 보내야 하나?
- 데모 에이전트는 무엇을 하나?
- 워터폴은 어떻게 읽나?
- 세션에서는 트레이스 외에 무엇을 볼 수 있나?
- 기능별 또는 사용자별 비용은 어떻게 나누나?
- 호출이 실패하면 어떻게 되나?
- 코드에서 호출별 비용은 어떻게 가져오나?
- 에이전트가 이미 추적 헤더를 보내고 있다면?
- 트레이스를 확보한 뒤에는 무엇을 하나?
- 이 데모에서 다루지 않는 것은?
- FAQ
- LLM 에이전트를 추적하려면 OpenTelemetry가 필요한가?
- 트레이스와 세션은 어떻게 다른가?
- 추적 헤더가 라우팅, 청구, 모델에 전달되는 내용을 바꾸나?
- 트레이스는 얼마나 보관되나?
- 실패한 호출에도 비용이 드나?
- 관련 글
메시지 하나에 답하려고 모델을 다섯 번 호출하는 에이전트는 단순한 요청 로그만으로 디버깅하기 어렵다. 어떤 호출이 같은 실행에 속하는지, 어떤 호출이 병렬로 실행됐는지, 대기 시간 중 자체 코드에서 쓴 시간은 얼마인지 알 수 없기 때문이다. 이 글에서는 작은 고객 지원 에이전트에 요청 헤더 3개를 추가한다. 결과는 Synthorai 콘솔에서 트레이스(한 번의 실행을 타임라인으로 표시)와 세션(한 대화와 그 비용)으로 확인한다. 추적 SDK를 설치하거나 수집기(트레이스를 받는 별도 서비스)를 실행할 필요는 없다. 소스는 github.com/synthorai-io/use-cases의 agent-tracing/에 있다. Python 3.10 이상과 콘솔에서 발급한 API 키가 필요하다.
TL;DR
- 각 모델 호출에 요청 헤더 3개(
X-Trace-Id,X-Span-Id,X-Session-Id)를 넣으면 Synthorai 콘솔에서 요청 로그를 트레이스와 세션으로 볼 수 있다. 추적 SDK는 필요 없다. - 데모 트레이스의 전체 경과 시간 8.5 s 중 약 7.0 s는 모델 호출에, 1.6 s는 에이전트 자체 코드와 네트워크 등 호출 외부에 쓰였다.
- 404로 실패한 호출도 트레이스에 남았으며 비용은 $0였다.
- 모델 호출 21회로 구성된 데모 실행의 비용은 $0.0017이었다.
git clone https://github.com/synthorai-io/use-cases
cd use-cases
cp .env.example .env    # put your API key in it
cd agent-tracing
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
python run.py --fail
2026년 10월 11일에 실행했을 때, 1분 안에 모델 호출 21회가 끝났고 비용은 $0.0017이었다. 실행 결과로 세션 ID 2개와 트레이스 ID 4개가 출력된다. 콘솔의 트레이스를 열면 같은 ID가 목록에 표시된다. 콘솔은 브라우저의 시간대를 사용하므로 이 글의 스크린샷에서 11:24 UTC는 19:24로 표시된다.
트레이스를 보려면 무엇을 보내야 하나?
모델을 호출할 때마다 헤더 3개를 보낸다. 값은 원하는 문자열로 정하면 된다. 게이트웨이는 이미 모든 요청을 기록하고 있다. 헤더는 어떤 요청들을 하나로 묶을지만 알려준다.
| 헤더 | 같은 값을 보내는 범위 | 결과 |
|---|---|---|
X-Trace-Id | 한 번의 실행에 속한 모든 호출(사용자 메시지 하나를 처음부터 끝까지 처리) | 호출들을 하나의 워터폴로 표시 |
X-Span-Id | 호출 하나에만 사용 | 워터폴에서 해당 호출의 행 이름 |
X-Session-Id | 한 대화에 속한 모든 호출 | 실행들을 묶고 대화 전체의 합계를 표시 |
스팬은 트레이스 안의 한 단계다. 이 글에서는 스팬 하나가 모델 호출 하나에 해당한다. 각 ID에는 출력 가능한 ASCII 문자를 최대 128개까지 사용할 수 있다. 게이트웨이는 응답에 ID를 돌려주며 모델 제공업체에는 전달하지 않는다.
선택적으로 사용할 수 있는 헤더가 3개 더 있다. X-Agent-Id는 호출한 하위 에이전트를, X-Parent-Agent-Id는 그 하위 에이전트를 시작한 에이전트를 나타낸다. X-Synthorai-Metadata에는 기능이나 최종 사용자 등의 라벨을 넣는다. 전체 헤더는 요청 헤더 레퍼런스에서 확인할 수 있다. 데모는 X-Agent-Id와 라벨을 보내지만 X-Parent-Agent-Id는 보내지 않는다. 하위 에이전트가 하나뿐이고 메인 에이전트가 직접 시작하므로 중첩 관계를 표현할 필요가 없다.
데모에서는 함수 하나가 호출에 넣을 헤더를 만든다. 이 함수가 추적 계층의 전부다.
@dataclass
class Run:
    """One agent run, which the gateway shows as one trace."""
    session_id: str
    labels: dict = field(default_factory=dict)
    trace_id: str = field(default_factory=lambda: new_id("trace"))

    def headers(self, span: str, agent: str | None = None, parent: str | None = None) -> dict:
        h = {
            "X-Session-Id": self.session_id,
            "X-Trace-Id": self.trace_id,
            "X-Span-Id": span,
        }
        if agent:
            # Only sub-agents need an id. Calls without one belong to the main agent.
            h["X-Agent-Id"] = agent
        if parent:
            h["X-Parent-Agent-Id"] = parent
        if self.labels:
            h["X-Synthorai-Metadata"] = json.dumps(self.labels, separators=(",", ":"))
        return h
에이전트의 모든 모델 호출은 이 헤더를 붙이는 래퍼 하나를 거친다. OpenAI Python SDK에서는 요청별 헤더를 extra_headers에 넣는다.
raw = await client.chat.completions.with_raw_response.create(
    model=model, messages=messages,
    extra_headers=run.headers(span, agent, parent), **kwargs)
resp = raw.parse()
request_id = raw.headers.get("x-request-id") # the gateway's id for this callwith_raw_response는 응답 헤더를 읽기 위해서만 사용한다. 요청 ID가 필요 없다면 일반적인 create(..., extra_headers=...) 호출로 충분하다.
데모 에이전트는 무엇을 하나?
고객 메시지에 답하는 과정은 4단계이며 모델을 5번 호출한다. 트레이스에서 확인할 내용이 있도록 구성했다. 메인 에이전트는 GPT-6 Luna, 하위 에이전트는 DeepSeek V4.1 Flash를 사용한다. 두 모델 모두 환경 변수로 설정한다. 하위 에이전트 호출에는 reasoning_effort="none"을 지정한다. 한 문장으로 점검 결과를 내는 작업에 사전 추론은 필요하지 않기 때문이다. 이 값을 지원하지 않는 모델로 바꾸면 ANALYST_REASONING을 수정하거나 비워야 한다.
| 스팬 | 실행 주체 | 동작 |
|---|---|---|
plan | 메인 에이전트 | 메시지를 읽고 도구 호출을 요청한다(function calling: 모델이 함수 이름과 인수를 반환하면 자체 코드가 실행) |
| 없음 | 자체 코드 | 로컬 도구 2개를 병렬로 실행한다. 주문 조회(1.2 s)와 정책 검색(0.6 s) |
sentiment, policy-check, risk | 하위 에이전트 analyst | 한 문장으로 답하는 점검 3개를 동시에 요청한다 |
answer | 메인 에이전트 | 도구 결과와 점검 결과 3개를 바탕으로 답변을 작성한다 |
도구는 sleep이 들어 있는 단순한 Python 함수다. 데이터베이스와 검색 인덱스를 대신한다. --fail을 지정하면 policy-check 호출 하나가 먼저 존재하지 않는 모델을 요청해 404를 받는다. 이후 policy-check.retry라는 스팬 이름으로 재시도한다.
run.py는 각각 2턴으로 구성된 대화 2개를 실행한다. 대화마다 세션 ID 하나를 사용하고, 턴마다 새 트레이스 ID를 만든다.
session_id, history = new_id("support"), []
for text in turns:
    run = Run(session_id, labels={"feature": "support-agent", "release": "v2", "_user": user})
    reply = await handle(run, history, text)
워터폴은 어떻게 읽나?
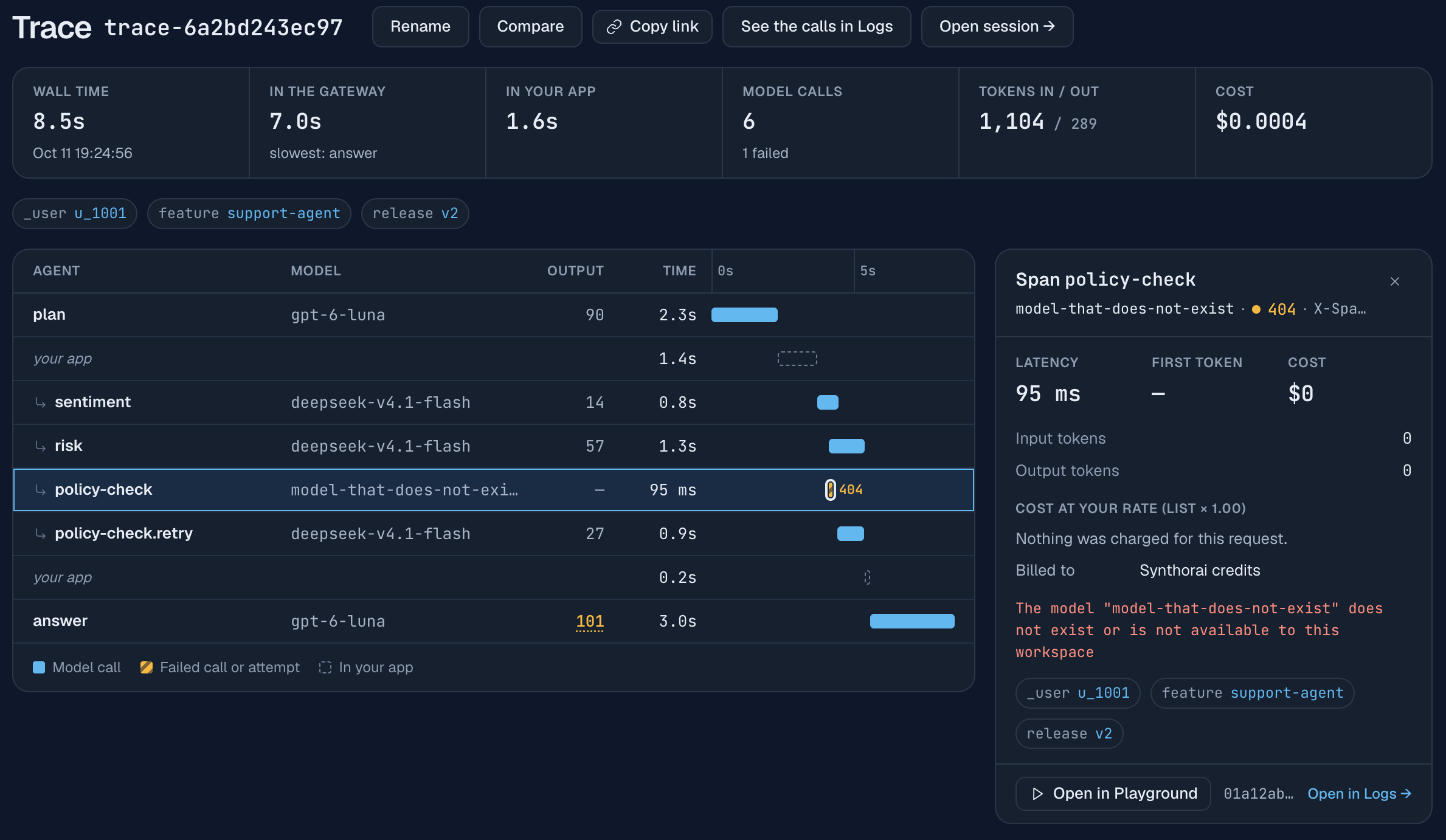
각 행은 모델 호출 하나 또는 자체 코드가 실행된 빈 구간 하나다. 시간축은 해당 실행의 첫 호출이 게이트웨이에 도착한 시점부터 시작한다. 위 스크린샷은 첫 번째 대화의 두 번째 턴이다. 위에서부터 읽으면 다음과 같다.
plan은 2.3 s가 걸렸다. 막대는 게이트웨이가 요청을 받은 시점부터 응답을 마칠 때까지 걸린 시간이다.your app은 1.4 s가 걸렸다. 이 구간에는 처리 중인 요청이 없었다. 따라서 게이트웨이 외부, 즉 자체 코드와 코드-게이트웨이 사이의 네트워크에서 쓴 시간이다. 여기서는 로컬 도구 2개가 실행됐으며, 더 느린 도구의 대기 시간은 1.2 s다. 실제 에이전트에서는 느린 데이터베이스 쿼리나 벡터 검색이 이 행에 드러난다.sentiment,risk,policy-check.retry는 서로 겹친다. 에이전트가asyncio.gather로 점검 3개를 보냈기 때문이다. 병렬 호출은 이렇게 막대가 겹쳐 표시된다. 이름 앞의 화살표는 하위 에이전트가 호출했다는 뜻이다.policy-check는404가 적힌 95 ms의 빗금 구간이다. 실패한 호출도 코드가 받은 상태 코드와 함께 트레이스에 남는다.answer는 3.0 s가 걸렸다. 가장 느린 호출이며 워터폴 위 요약에도 표시된다.- 출력 열은 각 호출의 출력 토큰 수다. 호출 시간은 출력 생성에 쓰이므로 이 열을 보면 옆 막대가 왜 길어졌는지 대체로 알 수 있다.
answer는 101토큰을 출력했고 점검 3개는 각각 14-57토큰을 출력했다. 출력량이 많고 그 대부분이 추론 토큰이면 콘솔은 토큰 수에 밑줄을 표시한다. 여기의 101도 그렇다.
요약에서는 전체 경과 시간 8.5 s를 게이트웨이의 7.0 s와 앱의 1.6 s로 나눠 보여준다. 지연 시간을 조사할 때 가장 먼저 판단할 수 있는 정보다. 모델 호출을 봐야 하는지, 자체 코드를 봐야 하는지 구분할 수 있다. 이 실행에서는 대기 시간의 82%가 모델에 쓰였다. 그중 메인 에이전트의 plan과 answer가 5.3 s를 차지하므로, 점검 3개를 빠르게 하는 것보다 메인 에이전트를 더 빠른 모델로 바꾸는 편이 효과가 크다.
게이트웨이는 자체 코드 내부를 볼 수 없다. 요청 사이의 빈 구간으로 your app 행을 추정하므로, 코드가 얼마나 오래 실행됐는지는 알 수 있어도 무엇을 했는지는 알 수 없다. 자체 함수에도 스팬이 필요하다면 개방형 추적 표준인 OpenTelemetry SDK를 사용해야 한다. 두 방식은 ID를 공유할 수 있다. X-Trace-Id를 보내지 않으면 게이트웨이는 트레이스 ID를 담는 표준 헤더인 traceparent를 읽는다.
세션에서는 트레이스 외에 무엇을 볼 수 있나?
세션은 한 대화의 실행들을 묶고 합계를 계산한다. 트레이스 목록에서 세션을 열거나, 트레이스 페이지에서 “세션 열기”를 선택하면 된다.
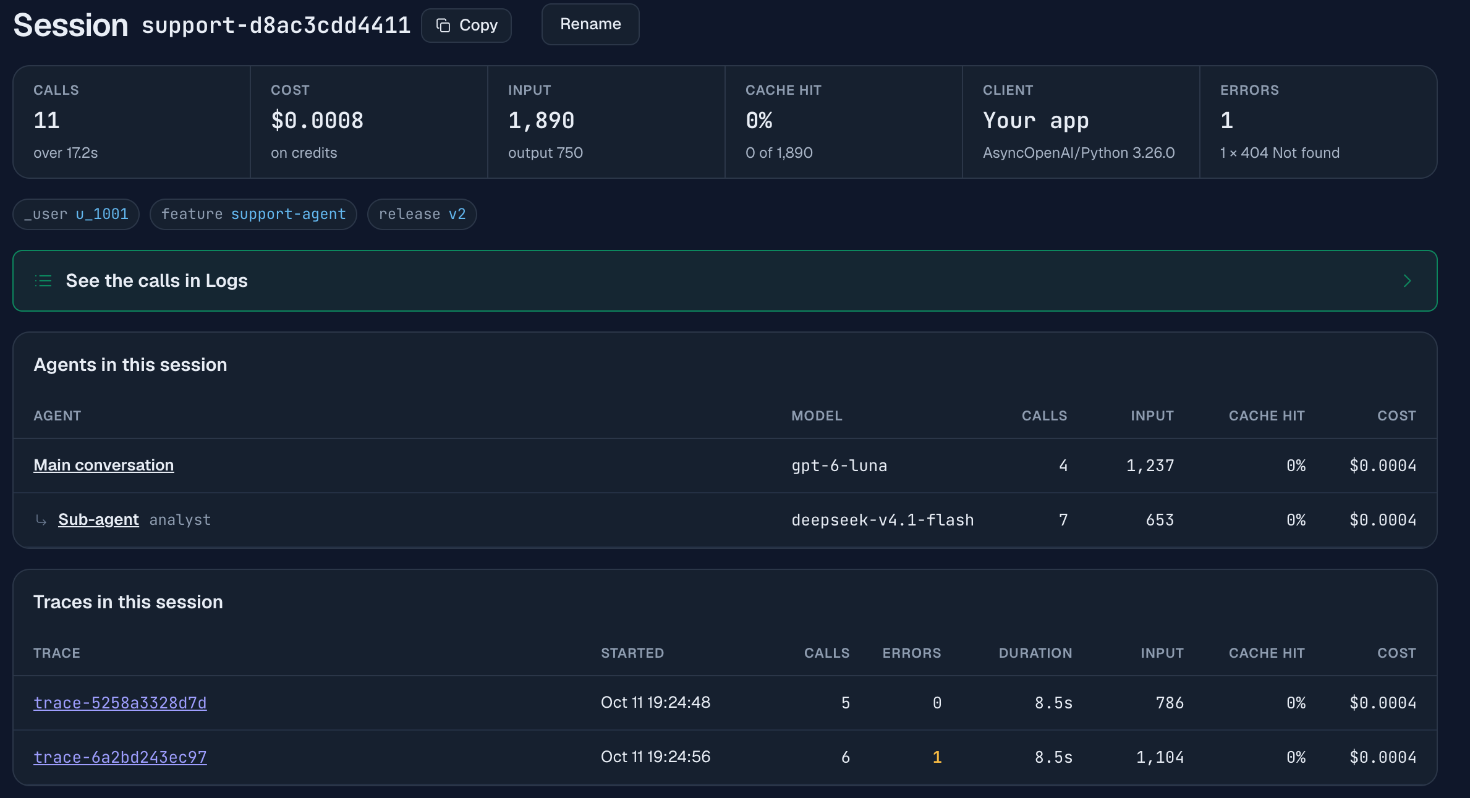
위 세션은 2턴으로 구성된 고객 대화 하나다. 호출 11회, 입력 토큰 1,890개, 출력 토큰 750개, 비용 $0.0008, 오류 1회다. 페이지는 세 부분으로 나뉜다.
- 이 세션의 에이전트 항목은 에이전트별로 호출 수와 비용을 나눈다. 메인 에이전트는 GPT-6 Luna로 4번 호출해 $0.0004를 썼고,
analyst하위 에이전트는 7번 호출해 $0.0004를 썼다. 그중 6번은 DeepSeek V4.1 Flash 호출이고 1번은 실패한 호출이다. 이 표는 하위 에이전트 호출에X-Agent-Id: analyst가 들어 있어서 표시된다. 해당 헤더가 없는 호출은 메인 대화로 집계된다. - 이 세션의 트레이스 항목은 턴별 오류, 소요 시간, 입력 토큰, 캐시 적중률, 비용을 나열한다. 긴 대화에서도 로그를 스크롤하지 않고 느리거나 실패했거나 비용이 많이 든 턴을 찾을 수 있다.
- 캐시 적중률 은 입력 토큰 중 제공업체의 프롬프트 캐시에서 읽은 비율이다. 여기서는 프롬프트 길이가 수백 토큰에 불과해 0%다. 제공업체는 최소 길이를 넘는 접두부만 캐시한다. 대부분 1,024토큰이 기준이다(프롬프트 캐싱 참고).
프롬프트가 캐시할 만큼 길어지면 세션 ID는 또 다른 역할을 한다. 한 대화의 모든 호출에 같은 X-Session-Id를 보내면 게이트웨이는 그 대화에서 프롬프트 캐시를 일관되게 활용하도록 한다. 두 번째 턴이 첫 번째 턴에서 만든 캐시를 읽을 수 있게 하는 것이다. 프레임워크에서 헤더를 설정하기 번거롭다면 /v1/chat/completions와 /v1/responses의 요청 본문에 session_id로 값을 넣어도 된다.
기능별 또는 사용자별 비용은 어떻게 나누나?
문자열 값으로만 구성된 평면 JSON 객체를 X-Synthorai-Metadata에 보내고, 이를 기준으로 그룹화하거나 필터링한다. 데모는 모든 호출에 기능, 릴리스, 최종 사용자 라벨을 붙인다.
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}라벨은 트레이스와 세션에 작은 태그로 표시된다. 합계를 보려면 분석 화면을 열고 세부 내역 탭에서 메타데이터별 비용 카드를 찾는다. 키를 선택하면 해당 키의 모든 값에 대해 요청 수, 오류 수, 입력 토큰, 비용이 표시된다.
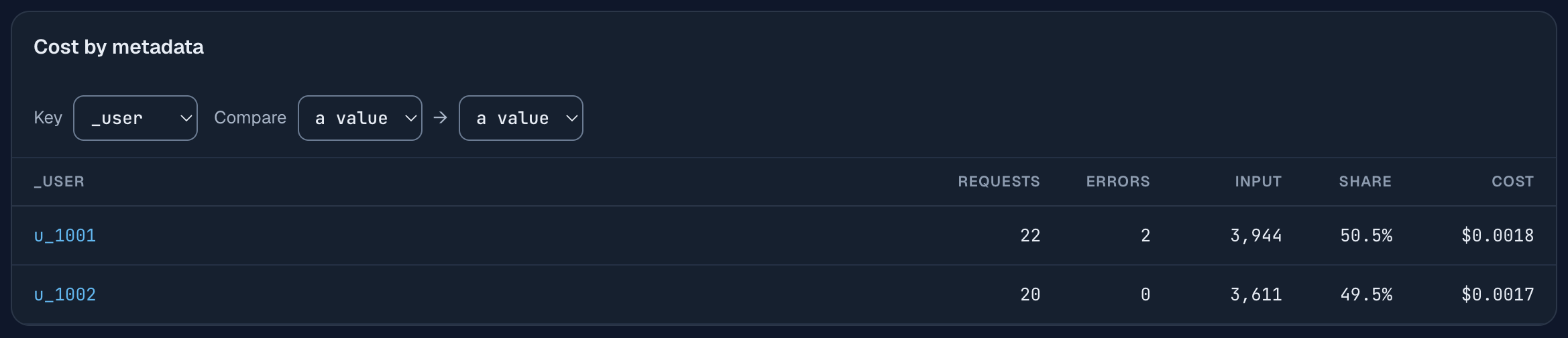
위 카드는 데모를 두 번 실행한 1시간의 집계다. 실패한 호출 2회가 포함된 u_1001은 요청 22회에 $0.0018, u_1002는 요청 20회에 $0.0017이다. 한 번 실행한 뒤에는 각각 11회와 10회로 표시된다. 기능별 비용을 보려면 feature를, 프롬프트 변경이 비용에 미친 영향을 보려면 release를 키로 선택한다. 카드에서 같은 키의 값 2개를 나란히 비교할 수도 있다. 같은 탭의 에이전트별 비용 카드는 세션 전체에 걸쳐 각 X-Agent-Id의 합계를 보여준다.
집계값에 해당하는 실행을 찾을 때도 라벨로 검색할 수 있다. 트레이스 목록의 검색창에 metadata._user = u_1002를 입력하고 Enter를 누르면 해당 사용자의 세션과 트레이스만 남는다. 로그 화면의 필터 입력란에서도 같은 식을 사용해 개별 요청을 찾을 수 있다.
라벨 규칙은 간단하다.
- 요청당 최대 10개다. 키는
a-z,0-9,_,.,-로 구성된 1-32자 문자열이다. 값은 최대 128바이트의 문자열이다. _user는 해당 요청의 최종 사용자를 나타내는 라벨이다. 밑줄로 시작하는 다른 키는 예약되어 있다.- 규칙에 맞지 않는 라벨은 제외되지만 요청은 그대로 실행된다. 응답 헤더
X-Synthorai-Metadata-Dropped에 제외된 키가 나열되므로, 설정하는 동안 이 헤더를 로그에 남기면 된다. 확인을 위해Bad?Key라는 키를 보냈더니 응답 헤더에Bad?Key가 들어 있었다. - 라벨에 프롬프트 본문, 개인정보, 비밀 정보를 넣지 않는다.
_user에는 이메일 주소 대신 내부 사용자 ID를 사용한다.
호출이 실패하면 어떻게 되나?
실패한 호출은 상태 코드가 적힌 빗금 표시로 트레이스에 남으며 비용은 들지 않는다. 데모에서 실패한 policy-check는 존재하지 않는 모델 ID를 요청했다. 워터폴에서 이 호출을 선택하면 위 스크린샷의 오른쪽 패널이 열린다. 코드가 받은 오류 The model "model-that-does-not-exist" does not exist or is not available to this workspace, 지연 시간 95 ms, 비용 $0, 청구되지 않았다는 안내가 표시된다.
데모는 재시도에 별도의 스팬 이름을 붙인다.
try:
    await call(run, span, model=BROKEN_MODEL, messages=messages, agent="analyst")
except APIStatusError:
    span = f"{span}.retry"      # the retry is its own span, so both show in the waterfall
resp = await call(run, span, model=ANALYST_MODEL, messages=messages, agent="analyst", max_tokens=400,
                  **analyst_options())   # reasoning_effort="none" unless ANALYST_REASONING says otherwise
트레이스 ID는 유지하고 스팬 이름만 바꾸면 실패와 재시도를 한 화면에서 나란히 볼 수 있다. 재시도 로직이 같은 헤더를 재사용하는 라이브러리 안에 있어도 두 시도는 모두 표시된다. 이름이 같은 행 2개가 생긴다.
오류도 상위 단위로 집계된다. 트레이스 요약에는 “모델 호출 6회, 실패 1회”가 표시되고, 세션에는 상태 코드별 오류(1 × 404 Not found)가 나온다. 트레이스 목록의 오류 열을 기준으로 정렬하면 확인이 필요한 실행을 찾을 수 있다.
코드에서 호출별 비용은 어떻게 가져오나?
응답으로 받은 요청 ID를 사용해 게이트웨이에 해당 요청의 청구 기록을 조회한다. GET /v1/generation?id=<request id>는 요청 하나의 비용, 토큰 수, 지연 시간, 상태를 반환한다.
async def cost_of(http: httpx.AsyncClient, request_id: str) -> float | None:
    """The billing record of one request. It is written a moment after the call returns."""
    if not request_id:
        return None                                  # a call that got no response has no record
    for _ in range(6):
        try:
            r = await http.get(f"{BASE_URL}/generation", params={"id": request_id})
            if r.status_code == 200:
                return r.json()["data"]["total_cost"]
        except (httpx.HTTPError, KeyError, TypeError, ValueError):
            pass                                     # a dropped connection or a half-written record: try again
        await asyncio.sleep(2)
    return None
기록은 응답이 끝난 직후 작성되므로 이 함수는 200을 받을 때까지 재시도한다. 호출자가 Authorization 헤더를 설정한 httpx.AsyncClient를 한 번 생성하고 모든 조회에 전달한다. 클라이언트 하나로 호출 20개의 기록을 조회하면 소수의 연결을 재사용한다. 조회마다 새 클라이언트를 만들면 연결 20개가 한꺼번에 열린다. 실제 실행에서는 그중 1-2개가 끊겼다. 데모는 자체 측정 시간과 이 기록을 이용해 호출마다 한 줄씩 출력한다. 다음은 스크린샷에 나온 세션의 첫 번째 턴이다.
trace trace-5258a3328d7d  session support-d8ac3cdd4411
  plan                 main     gpt-6-luna                 200   1878 ms    153 in   22 out  $0.000026
  sentiment            analyst  deepseek-v4.1-flash        200   1431 ms     91 in   28 out  $0.000061
  risk                 analyst  deepseek-v4.1-flash        200   1877 ms     96 in   33 out  $0.000068
  policy-check         analyst  deepseek-v4.1-flash        200   1885 ms     96 in   39 out  $0.000076
  answer               main     gpt-6-luna                 200   4142 ms    350 in  339 out  $0.000205
여기 표시된 시간은 클라이언트에서 측정해 네트워크 시간이 포함된다. 따라서 게이트웨이 내부의 요청 시간을 나타내는 콘솔 막대보다 길다. 위 워터폴에 나온 두 번째 턴에서 plan은 클라이언트 기준 2,499 ms, 게이트웨이 기준 2.3 s가 걸렸다. answer는 각각 3,161 ms와 3.0 s였다. 병렬로 보낸 호출은 차이가 더 클 수 있다. 실패한 호출은 클라이언트에서 694 ms, 게이트웨이에서 95 ms가 걸렸다.
호출별 청구 비용을 자체 로그에 남기려면 이 함수를 복사해 사용하면 된다. 비용을 너무 많이 쓰는 실행을 중단하는 용도로는 맞지 않는다. 기록은 호출이 끝난 뒤에 도착하고, 함수가 이를 기다리는 데 몇 초가 걸릴 수 있기 때문이다. 실시간 예산을 관리하려면 실행 중 각 응답의 usage로 직접 비용을 계산하고, 이후 이 기록으로 계산이 맞는지 확인한다.
에이전트가 이미 추적 헤더를 보내고 있다면?
추가할 것이 없을 수도 있다. 요청에 ID 3개 중 빠진 항목이 있으면 게이트웨이는 널리 쓰이는 도구가 보내는 대응 헤더를 읽는다.
| 사용 도구 | 보내는 헤더 | 해석 방식 |
|---|---|---|
| OpenTelemetry HTTP 계측 | traceparent | 트레이스, 부모 ID는 스팬으로 사용 |
| LiteLLM SDK | X-Litellm-Trace-Id, X-Litellm-Session-Id | 트레이스, 세션 |
| Langfuse SDK | baggage: langfuse_trace_id=…, langfuse_session_id=… | 트레이스, 세션 |
| Open WebUI | X-OpenWebUI-Chat-Id | 세션 |
| Claude Code | X-Claude-Code-Session-Id | 세션 |
| OpenAI Codex CLI | Session-Id | 세션 |
둘 다 있으면 직접 지정한 X-Trace-Id, X-Span-Id, X-Session-Id가 우선한다. 전체 목록은 요청 헤더 레퍼런스에 있다. 이 헤더들을 보내지 않는 에이전트 프레임워크에서는 프레임워크가 제공하는 사용자 지정 헤더 설정으로 추가해야 한다.
트레이스를 확보한 뒤에는 무엇을 하나?
가장 흔한 용도는 다른 트레이스와 비교하는 것이다. 모든 트레이스 페이지에는 비교 버튼이 있다. 두 번째 트레이스를 선택하면 콘솔이 두 트레이스를 한 페이지에 표시한다. 각 지표는 A, B, 변화량으로 나타내고, 같은 이름의 호출끼리 짝지으며, 워터폴 2개를 하나의 시간축에 놓는다. 프롬프트, 모델, 자체 코드의 변경이 실행에 어떤 영향을 줬는지 이렇게 확인한다.
다음 후속 가이드 3개는 같은 에이전트와 헤더를 사용한다. 각각 문제를 재현하고 수정한 뒤 이 방식으로 비교한다.
- LLM 에이전트가 느린 이유 순차 호출, 자체 코드의 느린 도구, 한 줄 답변에 쓰이는 추론.
- LLM 에이전트 비용이 높은 이유 캐시를 깨뜨리는 타임스탬프, 커지는 컨텍스트, 재시도 루프, 잘못 선택한 모델.
- LLM 에이전트 디버깅하기 사용자 불만에서 문제가 생긴 호출까지 추적하기.
다음 3개는 같은 로그를 다른 관점에서 살펴본다.
- Claude Code의 하위 에이전트별 비용 직접 작성하지 않은 코딩 에이전트를 같은 세션 및 에이전트 화면으로 분석하기.
- Claude에게 LLM 로그 질문하기 읽기 전용 MCP 연결을 통해 채팅창에서 이 세션들에 대한 답변 받기.
- 에이전트에 로그 도구 제공하기 같은 도구를 자체 프로그램에서 사용하고 모델 토큰 비용 확인하기.
이 데모에서 다루지 않는 것은?
데모는 모델 호출을 다룬다. 운영 환경에서는 보통 다음 4가지를 추가로 고려한다.
- 자체 코드의 스팬. 게이트웨이는 모델 호출 사이의 빈 구간을 보여주지만 그 안에서 무엇이 실행됐는지는 보여주지 않는다. OpenTelemetry로 도구, 검색, 큐를 계측하고
traceparent를 전달하면 하나의 트레이스 ID로 두 화면을 연결할 수 있다. - 프롬프트와 응답 본문. 이 글에서는 호출별 시간, 토큰, 비용 기록을 사용한다. 모델에 보낸 내용을 살펴보는 방법은 다루지 않는다.
- 예산.
cost_of는 사후에 청구 금액을 알려준다. 한도에 도달하면 실행을 중단하려면 응답이 올 때마다usage로 비용을 계산해야 한다. 에이전트 루프에 몇 줄을 추가하면 되지만 데모에는 포함하지 않았다. - 샘플링. 트레이스는 게이트웨이가 원래 보관하는 요청 로그로 만들기 때문에 모든 호출이 기록된다. 샘플링할 것은 없으며 에이전트 측 오버헤드는 헤더 몇 개뿐이다.
FAQ
LLM 에이전트를 추적하려면 OpenTelemetry가 필요한가?
필요 없다. 각 모델 호출에 요청 헤더 3개(X-Trace-Id, X-Span-Id, X-Session-Id)를 넣으면 모델 호출의 워터폴을 볼 수 있다. 호출 사이의 시간은 앱 구간으로 표시된다. 자체 함수에도 스팬이 필요할 때 OpenTelemetry가 유용하다.
트레이스와 세션은 어떻게 다른가?
트레이스는 에이전트 실행 한 번이다. 사용자 메시지 하나나 작업 하나를 처리하기 위해 수행한 모든 내용을 담는다. 세션은 여러 실행으로 구성된 대화 하나다. 데모에서는 고객 대화 하나가 트레이스 2개를 포함한 세션이며, 각 트레이스에는 모델 호출이 5회 또는 6회 있다.
추적 헤더가 라우팅, 청구, 모델에 전달되는 내용을 바꾸나?
X-Trace-Id와 X-Span-Id는 아무것도 바꾸지 않는다. X-Session-Id는 대화의 프롬프트 캐시를 일관되게 활용하도록 한다. 어떤 헤더도 모델 제공업체에 전달되지 않으며, 청구는 게이트웨이 자체 요청 ID를 기준으로 이뤄진다.
트레이스는 얼마나 보관되나?
트레이스와 세션은 요청 로그로 구성되며, 요청 로그와 동일하게 90일간 보관된다. 트레이스 목록의 기본 조회 범위는 최근 7일이다.
실패한 호출에도 비용이 드나?
데모에서 알 수 없는 모델 ID를 요청해 404로 실패한 호출은 비용 $0로 기록됐으며, 청구되지 않았다는 안내가 표시됐다.
관련 글
- LLM 챗봇 만들기: 컨텍스트 관리, 메모리, 프롬프트 캐싱을 포함한 단일 에이전트 사례.
- 요청 헤더 레퍼런스: 이 페이지의 모든 헤더와 다른 도구에서 읽어오는 별칭.
- 콘솔의 트레이스와 세션: 목록, 워터폴, 세션 페이지.
- LLM 토큰 사용량의 구성: 각 기록의 토큰 수가 무엇을 뜻하는지 제공업체별로 설명.