
LLM 에이전트 비용이 높은 이유: 트레이스에서 찾는 4가지 원인
에이전트 비용이 높아지는 4가지 원인을 각각 재현하고 수정합니다. 타임스탬프가 캐시를 깨는 사례에서 캐시 적중률을 0%에서 73%로 높인 수정 결과를 확인하고, 계속 늘어나는 컨텍스트, 반복되는 재시도 루프, 잘못된 모델 선택의 문제와 해결을 살펴봅니다.
추천 모델
실시간 가격| 모델 | 평가 | 가격 |
|---|---|---|
| GPT-6 Luna 타임스탬프를 프롬프트의 첫 줄에서 다른 위치로 옮기면, 콜드 스타트에서 네 턴에 걸친 입력 토큰 5,729개 중 4,157개를 캐시에서 읽었습니다. 타임스탬프가 첫 줄에 있으면 5,579개 중 캐시에서 읽은 토큰은 없었습니다. | 데모의 메인 에이전트 | $0.1/100만부터 |
| DeepSeek V4.1 Flash 한 문장으로 된 검사 세 건의 비용은 GPT-6.1 Sol에서 $0.0010, 이 모델에서 $0.0001였습니다. | 데모의 하위 에이전트 | $0.3/100만부터 |
목차
에이전트 비용이 늘어나는 원인은 요청 하나만 봐서는 드러나지 않습니다. 캐시에 전혀 적중하지 않는 프롬프트, 턴마다 더 많은 내용을 다시 보내는 대화, 같은 작업을 반복하는 루프, 저렴한 모델로 처리할 일을 맡은 비싼 모델이 대표적입니다. 호출을 세션과 트레이스로 묶으면 이 원인들이 분명하게 보입니다. 이 글에서는 작은 고객 지원 에이전트로 네 가지 문제를 모두 재현합니다. Synthorai 콘솔에서 각각 어디에 나타나는지 확인하고, 수정 전후 비용을 비교합니다.
TL;DR
- 프롬프트 첫 줄의 타임스탬프 때문에 캐시 적중률이 0%에 머물렀습니다. 이를 끝으로 옮기자 GPT-6 Luna의 적중률이 73%로 올라가고 입력 비용이 66% 줄었습니다.
- 모든 도구 결과를 다시 보내는 대화 기록은 입력 토큰을 세 배 사용했습니다. 하지만 71%를 캐시에서 읽었기 때문에 입력 비용은 21%만 늘었습니다.
- 재시도 루프 때문에 2번이면 될 모델 호출이 10번 발생했고, 모두 상태 코드 200을 반환했습니다.
- GPT-6.1 Sol에서 실행한 하위 에이전트 호출 3번이 한 세션 비용의 81%를 차지했습니다.
이 글은 호출을 세션과 트레이스로 묶는 요청 헤더를 설명한 LLM 에이전트 트레이싱을 바탕으로 합니다. 해당 글에 따라 데모를 준비하세요(Python 3.10 이상, virtualenv 활성화). 그런 다음 github.com/synthorai-io/use-cases의 같은 디렉터리에서 네 가지 사례와 캐시가 무효화되는 또 다른 사례인 replay-mismatch를 실행합니다.
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
각 사례는 문제가 있는 버전과 수정한 버전으로 두 번 실행하며, 호출에 case와 variant 라벨을 붙입니다. 아래 수치는 2026년 10월 11일에 각 사례를 한 번씩 실행한 결과입니다. 데모 규모가 작아 비용은 1센트에도 못 미칩니다. 실제 워크로드에서도 참고할 수 있는 것은 비용의 비율입니다.
| 사례 | 확인 위치 | 수정 전 | 수정 후 |
|---|---|---|---|
cache-miss | 세션 페이지의 턴별 캐시 적중률 | 캐시 사용 0%, $0.0015 | 콜드 스타트(캐시에 아직 아무것도 없는 상태)에서 캐시 사용 73%, $0.0011 |
context-growth | 세션 페이지에서 턴이 진행될수록 늘어나는 입력 | 입력 토큰 24,546개, 입력 비용 $0.0011 | 입력 토큰 8,053개, 입력 비용 $0.0009 |
replay-mismatch | 세션 페이지에서 0%에 머무는 캐시 적중률 | 캐시 사용 0%, $0.0038 | 캐시 사용 76%, $0.0015 |
retry-loop | 한 턴에 필요한 것보다 호출이 훨씬 많은 트레이스 | 호출 10번, $0.0004 | 호출 2번, $0.0001 |
wrong-model | 세션 페이지의 Agents 표 | $0.0012 | $0.0003 |
비용이 예상보다 높으면 어디부터 봐야 할까요?
Traces 목록을 비용순으로 정렬하는 것부터 시작합니다. 각 행에는 세션 또는 트레이스의 호출 수, 소요 시간, 비용이 표시되므로 비용이 가장 많이 든 대화가 맨 위에 나옵니다. 하나를 열면 아래에서 설명할 패턴 중 어떤 문제가 있는지 확인할 수 있습니다.
요청에 X-Synthorai-Metadata로 라벨을 붙였다면 먼저 목록의 범위를 좁히세요. Traces 목록의 검색창은 라벨 검색을 지원합니다. metadata.feature = support-agent로 검색하면 특정 기능의 세션과 트레이스만 남고, metadata.case = cache-miss로 검색하면 이 글에 나온 해당 사례의 두 실행을 찾을 수 있습니다. 합계를 보려면 Analytics의 Breakdown 탭에 있는 Cost by metadata 카드를 사용합니다. 키를 선택하면 값별 요청 수, 입력 토큰 수, 비용이 표시됩니다.
캐시 적중률이 왜 0%일까요?
요청마다 프롬프트 앞부분이 바뀌면 캐시 적중률은 0%가 됩니다. 프롬프트 캐싱을 사용하면 제공자는 반복되는 프롬프트 앞부분에 일반 입력 가격의 일부만 청구합니다. 다만 이전 요청과 처음으로 달라지는 토큰 직전까지만 캐시를 사용할 수 있습니다. 이 사례의 문제가 있는 버전은 약 1,300개 토큰으로 구성된 시스템 프롬프트의 첫 줄에 현재 시간을 넣습니다.
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
GPT-6 Luna로 4턴의 대화를 실행하면 세션 페이지에 Cache hit 0%가 표시됩니다. 입력 토큰 5,579개 중 캐시에서 읽은 토큰은 0개입니다. 수정 버전에서는 바뀌는 부분을 끝으로 옮깁니다.
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"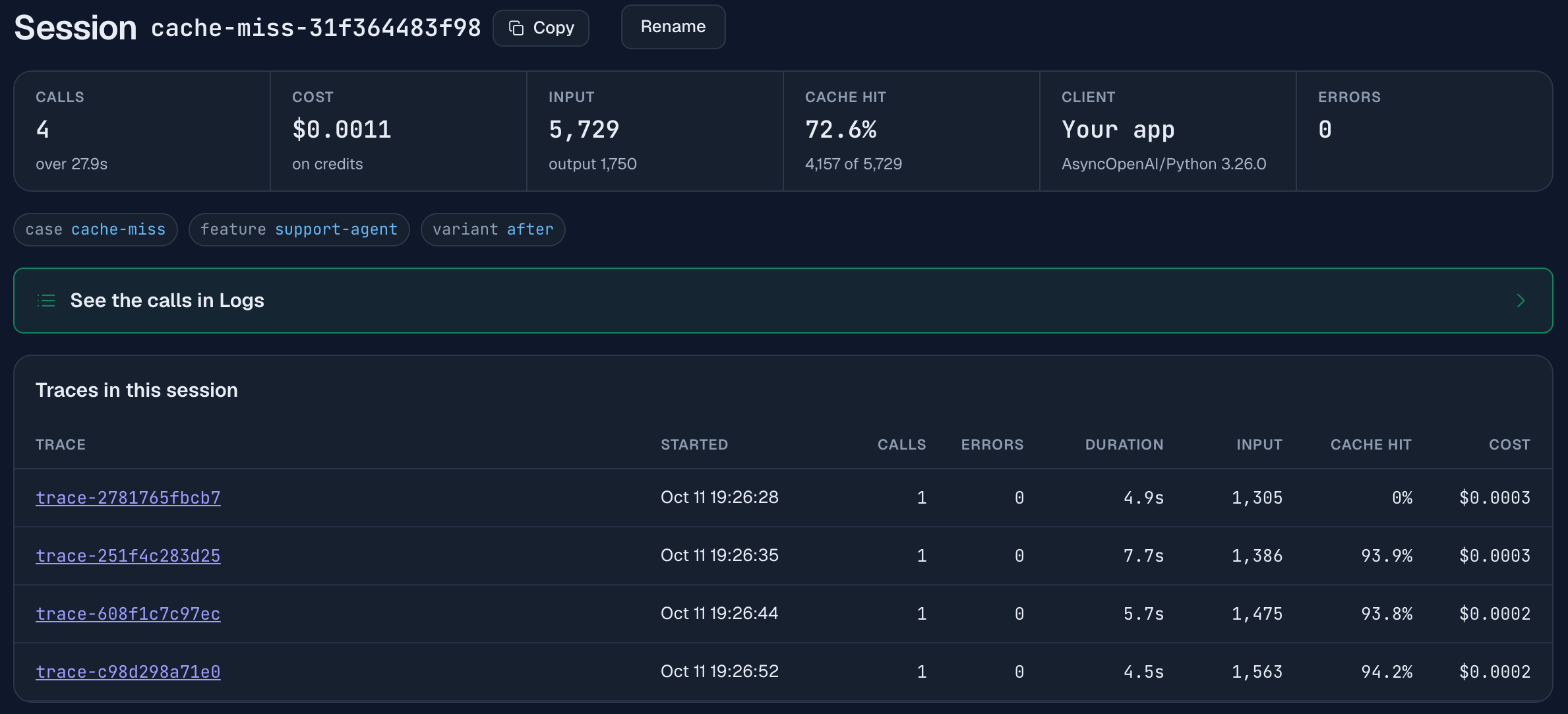
세션 페이지에는 각 턴의 입력량과 캐시 적중률이 표시되며, 첫 행은 0%입니다. 첫 턴에는 아직 어떤 요청도 캐시 항목을 쓰지 않았으므로 읽을 항목이 없습니다. 따라서 항목을 쓰기만 하고 읽지는 않습니다. 이후 세 턴은 캐시에서 각각 1,302개, 1,383개, 1,472개의 토큰을 읽습니다. 직전 턴이 보낸 내용의 거의 전부에 해당하므로 각 턴 입력의 약 94%를 캐시에서 읽습니다. 전체 대화에서는 입력 토큰 5,729개 중 4,157개, 즉 73%입니다.
비용 절감은 입력에서 발생합니다. 이 모델의 100만 토큰당 가격은 일반 입력 $0.10, 캐시 쓰기 $0.125, 캐시 읽기 $0.01입니다. 긴 프롬프트의 거의 모든 토큰은 캐시 쓰기나 읽기 중 하나로 처리됩니다.
문제가 있는 실행은 캐시에 토큰 5,567개를 쓰고 하나도 읽지 않았습니다. 수정한 실행은 1,560개를 쓰고 4,157개를 읽었습니다. 입력 비용은 $0.00070에서 $0.00024로 66% 줄었습니다. 세션 비용은 $0.0015에서 $0.0011로 줄어 입력 비용만큼 큰 폭으로 감소하지는 않았습니다. 이 실행에서는 출력이 비용의 더 큰 비중을 차지했고, 수정 버전이 우연히 출력도 더 많이 생성했기 때문입니다(1,599개 대비 1,750개 토큰).
절감 폭은 대화가 시작될 때 캐시에 무엇이 남아 있는지에 따라 달라집니다. 이번 실행은 콜드 스타트였으므로 첫 턴은 아무것도 읽지 못했습니다. 트래픽이 꾸준한 에이전트라면 73%보다 높은 적중률을 기대할 수 있습니다. 모든 대화가 같은 시스템 프롬프트로 시작하고, 캐시 항목이 만료되기 전에 요청이 계속 들어오면 이전 대화의 항목이 남아 있기 때문입니다. 단 하나의 대화에서만 보내는 프롬프트라면 첫 턴에 캐시 쓰기 가격을 지불합니다.
타임스탬프가 대표적인 원인입니다. 요청 ID, 무작위 인사말, 첫 문단에 삽입한 사용자 이름, 순서가 달라진 도구 정의도 같은 문제를 일으킵니다. 캐시 적중에는 두 가지 조건이 더 필요합니다. 고정 접두부, 즉 프롬프트에서 바뀌지 않는 앞부분이 제공자의 최소 길이보다 길어야 합니다(대부분 1,024개 토큰, 프롬프트 캐싱 참고). 또한 한 대화의 호출에는 같은 X-Session-Id를 보내야 합니다. 게이트웨이는 이 값을 사용해 대화의 캐시 적중이 일관되게 유지되도록 합니다.
왜 턴마다 보내는 입력이 늘어날까요?
대화 기록을 매번 다시 보내기 때문입니다. 기록이 길어지므로 입력이 어느 정도 늘어나는 것은 정상입니다. 이 사례의 문제가 있는 버전은 훨씬 빠르게 늘어납니다. 매 턴 고객 정보를 조회해 약 1,100개 토큰의 주문 내역 JSON을 받고, 조회 결과를 기록에 계속 남깁니다. 따라서 여섯 번째 턴에는 거의 같은 데이터가 여섯 벌 들어갑니다.
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]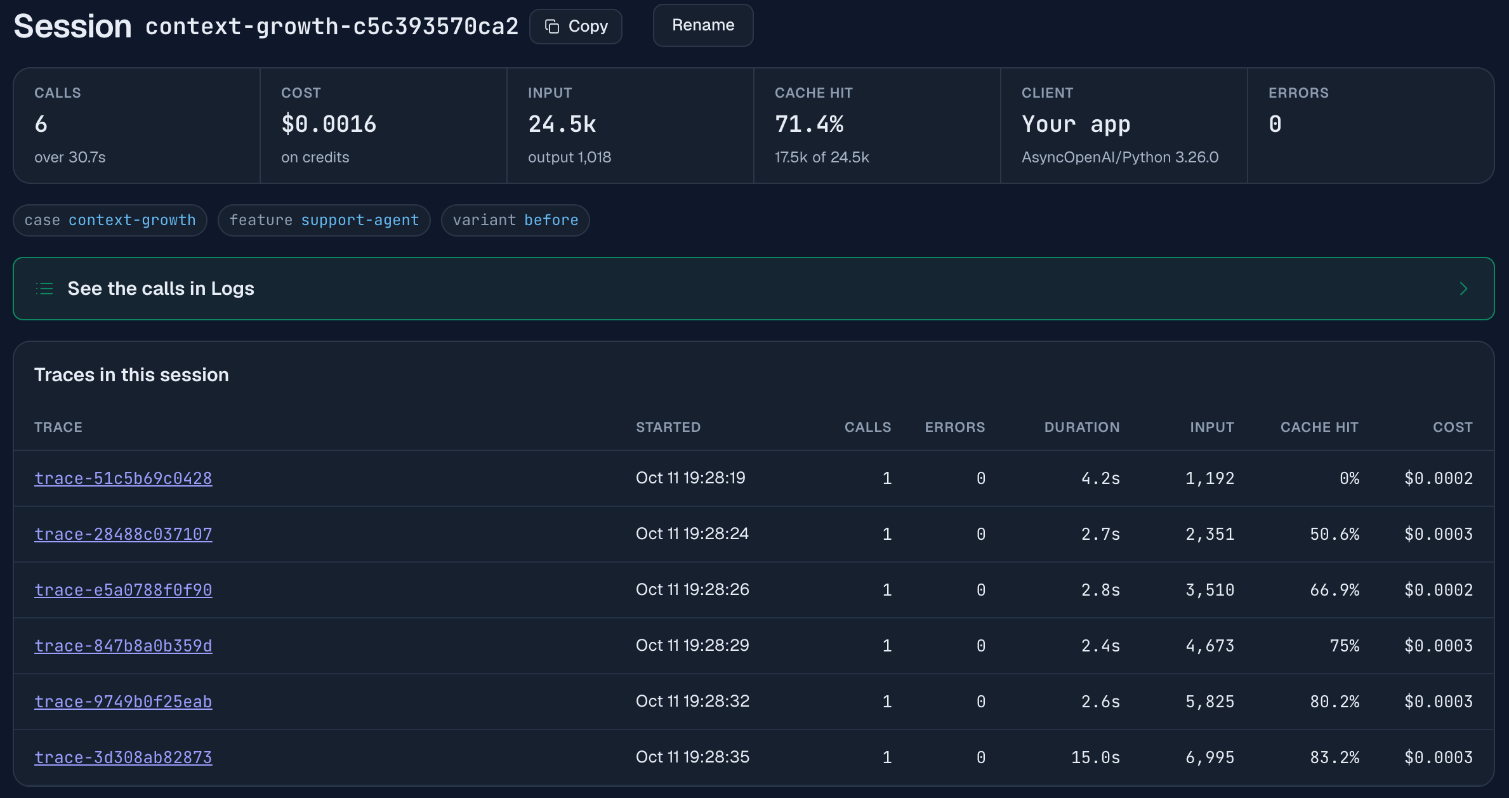
문제의 징후는 “Traces in this session” 표의 Input 열에 나타납니다. 답변은 계속 두 문장인데 입력은 턴마다 약 1,160개 토큰씩 늘어, 첫 턴의 1,192개에서 여섯 번째 턴의 6,995개가 됩니다. 6턴에 사용한 입력 토큰은 24,546개입니다. 수정 버전에서도 현재 턴은 새 조회 결과를 받습니다. 다만 중요한 내용은 이미 어시스턴트 답변에 남아 있으므로 이전 조회 결과는 보관하지 않습니다. 그러면 6턴의 입력 토큰은 8,053개로, 3분의 1 수준이 됩니다.
Input 옆의 두 열 때문에 이 문제는 잘 드러나지 않습니다. 입력량과 함께 Cache hit도 올라가고, 턴당 비용은 $0.0002에서 $0.0003 사이로 유지됩니다. 각 턴은 직전 턴의 프롬프트 전체로 시작하므로 제공자는 그 부분을 캐시에서 읽습니다. 입력 토큰 24,546개 중 17,536개, 즉 71%입니다. 문제가 있는 세션의 입력 비용은 $0.0011, 수정한 세션은 $0.0009입니다. 입력 토큰을 세 배 사용했지만 입력 비용은 21%만 늘었습니다.
이 두 실행에서는 세션 총비용만으로 수정 효과를 전혀 확인할 수 없습니다. 문제가 있는 세션은 $0.0016, 수정한 세션은 $0.0017이었습니다. 수정한 실행이 우연히 더 많은 출력을 생성했기 때문입니다(1,018개 대비 1,756개 토큰). 추가 출력 비용은 약 $0.0004로, 입력에서 절약한 $0.0002보다 큽니다. 세션 하나의 총비용이 아니라, 수정으로 바뀌는 Input과 Cache hit 열을 비교하세요.
프롬프트 캐싱은 대화 기록 증가에 따른 비용의 대부분을 흡수할 수 있습니다. 하지만 다음 세 가지는 해결하지 못합니다.
- 컨텍스트를 줄이지는 않습니다. 여섯 번째 턴은 여전히 토큰 6,995개를 보냅니다. 긴 세션은 마찬가지로 모델의 컨텍스트 한도에 도달하며, 캐시 토큰에도 캐시 요금이 청구됩니다.
- 기록을 실제로 보냈던 내용 그대로 다시 보낼 때만 작동합니다. 데모의
replay-mismatch가 이 사례입니다. 전송할 때 각 사용자 메시지에 지시문을 붙이지만, 저장할 때는 지시문을 뺍니다. 그러면 매 턴 직전 턴에서 한 번도 보내지 않은 프롬프트를 재구성하게 됩니다. 이 대화는 입력 토큰 24,557개 중 캐시에서 읽은 토큰이 0개였고 비용은 $0.0038이었습니다. 메시지를 보낸 그대로 저장하자 24,702개 중 18,844개, 즉 76%를 캐시에서 읽었고 비용은 $0.0015가 됐습니다. - 모든 모델이 지원하지는 않습니다. 이 사례에 사용한 GPT-6 Luna의 일반 입력 가격으로 토큰 24,546개를 계산하면 $0.0025입니다. 캐시를 적용해 청구된 약 $0.0011과 차이가 있습니다. 캐시를 전제로 판단하기 전에 Cache hit 열을 확인하세요.
실제 에이전트에서는 도구 결과가 대화 기록에서 가장 큰 부분을 차지하면서도 다시 보낼 필요는 가장 적은 경우가 많습니다. 그 결과를 활용한 답변이나 한 줄 요약을 남기고 원본 데이터는 제거하세요. 그러면 캐시 유무와 관계없이 모든 모델에서 비용을 줄일 수 있습니다. 오래된 턴을 요약으로 압축하는 일반적인 방법은 챗봇 가이드에서 다룹니다.
재시도 루프는 어떻게 보일까요?
한 턴에 필요한 것보다 훨씬 많은 호출이 한 트레이스에 모이고, 같은 span 이름이 반복됩니다. 이 사례에서는 배송사의 추적 API가 중단된 상태입니다. 에이전트는 도구를 호출하고 타임아웃을 받은 뒤, 배송물 위치를 확인할 수 없다는 답변을 작성합니다. 이후 코드는 답변에 배송물 위치가 있는지 검사합니다. 위치가 없으면 턴 전체를 다시 실행하며, 최대 다섯 번 반복합니다.
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused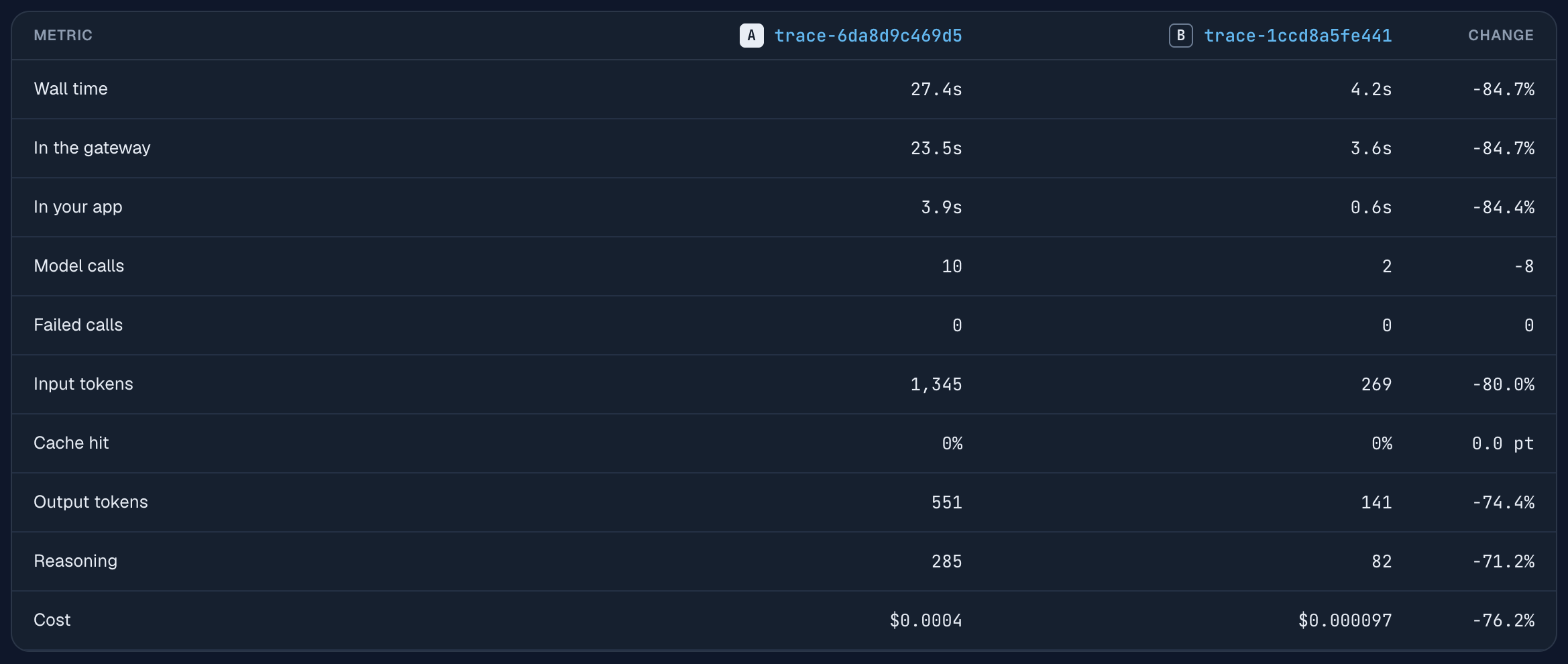
두 실행의 Compare 화면입니다. 트레이스 하나를 열고 Compare를 선택한 뒤 다른 트레이스를 고르면 됩니다. 문제가 있는 실행은 27.4초 동안 모델을 10번 호출해 $0.0004를 사용했지만, 고객은 결국 같은 답변을 받았습니다. 양쪽 모두 “Failed calls”는 0입니다. 루프의 모든 호출이 상태 코드 200으로 성공했으므로 여기서는 오류로 표시되는 것이 없습니다. 수정 버전은 도구 실패와 잘못된 답변을 구분하고, 도구가 문제라면 재시도하지 않습니다. 호출 2번, 4.2초, $0.0001로 줄어듭니다.
문제가 있는 실행의 워터폴에는 호출 이름이 plan-1, answer-1, plan-2, answer-2처럼 표시됩니다. 이처럼 단계와 시도 횟수로 span 이름을 붙이면 루프를 한눈에 알아볼 수 있습니다. 아직 발견하지 못한 루프를 찾으려면 Traces 목록을 호출 수로 정렬하세요.
단순한 작업에 비싼 모델을 쓰는지 어떻게 알 수 있을까요?
세션의 호출 수와 비용을 에이전트별로 나누는 “Agents in this session” 표를 확인합니다. 이 사례의 문제가 있는 버전은 하위 에이전트의 한 문장짜리 검사 세 건을 GPT-6.1 Sol에서 실행합니다. 이 모델은 입력 100만 토큰당 $2, 출력 100만 토큰당 $10입니다. 주 에이전트는 GPT-6 Luna로 답변합니다.
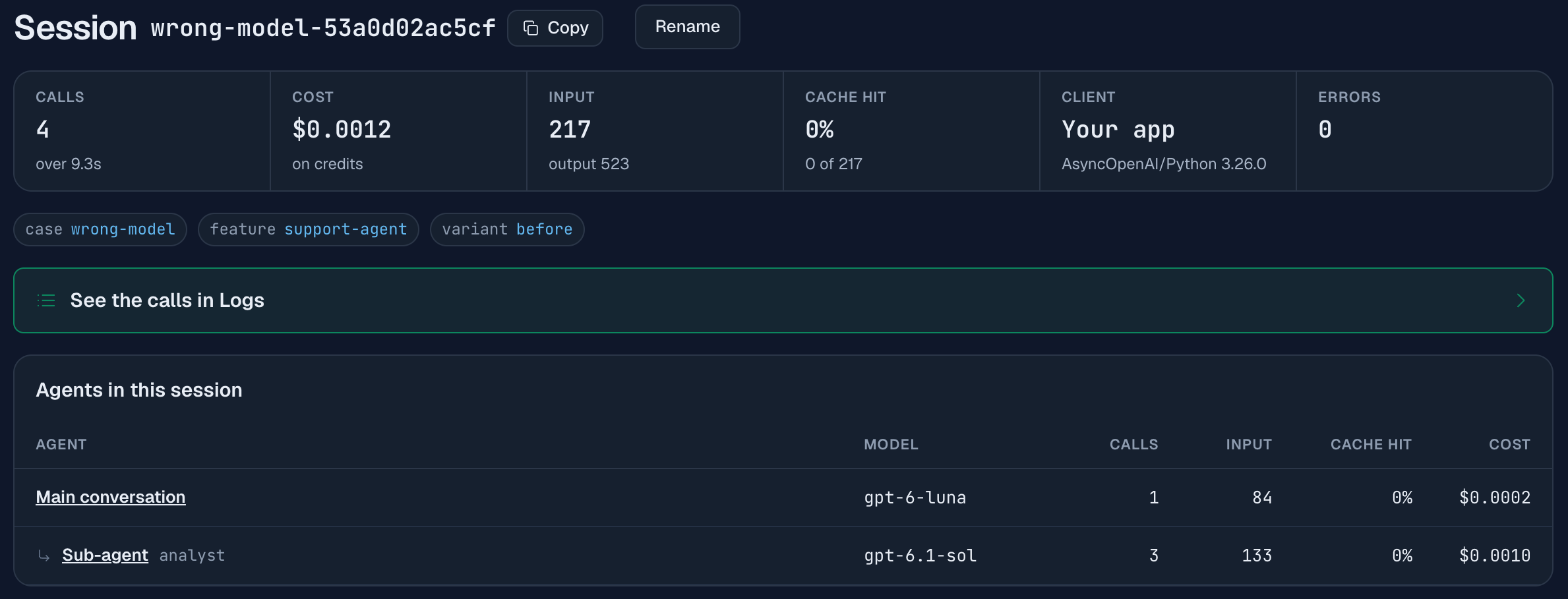
하위 에이전트의 호출 3번은 세션 총비용 $0.0012 중 $0.0010을 사용했습니다. 실행에서 가장 단순한 작업이 비용의 81%를 차지한 것입니다. 같은 검사 세 건을 DeepSeek V4.1 Flash에서 실행하면 $0.0001이 들고, 세션 총비용은 $0.0003입니다. 두 버전 모두 추론을 끈 상태로 검사하므로 차이는 모델 가격에서 발생합니다.
이 사례는 비용만 측정합니다. 검사 결과를 평가하지는 않았으며, 저렴한 모델의 답변이 해당 단계에 필요한 품질을 충족할 때만 올바른 선택이 됩니다. 이 표는 비용이 어디에 쓰이는지 보여줍니다. 이를 바탕으로 어느 단계를 저렴한 모델로 시험해 볼지 결정할 수 있습니다.
하위 에이전트 호출에 X-Agent-Id가 있으면 에이전트별 구분이 표시됩니다. 이 헤더가 없으면 “Models in this session” 표에서 모델별 내역을 볼 수 있습니다. 각 에이전트가 서로 다른 모델을 쓸 때만 에이전트별 구분과 같아집니다. 모든 세션에 걸쳐 특정 에이전트 하나를 보려면 Analytics의 Breakdown 탭에 있는 Cost by agent 카드를 사용합니다.
자주 묻는 질문
LLM 에이전트에서 어느 부분에 비용이 가장 많이 드는지 어떻게 확인하나요?
요청 헤더로 호출을 세션과 트레이스로 묶은 다음, Traces 목록을 비용순으로 정렬하고 맨 위 항목을 엽니다. 세션 페이지는 비용을 에이전트별, 모델별, 턴별로 나눠 보여줍니다. 이를 통해 캐시 문제인지, 컨텍스트 문제인지, 모델 선택 문제인지 구분할 수 있습니다.
프롬프트 캐시 적중률이 왜 0%인가요?
가장 흔한 원인은 타임스탬프처럼 프롬프트 앞부분에서 바뀌는 값입니다. 캐싱은 처음으로 달라지는 토큰 직전까지만 적용됩니다. 데모에서는 타임스탬프를 시스템 프롬프트 첫 줄에서 사용자 메시지 끝으로 옮기자 콜드 스타트의 캐시 적중률이 0%에서 73%로 올라갔습니다.
대화 첫 턴은 왜 캐시에 적중하지 않나요?
캐시 항목은 요청이 작성하며, 첫 턴이 바로 그 요청이기 때문입니다. 데모의 대화 4턴은 입력의 0%, 93.9%, 93.8%, 94.2%를 캐시에서 읽었습니다. 첫 턴이 캐시에서 읽으려면 앞선 대화가 같은 접두부를 보냈고, 그 항목이 아직 남아 있어야 합니다.
프롬프트 캐싱을 쓰면 긴 대화 기록은 무료인가요?
아닙니다. 다만 비용의 대부분이 가려질 수는 있습니다. 데모에서 이전 도구 결과를 모두 다시 보낸 대화는 기록을 줄인 버전보다 입력 토큰을 세 배 사용했습니다(8,053개 대비 24,546개). 하지만 입력의 71%를 캐시에서 읽어 입력 비용은 21%만 늘었습니다. 토큰은 여전히 컨텍스트 윈도우를 차지하며, 다시 보내는 기록이 실제로 보냈던 내용과 달라지는 순간 할인은 사라집니다. 데모의 replay-mismatch 사례에서는 메시지를 전송한 내용과 다르게 저장하자 캐시 사용률이 0%가 되고 비용이 두 배 넘게 늘었습니다.
프롬프트 캐싱으로 얼마나 절약할 수 있나요?
모델의 캐시 입력 가격과 전체 비용에서 입력이 차지하는 비중에 따라 달라집니다. GPT-6 Luna 데모에서는 대화 입력의 73%를 캐시에서 읽어 입력 비용이 66% 줄었습니다. 세션 비용은 캐시를 사용하지 않았을 때의 $0.0015 대비 $0.0011이었습니다. 이 비용의 대부분은 출력 토큰에서 발생했으며, 캐싱은 출력 토큰에 영향을 주지 않습니다.
재시도 루프는 오류로 표시되나요?
재시도 루프가 반드시 오류로 표시되는 것은 아닙니다. 데모에서는 루프의 모든 호출이 상태 코드 200을 반환했습니다. 필요한 호출은 2번인데 한 트레이스에 10번의 호출이 나타나는 것으로 루프를 확인할 수 있었습니다. 오류율뿐 아니라 트레이스당 호출 수도 확인하세요.
함께 읽기
- LLM 에이전트 트레이싱: 이 글에서 사용하는 헤더, 세션, 라벨.
- LLM 에이전트가 느린 이유: 같은 방법으로 지연 시간을 분석하는 법.
- LLM 에이전트 디버깅: 사용자 불만에서 문제가 발생한 호출까지 추적하는 법.
- Claude Code 하위 에이전트별 비용: 캐시 쓰기가 실행의 77%를 차지하는 코딩 에이전트에서 같은 세션 화면을 활용하는 법.
- Claude에 LLM 로그 질문하기: MCP로 이 세션들 중 비용이 가장 높은 세션을 찾는 법.
- 에이전트에 로그 도구 제공하기: 직접 만든 프로그램으로 같은 로그를 읽는 법과 모델 토큰 비용.
- 프롬프트 캐싱: 제공자별 최소 접두부 길이와 가격.
- 용도별 최적의 LLM: 단계별 모델 선택을 위한 워크로드 형태별 비용.