
배포 전 프롬프트 테스트: 평가로 잡아낸 16% 회귀
프롬프트를 줄이는 과정에서 규칙 하나가 빠졌다. 새 메시지 110개를 테스트하자 짧은 새 버전은 주문 번호를 18번(16%) 누락했고, 기존 버전은 한 번도 누락하지 않았다. 반면 40행으로 진행한 단일 실행에서는 누락이 없어 전체 평가와 다른 결과를 보였다.
추천 모델
실시간 가격| 모델 | 평가 | 가격 |
|---|---|---|
| GPT-6 Luna support-answer의 v1은 테스트 호출 275건 중 275건에서 주문 번호를 명시했습니다. 시스템 프롬프트가 더 짧은 v2는 사전에 정해 둔 실행에서 110건 중 92건에서 주문 번호를 명시했습니다. | 테스트 중인 두 버전의 모델 | $0.1/100만부터 |
| Claude Sonnet 5.5 각 답변이 고객의 질문에 답하는지 PASS 또는 FAIL로 평가했습니다. 이 모델의 호출 비용은 테스트 실행 6회의 총비용 $0.14 중 $0.12였습니다. | 데모의 평가 모델 | $2/100만부터 |
목차
프롬프트를 배포하기 전에 테스트하려면 새 버전과 현재 버전에 동일한 고정 입력을 넣고, 미리 작성한 규칙으로 모든 답변을 검사한다. 고객 지원 프롬프트의 v2를 이렇게 테스트했다. v2는 시스템 지침을 줄이면서 “주문 번호를 항상 명시한다”는 규칙을 빠뜨렸다. 테스트로 잡으려던 회귀, 즉 출력 품질이 나빠지는 변경이었다. 앞선 실행에서 한 번도 쓰지 않은 메시지 110개를 넣었을 때 v2는 답변 18개(16%)에서 주문 번호를 누락했고, v1은 한 번도 누락하지 않았다. 우연으로 보기 어려운 차이다(Fisher의 정확 검정, p = 3.6 × 10⁻⁶). 하지만 그보다 앞서 메시지 40개로 진행한 한 실행에서는 누락이 전혀 없었다. 한 번 통과했다고 배포해도 되는 버전은 아니다.
TL;DR
- 실행 전에 구성을 확정한 테스트에서 support-answer v2는 답변 110개 중 18개에서 주문 번호를 누락했고, v1은 110개 중 0개였다(p = 3.6 × 10⁻⁶).
- 앞서 40행씩 진행한 세 번의 실행 중 한 번은 v2가 40행 모두 통과했다. 최종 테스트 세트 세 개 중 하나도 단독으로는 문제를 잡아내지 못했을 것이다.
- 데모 스크립트가 수행한 테스트 호출 275건에서 v1은 모두 주문 번호를 명시했다.
- 15-20행으로 진행한 여섯 번의 테스트 비용은 $0.14였고, 그중 판정 모델 비용이 $0.12였다.
이 글은 support-answer와 각 버전을 설정하는 프롬프트 버전 관리에서 이어진다. v1과 v2는 모두 GPT-6 Luna를 사용하며, 시스템 지침만 다르다. github.com/synthorai-io/use-cases의 같은 디렉터리에서 실행한다.
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
이 글의 실행 결과는 2026년 10월 19일 기준이다. 판정 모델은 Claude Sonnet 5.5로, 테스트 대상 버전이 사용하는 모델과는 다르다.
프롬프트 테스트는 무엇으로 구성하나?
테스트 세트는 입력 테이블과 검사 목록으로 구성된다. 각 행에는 프롬프트 변수에 넣을 값이 들어가며, 사용자 메시지와 기대 답변을 선택적으로 추가할 수 있다. 테스트를 실행하면 각 행에 대해 후보 버전과 기준 버전을 호출하고, 모든 검사로 각 답변을 평가한다. 검사 유형은 다음과 같다.
| 검사 | 답변의 통과 조건 |
|---|---|
contains / not_contains | 지정한 문자열을 포함하거나 포함하지 않음 |
regex / not_regex | 패턴과 일치하거나 일치하지 않음(Go의 RE2 문법) |
equals_expected | 해당 행의 기대 답변과 같음 |
json / schema | 유효한 JSON임 / 해당 버전의 출력 스키마를 따름 |
max_latency_ms / max_cost_usd | 응답 시간과 비용이 한도 이내임 |
judge | 작성한 기준에 따라 모델이 PASS로 판정함 |
세트 하나에는 최대 50행을 넣을 수 있고, 각 검사는 해당 세트의 모든 행에 적용된다. 테스트 세트를 나눌 때도 이 제약을 고려해야 한다. “답변에 주문 번호가 들어 있다”는 검사는 입력 메시지에 주문 번호가 있어야 의미가 있으므로, 데모에서는 그런 메시지를 별도 세트로 분리했다.
| 세트 | 행 구성 | 검사 |
|---|---|---|
| orders (처음 15행, 이후 40행) | 배송, 반품, 오배송, 파손 상품, 청구에 관한 메시지로, 모두 주문 번호를 명시 | 주문 번호 포함(regex \bA-\d{5}\b); 모델 판정: 고객 질문에 답하는가 |
| fresh orders 1-3 | 다른 세트에 포함되지 않은 같은 유형의 새 메시지 110개를 40, 35, 35개로 분할 | 위와 같은 두 가지 검사 |
| general (20행) | 주문 번호가 없는 메시지로, 일부는 환불 소요 시간에 관한 질문 | not_contains “refund by” 및 “business days”; 지연 시간 20초 미만; 모델 판정: 질문에 답하는가; 모델 판정: 환불 날짜를 약속하지 않는가 |
모델 판정 검사는 답변마다 모델을 한 번 호출해 PASS 또는 FAIL을 받는다. 비용이 들고 오판할 수도 있으므로, 데모에서는 패턴으로 표현할 수 없는 항목에만 사용하고 결과도 패턴 검사와 분리해서 보고한다.
코드나 CI에서 프롬프트 테스트를 실행하려면?
CI(지속적 통합, 변경 사항을 병합하기 전에 매번 실행하는 검사)에서는 API로 프롬프트 테스트를 실행할 수 있다. 실제 테스트 실행은 호출하는 코드가 맡는다. 실행을 생성한 뒤, 각 행에 대해 prompt_version으로 두 버전을 호출하고 답변을 평가해 결과를 기록한다. 그러면 콘솔에서도 다른 실행과 똑같이 확인할 수 있다. 데모의 반복문을 줄이면 다음과 같다.
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
"results": {"rows": results}})call_by_version은 프롬프트 버전 관리에서처럼 prompt_version을 지정해 ID로 호출하는 함수다. judge는 판정 모델에 PASS 또는 FAIL을 요청하는 호출이다. 롤아웃 중에는 source: eval 라벨이 중요하다. Prompts 페이지의 버전별 집계는 이 라벨이 붙은 호출을 제외하므로, 테스트가 실제 트래픽 비교를 왜곡하지 않는다.
데모는 Python에서 패턴 검사를 수행한다. 콘솔과 정확히 같은 방식으로 평가하려면 검사와 답변을 POST /api/v1/prompt-checks/grade로 보내면 된다. 서버가 RE2를 사용해 contains, not_contains, regex, not_regex, equals_expected, json을 적용하고 검사 및 답변별 통과 여부를 반환한다. 간단히 확인해 보니 예상한 결과가 나왔다. “REFUND by Friday”에 (?i)refund를 적용하면 통과했고, 같은 답변에 not_regex (?i)refund.{0,40}\bby\b를 적용하면 실패했다.
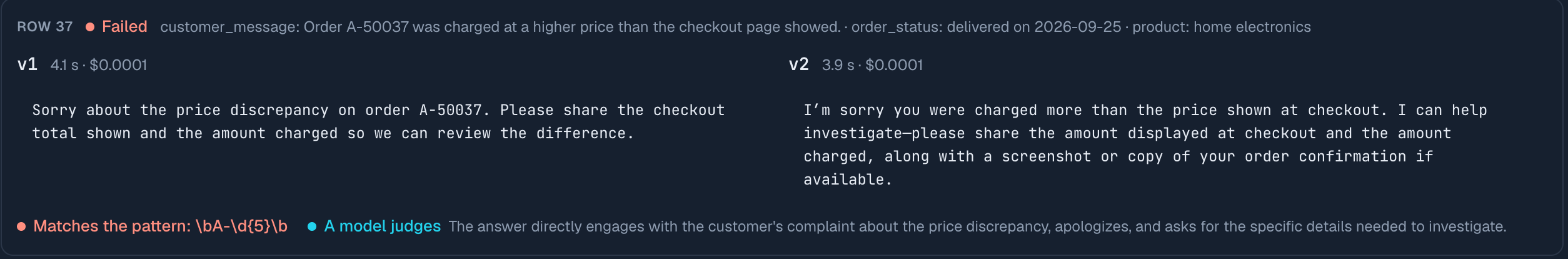
콘솔의 Run 버튼도 브라우저에서 같은 방식으로 동작한다. 행마다 두 버전을 호출하고 결과를 저장한다. 40행짜리 orders 세트를 콘솔에서 실행한 한 사례(아래 실행 10)에서는 후보 버전만 평가했고, v1 답변은 검사 없이 옆에 표시했다.
테스트로 회귀를 잡아냈나?
잡아냈다. 테스트 구성은 실행 전에 확정했다. 앞선 실행에서 쓰지 않은 새 메시지 110개를 사용하고, 행마다 버전별로 한 번씩 호출했다. 주문 번호 검사 결과는 110행 전체를 대상으로 Fisher의 정확 검정을 한 번만 수행했으며, 유의수준은 0.05로 정했다. Fisher의 정확 검정은 두 버전의 실제 동작이 같다고 가정할 때 이만큼 또는 그보다 큰 차이가 나올 확률을 구한다. 양측 검정은 어느 방향의 차이든 계산에 포함한다는 뜻이다. 첫 호출 전에 입력 행과 이 규칙을 저장소에 커밋했다. 결과는 다음과 같다.
| 세트 | v2가 주문 번호 명시 | v1이 주문 번호 명시 | 이 세트만 검정한 Fisher p값 |
|---|---|---|---|
| fresh orders 1 (40행) | 33/40 | 40/40 | 0.012 |
| fresh orders 2 (35행) | 27/35 | 35/35 | 0.005 |
| fresh orders 3 (35행) | 32/35 | 35/35 | 0.239 |
| 전체 110행 | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
v2는 답변의 16%에서 주문 번호를 누락했다. 누락은 특정 유형에만 몰리지 않았다. 배송, 반품, 오배송, 파손 상품은 각각 22개 중 4개, 청구는 22개 중 2개였다. 대표적인 예는 “은행 앱에 주문 A-50918의 승인 대기 내역이 두 건 보입니다.”라는 메시지에 대한 답변이다. 두 건의 청구가 아니라 승인 대기 내역일 수 있다고 설명해서 판정 모델은 통과로 처리했지만, 주문 번호는 끝내 언급하지 않았다.
세트별 p값은 각 세트의 결과를 설명하는 수치일 뿐, 사전에 정한 검정 결과는 아니다. 세 세트 중 두 개는 단독으로도 v2의 문제를 드러냈겠지만, 나머지 하나는 그러지 못했을 것이다.
한 번 통과한 실행이 회귀를 숨기는 이유는?
간헐적으로만 위반하는 규칙은 한 번의 실행 내내 지켜질 수도 있다. 위 테스트에 앞서 데모는 40행짜리 세트에서 v2와 v1을 세 번 비교했다.
| 실행 | v2가 주문 번호 명시 | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10 (콘솔) | 39/40 | 저장된 답변을 데모에서 평가한 결과 40/40 |
실행 9에서는 v2가 40행을 모두 통과했다. 테스트를 한 번만 실행해 이 결과를 얻은 팀이라면 v2를 배포했을 것이다. 이 실행들은 각각 따로 보면 통계적으로도 유의하지 않다. 한 번도 누락하지 않는 기준 버전과 비교할 때, 40행 이상인 실행에서 p값이 0.05 미만이 되려면 최소 6건의 누락이 필요하다(40개 중 34개 성공이면 p = 0.026, 35개 성공이면 0.055). 더 작은 세트는 누락이 적어도 된다. 20개 중 5개만 누락해도 p = 0.047이다.
여기서 테스트 크기를 정하는 기준을 얻을 수 있다. 누락 6건이 단순한 기댓값에 그치지 않고, 실제로 발생할 가능성이 높도록 행 수를 잡아야 한다. 누락률이 16%일 때 48행이면 최소 6건 누락할 확률이 80%다. 38행은 예상 누락 건수가 6건인데도 그 확률이 58%에 불과하다. 위 40행 세트의 누락률인 6.25%(답변 160개 중 10개 누락)라면 80% 확률을 확보하는 데 126행이 필요하다. 중요한 규칙이라면 세트 하나의 용량보다 많은 행을 준비해 여러 세트로 나누고, 결과를 어떻게 합칠지 미리 정해야 한다. 같은 행을 반복해도 새 행을 추가할 때만큼 근거가 늘지는 않는다. 같은 메시지를 다시 테스트하므로 독립 표본이 아니기 때문이다. 실제로 데모에서는 v2가 한 실행에서 누락한 행 중 세 개를 다른 실행에서도 누락했다.
짧아진 프롬프트에 다른 문제는 없었나?
다른 검사에서는 추가 문제를 찾지 못했다. general 세트에서 버전별로 세 번씩 실행한 결과다.
- 환불 날짜를 약속하지 않음: 두 버전 모두 “refund by”나 “business days”를 한 번도 쓰지 않았다. 모델 판정 검사는 버전별, 실행별로 답변 20개 중 최대 2개가 실패했으며, 버전 간 차이는 없었다.
- 지연 시간: v1은 한 실행에서 2행이 20초를 넘겼다. v2는 한 번도 넘기지 않았다.
- 질문에 답하는가(모델 판정): 모든 세트에서 v2의 평가가 더 좋았다. 새 세트에서는 v2가 110개 중 88개, v1이 110개 중 75개를 통과했다. 이 비교는 사전에 정하지 않았으므로 경향으로만 본다. 판정 모델이 보기에는 짧아진 프롬프트가 더 직접적으로 답한다.
콘솔과 데모는 판정 프롬프트가 다르다(콘솔은 판정 이유도 작성한다). 같은 메시지 40개에 대해 서로 다른 실행의 답변을 평가했을 때, 콘솔은 v2를 40개 모두 통과시켰고 데모의 판정 모델은 32-35개를 통과시켰다. 모델 판정 결과는 같은 평가 방식 안에서만 비교해야 한다.
프롬프트 테스트 비용은 얼마인가?
이 데모의 모델로 두 버전과 모델 판정 검사 하나를 실행하면 행당 약 0.1센트가 든다.
| 실행 | 실행당 행 수 | 호출 | 비용 |
|---|---|---|---|
| 15행 및 20행 세트로 6회 실행 | 15 또는 20 | 답변 생성 및 모델 판정 | $0.1400, 이 중 판정 호출 $0.1198 |
| 40행 세트로 3회 실행 | 40 | 답변 생성 240회 + 모델 판정 240회 | $0.115 |
| 사전에 구성을 확정한 테스트 | 110 | 답변 생성 220회 + 모델 판정 220회 | $0.1076 |
답변마다 더 큰 모델로 별도의 판정 호출을 하기 때문에 비용 대부분은 판정 모델에서 발생한다. 40행을 순차 호출한 실행은 10분이 걸렸다. 병렬 호출로 시간을 줄일 수 있지만, 그만큼 호출 한도를 더 많이 사용한다.
테스트 결과는 배포 판단에 어떻게 쓰이나?
콘솔에서 production을 옮길 때 대화 상자에 변경 내용과 함께 해당 버전의 마지막 테스트 실행이 표시된다. 이동 여부를 판단할 참고 자료이며, 이동을 차단하지는 않는다. 테스트 세트와 실행 답변은 암호화해서 저장하고, 답변은 30일간 보관한다.
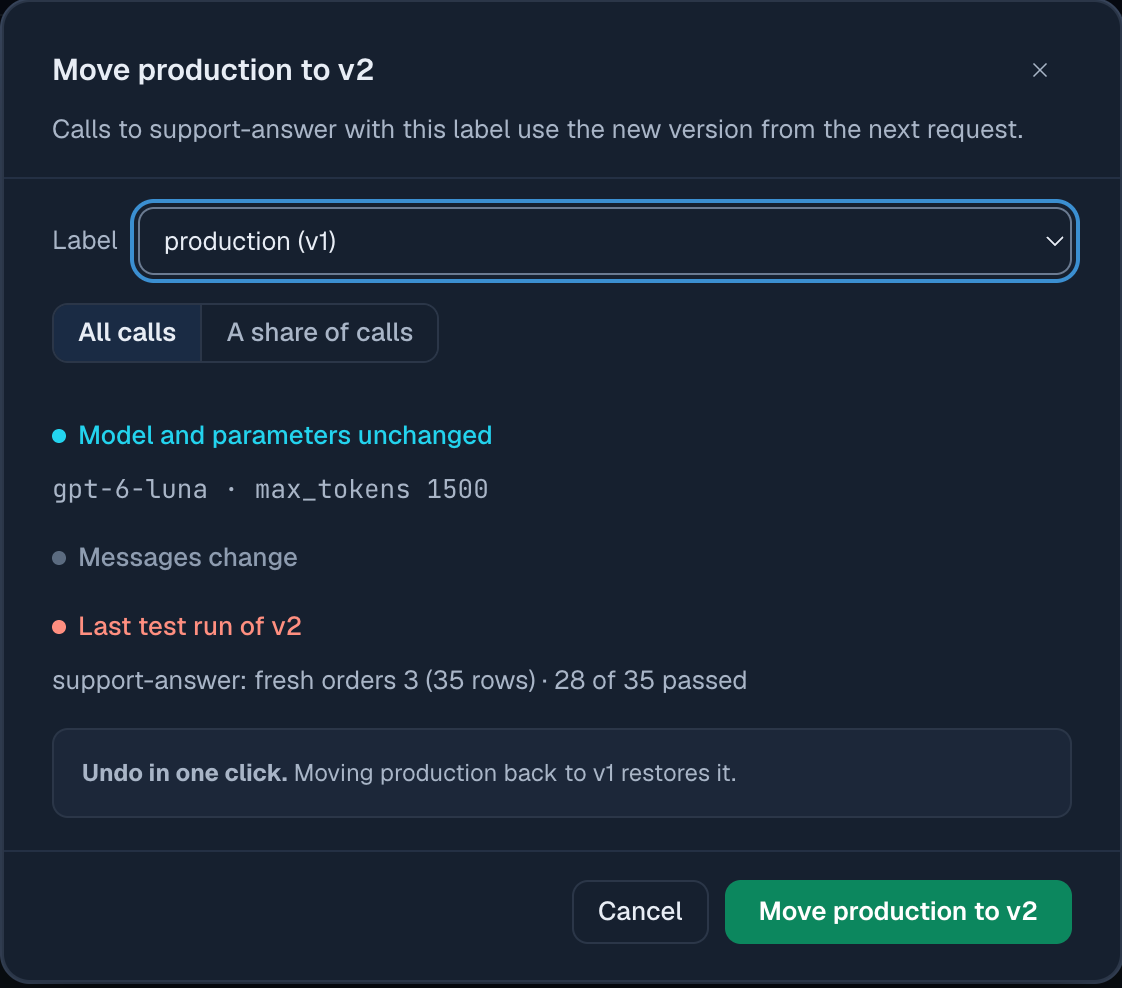
대화 상자에서는 세트의 모든 검사를 통과한 행만 통과로 집계한다. 따라서 여기 표시된 35개 중 28개는 패턴 검사와 모델 판정을 합친 결과다.
이 글에서 다루지 않은 것은?
- 행별 검사. 검사는 세트의 모든 행에 적용된다. 그래서 데모는 주문 번호가 있는 메시지와 없는 메시지를 별도 세트로 나눴다.
- 서버에서 실행하는 테스트. API와 콘솔의 Run 버튼 모두 호출하는 쪽에서 모델을 호출한다. 서버에서 테스트 전체를 실행하고 완료까지 기다리는 엔드포인트는 없다.
- 판정 모델의 정확도. 사람의 평가와 대조해 검증하지 않았다. 따라서 모델 판정 수치는 경향으로만 보고, 이 글에서 검증된 결과로 제시하는 것은 패턴 검사뿐이다.
자주 묻는 질문
LLM 프롬프트를 배포하기 전에 어떻게 테스트하나?
새 버전과 현재 버전에 동일한 고정 입력을 넣고, 미리 작성한 규칙으로 모든 답변을 검사한다. 그런 다음 사전에 정한 유의성 검정으로 통과 건수를 비교한다. 데모에서는 새 메시지 110개와 Fisher의 정확 검정 한 번으로 누락률 16%와 0%를 구분했다.
프롬프트 회귀 테스트에는 테스트 케이스가 몇 개 필요한가?
실제로 회귀가 발생했다면 규칙 위반이 최소 6건 나올 가능성이 높도록 행 수를 잡는다. 그 확률을 80%로 잡으면 실패율 16%에서는 48행, 6.25%에서는 126행이 필요하다. 데모에서는 본 테스트에서 답변의 16%가 규칙을 위반한 버전이 40행짜리 실행 한 번을 모두 통과했다.
LLM 판정 모델이 패턴 검사를 대신할 수 있나?
패턴으로 표현할 수 있는 검사를 판정 모델로 대체해서는 안 된다. 데모에서 콘솔과 스크립트는 서로 다른 판정 프롬프트를 사용했다. 같은 메시지 40개에서 v2의 통과 건수는 각각 40개와 32-35개였다. 반면 패턴 검사는 같은 텍스트에 항상 같은 결과를 낸다.
함께 읽을 글
- 프롬프트 버전 관리: ID로 프롬프트를 호출하고 라벨을 옮기는 방법.
- 프롬프트 변경 A/B 테스트: 실제 트래픽에서 버전별로 발생하는 비용.
- 프롬프트 라이브러리 가이드: 테스트 세트, 검사, 평가 실행.
- 콘솔의 프롬프트 관리: 테스트 편집기와 이동 대화 상자.