
GPT-6.1 Terra と GPT-5.6 Terra・Sol:192 回の API 比較
目次
- OpenAI のモデル群で GPT-6.1 Terra はどこに位置するか
- 公式ベンチマークで何が分かるか
- 推論設定をどうテストしたか
- 推論を無効にするとどうなったか
- 同じタスクで 3 モデルを比較するとどうなるか
- GPT-5.6 Terra から GPT-6.1 Terra に移行すべきか
- GPT-6.1 Terra と GPT-6.1 Sol のどちらを選ぶべきか
- API で推論強度を設定するには
- 本番環境では請求額をどう検証すべきか
- よくある質問
- GPT-5.6 Terra から GPT-6.1 Terra に移行する価値はあるか
- GPT-6.1 Terra と GPT-6.1 Sol のどちらを選ぶべきか
- 請求書処理で推論を無効にしてもよいか
GPT-6.1 Terra は、画像を扱うワークフロー向けの OpenAI の低価格モデルです。料金は入力 100 万 token あたり $1、出力 100 万 token あたり $5 で、GPT-6.1 Sol の半額です。推論強度は、回答前に行う内部推論の量を制御します。none では内部推論を無効にし、それ以外の設定では推論 token も出力として課金されます。今回のテストでは、推論を無効にしても表とボタン選択の全 16 タスクに成功しました。一方、請求書画像では 3/8、同じ計算を行うテキスト入力では 0/8 にとどまりました。
TL;DR
- 合成データによるテストで、GPT-6.1 Terra の
noneは表とスクリーンショットのタスクに 16/16 成功しましたが、請求書画像の計算は 3/8 でした。 - GPT-6.1 Terra の
lowは画像タスクで 24/24、対応するテキスト請求書タスクで 7/8、mediumはそれぞれ 24/24 と 8/8 でした。 - 画像 24 枚の処理コストは、GPT-6.1 Terra の
mediumが $0.028290、GPT-6.1 Sol のlowが $0.055012 でした。 - 条件をそろえて別途実行した比較では、画像 24 枚の処理コストは GPT-6.1 Terra の
mediumが $0.028269、GPT-5.6 Terra が $0.072094 でした。
OpenAI のモデル群で GPT-6.1 Terra はどこに位置するか
GPT-6.1 Terra は、画像の推論、画面操作、簡潔な文章作成を GPT-6.1 Sol より低価格で実行するモデルです。OpenAI は 2026 年 10 月 26 日に Terra を公開しました。モデル選定ガイドでは、画面上のワークフローや範囲を限定したコード修正など、要件が明確で結果を検証できるタスクを推奨しています。複雑なプロジェクトを幅広く扱うなら、引き続き Sol が選択肢になります。
GPT-5.6 Terra は、移行を判断するための旧世代の比較基準です。Sol は、利用するモデルのクラスを判断するための現行の上位価格モデルです。この 3 モデルで、移行とクラス選定という 2 つの判断を検証します。
| 仕様 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 今回の比較での位置づけ | 旧世代の比較基準 | 画像ワークフロー向けの新モデル | 複雑な作業向けの上位価格モデル |
| 100 万 token あたりの標準入力料金 | $2 | $1 | $2 |
| 100 万 token あたりの標準出力料金 | $12 | $5 | $10 |
| 100 万 token あたりのキャッシュ入力読み取り料金 | $0.20 | $0.05 | $0.10 |
| コンテキストウィンドウ | 1,050,000 token | 1,050,000 token | 1,050,000 token |
| 最大出力 | 128,000 token | 128,000 token | 128,000 token |
| 推論設定 | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| デフォルトの推論設定 | medium | medium | medium |
| 入力/出力モダリティ | テキストと画像/テキスト | テキストと画像/テキスト | テキストと画像/テキスト |
| テストに使用したエンドポイント | Responses API | Responses API | Responses API |
出典は公式の GPT-5.6 Terra リファレンス、GPT-6.1 Terra リファレンス、Sol リファレンス、リリース変更履歴です。上記の料金は、入力が 272,000 token 以下の Standard リクエストに適用されます。この境界を超えると、リクエスト全体に対して、キャッシュされていない入力の単価が 2 倍、出力の単価が 50% 増になります。キャッシュ書き込みには別料金が設定されています。今回計測した主要リクエストでは、キャッシュの読み取りも書き込みも報告されませんでした。
新しい Terra は、旧世代のコンテキスト長、出力上限、推論設定名を引き継いでいます。公表されている入力単価は 50%、出力単価は 58.3% 下がりました。後述の同条件での移行テストでは、この値下げと、token 使用量やタスクの正確性の変化を分けて確認します。
公式ベンチマークで何が分かるか
OpenAI の発表では、GPT-6.1 Terra を GPT-5.6 Terra および GPT-6.1 Sol と比較しています。発表文で実際に報告されている内容は次のとおりです。
| 評価 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam:専門業務の画像ワークフロー | 比較基準。絶対スコアの記載なし | medium で旧世代を 15 ポイント上回り、タスクのコストは約 3 分の 1 | 絶対スコアの記載なし |
| MMMU-Pro:画像の推論 | 公表された全設定で新しい Terra を下回る。スコアの記載なし | Sol にほぼ匹敵。スコアの記載なし | 新しい Terra がほぼ匹敵すると説明。スコアの記載なし |
| Terminal-Bench 4.0:ターミナルでのコーディング | 公表スコアは 21.5%。推論強度の記載なし | max で 50.3% | スコアの記載なし |
| 社内の事実性テスト:誤り率が低いほどよい | low で誤り率 53.6% | low で誤り率 16.7% | low の誤り率の記載なし |
出典は OpenAI の公開時評価です。記載のないスコアは未公表で、事実性の評価は社内テストです。以下の API テストでは、同じ合成タスクを使い、移行とモデルのクラス選定を検証します。
推論設定をどうテストしたか
GPT-6.1 Terra の none、low、medium と、GPT-6.1 Sol の low を比較しました。各構成に対し、画像 24 件と、それに対応する対照用テキスト 8 件の計 32 入力を使用し、本試験の呼び出し回数は 128 回になりました。別途行った移行比較では、同じ 32 入力に対し、GPT-5.6 Terra と新たに実行した GPT-6.1 Terra の medium を交互に呼び出しました。これが 64 回で、合計は 192 回です。移行比較の表には、この別バッチの結果だけを使っています。
| タスクの種類 | 構成ごとの入力数 | 必要な結果 |
|---|---|---|
| 請求書画像 | 8 | 明細ごとの乗算、割引の控除、税額の計算と丸め、前払金の控除 |
| 条件付きの表集計 | 8 | 指定された地域と四半期の値を集計し、返品率を計算 |
| アプリのスクリーンショット | 8 | 類似カードの中から正しいコントロール ID と、そのボタン内の座標を特定 |
| 対照用の請求書テキスト | 8 | 正確に書き起こしたテキストから同じ請求額を計算 |
3 種類のテンプレートで数値やレイアウトを変え、正解が既知の架空文書を生成しました。各画像は 960 × 640 ピクセルで、detail: "high" を指定して送信しました。請求書の画像版とテキスト版には、同じタスク指示、スキーマ、業務ルールを使っています。各入力について、各構成から 1 回ずつ応答を取得しました。
実行日は 2026 年 10 月 29 日です。Synthorai 経由で Responses の streaming リクエストを使い、出力上限を共通の 4,096 token に設定して、構成を交互に実行しました。本試験の 128 応答はすべて完了し、スキーマに適合する JSON を返しました。タスクの成功判定には、要求した値すべての一致を必要としました。スクリーンショットの座標は、正しいボタンの内側にあることを条件にしています。採点はモデルではなくコードで行い、金額には整数のセント値と十進数での丸めを使いました。
この 24 枚の画像は 3 種類のタスクテンプレートから作ったもので、24 種類の異なる業務ではありません。本試験と移行試験を合わせた 16 件の対応あり比較について、複数の差を検定することを考慮し、Holm 法で一括補正しました。補正後の p 値が 0.05 を下回る比較はありませんでした。以下の件数は今回の実行結果を示すもので、モデル全般の品質順位や同等性を立証するものではありません。
推論を無効にするとどうなったか
GPT-6.1 Terra の none は、請求書画像の計算で 8 件中 5 件、テキスト請求書の計算で 8 件すべてに失敗しました。同じ推論強度の比較で、low は請求書画像が 8/8、対照用テキストが 7/8、medium は両方とも 8/8 でした。モデル間の結果は、後述の 3 モデル比較表にまとめています。
テキストだけの入力でも誤りが出ているため、すべての失敗を画像の読み取りで説明することはできません。この 8 組の入力から、画像形式が有利だと結論づけることもできません。
具体的な失敗例として、次の請求書を見てみます。
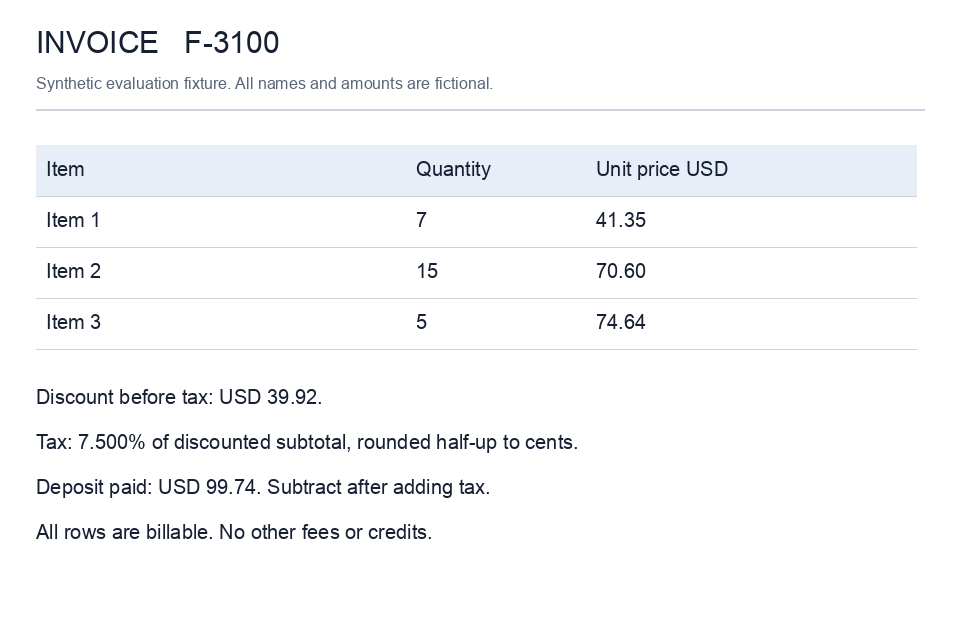
明細は 7 × $41.35、15 × $70.60、5 × $74.64 で、小計は $1,721.65 です。$39.92 の割引後に 7.5% の税をかけ、四捨五入すると税額は $126.13 になります。前払金 $99.74 を引いた支払残額は $1,708.12 です。
テキスト版では、Terra の low は小計 $1,711.65、税額 $125.38、支払残額 $1,697.37 を返しました。JSON はスキーマに適合していましたが、計算は誤っていました。推論強度を上げることは、検証すべき変数の 1 つです。型付きの出力を得ただけでは、金額の正しさは保証できません。
最初の基本試験では、4 構成すべてが表の条件付き集計 8 件とボタン選択 8 件に成功しました。この試験では、この 2 種類のテンプレートで品質の差は出ませんでした。成功件数の違いは請求書の誤りによるものです。
同じタスクで 3 モデルを比較するとどうなるか
GPT-5.6 Terra と GPT-6.1 Terra は medium で比較し、実用上のクラス比較として GPT-6.1 Sol には low を使いました。クラス選定の主な推奨構成に Terra の medium を使うのは、テキスト請求書の結果が low の 7/8 に対して 8/8 だったためです。Sol はテストした low を使います。これは推論強度の異なる候補構成の比較であり、同じ推論強度での品質比較ではありません。1 タスクの差だけで、medium が一般により正確だとはいえません。
基本試験 は最初の推論強度の比較、移行試験 は新旧 Terra を改めて比較した試験です。新しい Terra は、計測値が異なる箇所に各試験の値を併記しています。移行の推奨には移行試験の値を、Terra と Sol の選定には基本試験の値を使います。以下のコスト比や遅延比では、異なるバッチの値を混在させていません。
| 指標 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 構成 | medium、移行試験 | medium、基本試験と移行試験 | low、基本試験 |
| 請求書画像の正解数 | 8/8 | 両試験とも 8/8 | 8/8 |
| 対応するテキスト請求書の正解数 | 8/8 | 両試験とも 8/8 | 8/8 |
| 条件付きの表集計の正解数 | 8/8 | 両試験とも 8/8 | 8/8 |
| スクリーンショットタスクの完全正解数 | 2/8 | 両試験とも 8/8 | 8/8 |
| 全画像タスクの正解数 | 18/24 | 両試験とも 24/24 | 24/24 |
| 画像 24 枚のコスト | $0.072094 | 基本試験:$0.028290、移行試験:$0.028269 | $0.055012 |
| 同じ画像処理の使用量を 100 万 token あたり入力 $1/出力 $5 で換算 | $0.033500 | 基本試験:$0.028290、移行試験:$0.028269 | $0.027506 |
| 画像タスクの正解 1 件あたりのコスト | $0.004005 | 基本試験:$0.001179、移行試験:$0.001178 | $0.002292 |
| 画像応答時間の中央値 | 2.57 秒 | 基本試験:5.75 秒、移行試験:6.43 秒 | 4.51 秒 |
正解 1 件あたりのコストは、総コストを完全正解の応答数で割った値です。不正解のコストも含みますが、リトライはシミュレーションしていません。返された使用量に固定の Standard 料金を適用し、推論 token は出力 token に含めています。別途行った function calling の確認は除外しています。応答時間はゲートウェイ経由のエンドツーエンド計測で、配信インフラ自体を同一条件に固定したわけではありません。
旧 Terra の 6 件の失敗では、座標はすべて正しいボタン内にありましたが、印字されたコントロール ID を読まず、cobalt-edit のような ID を作っていました。特定フィールドの厳密な一致に失敗したケースです。移行試験の medium では、両世代ともすべての請求書を正しく計算しました。
基本試験の推論強度比較では、新しい Terra の none は画像 24 枚で $0.024275、正解数は 19/24 でした。対して low は $0.027835 で 24/24 でした。画像タスクの正解 1 件あたりの実測コストは、none が $0.001278、low が $0.001160 になります。このデータでは、none の総支出は低くても、成功結果 1 件あたりのコストは低くなりませんでした。
GPT-5.6 Terra から GPT-6.1 Terra に移行すべきか
推論コストや画像内のフィールドの厳密な抽出が重要なら、GPT-5.6 Terra から GPT-6.1 Terra への移行を評価する価値があります。同条件の medium 比較では、画像タスクのコストが 60.8% 下がり、完全正解数は 18/24 から 24/24 になりました。結果が変わった 6 件は、印字されたコントロール ID に関するものです。統計的な補正後、このサンプルから一般的な品質の優位性は立証できません。
旧モデルの現行料金は、100 万 token あたり入力 $2、出力 $12 です。新しい Terra は、それぞれ 50% と 58.3% 安くなっています。共通の $1/$5 の単価で換算しても、画像タスクの使用量に基づくコストは 15.6% 低くなります。入力は 20,765 token と 20,789 token でほぼ同じでしたが、出力は 2,547 token から 1,496 token に減りました。
社内文書処理や検証付きのフィールド抽出では、現在と同じ推論強度で新モデルをテストし、移行前に ID と金額の完全一致を確認してください。遅延に敏感な対話処理では、新モデルがアプリケーションの応答時間目標を満たすまで、旧モデルを比較対象として残してください。今回の画像応答時間の中央値は、旧モデルが 2.57 秒、新モデルが 6.43 秒でした。支払いにつながる請求書では、どちらの世代を使う場合も、決定的な計算処理と承認チェックを維持してください。
GPT-6.1 Terra と GPT-6.1 Sol のどちらを選ぶべきか
今回のように範囲が限定された画像タスクでは、GPT-6.1 Terra の medium が安い候補です。応答時間や、より複雑な作業を重視するなら、GPT-6.1 Sol の low も比較対象に残すべきです。基本試験では両方とも画像 24/24 に正解し、コストはそれぞれ $0.028290 と $0.055012 でした。実測の 48.6% のコスト削減は、Terra の入出力単価が 50% 低いことで説明できます。Sol の使用量を $1/$5 で換算すると $0.027506 となり、Terra の $0.028290 をわずかに下回ります。
検証付きのバッチ抽出なら、まず自社のサンプルで Terra を評価し、誤りの種類を比較してください。対話型ワークフローでは、Sol の実測中央値 4.51 秒と Terra の 5.75 秒を、製品の実際の遅延目標に照らして比較してください。複雑なコーディングや自由度の高いエージェントプロジェクトには、この 3 種類のテンプレートを超えた、実務を代表する評価が必要です。OpenAI のモデル選定ガイドも、複雑な作業には Sol を位置づけています。今回の成功件数が同じでも、一般的な同等性の根拠にはなりません。
API で推論強度を設定するには
GPT-6.1 Terra では、reasoning.effort を明示し、回答と返された使用量の両方を確認してください。GPT-6 ガイドでは、デフォルトは medium で、ツール呼び出しには Responses が必要とされています。推論 token は出力上限を消費し、出力 token の内数として課金されます。別途二重に加算されるわけではありません。
次の Python コードは、計算ベンチマークの再現ではなく、本番向けの抽出パターンを示すものです。openai をインストールし、OPENAI_API_KEY を設定して、上の請求書画像を invoice.png として保存してください。明細と印字されたルールを抽出し、存在しないフィールドは null にします。ここで対応するルールは、税計算前に割引し、セント単位で四捨五入した後、税込額から前払金を引くものです。
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
最初の基本試験で使った 4 構成について、ローカルで function calling も別途確認しました。対象は新しい Terra の none/low/medium と、GPT-6.1 Sol の low です。スクリーンショットのコントロールを選び、実際に保存された選択内容を読み取り、検証済みの結果を返す手順を実行させました。固定した 3 ターンの手順を 4 構成すべてが正しく完了し、API のターン数は計 12 回でした。関数の結果には対応する呼び出し ID を使い、出力項目を後続リクエストに引き継ぎました。これはローカルの互換性確認であり、自律的なデスクトップ操作のベンチマークではありません。
本番環境では請求額をどう検証すべきか
請求書の計上や支払いでは、計算に使う値を型付きで抽出し、合計額は決定的なコードで計算してください。コストや遅延の比較でどのモデルを選んでも、元フィールドを検証し、送金前の承認を必須にします。
次のブロックは、抽出サンプルの後に実行します。欠落した入力や未対応の入力を拒否し、上の請求書の合計額を計算します。セント単位の整数で二進浮動小数点の誤差を避け、Decimal で指定の税額丸めルールを適用します。
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
この出力はレビュー用であり、自動計上用ではありません。型とルールのチェックだけでは、単価を正しく読み取れたかどうかは分かりません。支払いを承認する前に、抽出フィールドを原本と照合し、曖昧な条件を確認してください。抽出サンプルは実装パターンを示したものです。計測した 192 回の呼び出しでは、前述の計算用プロンプトをテストしています。
関連する計測は、画像入力の課金ガイド、PDF の表現形式別コストテスト、同価格帯のモデル比較を参照してください。
よくある質問
GPT-5.6 Terra から GPT-6.1 Terra に移行する価値はあるか
同条件の medium 比較では、GPT-6.1 Terra は GPT-5.6 Terra より画像タスクのコストを 60.8% 削減しました。両方を 100 万 token あたり入力 $1/出力 $5 で換算した場合の削減率は 15.6% です。請求書の計算は両方とも全件成功しましたが、旧モデルは印字されたコントロール ID を 6 件誤りました。新モデルは応答時間の実測中央値が長かったため、移行判断には応答時間の検証も必要です。
GPT-6.1 Terra と GPT-6.1 Sol のどちらを選ぶべきか
画像 24 タスクのコストは、GPT-6.1 Terra の medium が $0.028290、GPT-6.1 Sol の low が $0.055012 で、基本試験の正解数は両方とも 24/24 でした。検証付きのバッチ処理には Terra を評価し、対話型の処理には Sol も比較してください。応答時間の中央値はそれぞれ 5.75 秒と 4.51 秒でした。この合成タスクから、一般的な品質の同等性は立証できません。
請求書処理で推論を無効にしてもよいか
基本試験で GPT-6.1 Terra の none が正解したのは、請求書画像で 3/8、対応するテキスト計算で 0/8 だけでした。厳密な金額計算はコードで行い、抽出した計算用の値を検証してください。範囲を限定した表やボタン選択のタスクでは、今回 none が 16/16 に成功しており、実際のワークロードで評価する候補になります。