
Quanti token costa un PDF? 4 fornitori, da 15 a 2,100 a pagina
Indice
- Come si invia un documento a un modello?
- Come si verifica che il modello abbia davvero letto il file?
- Come conta i token di un PDF ciascun fornitore?
- Quando il testo estratto non basta?
- Come si riduce il costo dei documenti?
- Come si gestisce un file Word?
- Come abbiamo misurato
- FAQ
- Quanti token occupa una pagina PDF?
- Costa meno inviare un PDF o il testo estratto?
- Un LLM può leggere un PDF scansionato?
- Quali modelli accettano direttamente i file PDF?
- Come si riduce il costo di un PDF lungo?
- Letture correlate
Ogni fornitore applica una regola diversa ai PDF inviati al modello come file. GPT-6 conta i token del testo e circa 15 in più per pagina. Claude conta il testo e aggiunge 1,558 token per ogni pagina. Gemini conta 515 token per pagina, senza addebitare il testo. Qwen 3.8 aggiunge 2,098 token per pagina a quelli del testo. Per misurare queste regole abbiamo inviato le stesse pagine con quantità di testo crescenti. Poi abbiamo sottoposto dieci documenti a quindici modelli per trovare, per ogni tipo di documento, il metodo meno costoso che mantenesse corrette le risposte.
TL;DR
- Per ogni pagina PDF inviata come file, GPT-6 aggiunge 15 token al testo, Claude 1,558 e Qwen 3.8 2,098. Gemini fattura 515 token fissi, senza costi per il testo.
- Il testo estratto ha prodotto 0 risposte corrette su 150 domande sui grafici e 0 su 105 domande su un documento scansionato.
- Scegliendo il metodo di invio pagina per pagina, un documento misto è passato da 17,228 a 6,543 token su Claude Sonnet 5.5, con tutte le 12 risposte corrette.
- Inviando 4 pagine selezionate di un PDF di 120 pagine, l’input di Claude Sonnet 5.5 è sceso da 253,822 a 8,758 token.
Come si invia un documento a un modello?
Ci sono tre possibilità: come file, come immagini delle pagine oppure come testo estratto in precedenza.
import base64
import pymupdf  # pip install pymupdf

doc = pymupdf.open("report.pdf")
b64 = lambda data: base64.b64encode(data).decode()   # binary written as text, so it fits in JSON

# 1. As a file. The vendor decides how to read it.
as_file = [{"type": "file", "file": {"filename": "report.pdf",                # OpenAI-compatible chat
            "file_data": "data:application/pdf;base64," + b64(open("report.pdf", "rb").read())}}]
as_document = [{"type": "document", "source": {"type": "base64",              # Anthropic Messages API
                "media_type": "application/pdf", "data": b64(open("report.pdf", "rb").read())}}]

# 2. As page images. You render each page; any model that accepts images takes these.
as_images = [{"type": "image_url", "image_url": {"url": "data:image/jpeg;base64," +
              b64(page.get_pixmap(dpi=72).tobytes("jpeg"))}} for page in doc]

# 3. As text. The text layer is the selectable text stored in a PDF. A scan has none.
as_text = "\n\n".join(page.get_text() for page in doc)
Ecco gli input accettati dai quindici modelli sull’endpoint chat:
| Modello | PDF come file | Immagini delle pagine | Testo |
|---|---|---|---|
| GPT-6.1 Sol, GPT-6 Luna | sì | sì, fino a 50 per richiesta | sì |
| Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 | sì | sì | sì |
| Gemini 3.1 Pro, Gemini 3.8 Flash | sì | sì | sì |
| Qwen 3.8 Max, Qwen 3.8 Flash | sì | sì | sì |
| Qwen 3.6 35B (pesi aperti), DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 | no | sì | sì |
| GLM 5.3, DeepSeek V4 Pro | no | no | sì |
Le immagini delle pagine sono l’unico formato accettato da tutti i modelli con capacità visive. Lo accettano anche i quattro modelli a pesi aperti, i cui pesi sono pubblici e che rifiutano i file. Sull’endpoint usato nei test, i modelli Gemini accettavano il PDF come data URL in una parte immagine; l’API di Google lo accetta come dati inline.
Come si verifica che il modello abbia davvero letto il file?
Basta chiedere un’informazione presente solo nel file e controllare il numero di token in input. Un input non supportato può generare un errore 400 oppure essere scartato mentre il modello risponde comunque. Nel nostro test, i due modelli senza capacità visive hanno ignorato la parte immagine: per un documento di due pagine hanno riportato 27 e 98 token in input. Un altro modello, a cui avevamo passato un URL al posto del file, ha risposto inventando il contenuto.
r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": as_file + [question]}])
read_it = "MF-OPS-2291" in r.choices[0].message.content   # a string found only in the document
plausible = r.usage.prompt_tokens > 200 * len(doc)        # a dropped file leaves a few dozen tokens
Per classificare una pagina non serve un modello. La scelta del metodo di invio descritta più avanti si basa proprio su questa classificazione:
def kind(page) -> str:
    if len(page.get_text().strip()) < 40:
        return "scan"        # no text layer: needs OCR or an image
    if page.get_images() or len(page.get_drawings()) > 60:
        return "visual"      # a picture or a chart drawn on the page
    return "text"
Come conta i token di un PDF ciascun fornitore?
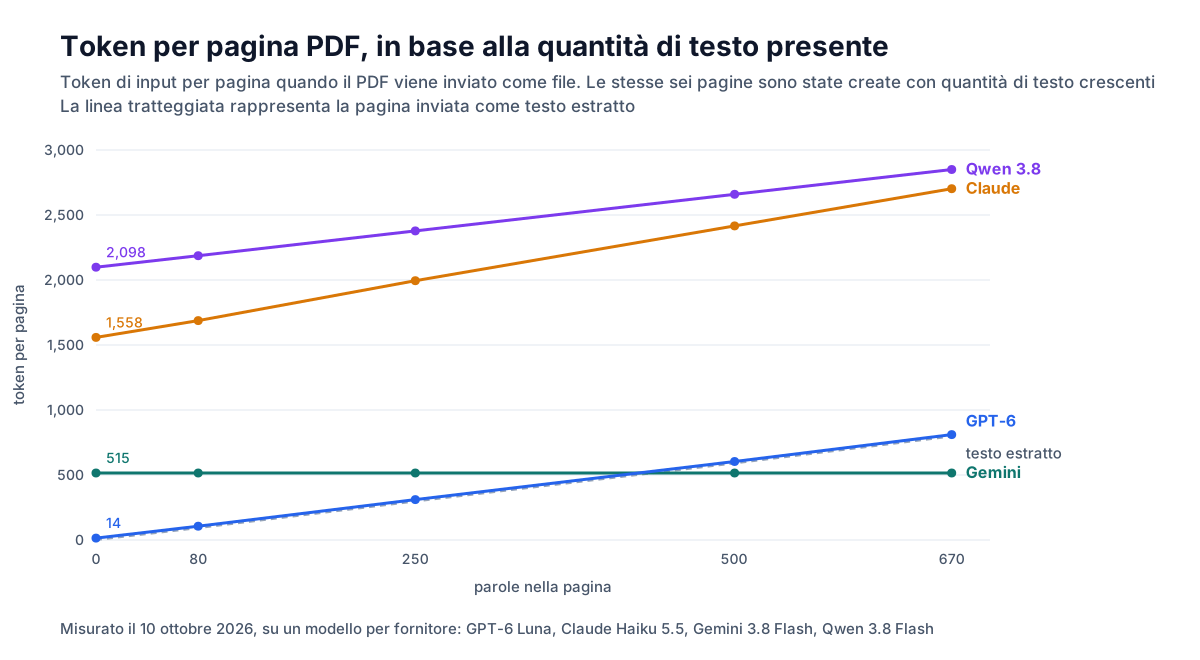
Le regole sono quattro. Abbiamo creato un PDF di sei pagine con 0, 80, 250, 500 e circa 670 parole per pagina, poi ripetuto il test aggiungendo un grafico a ogni pagina. Abbiamo inviato ogni versione sia come file sia come testo estratto.
| Fornitore | Token per un PDF inviato come file |
|---|---|
| GPT-6 | Token del testo più 14.5 per pagina. Una pagina con un’immagine aggiunge circa 650-1,700 token |
| Claude | Token del testo più esattamente 1,558 per pagina. Un grafico sulla pagina non aggiunge nulla |
| Gemini | 515 per pagina, qualunque sia il contenuto. Il testo non viene conteggiato |
| Qwen 3.8 | Circa 0.94 volte i token del testo più 2,098 per pagina. Un grafico aggiunge circa 770 token |
Il token è l’unità usata per la fatturazione del modello e corrisponde a circa tre quarti di una parola inglese. I modelli della stessa famiglia hanno restituito conteggi uguali, con scarti di pochi token.
Due regole differiscono da quelle pubblicate dai fornitori, almeno sul percorso API che abbiamo misurato. La documentazione di Google indica 258 token per pagina e nessun addebito per il testo del PDF; noi ne abbiamo misurati 515, con il testo gratuito come dichiarato. OpenAI documenta l’invio al modello sia del testo estratto sia delle immagini delle pagine; qui una pagina di solo testo non comportava costi per l’immagine. Anthropic dichiara che ogni pagina viene elaborata come testo e come immagine, in genere per 1,500-3,000 token: il dato è coerente con le misure.
Le conseguenze di queste regole:
- Le pagine con poco testo costano molto su Claude e Qwen. Una pagina con una sola riga costa 1,558 o 2,098 token come file e una dozzina come testo.
- Le pagine dense costano poco su Gemini. Una pagina di circa 670 parole costa gli stessi 515 token di una pagina vuota, mentre il solo testo occupa circa 800 token.
- Su GPT-6 il file costa quanto il testo, finché non ci sono immagini. Una pagina scansionata, composta interamente da un’immagine, ha richiesto 2,868 token.
Un report di 12 pagine di solo testo, con circa 250 parole per pagina, ha richiesto come file 6,028 token su GPT-6.1 Sol, 6,441 su Gemini 3.8 Flash, 27,297 su Claude Sonnet 5.5 e 30,934 su Qwen 3.8 Flash. Il testo estratto ha richiesto da 5,924 a 8,716 token sui quindici modelli.
Quando il testo estratto non basta?
Quando l’informazione non si trova nel livello testuale. Abbiamo classificato ogni domanda in base al contenuto necessario per rispondere; i risultati aggregano tutti e quindici i modelli:
| Metodo di invio | Testo corrente | Cella di tabella | Grafico | Pagina scansionata |
|---|---|---|---|---|
| Testo estratto | 297 su 300 | 168 su 170 | 0 su 150 | 0 su 105 |
| OCR, poi testo | 104 su 105 | |||
| PDF come file | 186 su 186 | 103 su 103 | 90 su 90 | 62 su 63 |
| Immagini delle pagine, 110 dpi | 258 su 260 | 148 su 148 | 130 su 130 | 89 su 91 |
| Immagini delle pagine, 72 dpi | 257 su 260 | 142 su 148 | 130 su 130 | 88 su 91 |
I punti per pollice (dpi) indicano la risoluzione di rendering della pagina; a 72 dpi una pagina US Letter misura 612 per 792 pixel. L’OCR, riconoscimento ottico dei caratteri, è il software che legge il testo da un’immagine; abbiamo eseguito localmente Tesseract, che è open source.
Il testo estratto non ha prodotto alcuna risposta corretta sui grafici e sulla scansione, con nessun modello, perché i numeri non erano presenti nel testo. L’OCR ha recuperato il report scansionato al costo del testo, ma non i grafici: su una presentazione di 15 slide con grafici, il testo ottenuto tramite OCR ha prodotto 0 risposte corrette su 7 in entrambi i modelli testati. Le tabelle sono rimaste leggibili dopo l’estrazione perché erano griglie semplici. Celle unite e colonne con testo a capo sono più difficili da gestire: vanno testate sui propri documenti.
Come si riduce il costo dei documenti?
Sette metodi, sei dei quali misurati.
1. Scegliere il metodo di invio in base alla regola di conteggio. Per le pagine di solo testo, inviare il testo. Negli altri casi, usare il file su Gemini e immagini delle pagine a 72 dpi sugli altri modelli: il costo di un’immagine di pagina non dipende dalla quantità di contenuto stampato. Un modulo IRS di 6 pagine dense richiede 13,635 token come testo su Claude Sonnet 5.5, 22,871 come file e 4,015 come immagini a 72 dpi. Tutti e tre i metodi hanno prodotto risposte corrette alle tre domande.
2. Scegliere il metodo pagina per pagina. Un documento reale contiene pagine di tipi diversi, che la funzione kind mostrata sopra permette di classificare: le pagine testuali si inviano come testo, quelle con immagini come immagini a 72 dpi e quelle scansionate passano dall’OCR. Ecco i risultati su un documento di nove pagine (quattro di testo, tre di grafici e due scansionate) con 12 domande:
| Modello | Come file | Metodo scelto pagina per pagina | Tutte le pagine come immagini a 72 dpi |
|---|---|---|---|
| GPT-6 Luna | 15,106, 12 corrette | 5,140, 12 corrette | 5,750, 9 corrette |
| Claude Sonnet 5.5 | 17,228, 12 corrette | 6,543, 12 corrette | 6,257, 12 corrette |
| Qwen 3.8 Flash | 25,036, 12 corrette | 5,313, 12 corrette | 4,710, 12 corrette |
| Gemini 3.8 Flash | 5,043, 12 corrette | 7,110, 12 corrette | 10,278, 12 corrette |
Su tre fornitori, la scelta pagina per pagina ha ridotto l’input del 62%-79% rispetto al file, mantenendo tutte le risposte corrette. Su Gemini il file è già l’opzione meno costosa.
3. Abbassare la risoluzione delle immagini, ma non per il testo. I token di un’immagine di pagina diminuiscono con il numero di pixel. Fa eccezione Gemini, che ha fatturato lo stesso numero di token a ogni dimensione. Le slide con grafici ed etichette grandi sono rimaste leggibili a 36 dpi: tutti i sei modelli testati hanno risposto correttamente ad almeno 6 domande su 7. Le 15 slide hanno richiesto 2,874 token su Claude Haiku 5.5, contro 23,949 come file. Per il corpo del testo servivano 72 dpi: a 50 dpi Claude Haiku 5.5 e Gemini rispondevano ancora correttamente a 7 domande su 7, mentre GLM 5.3 Flash scendeva a 2 su 7. GPT-6 Luna ha perso risposte corrette con immagini di pagina a tutte le risoluzioni inferiori a 96 dpi: meglio inviargli il file o il testo.
4. Su OpenAI, impostare detail su low per le pagine con immagini. La Responses API accetta un campo detail sui file PDF. Con low, GPT-6 Luna ha letto le 15 slide usando 9,985 token invece dei 22,155 della configurazione predefinita, e il report scansionato usando 11,387 token invece di 34,396. Tutte le risposte erano corrette. Per le pagine di solo testo non è cambiato nulla.
5. Inviare solo le pagine necessarie. Per un manuale di 120 pagine, GPT-6 Luna ha letto il testo estratto (46,420 token) e indicato la pagina necessaria per ciascuna delle quattro domande. Claude Sonnet 5.5 ha poi risposto correttamente a tutte e quattro usando un PDF di 4 pagine e 8,758 token. Il file completo richiede 253,822 token su Claude: il costo dell’input è quindi sceso da $0.508 a $0.022, includendo il primo passaggio.
6. Usare un modello economico per trascrivere e uno grande per ragionare. Un modello economico con capacità visive ha convertito le 15 slide di grafici in tabelle Markdown per $0.002-$0.011. Claude Opus 5.5 ha poi risposto correttamente a tutte e sette le domande usando una trascrizione di circa 2,000 token, al costo di $0.010. Il file richiede invece 23,949 token e $0.096 di input. La trascrizione può essere conservata e riutilizzata per altre domande.
7. Mettere il documento in cache e usare il batch per ciò che può aspettare. Con un punto di interruzione della cache sul PDF (il marcatore cache_control nell’API di Anthropic), sei domande a Claude Sonnet 5.5 sono costate $0.117 invece di $0.461: la prima richiesta ha scritto 38,364 token in cache e le cinque successive li hanno letti per circa $0.004 ciascuna. L’elaborazione batch è l’unico metodo che non abbiamo misurato. OpenAI, Anthropic e Google indicano tutti un prezzo dimezzato per le rispettive API batch, con risultati entro 24 ore. Anthropic dichiara che lo sconto si cumula con quello della cache.
Una soglia di prezzo da controllare: un PDF di 120 pagine supera i 250,000 token su Claude. Su Claude Haiku 5.5, un prompt oltre 100,000 token viene fatturato a cinque volte il prezzo. Il testo estratto dallo stesso manuale occupa 68,382 token.
Come si gestisce un file Word?
Va convertito. Dei sei modelli testati, solo GPT-6.1 Sol e GPT-6 Luna hanno accettato un .docx come file. Ne hanno letto solo il testo, come documentato da OpenAI per i file diversi dai PDF. Per testo e tabelle basta convertire in Markdown con pandoc: un contratto di nove pagine ha richiesto 3,144 token e tutti i modelli hanno risposto correttamente a 7 domande su 7. Un memo con un grafico incorporato ha ottenuto 2 risposte corrette su 5 con questo metodo e 5 su 5 dopo la conversione in PDF con LibreOffice, usando 1,217 token su Gemini 3.8 Flash e 3,827 su Claude Sonnet 5.5.
Come abbiamo misurato
Dieci documenti: sette generati (un report di 12 pagine, 8 pagine di tabelle finanziarie, una presentazione di 15 slide con grafici, il report scansionato, un manuale di 120 pagine, un contratto Word e un memo Word) e tre pubblici (l’articolo “Attention Is All You Need”, il modulo IRS W-9 e l’AI Risk Management Framework del NIST). A ciascuno abbiamo associato da tre a sette domande con una sola risposta verificabile.
Nel test principale abbiamo inviato ogni documento, con ogni metodo, a ogni modello in una singola richiesta: 568 richieste il 10 ottobre 2026, di cui 566 riuscite (GPT-6 Luna ha rifiutato due volte le 120 immagini di pagina). Per ricavare le regole di conteggio e misurare i costi abbiamo effettuato altre 176 richieste nello stesso giorno, usando un modello economico per fornitore. Tutte le richieste sono passate dall’endpoint chat compatibile con OpenAI del gateway Synthorai, tranne il test della cache (Messages API) e quello di detail (Responses API). Gli importi in dollari si basano sui prezzi di listino.
I conteggi dei token sono quelli riportati dall’endpoint su questo percorso API. Un altro provider dello stesso modello potrebbe pre-elaborare i file in modo diverso: prima di affidarsi a una regola, conviene eseguire il test delle sei pagine sul proprio percorso. Con tre-sette domande per documento, un metodo che ha risposto correttamente a tutto dimostra che il contenuto è leggibile, non che non ci siano perdite.
FAQ
Quanti token occupa una pagina PDF?
Dipende dal fornitore. Inviata come file, una pagina costa i token del testo più circa 15 su GPT-6, il testo più 1,558 su Claude, 515 fissi su Gemini senza costi per il testo, e circa 2,098 più il testo su Qwen 3.8. Una pagina scansionata ha richiesto 2,868 token su GPT-6.1 Sol e 1,579 su Claude Sonnet 5.5.
Costa meno inviare un PDF o il testo estratto?
Per le pagine di solo testo, il testo estratto costa meno o uguale ovunque tranne che su Gemini. Qui una pagina densa richiede meno token come file perché il testo non viene conteggiato. Su GPT-6.1 Sol il file costa quasi quanto il testo. Il testo estratto non permette di rispondere a domande sui grafici o sulle pagine scansionate.
Un LLM può leggere un PDF scansionato?
Sì, se riceve le pagine come file o come immagini. Da una scansione il testo estratto è vuoto e nel nostro test ha prodotto 0 risposte corrette su 105. Eseguendo l’OCR localmente e inviando il risultato abbiamo ottenuto 104 risposte corrette su 105 al prezzo del testo: è il metodo meno costoso per una scansione di testo stampato.
Quali modelli accettano direttamente i file PDF?
Nel nostro test: GPT-6.1 Sol, GPT-6 Luna, i tre modelli Claude 5.5, Gemini 3.1 Pro, Gemini 3.8 Flash, Qwen 3.8 Max e Qwen 3.8 Flash. DeepSeek V4.1 Flash, GLM 5.3 Flash, Kimi K3 e Qwen 3.6 35B hanno accettato le immagini delle pagine, ma non il file.
Come si riduce il costo di un PDF lungo?
Inviando meno pagine, scegliendo il metodo più economico per ciascuna e riutilizzando il contenuto già inviato. Facendo selezionare le pagine rilevanti a un modello economico, una richiesta di 120 pagine su Claude Sonnet 5.5 è scesa da 253,822 a 8,758 token in input. La scelta del metodo per tipo di pagina ha ridotto l’input di un documento misto del 62%-79%. La cache ha ridotto il costo di sei domande sullo stesso documento da $0.461 a $0.117.
Letture correlate
- Quanti token costa un’immagine?: le regole di fatturazione delle immagini, applicate anche alle immagini delle pagine.
- Prezzi di Claude Haiku 5.5: la soglia di 100,000 token che un PDF lungo può superare.
- Costo di scrittura della prompt cache: quanto paga la prima richiesta che mette un documento in cache.