
Jev vs LLM flash: 7x meno sui workflow, stesso costo su 1 label
Indice
- Cos’è Jev e in cosa differisce da un LLM?
- Come abbiamo eseguito i test?
- Quando Jev costa meno di un LLM flash?
- Quanto è più veloce Jev?
- Come si confrontano questi risultati con quelli pubblicati da TypeSafe?
- Jev è accurato quanto un LLM flash?
- Ci si può fidare della confidenza di Jev?
- Conviene usare Jev o un LLM flash?
- FAQ
La convenienza di Jev di TypeSafe rispetto a un LLM flash dipende dal tipo di carico. Con 12 domande per ogni trascrizione del supporto, Jev è costato 7 volte meno di GPT-5.6 Luna con thinking disattivato e, al netto della rete, ha impiegato 0.12 secondi contro 1.66. Su una singola label tra 77 opzioni, è costato quanto Qwen3.8 Flash e GLM 5.3 Flash. Jev è un modello decisionale: invece di generare testo, restituisce una scelta, un punteggio o una probabilità per ogni domanda definita. Lo abbiamo confrontato con cinque modelli chat di fascia flash, sia con le impostazioni di thinking più economiche sia con quelle predefinite, usando quattro test basati su dataset pubblici. È stato il modello più veloce in tutti i test, ma mai il più accurato.
TL;DR
- Con 12 domande per caso, gli LLM flash sono costati da 4.8 a 37 volte più di Jev e hanno impiegato da 11 a 27 volte più tempo, con accuratezza simile.
- Su una label per messaggio, Jev è costato quanto Qwen3.8 Flash e GLM 5.3 Flash con thinking disattivato.
- Con il thinking predefinito, una label è costata sui modelli flash da 1.5 a 26 volte più che su Jev.
- GPT-5.6 Luna è stato più accurato di Jev in tutti i test tranne quello sulla prompt injection.
- Le risposte di Jev con probabilità pari o superiore a 0.99 erano corrette nel 98% dei casi.
Cos’è Jev e in cosa differisce da un LLM?
Jev è il modello “System One” di TypeSafe: legge un testo o un oggetto JSON, chiamato state, e risponde a domande tipizzate senza generare testo da analizzare. Supporta tre tipi di domanda:
| Tipo di domanda | Cosa si chiede | Cosa restituisce |
|---|---|---|
| Noul (il nome usato da TypeSafe per sì/no) | una domanda con risposta sì/no | una probabilità da 0 a 1 |
| Choice | la scelta di una delle massimo 255 opzioni definite dall’utente | l’opzione, la probabilità di ogni opzione e un livello di confidenza |
| Score | una valutazione su una scala ordinata da 2 a 10 livelli definita dall’utente | un punteggio ponderato per probabilità e un livello di confidenza |
Ogni richiesta identifica le domande per nome e riceve una risposta per ciascun nome. Questo esempio, nel formato documentato da TypeSafe (riferimento API), pone tre domande sì/no su una breve conversazione con il supporto:
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {"transcript": "Customer: My card was declined twice today.\nAgent: One moment.\nCustomer: Also, how do I change my PIN?"},
    "questions": {
      "declined_card": {"type": "noul", "instructions": "In `transcript`, does the customer report a declined card payment?"},
      "change_pin":    {"type": "noul", "instructions": "In `transcript`, does the customer want to change a PIN?"},
      "lost_card":     {"type": "noul", "instructions": "In `transcript`, does the customer report a lost or stolen card?"}
    }
  }'
Ecco la risposta ottenuta durante il test:
{
  "model": "jev-1.13.0",
  "answers": {
    "declined_card": {"type": "noul", "noul": 0.99},
    "change_pin":    {"type": "noul", "noul": 0.98},
    "lost_card":     {"type": "noul", "noul": 0.02}
  },
  "usage": {"input_tokens": 359, "output_tokens": 56}
}
Il codice legge answers.<question>.noul e lo confronta con una soglia, come farebbe con qualsiasi altro numero. Il campo model indica la versione che ha prodotto la risposta. L’alias jev-latest viene aggiornato quando TypeSafe pubblica una nuova versione, quindi conviene fissare jev-1.13.0 se le soglie sono state ottimizzate su quella versione.
TypeSafe valuta le domande in parallelo. Jev 1.13 costa $0.042 per milione di token in input e l’output è gratuito (modelli). Il costo per token in input è 3.6 volte inferiore a Qwen3.8 Flash, 4.8 volte inferiore a GPT-5.6 Luna e 18 volte inferiore a Gemini 3.8 Flash. L’input comprende il template interno di TypeSafe, circa 300 token per chiamata, oltre a ogni domanda e opzione definita. La chiamata precedente ha fatturato 359 token in input, pari a $0.000015, mentre i 56 token in output erano gratuiti. TypeSafe documenta i punti deboli di Jev nelle note sulla variabilità del modello: conteggi, aritmetica, confronto tra date, domande con più passaggi e state lunghi pieni di testo irrilevante.
Come abbiamo eseguito i test?
Abbiamo eseguito quattro test, una volta il 2026-09-21 e una volta il 2026-09-22, su Jev e cinque modelli chat flash: GPT-5.6 Luna, Qwen3.8 Flash, GLM 5.3 Flash, DeepSeek V4.1 Flash e Gemini 3.8 Flash. Ogni modello chat è stato eseguito con l’impostazione di thinking funzionante meno costosa, disattivato oppure low quando off non era disponibile. Nei tre test di classificazione lo abbiamo eseguito di nuovo con l’impostazione predefinita del vendor.
- 12 domande per caso: 150 trascrizioni del supporto clienti, ciascuna composta da uno a sei messaggi del dataset Banking77 (PolyAI, CC BY 4.0), con risposte corrette note. Ogni modello risponde a 12 domande sì/no per trascrizione (“il cliente segnala una carta smarrita o rubata?”), fornendo una probabilità per ciascuna. Jev riceve 12 domande Noul in un’unica chiamata, mentre i modelli chat restituiscono un singolo oggetto JSON. Abbiamo ripetuto il test su 60 trascrizioni aggiungendo prima del testo un documento di riferimento da 3,000 e uno da 12,000 token, ricavati da articoli di Wikipedia sul settore bancario.
- Una label: 308 messaggi di Banking77, 4 per ciascuno dei 77 intent. Jev riceve una domanda Choice con 77 opzioni. I modelli chat ricevono lo stesso elenco e rispondono con l’intent.
- 28 label: 200 commenti di GoEmotions (Google, Apache 2.0), ciascuno con 28 possibili emozioni.
- Prompt injection: il test set deepset sulle prompt injection, composto da 116 righe (Apache 2.0), con una domanda sì/no per riga.
Il costo è calcolato moltiplicando il listino di ogni vendor per i token fatturati. La latenza viene da un’esecuzione separata di 40 chiamate per modello su una connessione mantenuta aperta, sottraendo il tempo di round trip della rete. La sezione sulle prestazioni spiega il metodo. Abbiamo eseguito anche GPT-5.6 Terra e Seed 2.0 Mini nei tre test di classificazione. I risultati sono nelle tabelle, ma non nel grafico.
Quando Jev costa meno di un LLM flash?
Quando sullo stesso testo si pongono molte domande, quando il testo è lungo o quando il modello chat userebbe il thinking. Con una sola label su un testo breve e un modello economico con thinking disattivato, il costo è lo stesso.
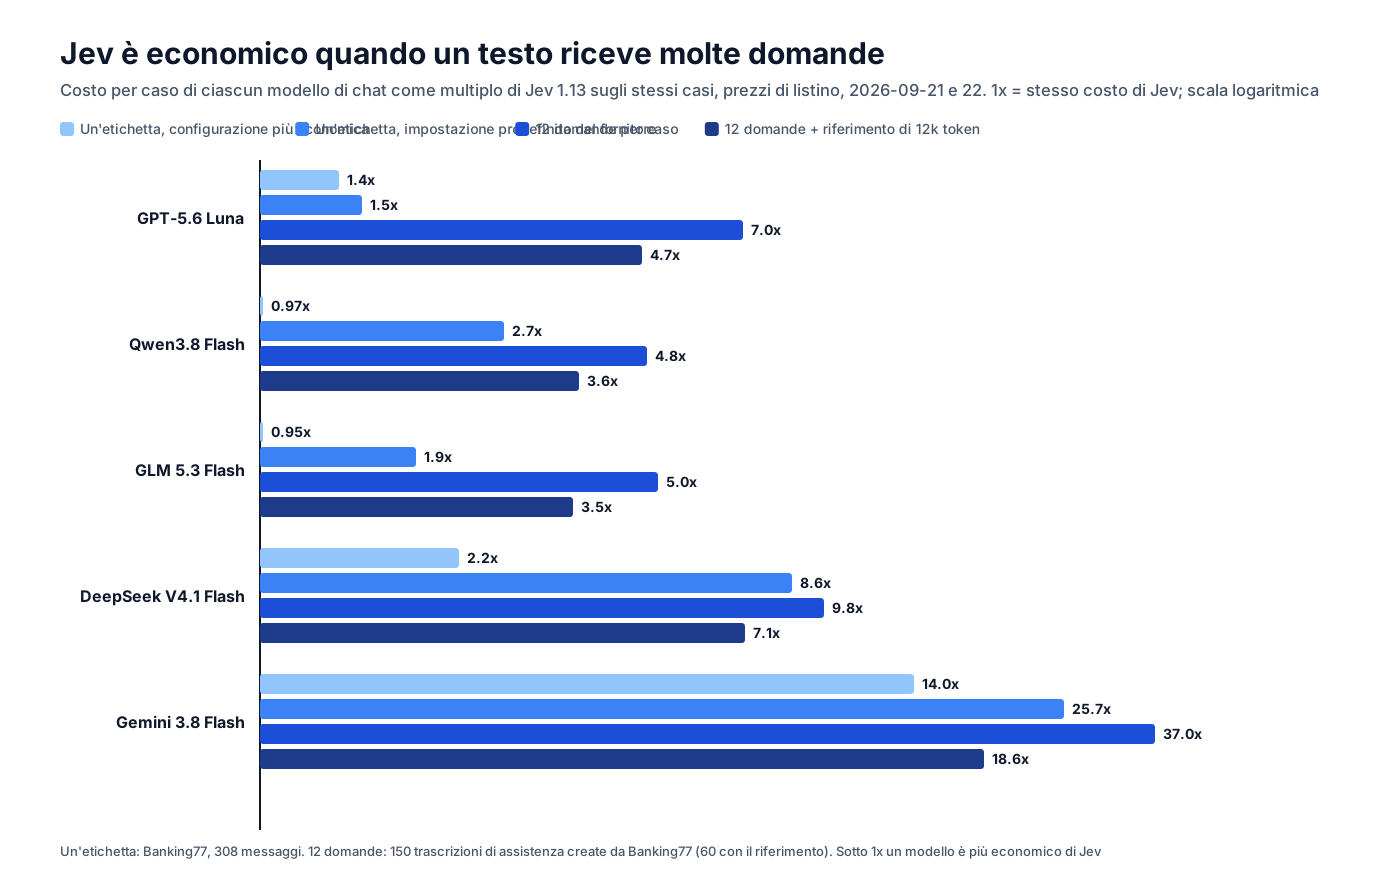
Il multiplo dipende da tre fattori. Il primo è il numero di domande: un modello chat deve generare una risposta per ciascuna domanda e l’output è la parte costosa, per esempio GPT-5.6 Luna addebita $1.20 per milione di token in output contro $0.20 per l’input. Le risposte di Jev sono invece gratuite e ogni domanda aggiuntiva richiede circa 17 token in input. Il secondo è il thinking: con le impostazioni predefinite dei vendor, i modelli chat hanno generato una mediana massima di 161 token in output per label, contro i 3-8 con thinking disattivato. Di conseguenza è aumentato anche il multiplo rispetto a Jev. Il terzo è la lunghezza dell’input: con un riferimento da 12,000 token, il peso del template fisso e delle risposte diventa trascurabile e il multiplo si avvicina al rapporto tra i prezzi dell’input. Si va da 3.5 volte per GLM 5.3 Flash a 18.6 volte per Gemini 3.8 Flash, con DeepSeek V4.1 Flash a 7.1 volte.
Il test con una sola label è il caso in cui Jev non offre risparmi rispetto ai modelli più economici. Le 77 opzioni aggiungono circa 1,400 token a ogni chiamata, quindi un messaggio di una riga fattura circa 1,690 token in input su Jev contro 440 su Qwen3.8 Flash.
| Test, costo per 1,000 casi | Jev | Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| 12 domande per caso | $0.027 | $0.19 | $0.13 | $0.14 | $0.27 | $1.02 |
| 12 domande, riferimento da 12,000 token | $0.43 | $2.02 | $1.57 | $1.53 | $3.06 | $8.06 |
| Una label, impostazione più economica | $0.071 | $0.098 | $0.069 | $0.068 | $0.16 | $0.99 |
| Una label, impostazione predefinita del vendor | $0.071 | $0.11 | $0.19 | $0.13 | $0.61 | $1.83 |
Quanto è più veloce Jev?
Da 7 a 28 volte circa, escludendo la rete: la mediana di Jev è stata tra 0.11 e 0.12 secondi, mentre i modelli chat hanno impiegato da 0.79 a 3.25 secondi.
Abbiamo cronometrato 40 chiamate per modello e attività, una alla volta su una connessione tenuta aperta, e sottratto il tempo di andata e ritorno misurato sulla stessa connessione con una richiesta che non esegue alcun calcolo del modello. Resta il tempo del modello stesso più il percorso dal nostro proxy al suo fornitore, uguale per tutti i modelli.
| Secondi al netto della rete, mediana (95° percentile) | Jev | GPT-5.6 Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Una label, impostazione più economica | 0.11 (0.21) | 1.33 (1.80) | 0.96 (1.68) | 1.22 (3.06) | 0.79 (1.35) | 1.95 (3.76) |
| Una label, impostazione predefinita del vendor | 0.11 (0.21) | 1.45 (5.29) | 3.25 (21.5) | 2.97 (7.32) | 1.19 (10.4) | 2.18 (8.22) |
| 12 domande per caso | 0.12 (0.20) | 1.66 (2.56) | 3.21 (5.21) | 3.13 (6.20) | 1.33 (1.70) | 2.14 (2.89) |
Il 95° percentile mostra l’impatto del thinking: con le impostazioni predefinite del vendor, una chiamata Qwen3.8 Flash su venti ha impiegato più di 21 secondi per una sola label. Le chiamate più lente di Jev sono rimaste vicine a 0.2 secondi.
Aggiungere domande non ha rallentato Jev: su un singolo ticket di supporto, passare da 1 a 60 domande sì/no ha spostato la mediana di meno di 0.1 secondi, e la chiamata con 60 domande ha fatturato 1,371 token in input, $0.000058. Nelle chiamate con 20 domande, tutte le risposte erano corrette in tutte e cinque le esecuzioni.
Come si confrontano questi risultati con quelli pubblicati da TypeSafe?
La tendenza è la stessa, ma i vantaggi che abbiamo misurato sono più contenuti perché i confronti sono diversi. Nel post di lancio, TypeSafe dichiara fino a 444.6 volte meno costi e una velocità fino a 193.6 volte superiore. Il confronto è stato eseguito contro modelli frontier con reasoning attivo su workflow con più passaggi, e TypeSafe definisce questi numeri “la fascia alta dei guadagni reali” (post di lancio).
Le valutazioni sui workflow pubblicate includono GPT-5.6 Luna: Jev ottiene un’accuratezza del 67.8%, con $0.0004 e 0.4 secondi per caso, contro il 66.8%, $0.0033 e 12.9 secondi di Luna. Jev risulta quindi circa 8 volte più economico e 32 volte più veloce. Nel nostro test con 12 domande, Luna con thinking disattivato è costato 7 volte più di Jev e, al netto della rete, ha impiegato 14 volte il tempo. L’ordine di grandezza è lo stesso. Con i modelli flash più economici su una sola label, la differenza di costo scompare.
Jev è accurato quanto un LLM flash?
Nel test sui workflow è vicino, nei test di classificazione resta indietro e non arriva mai primo. Con 12 domande per caso, il micro F1 di Jev, calcolato su ogni sì e no di tutte le domande e con 1.0 come risultato perfetto, rientra nell’intervallo dei modelli chat. Le sue probabilità distinguono le risposte corrette da quelle errate quasi quanto i modelli migliori.
| 12 domande per caso (150 trascrizioni) | Micro F1 con soglia 0.5 | Tutte le 12 risposte corrette | AUC |
|---|---|---|---|
| Jev 1.13 | 0.909 | 61.3% | 0.990 |
| GPT-5.6 Luna, thinking disattivato | 0.933 | 71.3% | 0.973 |
| GPT-5.6 Luna, impostazione predefinita | 0.931 | 71.3% | 0.992 |
| Gemini 3.8 Flash, low | 0.919 | 66.7% | 0.974 |
| Qwen3.8 Flash, thinking disattivato | 0.913 | 62.7% | 0.975 |
| GLM 5.3 Flash, low | 0.906 | 64.7% | 0.975 |
| DeepSeek V4.1 Flash, thinking disattivato | 0.896 | 60.0% | 0.958 |
L’AUC misura quanto bene le probabilità ordinano i risultati: 1.0 significa che ogni vero “sì” ha ricevuto una probabilità superiore a ogni “no”. Aggiungendo prima del testo il riferimento da 12,000 token, l’accuratezza di Jev è rimasta stabile: F1 0.914 contro 0.922 sulle stesse 60 trascrizioni senza il riferimento.
Nei test di classificazione i modelli chat hanno ottenuto risultati migliori, soprattutto con le impostazioni di thinking predefinite:
| Modello e impostazione | Una label (Banking77) | 28 label (GoEmotions micro F1) | Prompt injection |
|---|---|---|---|
| Jev 1.13 | 80.2% | 0.228 | 74.1% |
| GPT-5.6 Luna, thinking disattivato / predefinito | 85.1% / 87.3% | 0.301 / 0.342 | 69.6% / 72.2% |
| GPT-5.6 Terra, thinking disattivato / predefinito | 83.4% / 85.4% | 0.273 / 0.324 | 80.9% / 79.1% |
| Gemini 3.8 Flash, low / predefinito | 84.4% / 83.8% | 0.373 / 0.372 | 81.9% / 82.8% |
| Qwen3.8 Flash, disattivato / predefinito | 77.6% / 81.5% | 0.286 / 0.338 | 81.9% / 80.2% |
| GLM 5.3 Flash, low / predefinito | 77.9% / 79.9% | 0.255 / 0.310 | 81.9% / 81.9% |
| DeepSeek V4.1 Flash, disattivato / predefinito | 77.3% / 81.8% | 0.289 / 0.365 | 82.8% / 86.2% |
| Seed 2.0 Mini, thinking disattivato | 70.8% | 0.245 | 66.4% |
GPT-5.6 Luna e Terra hanno risposto a 115 dei 116 testi di injection e a 199 dei 200 commenti. Una richiesta per ciascun test ha restituito un errore, quindi l’accuratezza è calcolata sulle risposte ricevute. Una risposta diversa da sì o no è stata considerata errata. Nel test sulle emozioni, Jev ha risposto sì troppo spesso: un’emozione a cui assegnava una probabilità tra 0.80 e 0.95 compariva nella label umana solo nel 15% dei casi. Le label delle emozioni sono sparse, perché gli annotatori ne hanno selezionate una o due per commento, e questo riduce il punteggio di tutti i modelli. Tutti, però, hanno ricevuto la stessa istruzione. Nel test sulla prompt injection, la soglia predefinita di 0.5 non era adatta a Jev, come mostra la sezione successiva.
Ci si può fidare della confidenza di Jev?
Le probabilità distinguono bene le risposte corrette da quelle errate, ma non sono calibrate nel senso comune del termine. Ogni task richiede quindi una soglia specifica. Se fossero calibrate, un valore di 0.8 corrisponderebbe a una risposta corretta nell’80% dei casi. Su Banking77, Jev è stato corretto nel 98% dei casi con probabilità pari o superiore a 0.99, ma solo in circa metà dei casi sotto 0.8.
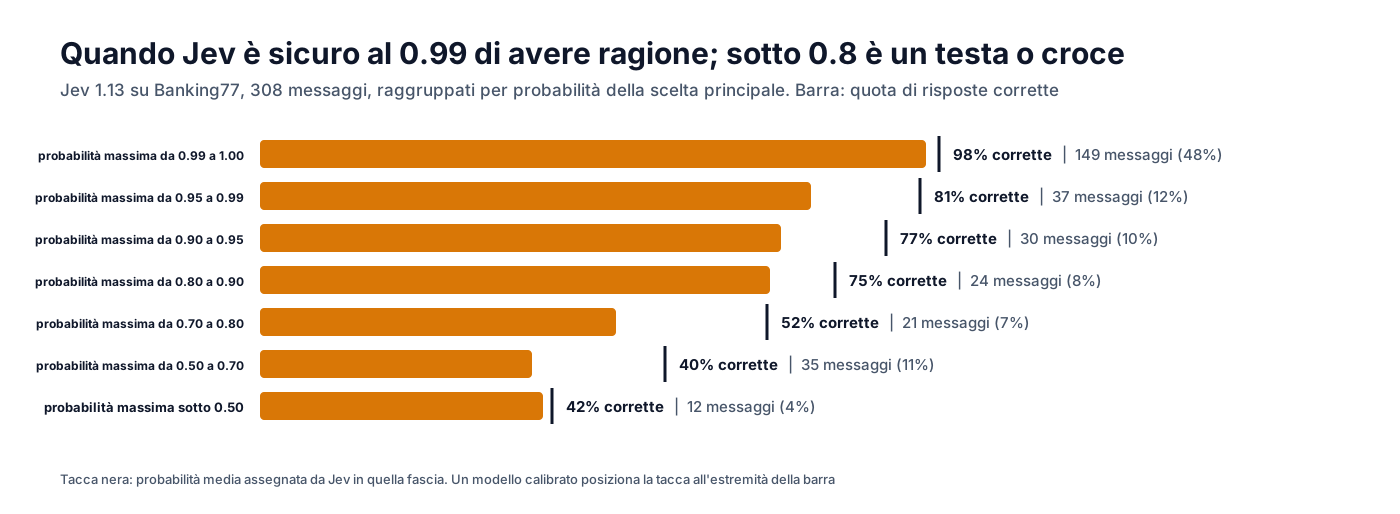
Quasi metà dei messaggi di Banking77, il 48%, ha ricevuto una probabilità massima di almeno 0.99. Una pipeline può quindi accettare questi risultati e inviare gli altri a un modello più grande, mantenendo un’accuratezza del 98% su quella quota di traffico. Il test sulla prompt injection mostra il caso opposto. Con la soglia predefinita di 0.5, Jev ha rilevato solo metà degli attacchi. L’altra metà ha ricevuto probabilità comprese tra 0.03 e 0.5, valori bassi in assoluto ma perlopiù superiori a quelli dei testi benigni, la cui mediana era 0.02. Ordinando i testi per probabilità, Jev ha separato attacchi e contenuti benigni con un’AUC di 0.984.
| Soglia sul set di injection | Accuratezza di Jev | Attacchi rilevati | Falsi allarmi (su 56 testi benigni) |
|---|---|---|---|
| 0.5 (predefinita) | 74.1% | 50.0% | 0 |
| 0.1 | 88.8% | 80.0% | 1 |
| 0.05 | 93.1% | 91.7% | 3 |
Queste soglie sono state scelte sugli stessi 116 testi, quindi vanno considerate un limite superiore. Anche un modello chat può fornire una probabilità se la sua API restituisce le log-probability dei token, cioè la probabilità assegnata dal modello a ogni token generato. Tra i modelli chat testati, Qwen3.8 Flash e Seed 2.0 Mini le hanno restituite. La probabilità del token “yes” di Qwen3.8 Flash ha ordinato i testi di injection con un’AUC di 0.977.
Conviene usare Jev o un LLM flash?
| Se il carico richiede | Modello consigliato | Motivo, in base a questi test |
|---|---|---|
| molte domande sì/no o a scelta singola sullo stesso testo | Jev | da 4.8 a 37 volte meno costoso, da 11 a 27 volte più veloce al netto della rete, con accuratezza simile |
| una decisione in un loop che deve arrivare in meno di un secondo | Jev | da 0.11 a 0.12 s al netto della rete |
| documenti lunghi con poche valutazioni ciascuno | Jev | il costo si assesta vicino al rapporto tra i prezzi dell’input, da 3.5 a 18.6 volte inferiore |
| una label per messaggio breve, al costo minimo | Jev, Qwen3.8 Flash o GLM 5.3 Flash con thinking disattivato | il costo è lo stesso; gli LLM non restituiscono probabilità se non si leggono le log-probability |
| la label più accurata | GPT-5.6 Luna con l’impostazione predefinita | 87.3% su Banking77 a $0.11 per 1,000 |
| numeri, date, conteggi o generazione di testo | un modello chat | TypeSafe li indica tra i punti deboli di Jev |
La strategia che ha sfruttato meglio Jev nei nostri test è questa: scomporre la decisione in molte domande mirate sullo stesso testo, agire sulle risposte che superano una soglia ottimizzata sui propri dati annotati e inviare le altre a un modello chat.
FAQ
Cos’è TypeSafe Jev?
Jev è un modello decisionale di TypeSafe che risponde a domande tipizzate, sì/no, scelta singola o valutazione su una scala, relative a un testo. Restituisce probabilità invece di testo generato. Jev 1.13 è la versione corrente, disponibile tramite l’alias jev-latest, al prezzo di $0.042 per milione di token in input, con output gratuito.
Jev costa meno di un LLM? Dipende dal tipo di carico. Con 12 domande per ogni trascrizione del supporto, GPT-5.6 Luna con thinking disattivato è costato 7 volte più di Jev e Gemini 3.8 Flash 37 volte più. Su una singola label tra 77 opzioni, Qwen3.8 Flash e GLM 5.3 Flash con thinking disattivato sono costati quanto Jev.
Jev è più accurato di GPT-5.6 Luna? Non nei nostri test. GPT-5.6 Luna con thinking disattivato ha ottenuto un micro F1 di 0.933 contro 0.909 di Jev nel test con 12 domande per caso, e l’85.1% contro l’80.2% su Banking77. Con le impostazioni predefinite, Jev ha rilevato più prompt injection di Luna con thinking disattivato.
Perché TypeSafe dichiara che Jev costa 444 volte meno? Quel dato confronta Jev con modelli frontier che eseguono reasoning su workflow con più passaggi, e TypeSafe lo definisce il limite superiore. Rispetto ai modelli flash, abbiamo misurato un costo da 4.8 a 37 volte inferiore su un workflow con 12 domande e quasi identico su una singola label.
Le probabilità di Jev sono calibrate? Non nel senso comune del termine. Su Banking77, le risposte con probabilità pari o superiore a 0.99 erano corrette nel 98% dei casi, ma sotto 0.8 lo erano solo in circa metà dei casi. Nel test sulle prompt injection, Jev ha assegnato a metà degli attacchi una probabilità inferiore a 0.5. Per ogni task bisogna ottimizzare la soglia sui propri dati annotati.
Correlati: migliore API per LLM flash nel 2026, confronto degli output strutturati degli LLM, controlli del thinking negli LLM, migliore LLM per caso d’uso.