
GPT-6.1 Terra vs GPT-5.6 Terra e Sol: 192 chiamate API
Indice
- Dove si colloca GPT-6.1 Terra nella gamma OpenAI?
- Cosa mostrano i benchmark ufficiali?
- Come abbiamo testato i livelli di ragionamento?
- Cosa è successo disattivando il ragionamento?
- Come si confrontano i tre modelli sui nostri task?
- Conviene passare da GPT-5.6 Terra a GPT-6.1 Terra?
- Meglio GPT-6.1 Terra o GPT-6.1 Sol?
- Come si imposta il livello di ragionamento nell’API?
- Come convalidare gli importi delle fatture in produzione?
- Domande frequenti
- Conviene passare da GPT-5.6 Terra a GPT-6.1 Terra?
- Meglio GPT-6.1 Terra o GPT-6.1 Sol?
- Posso disattivare il ragionamento per elaborare le fatture?
GPT-6.1 Terra è il modello OpenAI a costo ridotto per i flussi di lavoro visivi. Costa $1 per milione di token di input e $5 per milione di token di output, la metà delle tariffe di GPT-6.1 Sol. Il livello di ragionamento regola l’elaborazione interna prima della risposta. L’impostazione none la disattiva; con le altre impostazioni, i token di ragionamento vengono fatturati come output. Nei nostri test, senza ragionamento il modello ha superato tutti i 16 task su tabelle e selezione di pulsanti, ma solo 3/8 calcoli su immagini di fatture e 0/8 calcoli sugli stessi dati in formato testuale.
TL;DR
- Nel nostro test sintetico, GPT-6.1 Terra
noneha superato 16/16 task su tabelle e screenshot, ma solo 3/8 calcoli su immagini di fatture. - GPT-6.1 Terra
lowha superato 24/24 task su immagini e 7/8 task sulle fatture equivalenti in formato testuale;mediumha ottenuto 24/24 e 8/8. - GPT-6.1 Terra
mediumè costato $0.028290 per 24 immagini; GPT-6.1 Sollowè costato $0.055012. - In un’esecuzione separata a parità di condizioni, GPT-6.1 Terra
mediumè costato $0.028269 per 24 immagini; GPT-5.6 Terra è costato $0.072094.
Dove si colloca GPT-6.1 Terra nella gamma OpenAI?
GPT-6.1 Terra è pensato per il ragionamento visivo, le azioni su interfacce grafiche e la scrittura concisa, a un prezzo inferiore rispetto a GPT-6.1 Sol. OpenAI ha rilasciato Terra il 26 ottobre 2026. La sua guida alla scelta del modello lo consiglia per task ben definiti e con risultati verificabili, tra cui flussi di lavoro su interfacce grafiche e correzioni circoscritte al codice. Sol resta l’opzione più generalista per i progetti complessi.
GPT-5.6 Terra è il riferimento della generazione precedente per valutare un upgrade. Sol è l’alternativa attuale più costosa per scegliere la fascia di modello. Il confronto tra i tre serve quindi a due decisioni:
| Specifica | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Ruolo nel confronto | Riferimento della generazione precedente | Nuovo modello per flussi di lavoro visivi | Opzione più costosa per attività complesse |
| Prezzo input Standard per 1M di token | $2 | $1 | $2 |
| Prezzo output Standard per 1M di token | $12 | $5 | $10 |
| Prezzo lettura input in cache per 1M di token | $0.20 | $0.05 | $0.10 |
| Finestra di contesto | 1,050,000 token | 1,050,000 token | 1,050,000 token |
| Output massimo | 128,000 token | 128,000 token | 128,000 token |
| Livelli di ragionamento | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Ragionamento predefinito | medium | medium | medium |
| Modalità di input / output | Testo e immagini / testo | Testo e immagini / testo | Testo e immagini / testo |
| Endpoint usato nei test | Responses API | Responses API | Responses API |
Fonti: documentazione ufficiale di GPT-5.6 Terra, GPT-6.1 Terra, Sol e registro dei rilasci. I prezzi indicati valgono per le richieste Standard con un massimo di 272,000 token di input. Oltre questa soglia, le tariffe dell’input non in cache raddoppiano e quelle dell’output aumentano del 50% per l’intera richiesta. Le scritture in cache hanno prezzi separati; nessuna delle richieste principali misurate ha riportato letture o scritture in cache.
Il nuovo Terra mantiene la finestra di contesto, il limite di output e i nomi dei livelli di ragionamento della generazione precedente. Il prezzo di listino dell’input scende del 50% e quello dell’output del 58.3%. Il test di upgrade a parità di condizioni, descritto più avanti, distingue l’effetto di questi tagli da quello delle variazioni nell’uso dei token e nella correttezza dei risultati.
Cosa mostrano i benchmark ufficiali?
Al lancio, OpenAI confronta GPT-6.1 Terra con GPT-5.6 Terra e GPT-6.1 Sol. Questi sono i risultati effettivamente riportati nell’annuncio:
| Valutazione | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam: flussi di lavoro visivi professionali | Riferimento; punteggio assoluto non dichiarato | A medium, +15 punti percentuali rispetto al predecessore a circa un terzo del costo per task | Punteggio assoluto non dichiarato |
| MMMU-Pro: ragionamento visivo | Inferiore al nuovo Terra a ogni livello riportato; punteggi non dichiarati | Quasi alla pari con Sol; punteggi non dichiarati | Descritto come quasi raggiunto dal nuovo Terra; punteggio non dichiarato |
| Terminal-Bench 4.0: task di programmazione da terminale | Punteggio pubblicato 21.5%; livello non specificato | 50.3% a max | Punteggio non dichiarato |
| Test interno di accuratezza fattuale: un tasso di errore inferiore è migliore | 53.6% di errori a low | 16.7% di errori a low | Tasso di errore a low non dichiarato |
Fonte: valutazioni di lancio di OpenAI. I punteggi mancanti non sono stati pubblicati; la valutazione dell’accuratezza fattuale è interna. I nostri test API affrontano le decisioni di upgrade e di fascia usando gli stessi task sintetici.
Come abbiamo testato i livelli di ragionamento?
Abbiamo testato GPT-6.1 Terra a none, low e medium, insieme a GPT-6.1 Sol a low, con 32 input per configurazione: 24 immagini e otto controlli testuali equivalenti. Lo studio principale comprende quindi 128 chiamate. Un confronto di upgrade separato ha alternato GPT-5.6 Terra e nuove risposte di GPT-6.1 Terra a medium sugli stessi 32 input, aggiungendo 64 chiamate per un totale di 192. La tabella dell’upgrade usa solo questo lotto separato.
| Famiglia di task | Input per configurazione | Risultato richiesto |
|---|---|---|
| Immagini di fatture | 8 | Moltiplicare le voci, sottrarre uno sconto, calcolare e arrotondare l’imposta, sottrarre un acconto |
| Tabelle da filtrare | 8 | Aggregare i dati della regione e del trimestre richiesti, poi calcolare un tasso di reso |
| Screenshot di applicazioni | 8 | Individuare l’ID del controllo corretto e un punto all’interno del relativo pulsante tra schede simili |
| Controlli testuali delle fatture | 8 | Calcolare gli stessi valori della fattura da una trascrizione esatta |
Abbiamo generato documenti fittizi con risultati noti, usando tre template con valori o layout variabili. Ogni immagine aveva una risoluzione di 960 per 640 pixel ed è stata inviata con detail: "high". Le versioni immagine e testo di ogni fattura usavano le stesse istruzioni, lo stesso schema e le stesse regole di calcolo. Per ogni input abbiamo ottenuto una risposta per configurazione.
Il test è stato eseguito il 29 ottobre 2026 tramite Synthorai, con richieste Responses in streaming, un limite comune di 4,096 token di output e configurazioni alternate. Tutte le 128 risposte principali sono state completate e hanno restituito JSON conformi allo schema. Per considerare un task esattamente corretto, tutti i valori richiesti dovevano coincidere; le coordinate degli screenshot dovevano ricadere nel pulsante corretto. La valutazione è stata eseguita in codice, usando centesimi interi e arrotondamento decimale, senza un modello come giudice.
Queste 24 immagini rappresentano tre template di task, non 24 tipi diversi di attività. I sedici confronti appaiati tra lo studio principale e quello di upgrade, corretti congiuntamente con il metodo di Holm per tenere conto dei test multipli, non hanno prodotto alcun p-value corretto inferiore a 0.05. I conteggi riportati descrivono questa esecuzione; non dimostrano una classifica generale della qualità né l’equivalenza tra i modelli.
Cosa è successo disattivando il ragionamento?
GPT-6.1 Terra a none ha sbagliato cinque degli otto calcoli su immagini di fatture e tutti gli otto calcoli sulle fatture testuali. Nello stesso test dei livelli di ragionamento, low ha ottenuto 8/8 sulle immagini delle fatture e 7/8 sui controlli testuali; medium ha ottenuto 8/8 su entrambi. I risultati tra modelli sono raccolti nella tabella a tre modelli più avanti.
Gli errori sugli input solo testuali mostrano che la lettura delle immagini non può spiegare tutti i fallimenti. Gli otto input appaiati non dimostrano un vantaggio del formato immagine.
Una fattura rende concreto il problema:
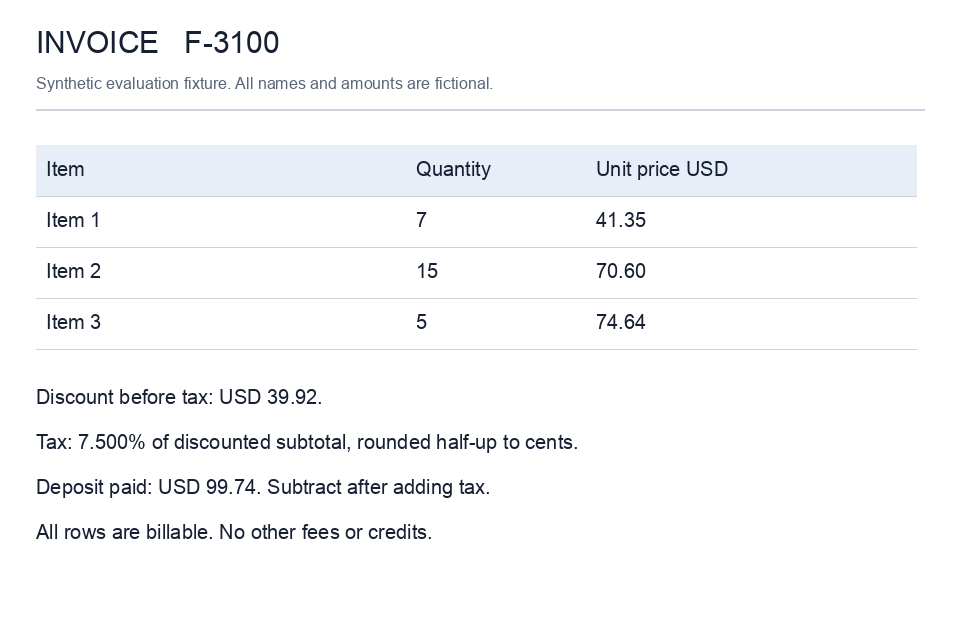
Le voci sono 7 × $41.35, 15 × $70.60 e 5 × $74.64. Il subtotale è $1,721.65. Dopo lo sconto di $39.92, l’imposta del 7.5%, arrotondata per eccesso in caso di metà esatta, è $126.13; sottraendo l’acconto di $99.74 restano $1,708.12 da pagare.
Sulla versione testuale, Terra low ha restituito un subtotale di $1,711.65, un’imposta di $125.38 e un saldo di $1,697.37. Il JSON rispettava lo schema, ma i calcoli erano sbagliati. Aumentare il livello di ragionamento è una variabile da valutare; un output tipizzato, da solo, non convalida un importo.
Nel test principale originale, tutte e quattro le configurazioni hanno superato gli otto task sulle tabelle da filtrare e gli otto sulla selezione dei pulsanti. Quei template non hanno evidenziato differenze di qualità in quel test; le differenze nel numero di task completati correttamente dipendono dagli errori sulle fatture.
Come si confrontano i tre modelli sui nostri task?
GPT-5.6 Terra e GPT-6.1 Terra sono stati confrontati a medium; GPT-6.1 Sol ha usato low per il confronto pratico tra fasce. Per la raccomandazione principale tra fasce usiamo Terra medium, perché sulle fatture testuali ha ottenuto 8/8 contro 7/8 a low; per Sol usiamo il livello low testato. Confrontiamo quindi configurazioni candidate con livelli diversi, non la qualità a parità di ragionamento. La differenza di un solo task non dimostra che medium sia generalmente più accurato.
Principale indica il test originale dei livelli di ragionamento. Upgrade indica il nuovo confronto tra vecchio e nuovo Terra. Per il nuovo Terra, dove le misure differiscono, la colonna riporta i valori di entrambe le esecuzioni. Le raccomandazioni sull’upgrade usano i valori del test di upgrade; quelle su Terra rispetto a Sol usano i valori del test principale. Nessun rapporto di costo o latenza riportato sotto combina lotti diversi.
| Misura | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Configurazione | medium, test di upgrade | medium, test principale e di upgrade | low, test principale |
| Immagini di fatture corrette | 8/8 | 8/8 in ogni test | 8/8 |
| Fatture testuali equivalenti corrette | 8/8 | 8/8 in ogni test | 8/8 |
| Tabelle filtrate corrette | 8/8 | 8/8 in ogni test | 8/8 |
| Task su screenshot interamente corretti | 2/8 | 8/8 in ogni test | 8/8 |
| Tutti i task su immagini corretti | 18/24 | 24/24 in ogni test | 24/24 |
| Costo per 24 immagini | $0.072094 | Principale: $0.028290; upgrade: $0.028269 | $0.055012 |
| Stessi consumi su immagini a $1 input / $5 output per 1M di token | $0.033500 | Principale: $0.028290; upgrade: $0.028269 | $0.027506 |
| Costo per task su immagine corretto | $0.004005 | Principale: $0.001179; upgrade: $0.001178 | $0.002292 |
| Tempo di risposta mediano sulle immagini | 2.57 s | Principale: 5.75 s; upgrade: 6.43 s | 4.51 s |
Il costo per task corretto è il costo totale diviso per il numero di risposte interamente corrette. Include il costo delle risposte errate, senza simulare nuovi tentativi. Usiamo i consumi restituiti dall’API alle tariffe Standard fisse, conteggiando il ragionamento nei token di output. Il test separato delle chiamate a funzione è escluso. I tempi di risposta sono end-to-end attraverso il gateway; l’infrastruttura di serving non è stata mantenuta costante in modo indipendente.
Nei sei fallimenti del vecchio Terra, le coordinate restituite erano tutte all’interno del pulsante corretto, ma il modello ha inventato ID come cobalt-edit invece di leggere l’ID del controllo stampato. Sono errori di corrispondenza esatta del campo. Nel test di upgrade, entrambe le generazioni hanno calcolato correttamente tutte le fatture a medium.
Nel test principale dei livelli di ragionamento, il nuovo Terra none è costato $0.024275 per le 24 immagini, con 19/24 risultati corretti, contro $0.027835 e 24/24 per low. Il costo osservato per task su immagine corretto è quindi $0.001278 per none e $0.001160 per low. Su questo insieme, la minore spesa totale di none non si è tradotta in un costo inferiore per risultato corretto.
Conviene passare da GPT-5.6 Terra a GPT-6.1 Terra?
Vale la pena valutare GPT-6.1 Terra come upgrade da GPT-5.6 Terra quando contano il costo di inferenza o l’estrazione esatta di campi dalle immagini. Nel test a parità di condizioni a medium, il costo dei task su immagini è sceso del 60.8%, con 24/24 risultati interamente corretti contro 18/24. I sei risultati diversi riguardano gli ID dei controlli stampati; dopo la correzione statistica, il campione non dimostra una superiorità generale nella qualità.
La tariffa attuale del vecchio modello è $2 per l’input e $12 per l’output per milione di token. Il nuovo Terra riduce questi prezzi del 50% e del 58.3%. Applicando a entrambi la tariffa comune $1/$5, i consumi dei task su immagini del nuovo modello costano comunque il 15.6% in meno. I conteggi di input erano simili, 20,765 contro 20,789 token; l’output è sceso da 2,547 a 1,496 token.
Per l’elaborazione interna di documenti o l’estrazione di campi con convalida, provate il nuovo modello al livello di ragionamento già in uso e verificate ID e importi esatti prima di passare in produzione. Per le interazioni sensibili alla latenza, mantenete il vecchio modello come riferimento finché il nuovo non rispetta il tempo di risposta richiesto dall’applicazione: in questo test, la latenza mediana sulle immagini è stata di 2.57 secondi per il vecchio modello e 6.43 per il nuovo. Per le fatture che possono attivare pagamenti, mantenete calcoli deterministici e controlli di approvazione con entrambe le generazioni.
Meglio GPT-6.1 Terra o GPT-6.1 Sol?
GPT-6.1 Terra medium è il candidato meno costoso per questi task visivi circoscritti; GPT-6.1 Sol low resta il termine di confronto quando contano i tempi di risposta o le attività più complesse. Nel test principale, entrambi hanno completato correttamente 24/24 immagini, con un costo di $0.028290 contro $0.055012. Il risparmio osservato del 48.6% è interamente spiegato dalle tariffe input/output di Terra, inferiori del 50%: applicando $1/$5 ai consumi di Sol si ottengono $0.027506, leggermente meno dei $0.028290 di Terra.
Per l’estrazione batch con convalida, valutate prima Terra su esempi locali e confrontate i tipi di errore. Per un flusso interattivo, confrontate la mediana osservata di Sol, 4.51 secondi, con i 5.75 secondi di Terra rispetto all’obiettivo di latenza effettivo del prodotto. La programmazione complessa e i progetti con agenti a obiettivi aperti richiedono una valutazione rappresentativa che vada oltre questi tre template; la guida di OpenAI alla scelta del modello colloca Sol nelle attività complesse. Lo stesso numero di risultati corretti non dimostra un’equivalenza generale.
Come si imposta il livello di ragionamento nell’API?
Per GPT-6.1 Terra, impostate esplicitamente reasoning.effort e controllate sia la risposta sia i consumi restituiti. La guida a GPT-6 indica medium come valore predefinito e richiede Responses per le chiamate agli strumenti. I token di ragionamento consumano il budget di output e vengono fatturati all’interno dei token di output, senza essere aggiunti una seconda volta.
Questo esempio Python mostra un approccio di estrazione per la produzione, non riproduce il benchmark di calcolo. Installate openai, impostate OPENAI_API_KEY e salvate la fattura mostrata come invoice.png. Richiedete le voci e le regole stampate, lasciando a null i campi assenti. La regola supportata qui prevede uno sconto prima dell’imposta, l’arrotondamento ai centesimi per eccesso in caso di metà esatta e un acconto dopo l’imposta.
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
Abbiamo anche eseguito un test locale separato delle chiamate a funzione per le quattro configurazioni principali originali (nuovo Terra a none/low/medium e GPT-6.1 Sol a low): selezionare un controllo nello screenshot, leggere la selezione effettivamente memorizzata e restituire un risultato verificato. Tutte e quattro hanno completato correttamente la sequenza forzata di tre turni, per 12 turni API. I risultati delle funzioni usavano ID di chiamata corrispondenti e gli elementi di output venivano reinviati. È un test locale di compatibilità, non un benchmark di autonomia su desktop.
Come convalidare gli importi delle fatture in produzione?
Per la registrazione contabile delle fatture e i pagamenti, estraete operandi tipizzati e calcolate i totali con codice deterministico. Convalidate i campi di origine e richiedete un’approvazione prima di movimentare denaro, indipendentemente dal modello che vince il confronto su costo o latenza.
Eseguite questo blocco dopo l’esempio di estrazione. Rifiuta gli input mancanti o non supportati e calcola i totali della fattura mostrata. I centesimi interi evitano gli errori della virgola mobile binaria; Decimal applica la regola di arrotondamento dell’imposta dichiarata.
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
L’output è pronto per la revisione, non per la registrazione automatica. I controlli sui tipi e sulle regole non possono stabilire se un prezzo sia stato letto correttamente: confrontate i campi estratti con la fonte e verificate le condizioni ambigue prima di approvare un pagamento. L’esempio di estrazione è un approccio implementativo; le nostre 192 chiamate misurate hanno testato i prompt di calcolo descritti sopra.
Per altre misurazioni, consultate la guida alla fatturazione degli input immagine, i test di costo delle rappresentazioni PDF e il confronto tra modelli allo stesso prezzo.
Domande frequenti
Conviene passare da GPT-5.6 Terra a GPT-6.1 Terra?
GPT-6.1 Terra ha ridotto il costo dei task su immagini del 60.8% rispetto a GPT-5.6 Terra a medium nel nostro test a parità di condizioni, oppure del 15.6% applicando a entrambi $1 per l’input e $5 per l’output per milione di token. Entrambi hanno superato tutti i calcoli sulle fatture; il vecchio modello ha sbagliato sei ID di controlli stampati. La latenza mediana osservata, più alta nel nuovo modello, rende la verifica dei tempi di risposta parte della decisione di upgrade.
Meglio GPT-6.1 Terra o GPT-6.1 Sol?
GPT-6.1 Terra medium è costato $0.028290 per 24 task su immagini contro $0.055012 per GPT-6.1 Sol low, con entrambi a 24/24 nel test principale. Valutate Terra per le elaborazioni batch con convalida e confrontatelo con Sol per quelle interattive: i tempi di risposta mediani sono stati rispettivamente 5.75 e 4.51 secondi. Questi task sintetici non dimostrano un’equivalenza generale nella qualità.
Posso disattivare il ragionamento per elaborare le fatture?
GPT-6.1 Terra a none ha risolto correttamente solo 3/8 immagini di fatture e 0/8 calcoli testuali equivalenti nel nostro test principale. Mantenete nel codice i calcoli monetari esatti e convalidate gli operandi estratti. Per task circoscritti su tabelle o selezione di pulsanti, none ha ottenuto 16/16 ed è un candidato da valutare sul carico di lavoro specifico.