
gemini-3.1-flash-lite-image vs Seedream 5.0 Lite
Lequel choisir, et quand
Ces deux modèles facturent dans des unités différentes - gemini-3.1-flash-lite-image facture par token ($0.25 par million en entrée, $30 par million en sortie) tandis que seedream-5-0-260128 facture un tarif fixe de $0.035 par appel - aucune conversion simple entre eux n'est donc honnête ; établissez votre budget en fonction de la taille de vos prompts et de votre volume d'appels. Choisissez le modèle de Google lorsque vous avez besoin d'un retour texte aux côtés des images, car il émet à la fois du texte et des images (jusqu'à 4096 tokens de sortie) à partir d'une entrée texte ou image. Choisissez le modèle de ByteDance pour des tâches pures de texte ou image vers image à un coût par appel prévisible.
Tarifs
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | Δ | |
|---|---|---|---|
| Par image générée | - | $0.035 | - |
| Entrée / 1M de tokens | $0.25 | - | - |
| Sortie / 1M de tokens | $30 | - | - |
Ces deux modèles ne sont pas facturés dans la même unité : aucun Δ n'est donc affiché, car les convertir supposerait une hypothèse que nous n'avons pas mesurée. Chaque grille tarifaire figure ci-dessus dans sa propre unité.
Spécifications
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | |
|---|---|---|
| Modalités d'entrée | texte image | texte image |
| Modalités de sortie | texte image | image |
| Date de sortie | 2026-06-30 | 2026-01 |
| Coupure des connaissances | 2025-01 | - |
| Tailles de sortie | 1K uniquement (1:1 = 1024x1024) |
|
| Modes d'entrée | text-to-image, génération et édition entrelacées, jusqu'à 14 images de référence | text-to-image, image-to-image à image unique, image-to-image multi-référence (2 à 14 références), lots et séries d'images |
| Images par requête | - | 15 |
| Formats | - | png, jpeg |
| Notes | Sortie 1K (1024px) uniquement 10 formats d'image (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) et jusqu'à 14 images de référence génération et édition entrelacées, avec des retouches locales rapides sur plusieurs tours latence de bout en bout inférieure à 2 s filigranes SynthID et C2PA toujours actifs | Sortie 2K/3K/4K, png/jpeg text-to-image et édition d'image à référence unique ou multiple génération par lots, images de référence et générées <=15 500 IPM maximum |
Les spécifications sont reprises de la documentation de chaque fournisseur ; quand un fournisseur ne publie pas une valeur, la ligne est omise et non déduite. Sources complètes : gemini-3.1-flash-lite-image · Seedream 5.0 Lite
Un prompt, deux modèles, mesurés via la passerelle
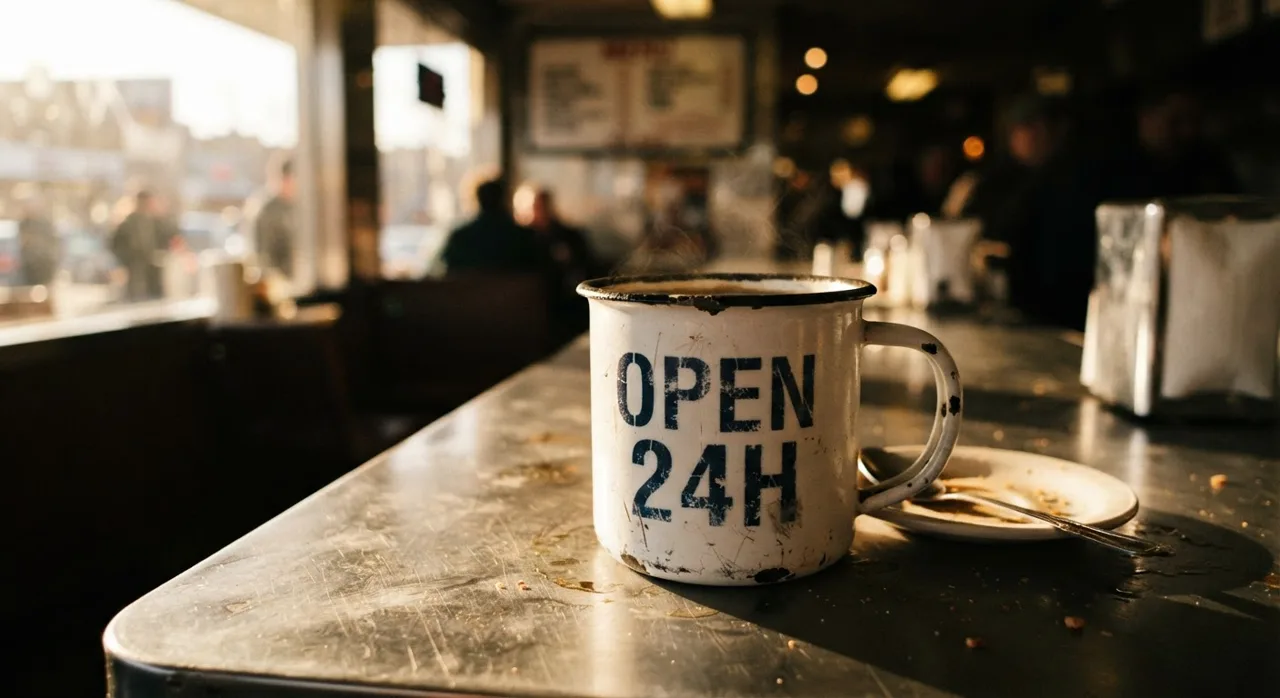
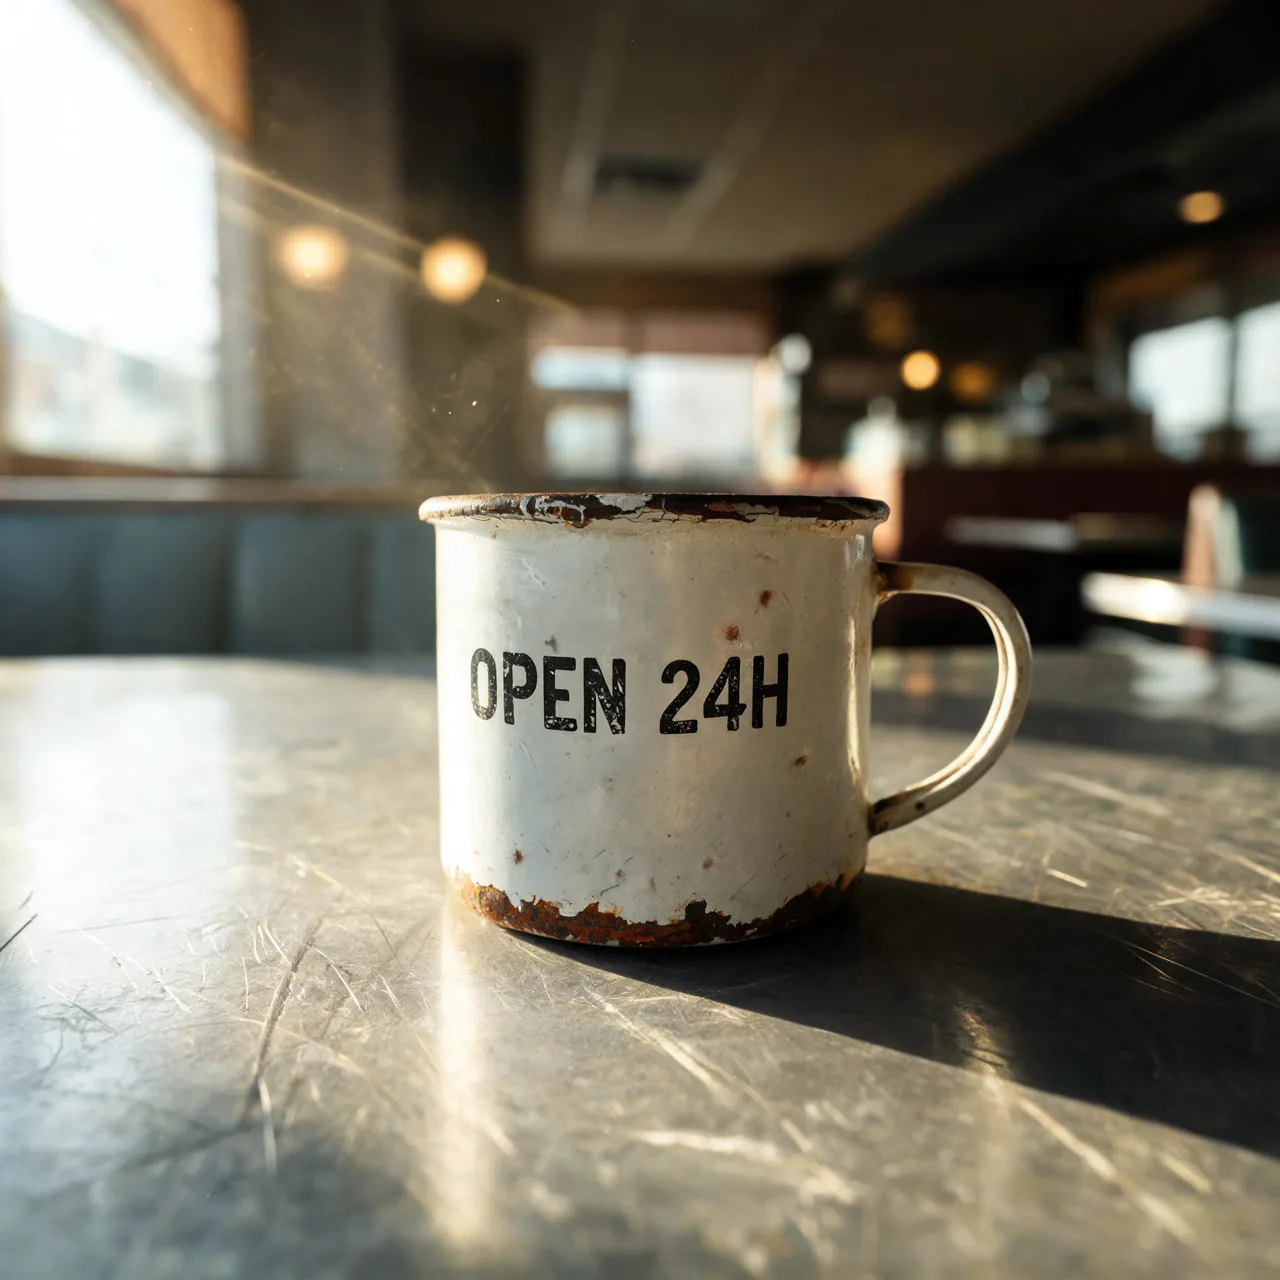
Un prompt, une requête par modèle, sans nouvel essai ni tri des résultats : c'est le premier résultat renvoyé par chaque modèle. Ni la taille ni la durée n'ont été imposées. Chaque modèle a utilisé sa valeur par défaut, car une requête calibrée pour convenir à tous n'en mettrait aucun en valeur. Les fichiers sont réencodés pour le web : jugez la composition et le respect du prompt, pas la compression.
Passez de l'un à l'autre en changeant une seule ligne
Les deux identifiants figurent dans chaque onglet ci-dessous : les deux lignes surlignées sont le seul changement. Même endpoint, même clé, même format de requête.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="seedream-5-0-260128",  # décommentez cette ligne, commentez celle du dessus
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "seedream-5-0-260128", // décommentez cette ligne, commentez celle du dessus
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "seedream-5-0-260128", # décommentez cette ligne, commentez celle du dessus
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "seedream-5-0-260128", // décommentez cette ligne, commentez celle du dessus
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("seedream-5-0-260128") // décommentez cette ligne, commentez celle du dessus
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Lequel est le moins cher, gemini-3.1-flash-lite-image ou Seedream 5.0 Lite ?
Ils ne sont pas facturés dans la même unité, il n'existe donc pas de chiffre unique qui soit honnête : dans le tableau ci-dessus, gemini-3.1-flash-lite-image et Seedream 5.0 Lite apparaissent chacun dans sa propre unité. Comparez-les sur votre charge de travail réelle. Le verdict en haut de cette page décrit le compromis en pratique.
Puis-je faire un test A/B entre gemini-3.1-flash-lite-image et Seedream 5.0 Lite sans deux intégrations ?
Oui. Les deux passent par le même endpoint compatible OpenAI, avec une seule clé API. Pour passer de l'un à l'autre, il suffit de changer l'identifiant du modèle, soit une ligne : vous pouvez donc envoyer une part du trafic à chacun et comparer directement les factures.
Le prix change-t-il avec la taille de l'image ?
Cela dépend du mode de facturation du modèle. Un modèle facturé à l'image coûte le même prix quelle que soit la taille du prompt ou de la sortie. Un modèle facturé au token coûte plus cher à mesure que la résolution générée augmente : une image 4K revient à plusieurs fois le prix d'une petite. Le tableau ci-dessus indique le cas de chacun.