
Mejor API LLM Flash 2026: GLM en valor, Gemini 3.8 en potencia
Contenido
- ¿Cómo se comparan los nueve modelos y cómo los probamos?
- ¿Qué modelos cuentan como Flash y conviene migrar al más nuevo?
- ¿Cuánto cuestan los nueve modelos?
- ¿Qué tipos de entrada admite cada modelo y se puede desactivar el thinking?
- ¿Cuánto cuesta una tarea completa, no un token?
- ¿Qué modelo Flash deberías elegir?
- ¿Qué modelos Flash fallan con la configuración predeterminada?
- ¿Basta un modelo Flash o necesitas el modelo grande?
- ¿Qué falla al poner un modelo Flash en producción?
- Cómo lo gestiona Synthorai
- Preguntas frecuentes
La mejor API LLM de nivel Flash en septiembre de 2026 depende de lo que necesites: GLM 5.3 Flash ofrece la mejor puntuación de benchmark por dólar, Gemini 3.8 Flash es el modelo generalista más potente y la mejor opción para audio y vídeo, Claude Sonnet 5 inventa menos respuestas al precio más alto, y Seed 2.0 Mini es el modelo más barato que superó todas nuestras pruebas. Por nivel Flash entendemos el modelo pequeño y rápido de cada proveedor. Evaluamos dieciséis modelos. Los modelos actuales de todos los proveedores superan a sus predecesores pequeños. Aquí comparamos los nueve actuales por precio de tarifa, coste de caché, tipos de entrada, controles de thinking, benchmarks independientes, coste por tarea y fallos en producción.
TL;DR
- Migra al modelo actual de cada proveedor: Claude Sonnet 5, GPT-5.6 Terra y Gemini 3.8 Flash cuestan más por token que Haiku 4.5, GPT-5.4 mini y Gemini 3.5 Flash-Lite, pero entre 2.5 y 3.9 veces menos por respuesta correcta.
- Mejor relación calidad-precio: GLM 5.3 Flash, con un índice de Artificial Analysis de 41.9 a $0.25 por tarea.
- Más potente y mejor multimodal: Gemini 3.8 Flash.
- Menos respuestas inventadas: Claude Sonnet 5, con el coste por tarea más alto.
- Más barato: Seed 2.0 Mini a $0.10 / $0.40.
¿Cómo se comparan los nueve modelos y cómo los probamos?
Los precios y las funciones proceden de las páginas de los proveedores. Los benchmarks vienen de clasificaciones independientes que ejecutan todos los modelos con el mismo entorno. Nuestra prueba es un filtro de admisión, no un ranking. Usamos el Intelligence Index v4.3 de Artificial Analysis (AA) y su tasa de no alucinación, que mide con qué frecuencia un modelo se niega a responder en vez de adivinar; LiveBench; Vals Index; y las votaciones de texto y WebDev de Arena. Nuestra prueba incluye 11 tareas con un resultado numérico verificable, como contar dígitos, sumar números primos, calcular rutas en una cuadrícula, resolver cambio de monedas, una potencia modular o una mochila. Ejecutamos cada tarea 3 veces. También hicimos cinco preguntas sobre una empresa, un instituto, una localidad, una aleación y un premio inexistentes, y leímos las respuestas completas para comprobar si el modelo se negaba a responder o inventaba. Thinking son los tokens de razonamiento que el modelo genera antes de responder. Se facturan como output y se configuran en cada petición con un campo como reasoning_effort. Ejecutamos todos los modelos con la configuración predeterminada y con todos los niveles de thinking que admiten.
| Modelo | Índice AA | AA no alucinación | LiveBench | Vals Index | Arena texto / WebDev | Nuestra prueba: predeterminado / mejor | Inventadas por defecto |
|---|---|---|---|---|---|---|---|
| GPT-5.6 Terra | 42.3 en max | 12.1 | 77.9 | 59.6 | 1466 / 1521 | 31 / 33 | 2 de 5 |
| GLM 5.3 Flash | 41.9 | 72.4 | 71.6 | 47.2 | 1475 / 1607 | 31 / 31 | 0 de 5 |
| Gemini 3.8 Flash | 41.2 en high | 44.8 | 75.8 | 62.3 | 1493 / 1568 | 32 / 33 | 0 de 5 |
| Qwen3.8 Flash | 39.9 | 54.7 | 76.2 | no aparece | no aparece / 1635 | 33 / 33 | 2 de 5 |
| DeepSeek V4.1 Flash | 39.5 en max | 3.5 | 81.1 | 57.9 | no aparece / 1614 | 33 / 33 | 4 de 5 |
| Claude Sonnet 5 | 38.4 en max | 60.6 | 76.0 | 59.6 | 1461 / 1537 | 33 / 33 | 0 de 5 |
| GPT-5.6 Luna | 37.5 en max | 7.4 | 73.6 | 59.9 | 1453 / 1519 | 31 / 32 | 4 de 5 |
| Hy3 | 25.8 | 25.9 | no aparece | no aparece | 1456 / 1513 | 33 / 33 | 0 de 5 |
| Seed 2.0 Mini | no aparece | no aparece | no aparece | no aparece | no aparece | 33 / 33 | 0 de 5 |
Fuentes consultadas el 2026-09-17: Artificial Analysis, LiveBench, Vals Index, Arena texto y Arena WebDev. Las puntuaciones de Arena siguen un sistema similar a Elo, donde una diferencia de 20 puntos es pequeña. Qwen3.8 Flash aparece como Qwen3.8-Flash-Next, el modelo con pesos abiertos que usa la API. Las mediciones se realizaron los días 2026-09-16 y 17. Volvimos a ejecutar dos modelos el segundo día para confirmar que los resultados eran comparables.
Ningún modelo lidera todas las clasificaciones: Terra encabeza el índice, DeepSeek lidera LiveBench, Gemini 3.8 Flash ocupa el primer puesto de Vals y Arena texto, y Qwen3.8 Flash lidera Arena WebDev. La tasa de no alucinación de AA y nuestras cinco preguntas inventadas coinciden en qué modelos se arriesgan a adivinar: DeepSeek V4.1 Flash, Luna y Terra rara vez se niegan a responder; GLM 5.3 Flash y Sonnet 5 suelen hacerlo. Seed 2.0 Mini no tiene puntuaciones independientes, así que nuestra prueba es la única evidencia disponible.
¿Qué modelos cuentan como Flash y conviene migrar al más nuevo?
El modelo pequeño más reciente de cada proveedor cuenta como Flash, y sí, conviene migrar. Google, DeepSeek, Alibaba, Z.ai, ByteDance y Tencent usan las etiquetas Flash, Mini o comercializan un único modelo barato. La generación actual de Anthropic incluye Fable, Opus y Sonnet. Haiku 4.5 pertenece a la generación anterior, se lanzó en octubre de 2025 y no se retirará antes del 15 de octubre de 2026. Por eso consideramos Claude Sonnet 5 como el nivel Flash de Claude. La documentación de OpenAI sitúa GPT-5.6 Terra en el antiguo nivel mini y GPT-5.6 Luna en nano. Sonnet 5 ($2 / $10) y Terra ($2 / $12) cuestan varias veces más por token que los otros siete y forman una categoría de precio propia.
También evaluamos el modelo pequeño anterior de cuatro proveedores. Para comparar cada pareja calculamos el coste por respuesta correcta: dividimos todo el gasto de las 33 ejecuciones entre las respuestas correctas. Si un modelo acierta la mitad de las veces, cada respuesta cuesta el doble. El modelo actual ganó en todas las comparaciones. En las tres parejas mencionadas en el TL;DR, el modelo nuevo cuesta más por token pero menos por respuesta correcta:
- Claude Sonnet 5 frente a Claude Haiku 4.5. Haiku solo llegó a 32 de 33 con el thinking al máximo. Sonnet 5 obtuvo 33 de 33 con cualquier configuración que activara thinking y, en
max, su opción más barata, costó 2.9 veces menos por respuesta correcta. Ambos rechazaron las cinco preguntas inventadas. - GPT-5.6 Terra frente a GPT-5.4 mini. Mini obtuvo 9 de 33 con la configuración predeterminada y necesitó
highpara llegar a 33. Terra consiguió 33 conlowpor 2.5 veces menos. Terra inventó dos respuestas, mientras que mini rechazó las cinco. - Gemini 3.8 Flash frente a Gemini 3.5 Flash-Lite y Gemini 3.7 Flash. Frente a Flash-Lite, cuesta 3.9 veces menos por respuesta correcta y rechazó las tres preguntas inventadas que Flash-Lite respondió. Flash-Lite solo conserva una ventaja en extracciones de un único paso. Frente a 3.7 Flash, el precio de tarifa es el mismo y 3.8 cuesta alrededor de un 10% más por llamada. La actualización aporta capacidad, no ahorro.
- GPT-5.6 Luna frente a GPT-5.4 nano cuesta aproximadamente un tercio por respuesta correcta con el mismo resultado, 31 de 33. Qwen3.8 Flash frente a Qwen3.6 Flash y Qwen3.5 Flash también gana: los modelos anteriores generan unas diez veces más thinking y cuestan entre 6 y 27 veces más por respuesta correcta.
El resto de esta guía solo cubre los nueve modelos actuales.
¿Cuánto cuestan los nueve modelos?
Los agrupamos en tres franjas según el precio de tarifa del output. La barra muestra el coste medido por respuesta correcta con la mejor configuración de cada modelo. Así se reflejan a la vez un precio de tarifa bajo y un uso caro del thinking. La etiqueta incluye el precio de tarifa y el coste de lectura de caché, expresado como porcentaje del precio del input para un prefijo repetido del prompt.
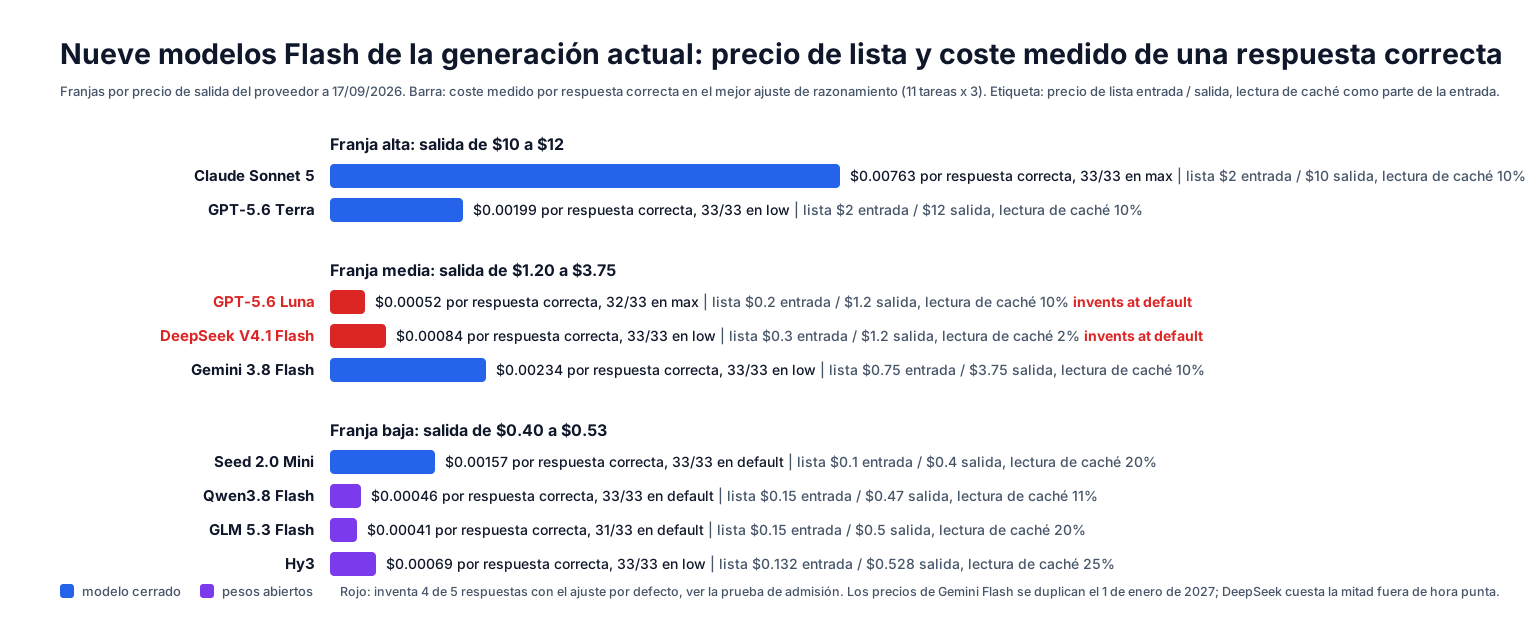
La franja de precio predice mal la factura. GPT-5.6 Terra, situado en la más cara, costó menos por respuesta correcta que Gemini 3.8 Flash y solo alrededor de un 25% más que Seed 2.0 Mini. El gasto de thinking influye tanto como el precio de tarifa. Los precios también cambian con frecuencia y varían según la hora y la región: los precios de Gemini 3.x Flash se duplican el 1 de enero de 2027, con Gemini 3.8 Flash a $1.50 / $7.50; DeepSeek cobra la mitad fuera de 01:00 a 04:00 y de 06:00 a 10:00 UTC entre semana; OpenAI redujo el precio de GPT-5.6 Luna un 80% en julio; y Qwen3.8 Flash cuesta entre un 19 y un 25% menos fuera de la región de Singapur de Alibaba. Tres modelos pequeños actuales no estaban disponibles en Synthorai durante las pruebas y no se midieron: Mistral Small 4 ($0.15 / $0.60), StepFun Step 3.7 Flash ($0.20 / $1.15) y Amazon Nova 2 Lite ($0.30 / $2.50).
¿Qué tipos de entrada admite cada modelo y se puede desactivar el thinking?
Ocho de los nueve admiten imágenes, cuatro aceptan vídeo, dos aceptan audio y Hy3, el Hunyuan 3 de Tencent, solo procesa texto. La última columna indica si una extracción JSON con un schema estricto devolvió los valores correctos en 8 ejecuciones de una extracción de factura.
| Modelo | Entrada | Contexto / output máximo | Pesos abiertos | Thinking desactivable | Thinking predeterminado | JSON con schema |
|---|---|---|---|---|---|---|
| Claude Sonnet 5 | texto, imagen | 1M / 128K | no | sí | adaptive, high | 8/8 mediante tool call |
| GPT-5.6 Terra | texto, imagen | 1.05M / 128K | no | sí | medium | 8/8 |
| Gemini 3.8 Flash | texto, imagen, audio, vídeo, PDF | 1M / 64K | no | no | medium | 8/8 |
| GPT-5.6 Luna | texto, imagen | 1.05M / 128K | no | sí | medium | 8/8 |
| DeepSeek V4.1 Flash | texto, imagen | 1M / 384K | MIT | sí | high | solo json_object, 8/8 |
| Seed 2.0 Mini | texto, imagen, audio, vídeo | 256K / 128K | no | sí | medium | 8/8 |
| Qwen3.8 Flash | texto, imagen, vídeo | 1M / 128K | licencia Qwen | sí | xhigh | 3/8, enteros incorrectos |
| GLM 5.3 Flash | texto, imagen, vídeo, archivo | 1M / 128K | MIT | no | max | solo json_object, 8/8 |
| Hy3 | texto | 256K / 128K | Apache 2.0 | sí | high | solo json_object, 7/8 |
“Mediante tool call” significa que enviamos el schema como input de una herramienta y obligamos a Claude a llamarla. “Solo json_object” significa que el schema estricto no devolvió una respuesta correcta a través de nuestra ruta de petición, pero sí {"type": "json_object"} con las claves indicadas en el prompt. Si necesitas entrada de audio, las opciones son Gemini 3.8 Flash o Seed 2.0 Mini. Para un output superior a 128K, DeepSeek V4.1 Flash. Si necesitas pesos que puedas alojar por tu cuenta, DeepSeek, GLM, Hy3 o Qwen3.8 Flash.
¿Cuánto cuesta una tarea completa, no un token?
El coste de una llamada depende del precio y de los tokens que el modelo decida gastar. En este nivel, el segundo factor varía más que el primero. La métrica pública más justa es el coste de Artificial Analysis por ejecutar una tarea de su índice, contando los tokens de thinking. Hay datos para ocho de los nueve modelos.
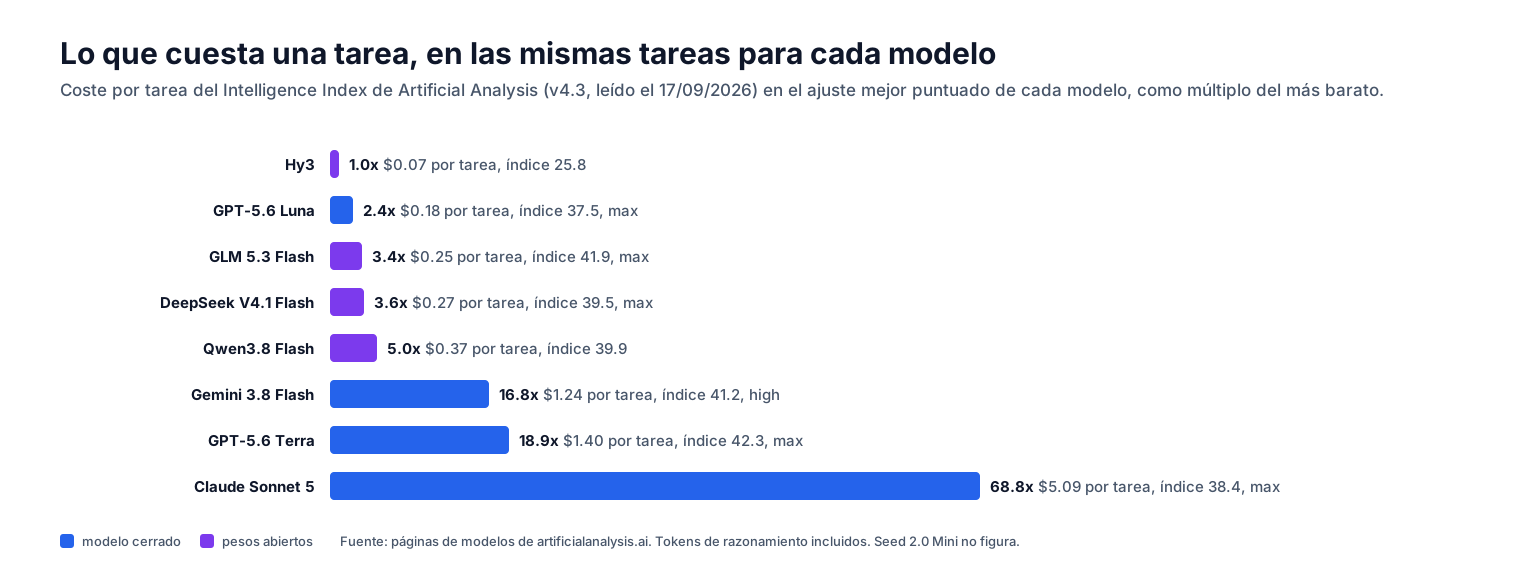
GLM 5.3 Flash queda a menos de medio punto de GPT-5.6 Terra y cuesta una quinta parte por tarea. Qwen3.8 Flash tiene casi el mismo precio de tarifa que GLM, pero cuesta un 50% más por tarea porque generó 240 millones de tokens de output al ejecutar el índice, frente a 180 millones de GLM. Claude Sonnet 5 cuesta $5.09 por tarea en max, frente a $1.79 con el nivel predeterminado high, a cambio de seis puntos adicionales en el índice. Nuestras llamadas individuales muestran el mismo efecto: Seed 2.0 Mini tiene un precio de tarifa menor que Qwen3.8 Flash, pero costó 3.4 veces más por respuesta correcta porque dedicó una mediana de 2,810 tokens de thinking a cada tarea, frente a 530.
Las lecturas de caché cuestan un 2% del input en DeepSeek, alrededor de un 10% en Google, OpenAI, Anthropic y Alibaba, un 20% en Z.ai y ByteDance, y un 25% en Tencent. En tráfico de agentes y RAG, es decir, generación aumentada por recuperación, donde los documentos recuperados se añaden a cada prompt, el precio de lectura determina la factura. Un prefijo en caché de 100K tokens cuesta $0.0006 por llamada en DeepSeek V4.1 Flash, frente a $0.02 en Sonnet 5 o Terra. OpenRouter informó de que el 90% de los tokens servidos por V4.1 Flash durante un día tras su lanzamiento fueron lecturas de caché (publicación). Los niveles batch, que responden en cuestión de horas, reducen a la mitad los precios de Gemini 3.8 Flash, GPT-5.6 Luna, Terra y Sonnet 5. Qwen3.8 Flash, GLM 5.3 Flash y Hy3 no tienen batch.
¿Qué modelo Flash deberías elegir?
GLM 5.3 Flash por relación calidad-precio, Gemini 3.8 Flash por potencia y entrada multimodal, Claude Sonnet 5 por inventar menos respuestas y Seed 2.0 Mini por precio.
| Necesidad | Elección | Motivo |
|---|---|---|
| Mejor relación calidad-precio | GLM 5.3 Flash | índice 41.9, solo por detrás de Terra, a $0.25 por tarea; mayor tasa de no alucinación de los nueve (72.4); $0.15 / $0.50; entrada de imagen, vídeo y archivo; pesos MIT |
| Generalista más potente | Gemini 3.8 Flash | lidera Vals y Arena texto entre los nueve, queda a 1.1 puntos de Terra en el índice y cuesta un 11% menos por tarea; 33 de 33 en low, rechazó todas las preguntas inventadas |
| Mejor multimodal | Gemini 3.8 Flash | entrada de audio, vídeo y PDF, audio al precio del texto; JSON con schema 8 de 8 |
| Menos respuestas inventadas, rápido | Claude Sonnet 5 | 33 de 33 con cualquier configuración que activara thinking, rechazó las cinco preguntas inventadas con thinking activado y desactivado, primer token de respuesta en 2.2 segundos; es el más caro por tarea, así que úsalo cuando una respuesta inventada cueste más que la llamada |
| Más barato | Seed 2.0 Mini | $0.10 / $0.40; 33 de 33 por defecto, JSON con schema 8 de 8, rechazó las cinco preguntas inventadas, entrada de audio y vídeo |
Tres modelos se quedan sin recomendación por un motivo concreto. GPT-5.6 Terra lidera el índice y consiguió 33 de 33 en low por $0.00199 por respuesta correcta, pero inventó dos de cinco respuestas con un precio de $12 por millón de tokens de output. DeepSeek V4.1 Flash lidera LiveBench y ofrece la caché más barata, pero solo admite texto e imágenes e inventó cuatro de cinco respuestas con thinking activado. Qwen3.8 Flash logró la puntuación perfecta más barata de nuestra prueba, $0.00046 por respuesta correcta, y lidera Arena WebDev, pero inventó dos respuestas, escribió enteros incorrectos con un schema estricto y tardó casi tres minutos en generar una explicación de 400 palabras.
En vez de elegir un único modelo, enruta según la petición: tareas cerradas con una respuesta verificable al modelo más barato que las supere (GLM 5.3 Flash, Qwen3.8 Flash, Hy3); preguntas factuales abiertas a un modelo capaz de negarse a responder (GLM 5.3 Flash, Sonnet 5, Gemini 3.8 Flash); ejecuciones largas de agentes al modelo más potente que puedas permitirte.
¿Qué modelos Flash fallan con la configuración predeterminada?
Dos de los nueve. Ambos pasan cuando las preguntas abiertas se envían a una configuración que sabe negarse a responder. Aplicamos estos mínimos de admisión con la configuración predeterminada del modelo: al menos 30 de 33 en las tareas y no más de dos respuestas inventadas de cinco.
| Modelo | Con la configuración predeterminada | Cambio | Resultado tras el cambio |
|---|---|---|---|
| DeepSeek V4.1 Flash | inventó 4 de 5 (“50 empleados”, “1790 °C”, un personaje de Los Simpson como ganador del premio) | desactivar thinking para preguntas abiertas | rechazó 5 de 5, pero obtuvo 21 de 33 en las tareas, así que envíale únicamente preguntas abiertas |
| GPT-5.6 Luna | inventó 4 de 5 (“aproximadamente 20 empleados”, “1974”, “1,400 °C”) | desactivar thinking para preguntas abiertas | rechazó 4 de 5, pero obtuvo 7 de 33 en las tareas, así que aplica el mismo enrutamiento |
GPT-5.6 Terra y Qwen3.8 Flash quedan justo en el límite, con dos respuestas inventadas cada uno (“0 empleados” y “unos 1,455 °C” en el caso de Terra). Para preguntas abiertas, trátalos igual.
¿Basta un modelo Flash o necesitas el modelo grande?
Para tareas acotadas, sí. En los benchmarks de agentes más cortos, donde el modelo trabaja en una shell con repositorios reales, DeepSeek V4.1 Flash supera a DeepSeek V4 Pro en Terminal-Bench 2.1 (90.6 frente a 87.9) y DeepSWE (74.2 frente a 62.7). Gemini 3.8 Flash obtiene 89.4 en Terminal-Bench 2.1, frente a 89.1 de Claude Opus 5. Los nueve completaron nuestro bucle de tool calling de dos turnos 3 de 3 veces.
La diferencia reaparece en tareas largas y contextos extensos. En Terminal-Bench 4.0, la tabla de Google sitúa Gemini 3.8 Flash en 19.1 frente a 51.8 de Opus 5. En la prueba de recuperación multi-needle de OpenAI entre 512K y 1M tokens, GPT-5.6 Luna obtiene 41.3 frente a 72.5 de GPT-5.6 Terra. Una ventana de 1M no implica poder recuperar de forma fiable 1M tokens en los modelos más pequeños. Reserva los modelos Flash para extracción, clasificación, pasos breves con herramientas y cambios de código con una forma conocida. Usa un modelo grande para planificar ejecuciones largas de agentes y responder preguntas sobre documentos muy extensos.
¿Qué falla al poner un modelo Flash en producción?
Los valores predeterminados y la forma de las peticiones causan más problemas que la capacidad del modelo.
- Dos modelos no permiten desactivar thinking. Gemini 3.8 Flash y GLM 5.3 Flash devolvieron un 400 con todas las opciones para desactivarlo que probamos.
- Los valores predeterminados están en ambos extremos. GLM 5.3 Flash usa
maxpor defecto y Qwen3.8 Flash usaxhigh(Alibaba). En nuestras cinco preguntas inventadas, Qwen3.8 Flash consumió una mediana de 11,680 tokens de razonamiento. Google incluye el thinking dentro demax_output_tokens, así que un límite ajustado puede devolver una respuesta truncada o vacía que se factura igualmente (guía de thinking). - Claude usa controles propios. Claude Sonnet 5 configura la profundidad de thinking mediante
output_config.efforty rechaza el antiguobudget_tokens(effort).reasoning_effortno es uno de sus parámetros. - Los bucles de herramientas deben reenviar el razonamiento. El modo thinking de DeepSeek espera el
reasoning_contentde los turnos anteriores (modo thinking), y Gemini añade firmas de pensamiento a las partes de las llamadas a funciones. Los frameworks que reconstruyen el historial de mensajes eliminan ambos. - El JSON estricto no funciona igual en todos los modelos. Qwen3.8 Flash respetó los tipos del schema, pero escribió enteros incorrectos en 5 de 8 ejecuciones (
-561994en líneas de factura). Usajson_objectcon las claves indicadas en el prompt para Qwen, GLM, Hy3 y DeepSeek, y una tool call para Claude. - El thinking cambia la propensión a inventar. DeepSeek V4.1 Flash inventó cuatro de cinco respuestas con thinking activado y ninguna con thinking desactivado.
- Los ids de modelo cambian.
deepseek-v4-flashsirve V4.1 Flash desde el 10 de septiembre (precios) y Claude Haiku 4.5 puede retirarse a partir del 15 de octubre (retiradas). Fija una snapshot con fecha cuando exista, comoseed-2-0-mini-260428. - Los proveedores externos de modelos con pesos abiertos varían. DeepSeek, GLM, Qwen y Hy3 se sirven desde muchos proveedores con distinta cuantización y comportamiento de caché. En septiembre se descubrió que un revendedor enviaba peticiones de pago a un modelo más barato (Hacker News). Compara las respuestas de tu proveedor con la API oficial del fabricante.
La velocidad depende más de la configuración predeterminada de thinking que del tamaño del modelo. Ejecutamos 3 veces una explicación de 400 palabras en streaming con los valores predeterminados de cada modelo el 2026-09-17:
| Modelo, configuración predeterminada | Primer token de respuesta | Tiempo total | Tokens de output por segundo |
|---|---|---|---|
| Claude Sonnet 5 | 2.2 s | 10.5 s | 70 |
| Gemini 3.8 Flash | 10.7 s | 14.3 s | 114 |
| GPT-5.6 Luna | 24.9 s | 26.1 s | 89 |
| GPT-5.6 Terra | 33.3 s | 34.2 s | 63 |
| GLM 5.3 Flash | 36.7 s | 39.3 s | 128 |
| DeepSeek V4.1 Flash | 40.4 s | 40.6 s | 158 |
| Seed 2.0 Mini | 61.3 s | 61.5 s | 81 |
| Hy3 | 123.0 s | 134.5 s | 35 |
| Qwen3.8 Flash | 159.9 s | 165.8 s | 72 |
Los tokens por segundo incluyen el razonamiento y la respuesta durante toda la llamada. El thinking adaptativo de Sonnet 5 no gastó tokens en una tarea de redacción y empezó a responder de inmediato. Qwen3.8 Flash dedicó una mediana de 10,697 tokens de razonamiento a la misma tarea. Por eso un prompt abierto puede tardar minutos en un modelo que resuelve tareas cerradas a bajo coste.
La configuración se controla con un único campo en una petición compatible con OpenAI, y el gasto de thinking vuelve en usage:
from openai import OpenAI

client = OpenAI(base_url="https://synthorai.io/v1", api_key="sk-syn-...")
r = client.chat.completions.create(
    model="gemini-3.8-flash",          # or glm-5.3-flash, gpt-5.6-terra, ...
    reasoning_effort="low",
    max_tokens=32768,
    messages=[{"role": "user", "content": "Compute 7 raised to the power 222, modulo 1000. Reply with a single integer."}],
)
u = r.usage
print(r.choices[0].message.content, u.completion_tokens, u.completion_tokens_details.reasoning_tokens)
Para Claude Sonnet 5, envía la misma petición a la Messages API con output_config: {"effort": "low"}.
Cómo lo gestiona Synthorai
Todos los modelos anteriores usan un único id en el mismo endpoint, compatible con OpenAI o Anthropic. La página para comparar modelos permite enfrentar cualquier pareja por precio, caché, tipos de entrada, contexto y benchmarks del proveedor. Los precios actuales de los nueve aparecen en la comparativa de precios de modelos.
Preguntas frecuentes
¿Claude Sonnet 5 es un modelo Flash? Anthropic no lo llama así, pero es el modelo más pequeño de la generación actual de Claude. Claude Haiku 4.5 se lanzó en octubre de 2025 y puede retirarse a partir del 15 de octubre de 2026. Claude Sonnet 5 cuesta $2 / $10 frente a $1 / $5 de Haiku, pero en nuestra prueba costó 2.9 veces menos por respuesta correcta.
¿La API de Gemini Flash es gratuita? Gemini 3.8 Flash tiene un nivel gratuito en Google AI Studio, pero Google usa el contenido de ese nivel para mejorar sus productos (precios) y solo permite usar el servicio de pago en aplicaciones que operen en el EEE, Suiza o Reino Unido (condiciones). El nivel de pago cuesta $0.75 / $3.75 hasta el 31 de diciembre de 2026 y $1.50 / $7.50 después.
¿Debería usar Gemini Flash o Flash-Lite? Gemini 3.8 Flash, salvo que todas las peticiones sean extracciones de un único paso. Obtiene 41.2 en el índice de Artificial Analysis frente a 23 de Gemini 3.5 Flash-Lite, costó 3.9 veces menos por respuesta correcta en nuestra prueba y rechazó las cinco preguntas inventadas, mientras que Flash-Lite respondió tres. Flash-Lite cuesta $0.30 / $2.50 y responde en unos 4 segundos.
¿GPT-5.6 Luna o GPT-5.6 Terra?
GPT-5.6 Luna para volumen, GPT-5.6 Terra para razonamientos más difíciles. Luna cuesta $0.20 / $1.20 y obtuvo 31 de 33 con la configuración predeterminada por $0.00030 por respuesta correcta. Terra cuesta $2 / $12, consiguió 33 de 33 en low por $0.00199 y lidera el índice entre los nueve. Ambos inventaron respuestas con la configuración predeterminada: Luna cuatro de cinco y Terra dos.
¿Qué modelo Flash es mejor para programar? Qwen3.8 Flash, DeepSeek V4.1 Flash y GLM 5.3 Flash lideran Arena WebDev (1635, 1614 y 1607). DeepSeek encabeza la categoría de programación con agentes de LiveBench (77.3), y DeepSeek y Claude Sonnet 5 lideran Vibe Code Bench de Vals (84.7 y 81.3).
Relacionado: coste de la API de DeepSeek V4.1 Flash, coste de la API de GLM 5.3, coste de la API de Gemini 3.7 Flash, caché de prompts entre proveedores, mejor LLM según el caso de uso.