
Coste API DeepSeek V4.1 Flash: iguala a Pro por 3-6x menos
Contenido
- ¿Qué cambió el 10 de septiembre y cuánto cuesta V4.1 Flash?
- ¿V4.1 Flash realmente iguala a V4 Pro y supera a V4 Flash?
- ¿Qué hace el selector de esfuerzo y se puede desactivar thinking?
- ¿Qué ocurre si preguntas por algo que no existe?
- ¿Se ha corregido la corrupción de JSON de V4 Flash?
- ¿Cuánto cuesta una imagen en V4.1 Flash?
- Cómo lo gestiona Synthorai
- Preguntas frecuentes
DeepSeek V4.1 Flash cuesta $0.30 por millón de tokens de entrada y $1.20 por millón de salida en horario punta, y la mitad fuera de ese horario. En 11 tareas con respuestas verificables, ejecutadas tres veces cada una, acertó las 33, igual que V4 Pro, pero con un coste por respuesta correcta entre 3 y 6 veces menor y una velocidad de salida 2.9x superior. Frente al V4 Flash al que sustituye, cuesta un 26% menos por respuesta correcta, es 1.5x más rápido y es el primer Flash capaz de procesar imágenes. También incorpora dos comportamientos que hay que tener en cuenta al diseñar la integración: con thinking desactivado responde a cálculos de varios pasos con un único token incorrecto; con thinking activado agota toda la ventana de salida, 16,384 tokens en tres de cinco ejecuciones, cuando se le pregunta por cosas que no existen. Medimos las tres versiones: deepseek-v4.1-flash y deepseek-v4-pro-0813 en un mismo lote, durante la misma hora y mediante el mismo gateway, cuatro días después del lanzamiento; deepseek-v4-flash-0731, esa misma tarde.
TL;DR
- V4.1 Flash cuesta $0.30/$1.20 por millón en horario punta y la mitad fuera de él; V4 Pro cuesta $1.32/$3.96.
- Con thinking activado, las tres versiones lograron 33 de 33 aciertos; cada respuesta correcta de V4.1 Flash costó entre $0.00097 y $0.00149, entre 3 y 6 veces menos que V4 Pro y un 26% menos que V4 Flash.
- Sin thinking, las tres bajan a 21 de 33; V4.1 Flash responde entonces con un único token incorrecto.
- Ante cinco entidades inventadas, V4.1 Flash con thinking activado alcanzó tres veces el límite de 16,384 tokens e inventó una respuesta dos veces; con thinking desactivado rechazó las cinco.
¿Qué cambió el 10 de septiembre y cuánto cuesta V4.1 Flash?
Una arquitectura nueva, un precio nuevo y una retirada. V4.1 Flash es “el modelo más pequeño de nuestra nueva familia de arquitecturas”: 552B parámetros en un encoder-decoder causal, donde un stack de 20 capas lee el prompt y otro genera la respuesta; 8B parámetros activos por token de entrada y 16B por token de salida; entrada de imágenes nativa; un contexto de 1M tokens; un límite de salida de 384K; y licencia MIT. La página de precios de DeepSeek indica $0.30 por millón de tokens de entrada y $1.20 por millón de salida en horario punta, de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes. Fuera de ese horario cuesta $0.15 y $0.60, con cache hits a $0.006 y $0.003. La tarifa queda entre las dos que tuvo V4 Flash: $0.14/$0.28 fijos en su lanzamiento de julio y $0.44/$1.32 en horario punta desde 2026-08-16. También está muy por debajo de V4 Pro, que cuesta $1.32/$3.96 en horario punta.
V4 Flash y la versión Vision Exp se han retirado, y sus nombres ahora redirigen a V4.1 Flash con la tarifa de Flash. DeepSeek también tenía previsto redirigir a V4.1 Flash el tráfico de V4 Pro a partir del 14 de septiembre. Ese mismo día retiró el plan del registro de cambios, “en respuesta a la demanda de los usuarios”, por lo que Pro sigue disponible con sus propias tarifas.
La integración cambió menos que el precio. El tokenizer es idéntico en las tres versiones, con 729, 452 y 528 tokens para los mismos corpus en inglés, chino y Python, así que se pueden reutilizar los presupuestos de tokens. Las páginas de cache pasaron de 1,024 a 512 tokens, por lo que un prompt de 549 tokens ahora almacena 512 en cache. Un prompt de 902K tokens recuperó correctamente un valor insertado, mientras que otro que superaba la ventana de 1M devolvió un 400 en lugar de truncarse silenciosamente.
Según los datos de DeepSeek publicados en la model card, el nuevo Flash supera al anterior en todos los benchmarks. También supera a Pro en tareas de agentes y programación, pero no en conocimiento:
| Benchmark | Qué evalúa | V4 Flash | V4.1 Flash | V4 Pro |
|---|---|---|---|---|
| GPQA Diamond | preguntas científicas de nivel de posgrado | 89.9 | 90.9 | 92.4 |
| HLE | preguntas difíciles de varias disciplinas | 37.8 | 36.8 | 42.7 |
| Codeforces | rating de programación competitiva | 3289 | 3471 | 3348 |
| MathArena Apex | matemáticas de competición | 58.6 | 65.6 | 65.3 |
| Terminal-Bench 2.1 | tareas de agentes en una terminal | 82.7 | 90.6 | 87.9 |
| Terminal-Bench 4.0 | tareas de agentes más difíciles en una terminal | 7.0 | 31.2 | 12.4 |
| DeepSWE v1.1 | corrección de repositorios reales | 54.4 | 74.2 | 62.7 |
| CyberGym | tareas sobre vulnerabilidades de seguridad | 76.7 | 88.1 | 83.3 |
| AutomationBench | automatización de workflows | 37.7 | 54.8 | 43.2 |
El resto del artículo recoge lo que pudimos comprobar directamente: la primera mitad de la tabla, con respuestas verificables, no las filas de conocimiento.
¿V4.1 Flash realmente iguala a V4 Pro y supera a V4 Flash?
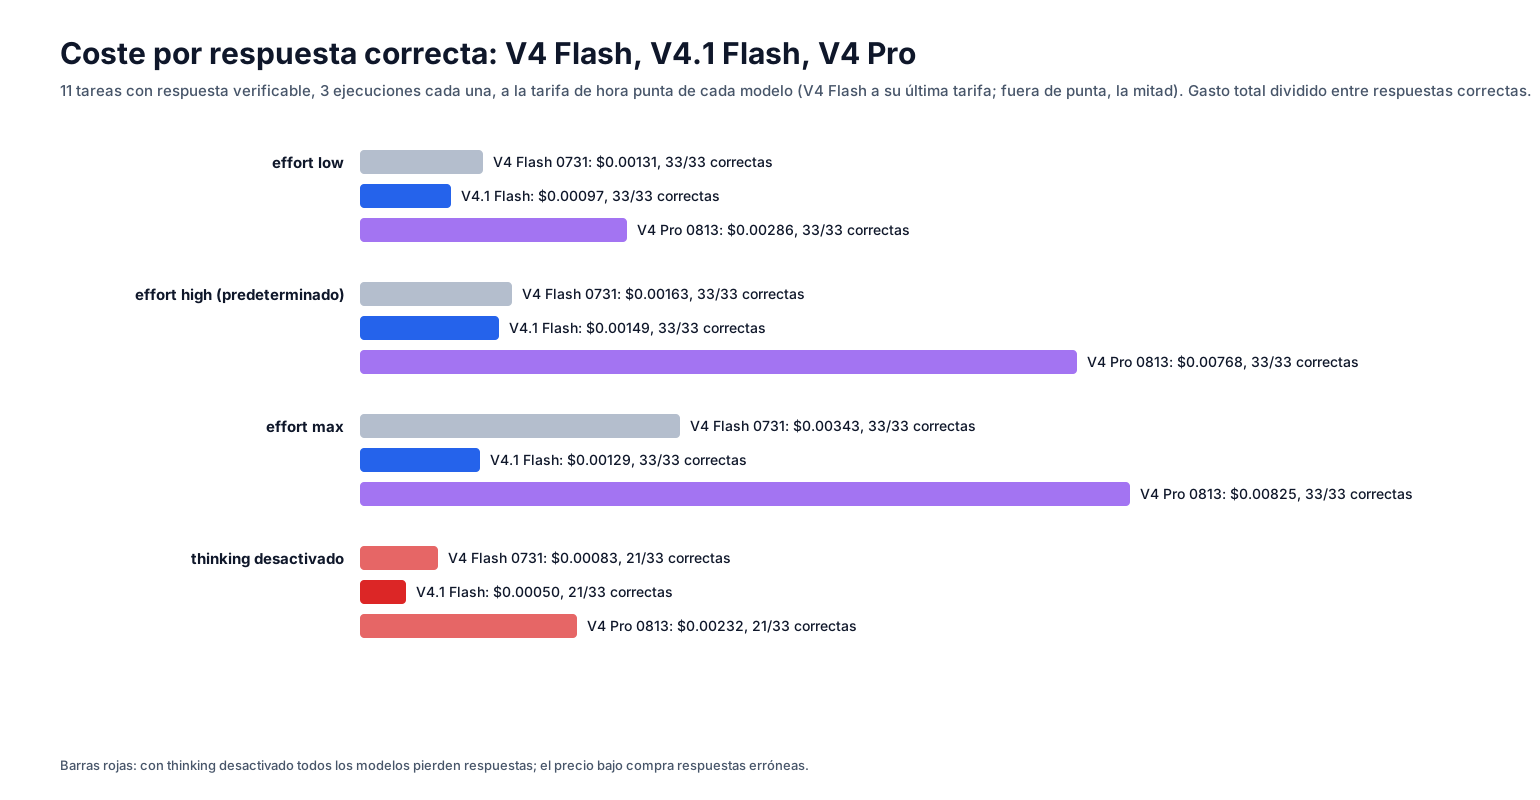
En tareas con respuestas verificables, las tres versiones obtienen la misma puntuación. Las diferencias están en el precio, la velocidad y el tipo de fallo. Ejecutamos 11 tareas cuya respuesta es un único número comprobable: sumas de números primos, recuentos de dígitos, caminos en cuadrículas, combinaciones de monedas, una regla aplicada 40 veces, el resto de dividir 7 elevado a 222 entre 1000, una conversión de base, un problema de mochila y el recuento de números de cuatro cifras sujetos a tres restricciones. Ejecutamos cada tarea tres veces con reasoning_effort en low, high y max, además de una ejecución con thinking desactivado. Los tokens de razonamiento corresponden al razonamiento oculto que el modelo genera antes de responder y se facturan como salida. El coste por respuesta correcta es el gasto total dividido entre el número de aciertos, calculado con la tarifa punta de cada modelo. Para V4 Flash usamos la tarifa de $0.44/$1.32 vigente hasta su retirada. Fuera del horario punta, el coste es la mitad:
| Modelo | Esfuerzo | Aciertos | Tokens de razonamiento, mediana (máximo) | Coste por respuesta correcta, horario punta |
|---|---|---|---|---|
| V4 Flash 0731 | low | 33/33 | 492 (6,444) | $0.00131 |
| V4 Flash 0731 | high (predeterminado) | 33/33 | 433 (9,172) | $0.00163 |
| V4 Flash 0731 | max | 33/33 | 453 (24,010) | $0.00343 |
| V4 Flash 0731 | thinking desactivado | 21/33 | 0 | $0.00083 |
| V4.1 Flash | low | 33/33 | 316 (6,153) | $0.00097 |
| V4.1 Flash | high (predeterminado) | 33/33 | 391 (13,300) | $0.00149 |
| V4.1 Flash | max | 33/33 | 391 (11,037) | $0.00129 |
| V4.1 Flash | thinking desactivado | 21/33 | 0 | $0.00050 |
| V4 Pro | low | 33/33 | 309 (6,398) | $0.00286 |
| V4 Pro | high (predeterminado) | 33/33 | 548 (18,247) | $0.00768 |
| V4 Pro | max | 33/33 | 644 (15,920) | $0.00825 |
| V4 Pro | thinking desactivado | 21/33 | 0 | $0.00232 |
Con thinking activado, ninguna versión falló una tarea con ninguno de los niveles de esfuerzo. Este conjunto de pruebas no permite distinguirlas por precisión, pero sí por coste y velocidad. Frente a Pro, V4.1 Flash cuesta 2.9x menos con low, 5.2x menos con el high predeterminado y 6.4x menos con max. Frente a V4 Flash, cuesta un 26% menos con low. En streaming y con thinking desactivado, para que el tiempo mida la generación de la respuesta y no el razonamiento, V4.1 Flash generó entre 121 y 134 tokens de salida por segundo, con 1.4 s desde la petición hasta el primer token. V4 Flash alcanzó entre 86 y 94, con 2.3 s hasta el primer token; Pro, entre 46 y 49, con 1.9 s. En un bucle de function calling de dos turnos, cada versión hizo exactamente una llamada por turno. V4.1 Flash utilizó 27 y 13 tokens de razonamiento en ambos tramos, V4 Flash 30 y 19, y Pro 61 y 29, con costes de $0.00019, $0.00030 y $0.00103 por tramo. La única diferencia de la tabla de DeepSeek que estas pruebas no evalúan es la de conocimiento, representada por HLE y GPQA.
¿Qué hace el selector de esfuerzo y se puede desactivar thinking?
El nivel de esfuerzo cambia el coste en unas pocas tareas, pero no altera ninguna respuesta. Desactivar thinking reduce los aciertos de las tres versiones en 12 de 33. V4.1 Flash acepta reasoning_effort con los valores low, high y max. DeepSeek asigna minimal a low, y medium y xhigh a high. En nueve de las once tareas, los tres niveles se mantienen a pocos cientos de tokens de razonamiento entre sí. La única excepción clara es el recuento de números de cuatro cifras sujetos a tres restricciones: 5,650 con low, 9,714 con high y 6,763 con max, todos correctos. El API aceptó e ignoró todos los valores de thinking_budget entre 0 y 1,024. El “nivel de esfuerzo de razonamiento ajustable de forma continua (entero de 1 a 100)” que menciona la model card no está disponible en el API, que rechaza los enteros. V4 Pro y V4 Flash se comportan igual, aunque con sus propios consumos. La tarea de recuento es donde max se encarece en las versiones anteriores: entre 12,729 y 15,920 tokens de razonamiento en Pro, y entre 17,866 y 24,010 en V4 Flash, para llegar a la misma respuesta correcta que V4.1 Flash obtuvo con 6,763.
Estos son los dos controles y los campos de la respuesta de los que salen las métricas:
resp = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[{"role": "user", "content": prompt}],
    reasoning_effort="low",                    # "low" | "high" | "max"; default "high"
    extra_body={"thinking": {"type": "enabled"}},  # {"type": "disabled"} turns it off
    max_tokens=4096,                           # always set one: see the next section
)
usage = resp.usage
reasoning_tokens = usage.completion_tokens_details.reasoning_tokens  # billed as output
thinking_text = resp.choices[0].message.reasoning_content            # returned on every thinking call
Desactivar thinking es la opción más barata y también la más arriesgada. Cada versión pierde un conjunto distinto de tareas:
| Thinking desactivado, 11 tareas x 3 | V4 Flash 0731 | V4.1 Flash | V4 Pro |
|---|---|---|---|
| Aciertos | 21/33 | 21/33 | 21/33 |
| Fallos totales (0 de 3) | mochila, suma de primos, horario de trenes | combinaciones de monedas, regla de 40 pasos, mochila | mochila, tarea de recuento |
| Cómo falla | un número incorrecto con el formato correcto (17, 1043; 10:40) | un token incorrecto (83 para una cadena de cinco pasos cuya respuesta es 168) | muestra los cálculos y después da una respuesta incorrecta |
La cadena de cinco pasos de nuestros casos estándar es el ejemplo más claro. Con thinking desactivado, V4.1 Flash acertó 1 de 3 veces, y 0 de 3 en una segunda tanda. V4 Flash acertó 2 de 3 y Pro, 3 de 3. Pro escribe los pasos antes de responder; las versiones Flash no. Hay otros dos datos que afectan al presupuesto. El modo thinking añade un prefijo oculto a la plantilla que se factura como entrada: 26 tokens de prompt en V4.1 Flash y 79 en V4 Flash y Pro, aunque el texto es idéntico y ocupa 729 tokens con thinking desactivado en los tres. Además, el reasoning_content que se devuelve al modelo en el siguiente turno no se vuelve a facturar: V4.1 Flash contabilizó 81 tokens de prompt con y sin ese contenido; Pro, 134.
¿Qué ocurre si preguntas por algo que no existe?
Con thinking activado, V4.1 Flash agota el límite de salida o inventa una respuesta. Con thinking desactivado, se niega a responder y lo hace de forma más fiable que las otras dos versiones. Hicimos cinco preguntas sobre entidades inventadas, cuya única respuesta correcta era “No lo sé”: el precio de las acciones de “Verantis Dynamics”, la plantilla del “Kessler-Fanning Institute”, el punto de fusión de “Oridium-7” y el ganador de un “1987 Pan-Continental Robotics Prize”. El límite era de 16,384 tokens:
| Modelo, configuración | Rechazó responder | Inventó una respuesta | Alcanzó el límite de 16,384 tokens sin responder | Tokens de razonamiento |
|---|---|---|---|---|
| V4.1 Flash, thinking activado | 0/5 | 2/5 (“El profesor Frink de Los Simpson ganó el premio de 1987”; “Oridium-7 tiene un punto de fusión de 1815 °C”) | 3/5 | 2,610; 11,905; 16,384 x3 |
| V4.1 Flash, thinking desactivado | 5/5 | 0/5 | 0/5 | 0 (entre 69 y 248 tokens de salida) |
| V4 Flash 0731, thinking activado | 1/5 | 3/5 (“0 empleados”; “Oridium-7 está aproximadamente a 1065 °C”; “Montblanc, el robot suizo del manga Pluto, ganó”) | 1/5 | entre 4,080 y 16,384 |
| V4 Flash 0731, thinking desactivado | 4/5 | 1/5 (“Oridium-7 tiene un punto de fusión de…“) | 0/5 | 0 |
| V4 Pro, thinking activado | 1/5 | 3/5 (“Andrew Martin ganó”; “0 empleados”; un intervalo de fusión de 899 a 949 °C) | 1/5 | entre 754 y 16,384 |
| V4 Pro, thinking desactivado | 3/5 | 2/5 (According to reference 844476, the Kessler-Fanning Institute had 247…) | 0/5 | 0 |
Tres de las cinco ejecuciones de V4.1 Flash con thinking activado costaron $0.0197 cada una en horario punta y devolvieron un mensaje vacío. Con el límite de 2,048 tokens que usamos en otras pruebas, ocurrió en las cinco, y también en cuatro de cinco ejecuciones de Pro. Si una búsqueda puede no tener respuesta, ejecútala con thinking desactivado o limita max_tokens y trata los mensajes vacíos como “desconocido”. El fallo de Pro sin thinking es distinto y merece su propia expresión regular: escribe Let me check that reference for you. According to reference y después inventa un número.
¿Se ha corregido la corrupción de JSON de V4 Flash?
Con json_object no hay nada que corregir en ninguna versión. No pudimos probarlo con json_schema estricto. V4 Flash 0731 se lanzó con un defecto: la combinación de thinking activado y un json_schema estricto corrompía campos enteros en 8 de 13 ejecuciones. En V4.1 Flash, un json_schema estricto devolvió 400 en nuestra ruta, y la guía de JSON de DeepSeek solo documenta {"type": "json_object"}.
Con json_object, la misma factura, con proveedor, fecha, total y líneas de detalle, devolvió todos los valores correctos en 8 de 8 ejecuciones con thinking activado y en 8 de 8 con thinking desactivado, en las tres versiones. V4 Pro sigue corrompiendo datos con un json_schema estricto y thinking activado: ninguna de las 8 ejecuciones devolvió la cantidad correcta de líneas de detalle, con resultados de 45, 12, 47, 1 y 2026; con thinking desactivado acertó 8 de 8. Para extracción, json_object con thinking desactivado acertó siempre en todas las versiones y, en V4.1 Flash, consume 25 tokens de salida.
¿Cuánto cuesta una imagen en V4.1 Flash?
184 tokens de entrada para cualquier imagen de hasta 512x512, 652 para un megapíxel y 994 para cuatro. La entrada de imágenes es nueva en la línea Flash. La versión Vision Exp retirada era un modelo independiente, y V4 Flash 0731 solo admite texto. Enviamos PNG generados a V4.1 Flash y restamos los tokens del prompt equivalente sin imagen:
| Imagen | Tokens de imagen | Coste en horario punta |
|---|---|---|
| 64x64, 128x128, 256x256, 512x512 | 184 | $0.000055 |
| 1024x1024 | 652 | $0.000196 |
| 2048x512 (misma área que 1024x1024) | 652 | $0.000196 |
| 512x2048 | 688 | $0.000206 |
| 2048x2048 | 994 | $0.000298 |
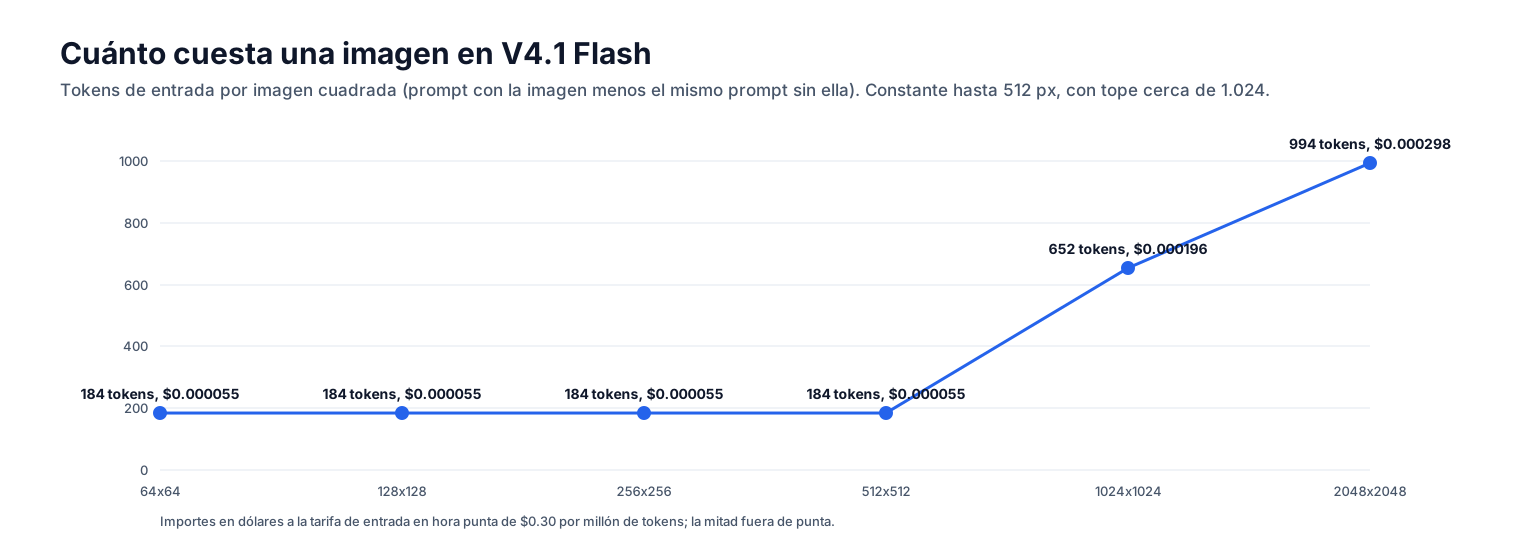
El mínimo coincide con la guía de visión: “las imágenes con un número total de píxeles inferior a aproximadamente 544x544 se amplían”; las más grandes se reducen “hasta aproximadamente el tamaño de una imagen de 1300x1300”; y el máximo documentado es de 1,024 tokens por imagen. Ni el contenido, ya fuera un color sólido, ruido o texto renderizado, ni el formato, PNG, JPEG o WebP con tamaños de 174 a 243 KB, cambiaron el recuento. La facturación depende de la geometría, no de los bytes. Mil imágenes de 1 megapíxel cuestan $0.20 en tokens de imagen durante el horario punta, sin contar la pregunta ni la respuesta.
Cómo lo gestiona Synthorai
V4.1 Flash está disponible como deepseek-v4.1-flash en el gateway, aunque el id de DeepSeek es deepseek-flash. Se factura a $0.30 por millón de tokens de entrada y $1.20 por millón de salida a cualquier hora, con lecturas de cache a $0.03 por millón y sin tarifa fuera de horario punta. Todos los importes de este artículo usan la tarifa publicada por DeepSeek para que puedas aplicar tus propios horarios. V4 Flash 0731 y V4 Pro 0813 siguen disponibles como deepseek-v4-flash-0731 y deepseek-v4-pro-0813, con sus respectivas tarifas. Tanto /v1/chat/completions como /v1/responses admiten el modelo. thinking: {"type": "disabled"} permite desactivar thinking en esta ruta, y el texto de razonamiento se devuelve en reasoning_content en todas las llamadas con thinking activado. Las imágenes se envían mediante partes de contenido image_url.
Preguntas frecuentes
¿DeepSeek V4.1 Flash es más barato que V4 Flash?
Es más barato que la tarifa de agosto a la que sustituye, pero no que la tarifa de lanzamiento de julio. V4.1 Flash cuesta $0.30/$1.20 por millón en horario punta y $0.15/$0.60 fuera de él. V4 Flash costaba $0.44/$1.32 en horario punta desde mediados de agosto y $0.14/$0.28 antes de esa fecha. En nuestras pruebas, cada respuesta correcta de V4.1 Flash con low costó $0.00097, frente a los $0.00131 de V4 Flash con su última tarifa.
¿Se puede desactivar thinking en DeepSeek V4.1 Flash?
Sí, con thinking: {"type": "disabled"}. DeepSeek también documenta reasoning_effort: "none". Desactivarlo reduce la precisión en tareas de varios pasos: V4.1 Flash pasó de 33 de 33 aciertos a 21 de 33 en nuestras pruebas y respondió a una cadena de cinco pasos con un único token incorrecto. Déjalo activado para aritmética y planificación; desactívalo para extracción y búsquedas que puedan no tener respuesta.
¿DeepSeek V4.1 Flash admite imágenes y cuánto cuesta cada una?
Sí, de forma nativa. En V4.1 Flash, una imagen consume 184 tokens de entrada hasta 512x512, 652 en 1024x1024 y 994 en 2048x2048, independientemente del contenido y el formato. Según la tarifa punta publicada, cuesta entre $0.000055 y $0.000298 por imagen.
Relacionado: coste de DeepSeek V4 Flash, DeepSeek V4 Pro GA frente a preview, controles de thinking en LLM, coste en tokens de las imágenes de entrada, salidas estructuradas de LLM.