
GPT Image 2.5 Flare vs GPT Image 2.6 Flare
Welches Modell wofür
Die Preise für ungecachten Text, Referenzbilder und Ausgaben sind gleich. Testen Sie gpt-image-2.6-flare für die complexity-Einstellung und prüfen Sie vor dem Wechsel von gpt-image-2.5-flare den tatsächlichen Verbrauch.
Preise
| GPT Image 2.5 Flare | GPT Image 2.6 Flare | Δ | |
|---|---|---|---|
| Eingabe / 1M Tokens | $5 | $5 | = |
| Ausgabe / 1M Tokens | $30 | $30 | = |
| Referenzbild-Tokens / Mio. | $8 | $8 | = |
| Cache-Lesen / 1M Tokens | - | $1.25 | - |
| Gecachte Referenzbild-Tokens / Mio. | - | $2 | - |
Preise aus dem Live-Katalog, Stand des letzten Builds. Die aktuellen Preise stehen auf der jeweiligen Modellseite.
Einordnung: Ausgabepreis pro 1M Tokens aller 15 Bildgenerierung-Modelle mit dieser Abrechnungseinheit (logarithmische Skala)
Spezifikationen
| GPT Image 2.5 Flare | GPT Image 2.6 Flare | |
|---|---|---|
| Eingabemodalitäten | Text Bild | Text Bild |
| Ausgabemodalitäten | Bild | Bild |
| Veröffentlicht | 2026-09-08 | 2026-11-04 |
| Ausgabegrößen |
|
|
| Eingabemodi | Bilder aus Text erzeugen und Referenzbilder bearbeiten | Bilder aus Text erzeugen und Referenzbilder bearbeiten |
| Bilder pro Anfrage | 4 | 4 |
| Formate | png, jpeg, webp | png, jpeg, webp, gif, svg |
| Anmerkungen | Benutzerdefinierte Breite und Höhe müssen Vielfache von 16 sein, das Seitenverhältnis muss zwischen 1:3 und 3:1 liegen. Für quality gibt es über high hinaus xhigh und max. Senden Sie das Referenzbild bei Synthorai als base64 im Feld image einer JSON-Anfrage an /v1/images/generations. | Benutzerdefinierte Breite und Höhe müssen Vielfache von 16 sein, das Seitenverhältnis muss zwischen 1:3 und 3:1 liegen. Senden Sie das Referenzbild bei Synthorai als base64 im Feld image einer JSON-Anfrage an /v1/images/generations. Für complexity stehen unabhängig von quality low, medium und high zur Wahl. |
Die Spezifikationen stammen aus der Dokumentation des jeweiligen Anbieters. Veröffentlicht ein Anbieter eine Angabe nicht, lassen wir die Zeile weg, statt sie zu schätzen. Vollständige Quellen: GPT Image 2.5 Flare · GPT Image 2.6 Flare
Ein Prompt, beide Modelle, gemessen über das Gateway
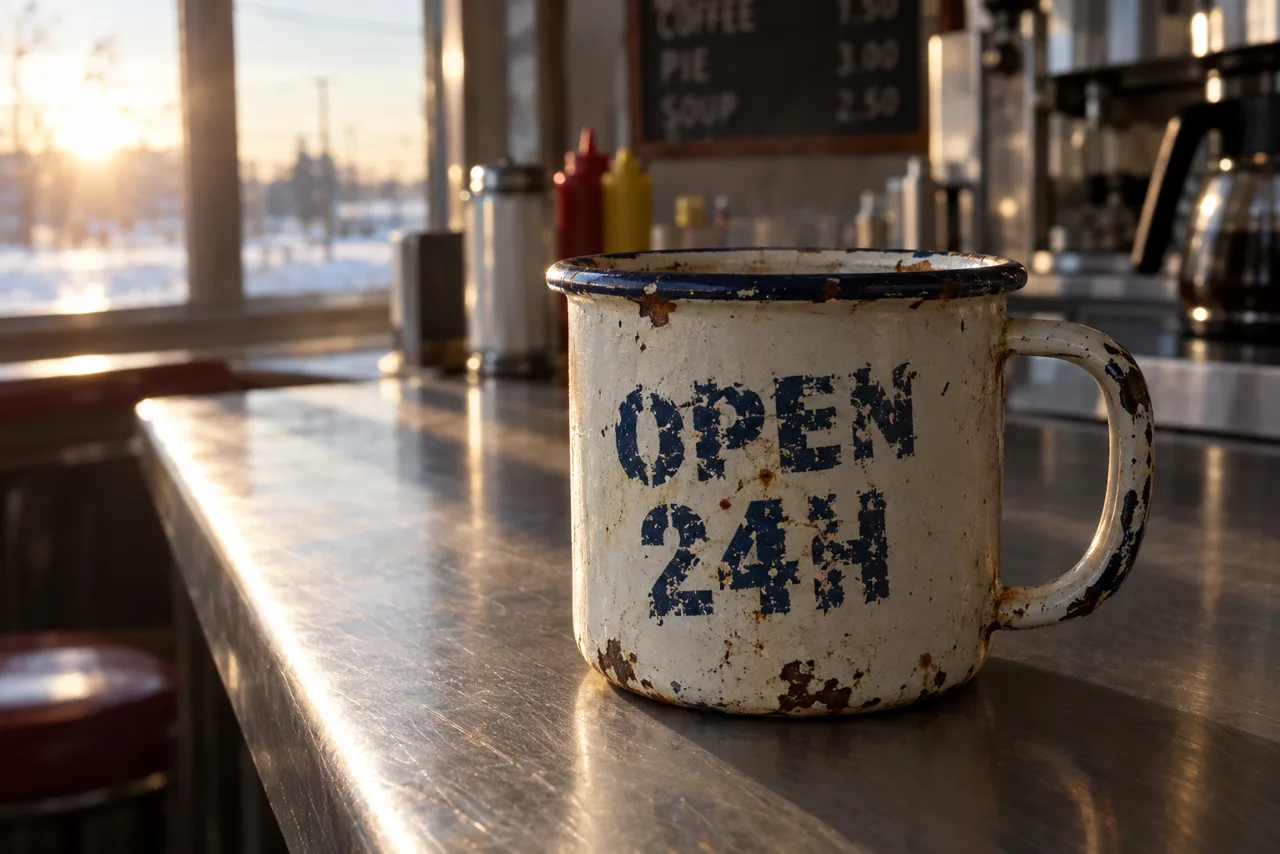
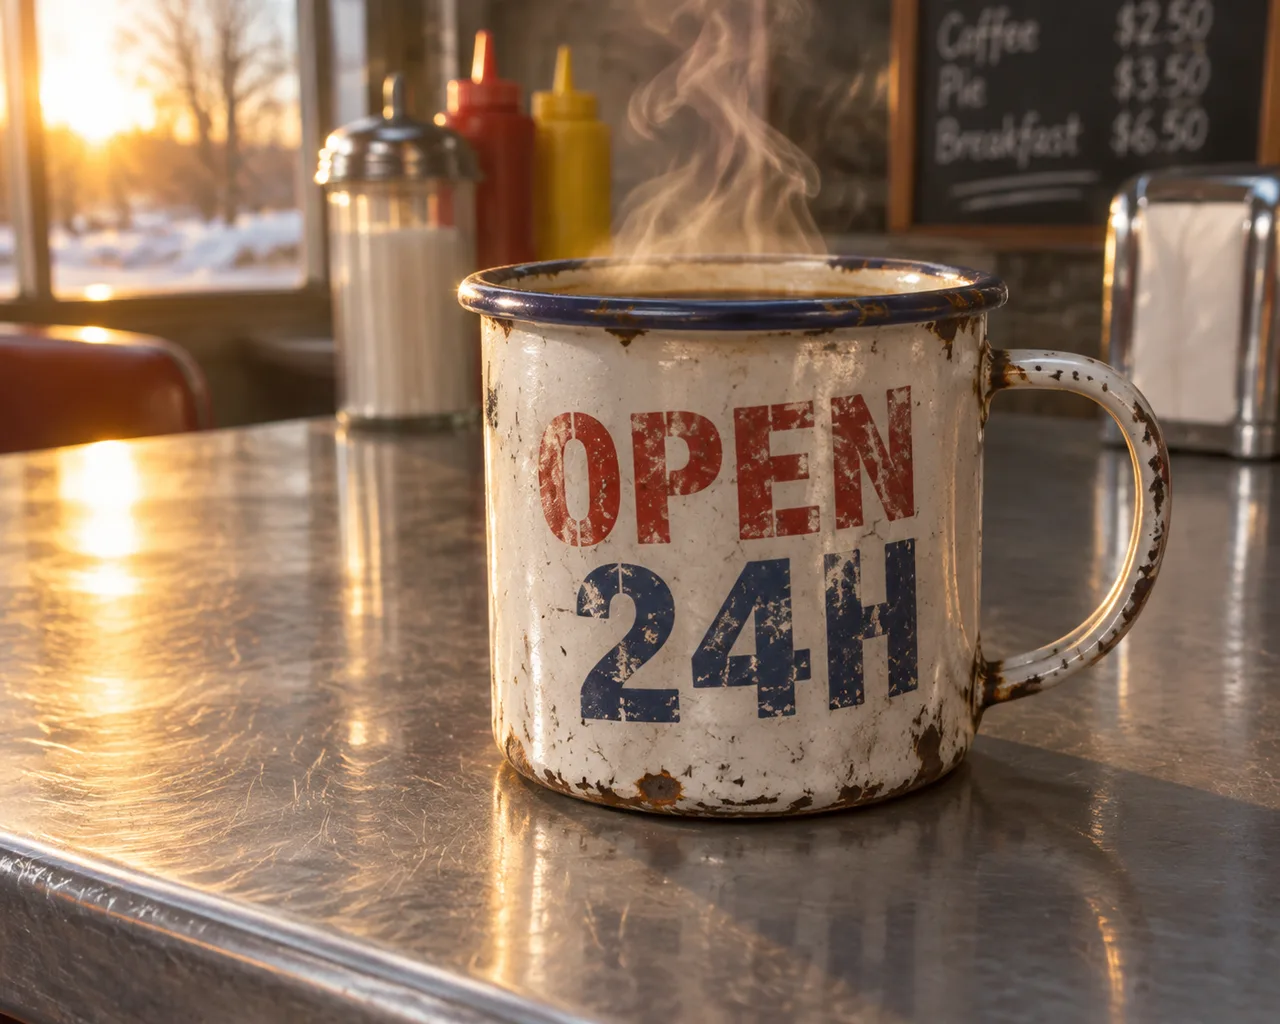
Ein Prompt, eine Anfrage pro Modell, keine Wiederholungen und keine Auswahl der besten Ergebnisse: Sie sehen das erste Ergebnis, das jedes Modell geliefert hat. Größe und Dauer haben wir nicht vorgegeben. Jedes Modell hat seinen eigenen Standardwert verwendet, denn eine Anfrage, die auf alle zugeschnitten ist, würde keinem gerecht. Die Dateien wurden für das Web neu kodiert. Beurteilen Sie deshalb Bildaufbau und Prompt-Treue, nicht die Kompression.
Eine Zeile genügt für den Wechsel
Beide IDs stehen in jedem Tab unten. Die beiden hervorgehobenen Zeilen sind die einzige Änderung. Gleicher Endpunkt, gleicher Schlüssel, gleiches Anfrageformat.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    # model="gpt-image-2.6-flare",  # diese Zeile einkommentieren, die darüberliegende auskommentieren
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gpt-image-2.5-flare",
// model: "gpt-image-2.6-flare", // diese Zeile einkommentieren, die darüberliegende auskommentieren
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2.5-flare",
# "model": "gpt-image-2.6-flare", # diese Zeile einkommentieren, die darüberliegende auskommentieren
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gpt-image-2.5-flare",
// Model: "gpt-image-2.6-flare", // diese Zeile einkommentieren, die darüberliegende auskommentieren
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gpt-image-2.5-flare")
// .model("gpt-image-2.6-flare") // diese Zeile einkommentieren, die darüberliegende auskommentieren
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Welches Modell ist günstiger: GPT Image 2.5 Flare oder GPT Image 2.6 Flare?
Beide berechnen $5 für „Eingabe / 1M Tokens“. Andere Tarife und die tatsächliche Nutzung können die Gesamtkosten verändern.
Kann ich GPT Image 2.5 Flare gegen GPT Image 2.6 Flare A/B-testen, ohne zweimal zu integrieren?
Ja. Beide laufen über denselben OpenAI-kompatiblen Endpunkt mit einem API-Schlüssel. Für den Wechsel ändern Sie nur eine Zeile, den Modellnamen. So können Sie einen Teil des Traffics an jedes Modell schicken und die Kosten direkt vergleichen.
Ändert sich der Preis mit der Bildgröße?
Das hängt davon ab, wie das Modell abrechnet. Modelle mit Preis pro Bild kosten immer gleich viel, egal wie lang der Prompt oder wie groß die Ausgabe ist. Bei Modellen mit Token-Abrechnung steigt der Preis mit der Auflösung, ein 4K-Bild kostet also ein Vielfaches eines kleinen. Die Tabelle oben zeigt, was für welches Modell gilt.