
提示詞快取未命中:先做五項檢查,再查路由
目錄
排查提示詞快取未命中時,先確認用量資料,再以已確認快取可用的基準請求為對照,檢查可重用前綴、快取資格、時間點,以及實際上游目的地。
TL;DR
- 沒有快取用量資料,代表狀態未知;回報讀取量為零,也無法直接判定原因。
- 請求命中率計算有重用任何快取的請求比例;權杖重用率則衡量重用了多少輸入。
- 原生診斷的不同狀態需要不同處理:修正差異、更換遺失的基準,或繼續調查無法判定的比較結果。
- DeepSeek 必須比對完整的持久化前綴單元;只有相同的文字前綴可能還不夠。
快取不再命中時,應該先查什麼?
先確認原始回應是否真的包含快取用量。如果供應商有回報讀取量,但用戶端或儀表板沒有顯示,先查用量回報流程。其他情況則保留最後一筆確認快取可用的請求,拿未命中的請求與它比較。
| 優先檢查 | 要收集的證據 | 最小且有用的下一步 |
|---|---|---|
| 真的未命中嗎? | 供應商原始用量、用戶端回應與儀表板紀錄 | 修改提示詞前,先檢查缺漏欄位與串流用量彙整 |
| 前綴是否變了? | 依序排列的工具、系統文字與先前訊息 | 逐項比較;將會變動的時間戳記或請求 ID 移到可重用內容之後 |
| 前綴是否符合資格且已寫入? | 模型最低門檻、控制設定、讀取與寫入用量 | 確認實際模型與 API;檢查預定的中斷點 |
| 請求是否太早或太晚? | 回應開始時間、請求間隔、快取存活時間 | 測試平行流量前,先依序送出一筆後續請求 |
| 目的地是否改變? | 實際模型、服務、帳號範圍與備援嘗試 | 請閘道維運方比對實際的上游嘗試 |
對輸入與快取用量完整的請求,使用下列兩個明確命名的指標:
- 請求命中率 = 快取讀取權杖大於零的請求數 / 用量完整的請求數。
- 權杖重用率 = 快取讀取權杖總數 / 所有輸入權杖總數,包含快取輸入與快取寫入。
缺少用量的請求要另外列出,事故成本也要計入失敗的嘗試。輸入持續增加時,權杖重用率可能下降,但請求命中率不變。
| 原生 API | 快取讀取欄位 | 權杖重用率分母使用的總輸入 |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens,已包含快取輸入 |
| Anthropic Messages | usage.cache_read_input_tokens | usage 內的 input_tokens + cache_read_input_tokens + cache_creation_input_tokens |
| DeepSeek | usage.prompt_cache_hit_tokens | usage 內的 prompt_cache_hit_tokens + prompt_cache_miss_tokens |
原生欄位若已經過轉換,請使用閘道的標準化結構;Synthorai 的計算公式見下文。
應該檢查哪些應用程式設定與時間點?
檢查預期可重用前綴之前的內容是否有變動,可以先從系統時間戳記、工具順序與重寫過的歷史訊息查起。
前綴變動。分別為有序的工具定義、固定的系統文字與先前訊息區塊記錄指紋,也就是用來偵測變更的雜湊值。請求專屬標記要放在最後。對話正常以附加方式增長時,整筆請求的雜湊也會改變,無法據此找出第一個差異。文字外的 JSON 空白,與模型可見字串內的空白,也必須分開看待。
檢查檢索內容的位置、模式切換、壓縮,以及框架最終送出的請求。多模態輸入還要比較前處理與檔案參照。
資格與控制設定。中斷點標示要求快取的前綴結束位置。存活時間(TTL)則是快取項目設定的有效時間。
整筆請求很長,不代表選定的可重用前綴已達模型最低門檻。使用明確中斷點時,要檢查中斷點之前的內容。原本不符合資格的前綴,不會因為加上 cache_control 就變得可重用。在 Anthropic 上,要檢查自動控制與區塊層級控制、TTL 衝突,以及中斷點數量限制;無效的組合可能回傳 HTTP 400,表示請求遭到拒絕,而不是成功回應但快取讀取量為零。Anthropic 提示詞快取。
可用時間與到期時間。第一筆寫入尚未可用前,若一次送出大量相同請求,可能產生多筆冷請求。Anthropic 文件指出,快取會在第一筆回應開始後可用。先等第一筆回應開始,再送出一筆後續請求,建立快取已可用的基準;之後再依回應開始時間比較平行請求。對於閒置過的對話,則要將請求間隔與設定的快取存活時間,以及文件記載的刷新行為相比較。Anthropic 快取可用時間。
DeepSeek 持久化單元。DeepSeek 比對的是完整的持久化前綴單元,也就是先前上下文中已儲存的片段。官方範例先送出 A+B,接著送出 A+C:第二筆請求無法重用完整的 A+B 單元。服務偵測並持久化共同前綴 A 後,第三筆請求 A+D 才能重用該單元。其中 A 是固定的上下文,B、C 和 D 則是不同的後綴。這是供應商文件描述的機制,不是我們的測量結果。
遇到這種模式時,讓 A 維持完全一致,依序完成前兩筆請求,預留數秒讓持久化完成,再檢查第三筆請求的命中與未命中權杖欄位。光是等待,無法保證需要的共同前綴單元已建立;快取仍採盡力而為的方式提供。DeepSeek 持久化規則。
閘道可能在用戶端與供應商之間改變什麼?
閘道可能同時改變實際送出的請求,以及回傳給用戶端的證據。將效能退化歸因於路由之前,要分別檢查這兩件事。
檢查模型別名、憑證範圍、政策覆寫與備援嘗試。若涉及協定轉換,要檢查送往上游的控制設定與回傳的原生欄位;使用串流時,則要比對上游用量事件與用戶端最終用量。
跨供應商路由漂移。負載平衡或故障切換可能將同一個對外模型名稱導向不同的推論供應商,而各家快取互不共用。在供應商 A 預熱的前綴,到了供應商 B 就無法使用。我們的供應商漂移研究觀察到九個上游,請求命中為 4/20;單一後端對照組則為 19/20。這些結果描述的是當時的設定。
依供應商、模型與帳號範圍將各次嘗試分組。在前綴與間隔固定的情況下,比較各組內的快取讀取量,並納入失敗嘗試與備援目的地。請維運方確認親和性設定,也就是是否持續將相關請求送往相同目的地,並確認故障切換行為。經核准調整後再測一次。供應商改變可以確認發生漂移,但個別未命中仍須檢查時間點與資格。
Synthorai 請求沒有供應商/通道選擇器。
如何在 Synthorai 調查快取退化?
用 Analytics 查看工作負載趨勢,用 Logs 查看請求。以下介面標籤已於 2026 年 11 月 6 日在線上環境確認。
- 縮小工作負載範圍。在 Analytics 選取
Time range與All keys · all models。在 Logs 使用Add filter,以model或key篩選。正常時段與異常時段要使用一致的選取條件。CACHE HIT是權杖重用率,不是請求命中率。 - 檢查請求。在
Overview的Cost at your rate中,比較 Input、Cache read、Output,以及適用的寫入項目。讀取量穩定但輸入增加,可能是上下文增長;讀取量下降且寫入量上升,則應檢查前綴與時間點。Raw包含的是已儲存欄位,不是供應商原始回應。 - 追查 trace 與工作階段。從受影響的 Logs 請求選取
Open trace,再選Open session。在Traces in this session中比較各個任務,開啟重用量為零的 trace。點選每個 span,也就是個別操作,檢查快取讀寫與費用;單看瀑布圖無法得知快取重用情況。使用 Logs 的session或trace篩選器查看底層紀錄。保留連結、時間戳記與原生回應 ID,供後續升級處理。
每段對話傳送 X-Session-Id,每個任務傳送 X-Trace-Id,每項操作傳送 X-Span-Id。解讀快取趨勢前,先依模型與預期共用的前綴分組。
關聯追蹤與路由是兩件事:閘道判定親和性時,X-Session-Id 的優先順序也高於 body 中的快取鍵;X-Trace-Id 則只用於彙整觀測資料。比較期間要維持相同的工作階段識別。兩者都不保證共用快取或固定目的地;不要為了追求命中,將無關的對話歸在一起。
對於用量完整的 Synthorai 儲存紀錄,權杖重用率計算如下:
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)
這裡的 cached_tokens 已包含在 prompt_tokens 中,再加一次就會重複計算輸入。快取寫入應放在分母,不是分子。排除缺少用量的紀錄,並另外回報筆數;單憑儲存值為零,無法證明上游提供的是實測為零的結果。
實測工作階段:先找出退化,再檢查各個 span
延續先前的代理程式成本調查,我們於 2026 年 11 月 6 日,使用 GPT-6.1 Sol 經由 Synthorai 依序送出六筆 Responses 請求。同一個工作階段包含三個 trace,每個 trace 都有兩次呼叫,標記為 lookup-1 與 lookup-2。這些標記代表合成測試的模型呼叫,並未執行查詢工具。模型、工具與工作階段 ID 都保持不變。退化測試會在每筆請求最前面加入新的類時間戳記值;修復則恢復原始前綴。請求標記始終放在尾端。
| Trace | 輸入權杖 | 快取讀取 | 重用率 | 回報費用 |
|---|---|---|---|---|
| 基準 | 4,729 | 2,273 | 48.1% | $0.0063923 |
| 退化 | 4,764 | 0 | 0% | $0.0119350 |
| 修復 | 4,732 | 4,546 | 96.1% | $0.0009446 |
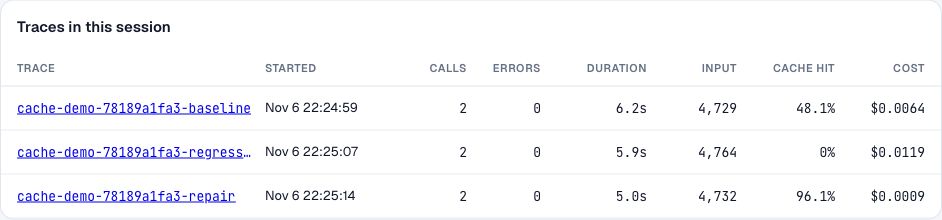
在 Traces in this session 開啟重用量為零的退化資料列。基準包含第一次冷呼叫;修復則重用了已預熱的前綴。這六次呼叫展示的是刻意引入的故障及其恢復過程,不代表正式環境預期可達成的節省比例。整個工作階段的重用率為 6,819 / 14,225 = 47.9%;這個平均值掩蓋了退化。
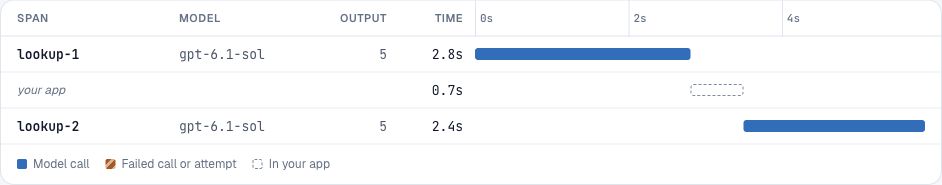
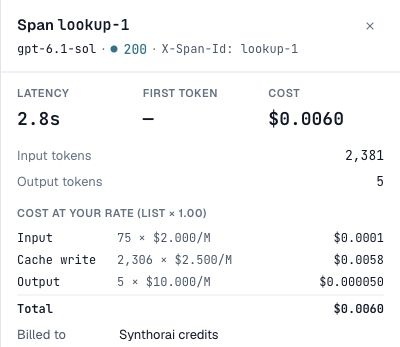
在瀑布圖選取 lookup-1。詳細資料顯示,2,381 個輸入權杖中有 2,306 個快取寫入權杖,符合重建已變更前綴的情況。儲存的合成測試請求可確認刻意引入的差異;單靠時間軸無法辨識。使用 Open in Logs 開啟請求紀錄,並比較應用程式端的前綴指紋。
這次示範沒有要求原生診斷比較。刻意引入的前綴變更與回報用量,足以確認觀察到的退化與恢復;但我們沒有獨立驗證實際供應商是否始終相同。工作階段識別保持固定,因此這項實驗並未測量親和性帶來的效益。
使用 BYOK 時,核對帳單前要先區分供應商回報費用與估算費用。無法取得的目的地/備援細節,應向維運方索取證據。
原生診斷如何協助找出請求變更?
原生診斷用來辨識請求差異;用量則衡量回報的重用量。兩者要一起看。選用的閘道路徑必須支援並保留原生欄位。我們先前透過 Synthorai 進行比較探測時,沒有收到診斷資料,因此不能只憑供應商文件就認定閘道也支援。
OpenAI Responses 在支援的模型上接受 prompt_cache_options.comparison_response_id。保留已完成的基準回應 ID,並送出實際的後續內容;比較參照不會載入對話歷史。結果會出現在 prompt_cache_diagnostics 中,串流模式也會在 response.completed 事件中提供。依下列狀態決定下一步。診斷中的權杖估算與計費用量是分開的。OpenAI 快取診斷。
Anthropic Messages 首次啟用時使用 diagnostics: {"previous_message_id": null},後續已啟用的請求則帶入上一筆原生訊息 ID。串流模式會在 message_start 提供結果。解讀 null 結果前,先確認兩筆請求都已啟用診斷,且後續請求提供了有效參照。Anthropic 文件所述的診斷適用於 Claude API,不包含 Amazon Bedrock 與 Google 代管的 Claude。Anthropic 快取診斷。
| API 與回傳狀態 | 意義 | 下一步 |
|---|---|---|
OpenAI cache_hit | 比較未偵測到未命中 | 查看用量以量化重用量;新的後綴權杖仍可能需要處理 |
OpenAI cache_miss | 已分類的差異影響了預期重用 | 檢查 reason,修正對應元件,再次比較 |
OpenAI comparison_response_not_found | 基準紀錄遺失或已過期 | 選用同一組織內近期已完成的回應 |
OpenAI unavailable | 不支援或無法判定的比較 | 確認模型支援情況;改用近期參照,若持續發生則手動檢查 |
Anthropic diagnostics: null | 只有在已啟用且有效的比較執行後,才代表沒有差異;未啟用或第一輪也會回傳此值 | 先確認已啟用診斷且參照有效;若有效比對無差異但讀取量低,則檢查快取可用性 |
Anthropic 診斷物件內的 cache_miss_reason: null | 比較尚待完成 | 檢查下一輪已啟用診斷的請求;不要將待完成結果歸類為未命中 |
Anthropic 原因類型 *_changed | 第一個辨識出的差異元件 | 修正該元件後再比較;後面可能還有其他差異 |
Anthropic previous_message_not_found | 未保留基準指紋 | 檢查前一筆請求是否啟用診斷、組織/工作區與經過時間;建立新基準 |
Anthropic unavailable | 無法做出明確比較,包含部分其他參數變更或比較限制 | 比較實際的 tool_choice、思考/輸出設定與 beta 標頭;若持續發生則手動檢查 |
| 任一 API 缺少診斷欄位 | 缺乏證據 | 檢查 API/模型支援情況、請求選項、轉換與串流事件擷取 |
OpenAI 的 prompt_cache_key_changed 需要特別留意:即使實體快取沒有未命中,用量也可能回報未命中。歸因於快取可用性之前,先確認是否為了分開計量而刻意改變快取鍵。在預期的計量群組內保持快取鍵固定,同時也要檢查它對閘道親和性的影響。OpenAI 診斷原因。
什麼時候該查推論服務本身?
確認內容符合快取資格、時間點有效、目的地範圍可比較,且用量可信後,再調查快取可用性。即使如此,輸入沒變也不保證可重用項目仍然存在。
可能原因包含到期、持久化未完成、容量壓力與服務端排程。OpenAI 文件說明了快取路由與可用性限制;工作階段標籤不保證能存取特定 worker。部分命中也可能表示較早的前綴仍可重用,但後面的內容必須重新處理。OpenAI 提示詞快取。
首個權杖延遲偏高或讀取量為零,都不能證明發生叢集切換。升級處理時提供原生回應 ID、時間戳記、間隔與目的地標籤;沒有供應商證據,就不要對底層機制定論。
明確建立的快取資源還需要另一項檢查:確認參照物件是否存在、是否到期,以及所屬範圍。不要用自動前綴快取的假設,診斷已失效的明確快取資源 ID。
如何證明修復有效?
搭配用量、診斷與目的地,比較正常、受影響與修復後的流量。
成本要包含重試。修復回報問題後,原生用量與用戶端用量應能對得起來。修復前綴後,差異應消失,並恢復可比較的重用量。修復路由後,應確認請求抵達預期目的地,且在該範圍內恢復。若相關條件未成立,就保留未解決的分類,根據其餘證據繼續追查。
常見問題
加上 cache_control 就一定會命中嗎?
快取控制仍受前綴長度、位置、可用時間與存活時間限制。請檢查模型要求與原始用量。
模型名稱不變,快取未命中仍可能是路由造成的嗎?
用戶端使用的模型名稱即使固定,也可能解析到不同供應商、模型或帳號範圍。請搭配供應商漂移排查流程,與閘道維運方比較實際嘗試。
為什麼已有部分權杖使用快取,診斷卻說請求變了?
請求後段的變更,可能不影響前段前綴的重用。檢查變更元件時,也要一起看快取讀取權杖的絕對數量。診斷比較與快取計量描述的是請求的不同面向。